 AIREITER
Muse Spark 1.3 目前在 OpenRouter 的掛牌價格是每百萬個輸入 token 1.25 美元、每百萬個輸出 token 4.25 美元,但真正該考慮的遠不只是單價。它在長上下文程式設計和代理工作上顯得相當有潛力;不過目前仍是剛推出的模型,發表時 max reasoning 尚未開放,而且首 token 延遲可能相當高。
Muse Spark 1.3 是什麼?「可用」又代表什麼?
Muse Spark 1.3 是 Meta 自研的推理模型,主打長時間執行的代理任務、程式設計與多模態工作。Meta 於 2026 年 9 月 2 日宣布推出,並表示模型正陸續部署到 Muse Code 和 Meta Model API;現有的推理模式會優先開放,max reasoning 則還需要進一步完成安全測試。(Meta AI Research 公告)
由於發布圖表已經列出 max 結果,但 max reasoning 當時仍需追加安全測試,因此不要預期這些成績在第一天就能完整重現。
Meta 表示,Muse Spark 1.3 更擅長在長時間任務中維持限制條件、在同一個執行緒處理中斷、主動提出澄清問題,以及在執行重大操作前要求確認;遇到卡住的情況,也更能承認自己無法繼續。Meta 另外宣稱,在內部程式設計比較中,Muse Spark 1.3 比 Muse Spark 1.2 少約 20% 的工具呼叫,token 用量也少 25%。不過這些都是供應商自行回報的數字,沒有公開可重現的任務集或誤差範圍。
發布文章把開放權重列為未來路線圖的一部分。目前查到的資料都將 Muse Spark 1.3 列為僅能透過託管服務或 API 使用的模型,沒有提供可下載的 checkpoint、已確認的授權條款、參數量或硬體需求。
API 價格看似簡單,實際成本卻沒那麼單純
目前最清楚的公開價目表來自 OpenRouter 的 Muse Spark 1.3 頁面,而不是 Meta 的發布文章。OpenRouter 列出的標準輸入與輸出價格分別是每百萬 token 1.25 美元和 4.25 美元,另外還有快取讀取與網頁搜尋費用。
| 用量 | 掛牌價格 | 注意事項 |
|---|---|---|
| 輸入 | 每 1M token 1.25 美元 | 新的提示詞與上下文 token |
| 輸出 | 每 1M token 4.25 美元 | 約為輸入價格的 3.4 倍 |
| 快取讀取 | 每 1M token 0.15 美元 | 適合重複使用代理上下文 |
| 網頁搜尋 | 每 1,000 次 2.50 美元 | 另計,不包含在 token 費用內 |
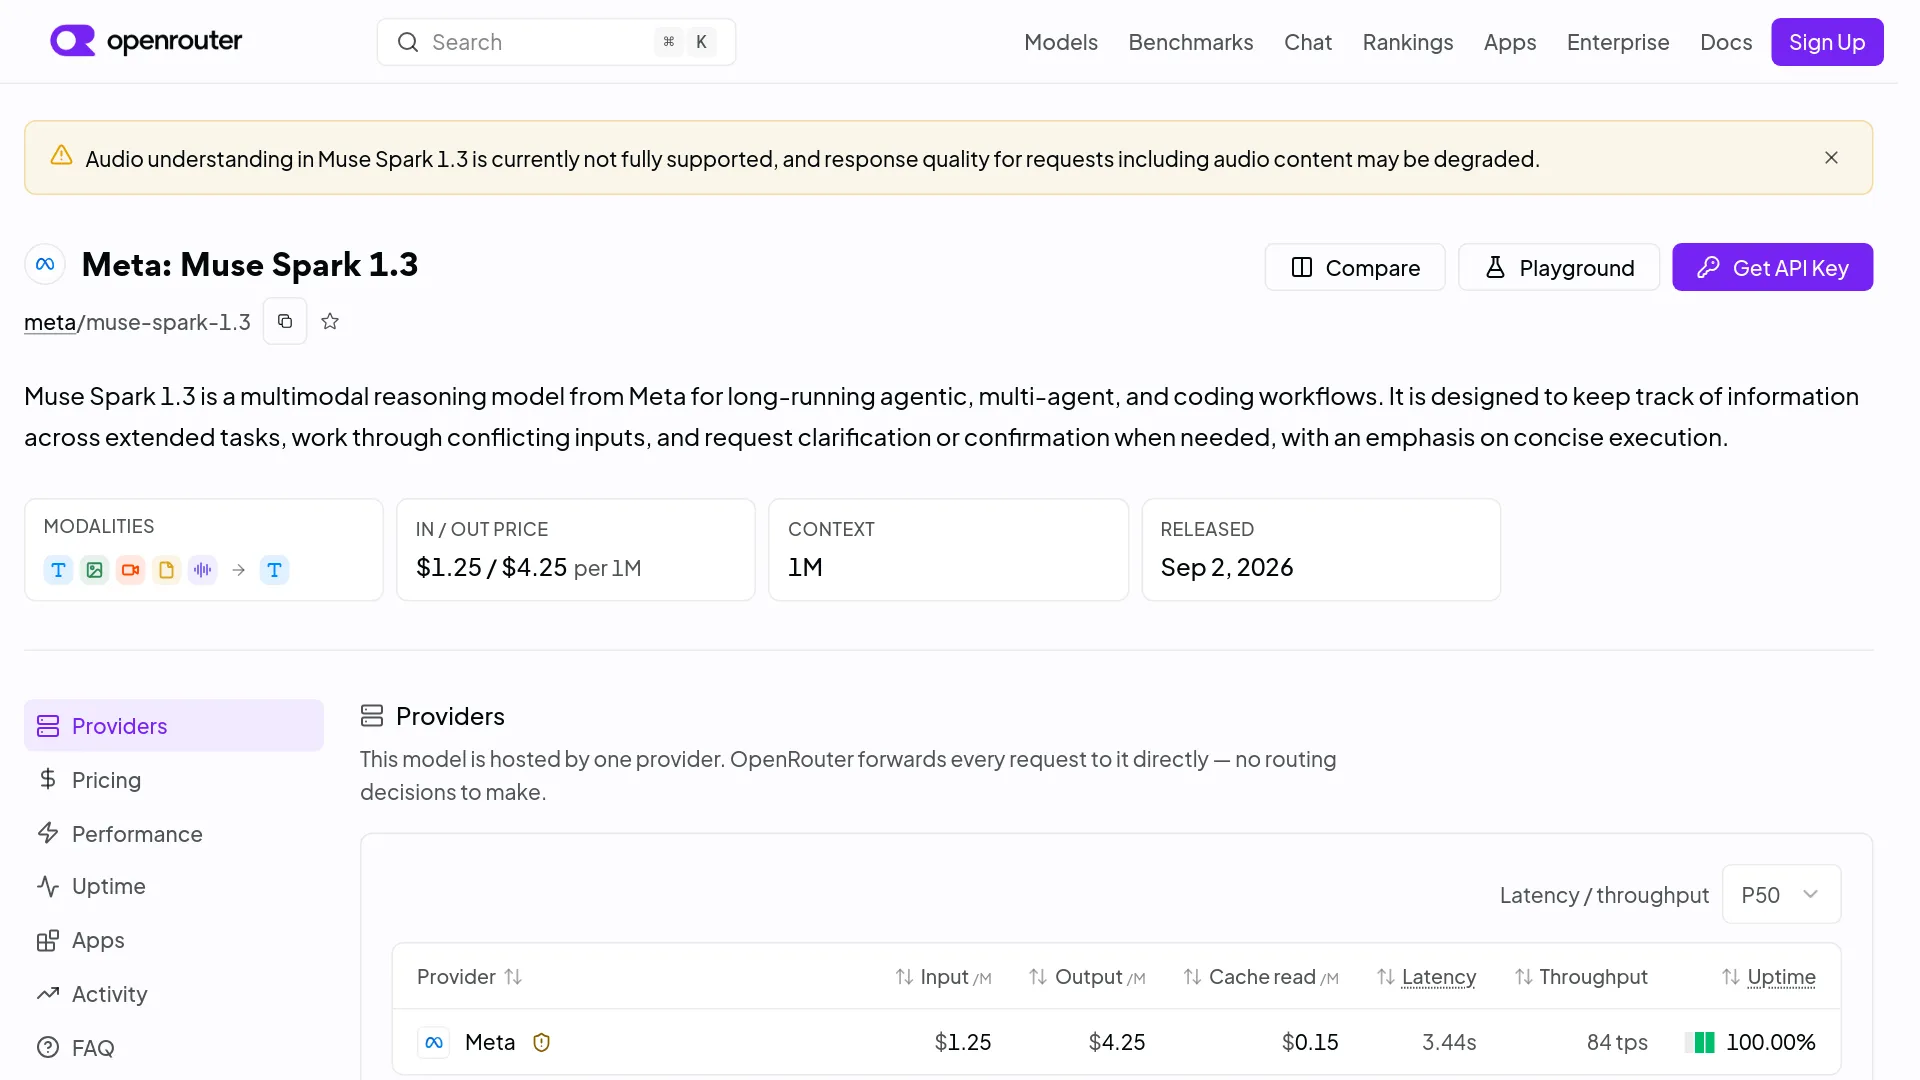
如果一次請求包含 100,000 個全新的輸入 token 和 20,000 個輸出 token,在不計快取或網頁搜尋費用的情況下,成本約為0.21 美元:輸入費 0.125 美元,加上輸出費 0.085 美元。不過,代理迴圈、重試,以及反覆傳送相同上下文,都會推高完整任務的實際成本。
Artificial Analysis 的報告則以 7:2:1 的快取命中、輸入與輸出比例,估算出每百萬 token 0.78 美元的混合價格。如果工作流程主要使用全新上下文,或輸出量特別高,實際費用會更高,因此這個數字只能視為特定情境下的估算,不能當成通用價格。
不要把 Muse Spark 1.2 API 價格指南中的 Contributor 假設直接套用到 Muse Spark 1.3。1.3 的公開掛牌價格已確立上述標準費率,但目前查到的資料並不足以確認完整的 1.3 Contributor 合約,包括資料使用方式、速率限制或地區可用性。在供應商明確確認前,建議先按照標準價格編列預算。
目前的證據支持「強大的程式設計模型」,但還不到「全面勝出」
現有證據足以把 Muse Spark 1.3 視為強大的程式設計與長上下文模型,但還不能說它在所有任務都領先。下表採用Meta 提供的評測方法中的分數;不同基準測試的尺度各異,同一欄內的數字只能在該列中比較。
| 評測 | Muse 1.3 max | Muse 1.3 xhigh | Muse 1.2 xhigh | GPT-5.6 Sol | Claude Opus 5 | 表中最高 |
|---|---|---|---|---|---|---|
| MRCR 512K–1M | 98.1 | 93.1 | 55.5 | 73.8 | — | Muse 1.3 max |
| DeepSWE v1.1 | 75.4 | — | 55.0 | 73.0 | 74.0 | Muse 1.3 max |
| SWE-Atlas Codebase QnA | 59.4 | 54.0 | 46.2 | 53.5 | 52.7 | Muse 1.3 max |
| Terminal-Bench 2.1 | 88.8 | 89.2 | 82.9 | 88.8 | 86.7 | Muse 1.3 xhigh |
| OSWorld 2.0 | 66.9 | 57.2 | 47.6 | 62.7 | 68.3 | Claude Opus 5 |
| DeepSearchQA | 89.4 | 89.4 | 85.9 | 93.0 | 90.4 | GPT-5.6 Sol |
| GDPVal-AA v2 | 1754 | 1709 | 1615 | 1710 | 1824 | Claude Opus 5 |
Muse Spark 1.3 最明顯的優勢在長上下文程式設計:它在 512K–1M 上下文的 MRCR max 測試拿到98.1,DeepSWE 則是75.4;Muse Spark 1.2 xhigh 對應分數分別為 55.5 和 55.0。但同一張表也顯示,在部分專業工作、電腦操作和搜尋評測中,其他模型的表現更好。
Meta 的方法說明指出,表格中的數據可能來自 Meta 自行評測、官方排行榜,或供應商自行回報的結果。程式設計測試使用受限工具,且不允許存取外部網際網路,因此這些分數適合作為參考訊號,不能視為一次由獨立機構完整重跑的比較。
Artificial Analysis 的資料顯示,Muse Spark 1.3 的Intelligence Index 為 61 分,在 196 個可比較模型中排名第 10,而可比較模型的中位數是 36。ModelCap 則顯示其ModelCap Index 為 81.7,排行榜位居第 4,但只給予 20% 的支援度,且僅有一筆公開基準測試觀察值。不同評測系統得出的結果,都指向同一個提醒:目前的證據基礎仍然偏薄弱。
如果要放進實際工作流程,建議先用 Muse Spark 1.3 測試儲存庫探索、長時間終端機代理,以及程式碼庫問答。不要把這些結果直接推論到所有高度依賴瀏覽或專業電腦操作的任務。
速度上的矛盾:開始生成後很快,開始之前卻很慢
Muse Spark 1.3 在真正開始輸出後似乎相當快,但使用者看到第一個答案前可能要等更久。這種特性更適合持續執行或批次工作,不太適合每一輪都要求立即開始回應的互動式程式設計。
Artificial Analysis 測得其每秒輸出 181.7 個 token,可比較模型的中位數則是 68.1。該網站同時回報首 token 需等待 27.51 秒,相較之下中位數為 3.04 秒;以其工作負載估算,輸出 500 個 token 需要41.26 秒。供應商頁面則顯示,從請求到第一個答案 token 的時間為38.51 秒,每個 Intelligence Index 任務的成本為0.55 美元。
OpenRouter 顯示的是另一組 P50 數據:每秒 62 個 token,延遲1.83 秒。這些指標不能直接互相比較,因為兩個頁面採用的工作負載與定義不同,而且 Artificial Analysis 的首個答案指標包含推理時間。實際導入前,應在自己的測試框架中同時測量首 token 時間與完整任務耗時。
「因為有幾個人問,所以先講一下我的早期感受(目前還在跑):感覺很機械化(做事很棒,但策略方面就不知道了),能力非常強。看起來也很快。」— u/NewYak4281,r/singularity
這個非受控的初步觀察,和實測出的取捨相當一致:開始生成後速度很快,但前面可能要等待一段時間,而且互動風格可能讓人覺得偏機械。它可以補充使用情境,但不能取代受控測試。
正式上線前,先確認 API 能力與部署限制
Muse Spark 1.3 具備現代代理模型常見的整合功能,但多項正式環境所需的細節仍取決於供應商,或尚未公開。目前最有力的 API 證據來自 OpenRouter 的線上模型頁面與 Artificial Analysis 的供應商追蹤資料,而不是發布文章中一份完整的 Meta 公開規格。
| 能力或限制 | 目前證據 | 對正式環境的影響 |
|---|---|---|
| 上下文視窗 | OpenRouter 與 ModelCap 列出1,048,576 個 token | 確認實際使用的 endpoint 限制 |
| 最大輸出 | ModelCap 列出944K token | 供應商層級的輸出限制可能更低 |
| 輸入 | 文字、圖片、影片與檔案;音訊列有警告 | 應將音訊理解視為尚未完整支援 |
| 輸出 | 文字 | 規劃以文字為主的工作流程 |
| 工具呼叫 | 標示為支援 | 在 SDK 中測試 schema 與工具錯誤處理 |
| 結構化輸出 | 列出 JSON-schema 回應格式 | 測試嚴格 schema 失敗時的行為 |
| 供應商覆蓋 | OpenRouter 頁面與 Artificial Analysis 追蹤器目前都顯示一個 Meta 供應商 | 不要假設具備故障轉移備援 |
| 模型權重 | 僅提供 API;未列出可下載權重 | 尚未建立自架模型的途徑 |
ModelCap 警告,個別供應商提供的上下文或輸出上限,可能低於公開的最大值。OpenRouter 的可用性面板顯示,過去三天的正常運作時間為 99.97%,但在 72 小時與 24 小時區間的可用性數字較低。這些是頁面上不同定義的指標,因此若要將流量導入正式環境,應查看最新狀態資料,並搭配自己的錯誤紀錄。
Meta 沒有在發布文章中公開參數量、架構、正式 API 速率限制、授權條款或詳細的安全測試結果。Meta 確實宣稱模型更能抵抗提示注入,也更擅長判斷不可逆操作的風險,但沒有提供攻擊成功率或可重現的紅隊測試流程。
現在適合使用 Muse Spark 1.3 嗎?
如果你的長上下文程式設計或工具密集型代理,更重視低 token 成本與持續生成能力,而不是立即得到第一個回應,Muse Spark 1.3 值得現在就開始測試。但對於重視延遲、以音訊為主、涉及敏感隱私,或必須具備多重備援的系統,它還不適合成為唯一的正式環境模型。
| 你的使用情境 | 建議 |
|---|---|
| 大型儲存庫、程式碼庫問答、長時間終端機任務 | 優先測試 Muse Spark 1.3 |
| 重視輸出速度的批次代理工作 | 值得考慮,但要測量完整任務成本 |
| 互動式結對程式設計 | 只有在能接受首 token 延遲時才使用 |
| 以音訊為主的工作流程 | 等待,或選擇已確認支援音訊的模型 |
| 敏感的客戶程式碼或受監管資料 | 先確認資料合約 |
| 需要故障轉移的關鍵任務服務 | 保留第二個模型與路由方案 |
與其再看一張排行榜截圖,不如先進行低風險的導入測試:
- 從非敏感儲存庫開始,準備五到十個固定任務。
- 將 shell、檔案寫入、網路與破壞性工具限制在最低必要權限。
- 記錄完成率、工具呼叫次數、首 token 延遲、執行時間、token 用量與帳單成本。
- 用目前的基準模型執行相同任務進行比較,並為逾時或低信心修改保留備援方案。
可以先用實驗旗標將 Muse Spark 1.3 接入程式設計代理,最後根據儲存庫測試結果做決定,而不是只看發布日排名。它的價格與長上下文成績足以支持測試,但初始回應速度慢、供應商選擇有限、音訊支援不完整,以及基準測試證據仍屬初步階段,都不適合拿來支持獨家部署。
Muse Spark 1.3 API 與價格常見問題
Muse Spark 1.3 已經正式發布了嗎?
是。Meta 在 2026 年 9 月 2 日的公告表示,Muse Spark 1.3 正陸續部署到 Muse Code 和 Meta Model API。max reasoning 當時仍等待進一步的安全測試。
我要去哪裡使用 Muse Spark 1.3?
Meta 指出 Muse Code 和 Meta Model API 這兩個使用管道。OpenRouter 也列出了 meta/muse-spark-1.3;實際能否使用,可能取決於供應商、帳戶與所在地區。
Muse Spark 1.3 的價格是多少?
OpenRouter 的掛牌價格是每百萬輸入 token 1.25 美元、每百萬輸出 token 4.25 美元、每百萬快取讀取 token 0.15 美元,以及每 1,000 次網頁搜尋 2.50 美元。除非你的直接供應商確認了自己的價目表,否則應將這些視為本文引用的 OpenRouter 費率。
Muse Spark 1.3 有一百萬 token 的上下文視窗嗎?
OpenRouter 與 ModelCap 列出1,048,576 個 token,Artificial Analysis 則四捨五入為 1 百萬。實際呼叫前,請確認所使用 endpoint 的有效上下文與輸出上限。
它支援視覺、影片、工具和 JSON 輸出嗎?
OpenRouter 列出文字、圖片、影片與檔案輸入,也支援工具呼叫和 JSON-schema 結構化輸出。音訊雖然有列出,但同時標示理解能力尚未完整支援。
Muse Spark 1.3 是開源模型,或可以自行託管嗎?
目前查到的資料沒有證實存在可下載權重或自架套件。Meta 將開放權重描述為未來路線圖,而不是目前可取得的 Muse Spark 1.3 檔案。
max reasoning 已經可以使用了嗎?
Meta 表示現有推理模式會優先開放,max reasoning 則要等進一步安全測試完成後推出。公告沒有提供確切日期。
可以假設 Muse Spark 1.2 的 Contributor 價格同樣適用於 1.3 嗎?
不行。1.2 的 Contributor 條款是另外記載的,但目前查到的資料不足以確認完整的 1.3 Contributor 合約。在供應商確認不同級別、資料政策與速率限制之前,請先按照 1.3 的標準價格編列預算。
正式部署前,先用小型、非敏感的儲存庫進行基準測試:讓目前使用的模型執行相同任務,同時記錄首 token 延遲、完成的修改、工具呼叫次數與成本。這樣得到的結果,會比發布日排行榜更能回答是否適合導入的問題。