 AIREITER
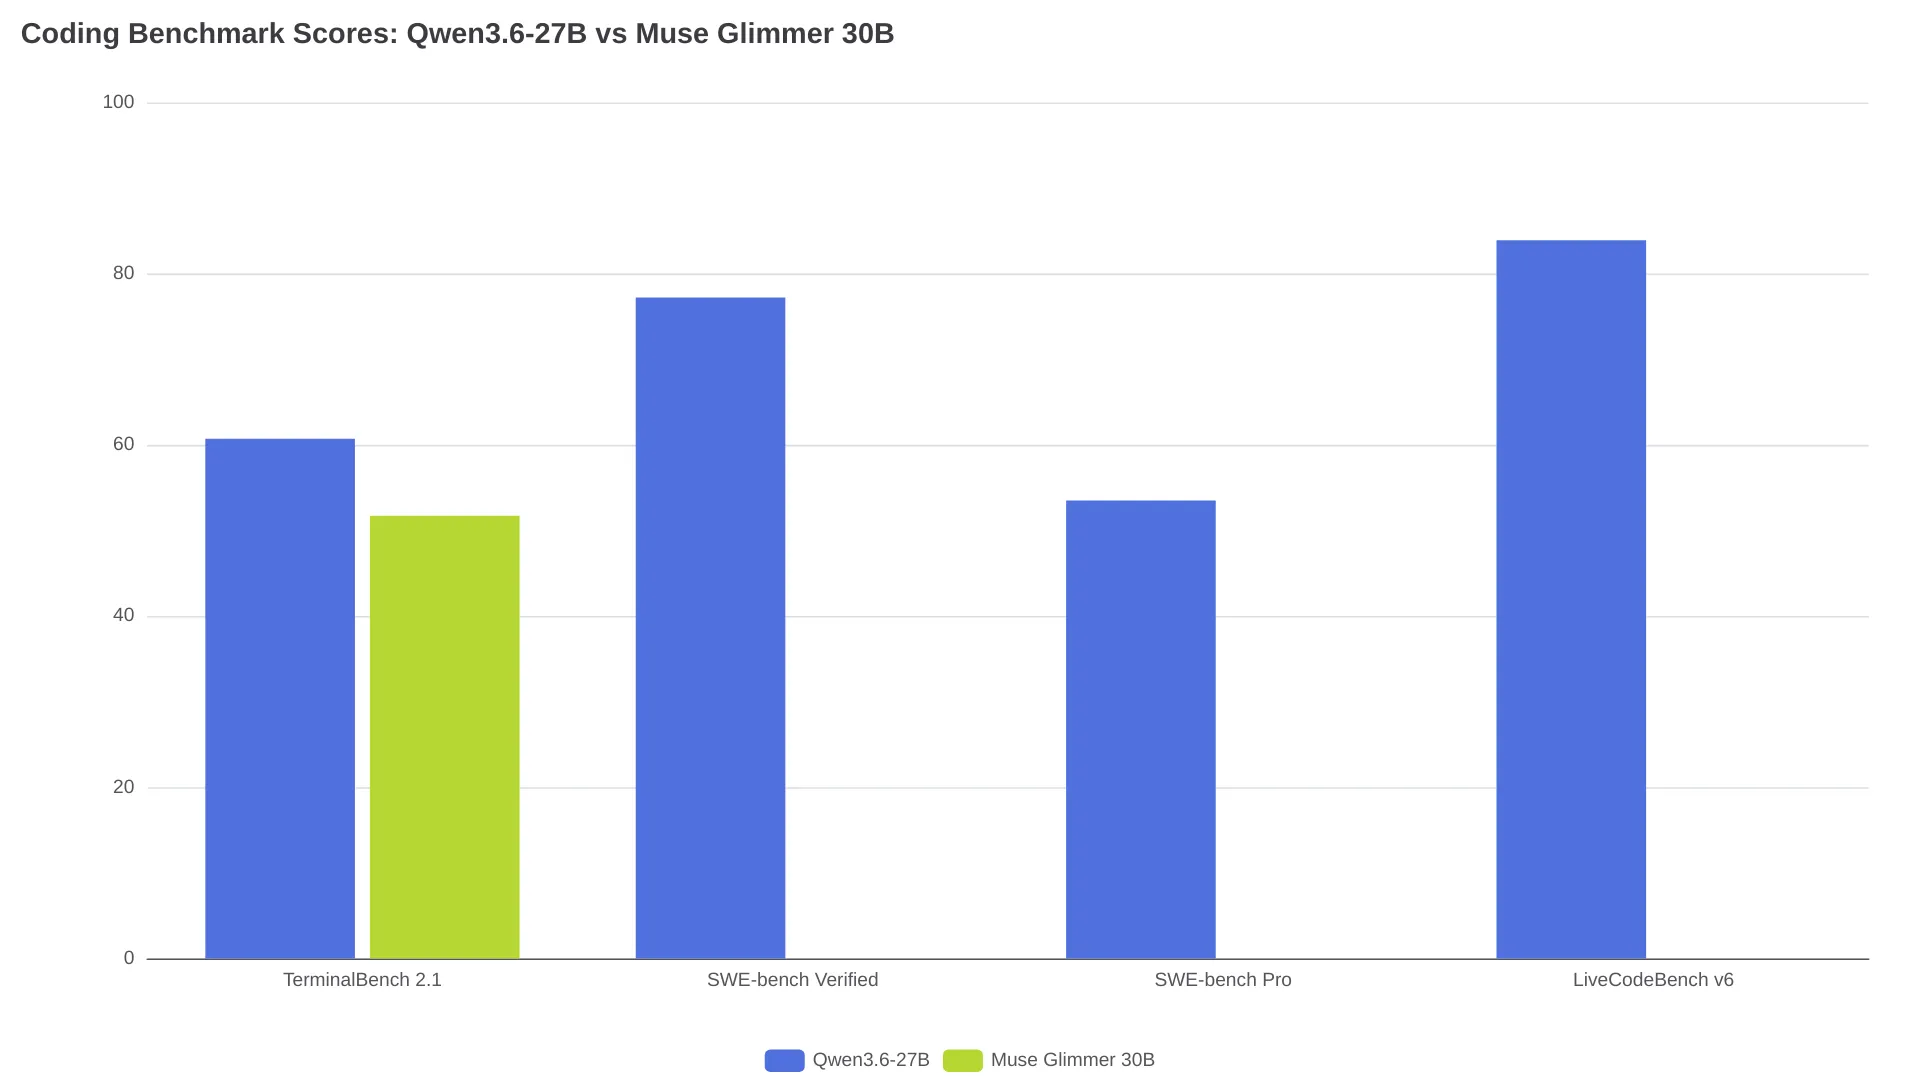
若只看程式能力的基準分數,Qwen3.6-27B 的優勢相當明確:TerminalBench 2.1 為 60.7 分,高於 Muse Glimmer 30B 的 51.7 分;Qwen 官方公布的 SWE-bench Verified 成績也達 77.2。不過,真正決定本地部署選擇的未必只是分數。Meta 在 2026 年 8 月釋出的開放權重模型 Muse Glimmer 30B,有一項足以改變單卡使用體驗的優勢:它能在單張 GPU 上容納更大的 context。Qwen3.6-27B 則在 2026 年 4 月推出,並在其 Hugging Face model card 中附上完整基準表;Glimmer 發布後幾天內,本地 LLM 社群便開始進行正面比較。
TerminalBench 2.1:Qwen 領先 9 分
TerminalBench 主要評估模型作為終端機 Agent 時的多步驟任務可靠度,涵蓋工具呼叫,以及長時間工作階段中的 context 維持能力。相關社群討論普遍將 TerminalBench 2.1 視為目前可取得的兩者正面 Coding Agent 對比結果。
以下是 2026 年 8 月 10 至 11 日 r/LocalLLaMA 討論串中整理出的社群回報 TerminalBench 2.1 成績:
| 模型 | TerminalBench 2.1 | 來源類型 |
|---|---|---|
| Qwen3.6-27B | 60.7 | 社群回報 |
| Muse Glimmer 30B | 51.7 | 社群回報 |
| Gemma 4 31B | 43.4 | 社群回報 |
不過這裡有個重要前提:TerminalBench 測的是「模型加上測試 harness」的整體表現,並非單獨測量基礎模型。Qwen3.6-27B 的官方 model card 註明使用 Harbor/Terminus-2 harness,設定為 3 小時逾時、32 CPUs、48 GB RAM、80K 最大輸出、256K context,並取五次執行的平均值。Glimmer 的分數可能來自不同或最佳化程度較低的 harness,因此這 9 分差距在你的 Agent 設定下可能縮小,也可能擴大。
官方程式基準資料:Qwen 完整公開,Glimmer 尚待補齊
Qwen3.6-27B 已在 model card 公布官方基準成績。就本次比較查閱的連結來源而言,截至 2026 年 8 月,尚未找到 Muse Glimmer 的官方 SWE-bench、LiveCodeBench,或同等級 Agentic Coding 基準結果。因此,Qwen 目前擁有更完整的公開證據,但兩者之間還沒有可一對一比對的官方測試。
Qwen 公布的官方程式基準如下:
| 基準測試 | Qwen3.6-27B(官方) |
|---|---|
| SWE-bench Verified | 77.2 |
| SWE-bench Pro | 53.5 |
| SWE-bench Multilingual | 71.3 |
| Terminal-Bench 2.0 | 59.3 |
| LiveCodeBench v6 | 83.9 |
這些數字皆為廠商自行發布的結果。Model card 說明,SWE-bench 使用 Qwen 內部的 bash/檔案編輯 scaffold,temperature 設為 1.0、top-p 為 0.95,context window 為 200K。SWE-bench Pro 的結果則是基於經過調整的任務集,當中 Qwen 修正了一些有問題的題目,因此未必能與公開排行榜數值直接對照。第三方 morphllm 也指出,這些結果依賴 Qwen 自家的 Agent scaffold,目前獨立重現的證據有限。
本地實測怎麼看:社群使用者的程式開發回饋
M5 Pro 上的 OpenCode Q4 測試
一名開發者在搭載 48 GB RAM 的 M5 Pro 上,透過 OpenCode 測試 Q4 quantization 的 Muse Glimmer(Unsloth build)。模型約使用 20 GB RAM,生成速度為 17 tokens/second。其結論是:
「整體而言,表現低於 Qwen3.6 27B」-u/curiousily_
在前端與後端程式任務中,Glimmer 的輸出品質都被評為不如 Qwen。不過作者也提到一項優點:整個測試過程中,Muse Glimmer 沒有任何工具呼叫失敗。該測試並未啟用 reasoning loops 或延伸思考,這可能限制了 Glimmer 的發揮。
max_tokens 設太小,結果可能失真
另一名 r/LocalLLM 測試者發現,若輸出 Token 預算設得太低,Muse Glimmer 看起來可能會比實際能力差很多。模型會先把 Token 預算耗在 reasoning 上,還沒來得及產生可見輸出,便出現空白或遭截斷的回答。提高 max_tokens 後,在沒有更換模型的情況下,其測試 harness 的通過任務數從 6/13 提升至 11/13,通過率幾乎翻倍。若你以預設輸出上限測試 Glimmer,測到的可能是設定限制,而非模型本身。
搭配 Hermes 時的終端機迴圈問題
另一位使用者回報,Muse Glimmer 與 Hermes Agent framework 搭配時會卡在大量終端機指令的迴圈中;在同一套設定下使用 Qwen3.6-27B 時,他沒有遇到這種情況。這則經驗談與目前可見的 TerminalBench 差距方向一致,但仍無法將模型本身與 Hermes 設定的影響完全拆開看。
Token 效率:值得關注,但仍只是質化觀察
u/NoFaithlessness951 在其 benchmark gallery post 中提出了效率面的觀察:
「比 Qwen 稍微沒那麼聰明,但每個任務消耗的 Token 少很多。」-u/NoFaithlessness951
這是社群的質化使用心得,不是針對每個成功任務 Token 用量所做的受控測量。目前尚無正面研究以相同任務、成功率及延遲資料,量化 Glimmer 相較 Qwen 的 Token 優勢。這項說法可視為有潛力的線索,而非已確立的事實。
VRAM 與 Context:Glimmer 的硬體優勢
Muse Glimmer 真正拉開差距的地方在於硬體需求。一名 r/LocalLLaMA 測試者展示,在單張 RTX 3090 上,以 Q4_K_XL 搭配 DFlash speculative decoding、多模態 projector,以及完整 F16 KV cache 運行 Muse Glimmer 30B,約占用 22-23 GB,並可設定 262,144-token context window。
同一張 RTX 3090、同樣採用 Q4_K_XL quantization 時:
| 模型 | F16 KV Context | Q8 KV Context | VRAM 使用量 |
|---|---|---|---|
| Muse Glimmer 30B | 262,144 | N/A | ~22-23 GB |
| Qwen3.6-27B | 70,000 | 125,000 | 可裝入 24 GB |
| Gemma 4 31B | 52,000 | 81,000 | 可裝入 24 GB |
對於需要將大型 repository context 載入 prompt 的工作流程,該作者形容 Qwen 的 70K F16 context 已經是「勉強能用」。
該 RTX 3090 設定下回報的 Muse Glimmer 效能如下:
- 生成速度:64-124 tokens/second,依程式碼或一般文字內容而異
- Prompt 處理:~1,400 tokens/second
- 長 context 擷取:在約 150K tokens 的雙針尋草堆測試中,第一次嘗試便通過
在相同硬體上,Qwen3.6-27B 若要取得更長 context,必須改用 Q8 KV cache compression,以輸出保真度換取 context 長度,或將工作卸載至更高階的機器。該測試者表示,當需要完整 context 時,會將 Qwen 移至自己的 DGX Spark,這是價格明顯更高的設備。
至於更高階硬體,根據 kie.ai's benchmark analysis,Qwen3.6-27B 的 NVFP4 build 在 DGX Spark 上,單一 session、context 最高至 128K 時可達 28-33 tokens/second。另一方面,Unsloth Muse Glimmer Q5_K_M build 在 RTX 5090 上,透過修補過的 llama.cpp DFlash path 進行 code-patch generation,據報可達 220-253 tokens/second。
不同需求該選哪一款?
| 使用情境 | 建議選擇 | 原因 |
|---|---|---|
| 只做程式開發、一次性生成 | Qwen3.6-27B | 公開的程式基準證據較強,且在現有 TerminalBench 2.1 社群對比中領先 |
| 單張 24 GB GPU 上的大 context Agentic Coding | Muse Glimmer 30B | 在相同硬體、Q4_K_XL/DFlash 設定下,可提供 262K F16 context,Qwen 為 70K |
| 長時間跨度的終端機任務 | Qwen3.6-27B | TerminalBench 2.1 為 60.7 對 51.7;另有 Glimmer 在 Agent framework 中迴圈的社群回報 |
| 高工作量且對成本敏感 | Muse Glimmer 30B(可能) | 一則社群回報認為每項任務使用的 Token 較少;但沒有對等的每次成功成本比較 |
| 需要大 context 的 repository 級程式開發 | Muse Glimmer 30B(若 VRAM 受限) | Qwen 在 24 GB 環境下要處理大 context,須使用 Q8 KV compression 或多張 GPU |
| 硬體不受限,追求最高程式準確度 | Qwen3.6-27B | 已公布的基準成績更強,且具官方分數佐證 |
FAQ
Muse Glimmer 有官方 SWE-bench 成績嗎?
沒有。截至 2026 年 8 月,在本次比較查閱的來源中,尚未找到 Muse Glimmer 30B 的官方 SWE-bench、LiveCodeBench 或 TerminalBench 成績。51.7 的 TerminalBench 2.1 分數來自 Reddit 討論串中的社群測試,不是 Meta 的官方評估。
兩款模型都能跑在單張 RTX 3090 上嗎?
可以。Muse Glimmer 30B 的 Q4_K_XL 版本可在約 22-23 GB 內運行,並使用完整 F16 KV cache 與 262K context。Qwen3.6-27B 的 Q4_K_XL 版本也能裝入同一張卡,但 F16 context 僅限 70K;若使用 Q8 KV cache compression,則可提升至 125K。
Muse Glimmer 在程式任務上有審查限制嗎?
一名使用者曾回報,Muse Glimmer 拒絕協助除錯 Python 滑鼠控制程式碼,理由是可能涉及安全疑慮。這僅是單一經驗談,且 system prompt 與設定都未說明;不足以判定這種行為來自模型本身,或是推論設定所致。
哪款更適合 Agentic Coding 工作流程?
以 TerminalBench 成績與社群回報來看,Qwen3.6-27B 在長時間跨度的終端機 Agent 任務中更可靠。Muse Glimmer 30B 則因 VRAM 效率而更適合硬體受限的環境,且可能在每項任務中產生較少 Token,有機會降低高工作量 Agent 迴圈的成本與延遲;不過目前仍沒有受控比較量化這項優勢。
Muse Glimmer 寫程式時,max_tokens 該設多少?
建議給予寬裕的輸出預算。有測試者發現,過緊的 max_tokens 限制會讓 Glimmer 在產生可見輸出前,就把預算耗在 reasoning 上,導致空白或截斷的回答,看起來像是任務失敗。提高上限後,其測試 harness 的通過任務數從 6/13 增加為 11/13。Qwen3.6-27B 的 model card 建議一般查詢使用 32,768 tokens,困難基準任務則使用 81,920;在 Meta 發布自己的指引前,以相同輸出預算作為 Glimmer 的起始設定是合理做法。