 AIREITER
一張 RTX 3090,真的能跑完整 262K 上下文的 30B 多模態模型嗎?Meta 於 2026 年 8 月 10 日推出 Muse Glimmer 後,本機 AI 社群很快便開始測試它能否在消費級硬體上取代 Qwen 3.6 27B。結論很明確:Muse Glimmer 可在單張 RTX 3090 上容納完整 262K 上下文,搭配 DFlash 的 RTX 5090 可跑到 236 tok/s;不過在 TerminalBench 2.1 上仍比 Qwen 3.6 27B 少 9 分,且面對作業系統層級的自動化工作時,常會拒絕執行。
Muse Glimmer 30B 是什麼模型?
Muse Glimmer 是 Meta Superintelligence Labs 以 Apache 2.0 授權釋出的 30B 參數稠密多模態模型。它的設計重點不是衝擊程式碼排行榜,而是支援常駐於本機的代理工作流程。模型由 27.9B 文字解碼器、1.9B ViT 視覺編碼器,以及基於 GELU 的多模態投影器組成,因此同時具備文字與圖像理解能力。以下架構資訊來自 SGLang Day-0 support blog。
核心架構規格一覽
| 項目 | 詳細資料 |
|---|---|
| 總參數量 | 30B |
| 文字解碼器 | 27.9B dense |
| 視覺編碼器 | 1.9B ViT |
| Transformer 層數 | 52 |
| 注意力機制 | Grouped-query(32 個 query heads、2 個 KV heads,16:1 GQA) |
| 前饋網路 | SwiGLU |
| 上下文視窗 | 128K+(已測至 262K) |
| 授權 | Apache 2.0 |
它採用混合式注意力設計:每四層為一組,前三層使用 2,048 token 的滑動視窗注意力,第四層則採完整序列注意力。局部視窗層搭配 RoPE,完整注意力層使用 NoPE,讓模型得以將上下文延伸至訓練上限之外。16:1 的 grouped-query attention 也大幅壓低 KV cache 體積;一項社群實測顯示,131K tokens 在 F16 下約只需 1.8 GiB。這正是它能在 24 GB GPU 上保有完整長上下文的原因,相同 F16 配置下,Qwen 3.6 27B 最多只能到 70K tokens。
你的硬體跑得動 Muse Glimmer 嗎?
關鍵主要在於選擇哪種量化格式。SGLang提供 BF16、NVFP4+MXFP8、GGUF Q4_K_M、GGUF Q4K-Dynamic 與 MLX 4-bit 等官方 checkpoint。若是 VRAM 極度有限,社群測試者也已將模型壓到 2-bit GGUF運行。
各配置的 VRAM 需求
| 配置 | 約略 VRAM | 目標硬體 |
|---|---|---|
| BF16 | ~60 GB | 單張 H100 |
| NVFP4 + MXFP8 | ~19.5 GB | RTX 5090 / DGX Spark |
| NVFP4 + BF16 DFlash | 18 GB + 5 GB speculator | RTX 5090 |
| Q4_K_XL + DFlash + mmproj + 262K context | ~22-23 GB | RTX 3090(24 GB) |
| 2-bit GGUF | ~14 GB | RTX 4060 Ti / 入門級硬體 |
| MLX Q4(Apple Silicon) | 統一記憶體 | Mac mini / MacBook Pro |
有 Reddit 用戶實測證明,單張 RTX 3090 上使用 Q4_K_XL 的 Muse Glimmer,搭配 DFlash speculative decoding、多模態投影檔與 F16 KV cache,可舒適地放進 22-23 GB VRAM,同時啟用完整 262,144-token 上下文。他們在約 150K-token 的 haystack 中,第一次就成功找回兩個 needle。
作為對照,同一張 RTX 3090 上的 Qwen 3.6 27B,F16 KV cache 只能到 70K tokens,改用 Q8 KV cache 也僅有 125K;Gemma 4 31B 則為 52K F16 或 81K Q8。Muse Glimmer 的 16:1 GQA 比例讓 KV cache 更省空間,正是同樣硬體能塞進更多上下文的主因。
部署方式:NVIDIA 平台可使用 SGLang 或 llama.cpp,搭配 NVFP4 或 GGUF checkpoint,並啟用 --speculative-algorithm DFLASH。Apple Silicon 則使用 MLX backend,但無法使用 DFlash。一位使用 96 GB 統一記憶體 M3 Max 的用戶回報速度為 17 tokens/s,且在該系統上 Muse Glimmer 比 Qwen 和 Gemma 都更快。
Muse Glimmer 實際速度有多快?
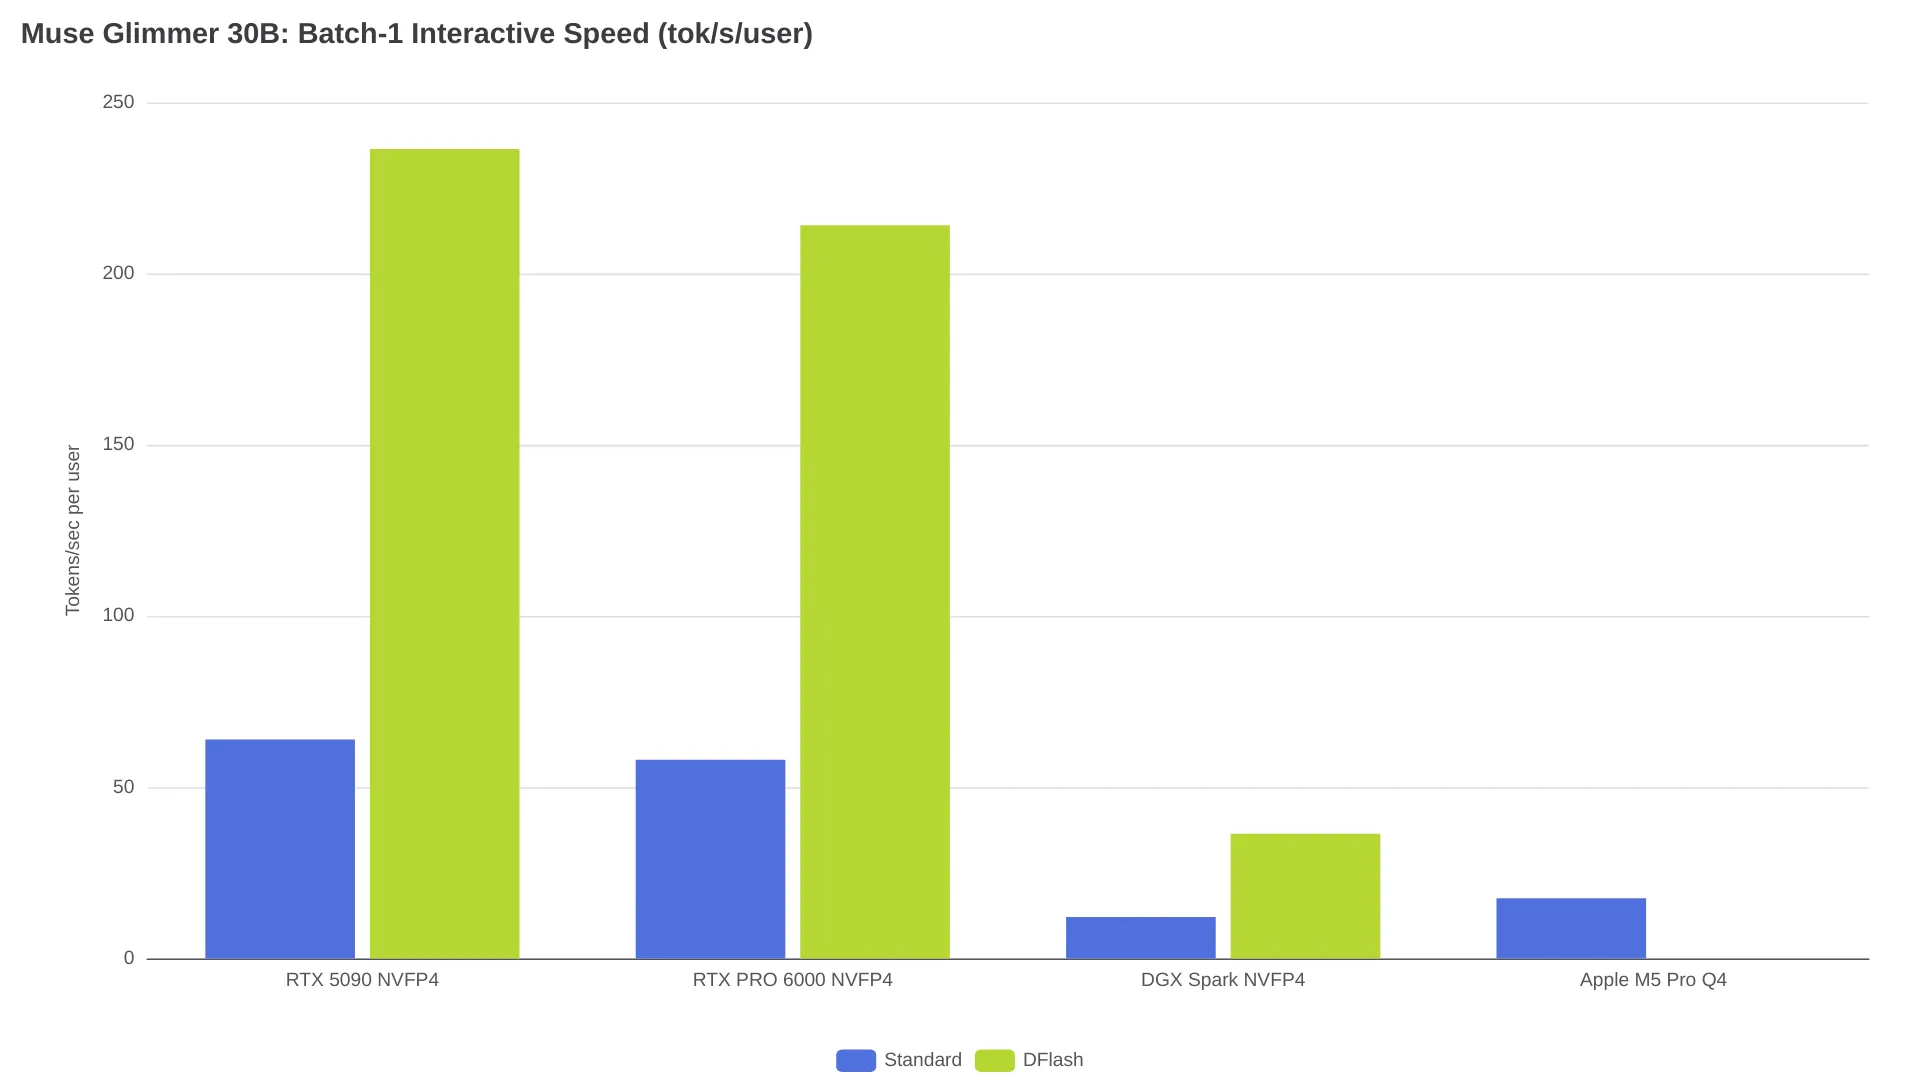
SGLang公布了涵蓋七種硬體配置的效能表,測試 batch size 從 1 至 8。透過 --speculative-algorithm DFLASH 啟用 DFlash speculative decoding 後,在 NVIDIA 平台的 batch-1 互動式吞吐量可提升 1.9 倍至 4.3 倍。
SGLang 跑分重點數據
| 平台 | 精度 | 解碼方式 | Batch-1 tok/s/user | Batch-8 tok/s |
|---|---|---|---|---|
| NVIDIA B300 | BF16 | DFlash | 308.51 | 261 |
| RTX 5090 | NVFP4 | DFlash | 236.4 | 1,452 |
| RTX 5090 | Q4_K_M | DFlash | 140.7 | 332 |
| RTX PRO 6000 | NVFP4 | DFlash | 214.11 | 403 |
| DGX Spark | NVFP4 | DFlash | 36.4 | 301 |
| Apple M5 Pro | Q4 | Standard | 17.6 | 56.9 |
RTX 5090 在 batch 8 測得的 1,452 output tokens/s 是總吞吐量;若是單人本機推論,真正值得參考的是 NVFP4 搭配 DFlash 的 236 tok/s。關閉 DFlash 後,同一配置會降至 63.9 tok/s。社群回報也大致吻合:一位使用 Unsloth Q5_K_M 量化與 RTX 5090 的用戶,測得 220-253 tokens/s。
DFlash 的表現取決於 draft acceptance rate;使用 Vulkan/RX 7900 XTX 與 SYCL/B70 的用戶都回報 draft acceptance 偏低,整體吞吐量反而較慢。
Muse Glimmer vs Qwen 3.6 27B:該選哪一個?
TerminalBench 2.1 成績比較
| 模型 | TerminalBench 2.1 | RTX 3090 上下文(F16 KV) |
|---|---|---|
| Qwen 3.6 27B | 60.7 | ~70K tokens |
| Muse Glimmer 30B | 51.7 | ~262K tokens |
| Gemma 4 31B | 43.4 | ~52K tokens |
TerminalBench 2.1 分數引自社群討論。上下文數據來自RTX 3090 測試。
在 TerminalBench 2.1 上,Qwen 3.6 27B 領先 9 分。多數社群使用者將此 benchmark 視為評估模型能否在長時間任務中可靠執行終端機指令的關鍵指標。直接的程式碼測試也呈現相同差距:某用戶的私有評測集裡,Qwen 得分為 12/13,Glimmer 為 11/13;Qwen 第一次便正確產出 953 行的東京旅遊頁面,Glimmer 則只產出不到 200 行(完整討論串)。
「和 Qwen 3.6 27B 根本沒得比」——Reddit 用戶 BarberIcy366 在 Glimmer 花費 21,000 tokens 後,僅產出 220 行 8-ball pool 遊戲 HTML 的評語(r/LocalLLaMA)。同一討論串中也有人回報,啟用 MTP 後,Qwen 3.6 27B 完成 Tetris 實作的速度快 1.7 倍。
不過,Glimmer 在一些特定場景確實有優勢:
- 上下文容量:在相同 F16 KV 設定下,單張 RTX 3090 可達 262K tokens,Qwen 僅有 70K;處理大型程式碼庫時,前者有 3.7 倍優勢。
- KV cache 效率:16:1 GQA 比例讓 Glimmer 的 KV cache 明顯更小,能把更多 VRAM 留給上下文。
- 視覺能力:Glimmer 原生就是多模態模型;Qwen 3.6 27B 的基本版本僅支援文字。
- MCP 與工具問答:有用戶表示,雖然 Glimmer 的終端機程式設計不及 Qwen,但它在 MCP 輔助的程式碼庫搜尋與問答工作流程中頗有潛力。
- 寫作品質:多位使用者更偏好 Glimmer 產生的自然語言內容,而不是 Qwen 的風格。
一位留言者如此總結兩者取捨:Glimmer 是「Qwen 3.6 27B 加上 5% 寫作風格,再減去 5% agentic capability」。
結論:依工作型態選模型
如果你的主要工作是一次完成的程式設計,或自主終端機代理,Qwen 3.6 27B 依然是更強的選擇——它在 TerminalBench 2.1 高出 9 分,也沒有 Glimmer 在作業系統層級自動化上頻繁出現的安全拒答問題。若你需要在單張消費級 GPU 上處理長上下文檢索、多模態輸入,或 MCP 輔助工作流程,則值得測試 Muse Glimmer。若終端機自動化的可靠性是必要條件,建議等待社群微調版本。
已知問題與使用陷阱
別把 max_tokens 設得太低
Muse Glimmer 在真正輸出前,會將相當一部分 token 預算用於內部推理。若 max_tokens 設得太小,模型可能在思考途中耗盡預算,最後回傳空白回應。一名用戶最初在自己的評測集上只測得 Glimmer 6/13;提高輸出 token 預算後,成績升至 11/13(來源討論串)。請將 max_tokens 設得足以涵蓋推理額外開銷,否則回應可能會在思考過程中中斷。
作業系統層級自動化會觸發拒答
多位使用者回報,Muse Glimmer 會拒絕涉及滑鼠控制、鍵盤自動化或其他作業系統層級工具呼叫的任務。即使只是使用標準 Python 函式庫,模型也可能將其視為潛在安全風險。
「以程式方式移動滑鼠,可能被濫用於自動化、clickjacking,或繞過安全提示。」——Reddit 用戶 Cold_Tree190 回報的 Muse Glimmer 拒答內容(r/LocalLLaMA)
重新開啟新 session,並提供更多預定用途的上下文,有時能解除拒答;但在模型已經拒絕過的同一個 session 中,它通常會維持原本立場。
工具呼叫穩定度不一
社群對工具呼叫可靠性的回饋落差很大:有人在 C 程式碼庫中表示「從未失敗」,也有人在其他設定下遇到無限迴圈與空白 API 回應。有回報指出,部分配置下 Unsloth Q4 和 Q5 量化版本會在工具呼叫時大量迴圈;相較之下,針對 24 GB 與 32 GB VRAM 的官方 GGUF 可能更穩定(來源討論串)。
部分地區無法下載官方模型
據報導,官方 Hugging Face 頁面在香港、澳門與中國停用了下載功能。作為替代方案,Unsloth提供的第三方 GGUF 發行版仍可取得。
延伸閱讀:Muse Spark 1.2 API pricing guide | Best free OpenRouter models for programming 2026