 AIREITER
多向量嵌入模型本週正式成為 Sentence Transformers 的一級支援功能。於 2026 年 8 月 18 日發布的 6.0 版,加入了 MultiVectorEncoder,與 dense、sparse、reranker 模型並列。Hugging Face 自家的發布基準比宣傳話術冷靜得多:late interaction 對上條件相同的 dense 模型,在 13 個 NanoBEIR 資料集贏了 9 個,但平均差距約只有 1 個 NDCG@10 點。代價則很明確:其範例中的原始索引,是 384 維 MiniLM 基準的 42 倍,即使與同級 dense 模型相比也有 21 倍之多。這筆交換值不值得,幾乎完全取決於你的查詢長什麼樣子。
多向量與 Late Interaction 到底在做什麼
多向量嵌入模型不會把整份文件壓成單一的 pooled vector,而是為每個 token 保留一個向量。在 Hugging Face 支援的模型中,token 向量慣例上是 128 維;一般 dense embedding 則常見 384、768 或 1,024 維。計分時,MaxSim 運算子會針對每個查詢 token,找出它與任一文件 token 之間最高的點積,最後加總各 token 的最大值:MaxSim(Q,D) = Σᵢ maxⱼ(qᵢ · dⱼ)。這些模型都採用 L2 正規化,因此每個分量落在 [-1, 1],最終分數會隨查詢長度增加。
它的位置正好介於兩種既有架構之間:
| 架構 | 文件端表示 | 計分方式 | 成本特性 |
|---|---|---|---|
| Dense bi-encoder | 預先計算的一個 pooled vector | 一次點積 | 檢索最快;但 pooling 會捨棄 token 細節 |
| Late interaction | 預先計算、每個 token 一個向量 | 對 token 配對執行 MaxSim | 比對資訊更豐富;索引會隨文件長度成長 |
| Cross-encoder | 不預先計算任何表示 | 每組 query-document 都完整 forward pass | Hugging Face 發布文中每對樣本的準確度最高;但作為第一階段成本過高 |
最初的 ColBERT 論文將這套方法稱為「contextualized late interaction」。
它的價值在 token 層級就看得出來。Hugging Face 的 lightonai/mLateOn 範例中,查詢 token「live」與文件 token「inhabit」配出了 0.94 的相似度:沒有任何字面重疊,卻能對應到相近語意。
多向量模型最值得出手的場景
短段落基準其實低估了這類模型的真正價值。本文比對的五份資料——Hugging Face 的發布文、TopK、Qdrant 的工程文章、Data AI Hub 的生產環境指南,以及 Suhas Bhairav 的生產搜尋比較——反覆指向幾類特別適合的問題:
- 語意搜尋中夾帶精確識別字。例如產品代碼、函式名稱、姓氏、錯誤字串、條款編號。Pooled vector 容易把這些訊號沖淡,逐 token 向量則仍能直接對應。
- 包含多個條件的查詢。像是「具備 X、Y 與 Z 的內容」:每個查詢 token 都能獨立找到支撐它的文件 token,不會有條件被平均掉。
- 答案只藏在長文件一小段中的情境。在多語長文件基準 MLDR 上,多向量
mLateOn得分為 77.92,mDenseOn為 51.59;這個差距比短段落平均值大了一個數量級。 - PDF、表格與掃描頁面。ColPali 系列模型能以文字查詢直接索引頁面影像,跳過 OCR。Hugging Face 發布文將視覺文件檢索視為 late interaction 的 state-of-the-art 領域;TopK 的分析則指出,在 ViDoRe v3 上,一個輕量多向量檢索器的 recall 比尺寸大 80 倍的單向量模型高出 +34%,工業文件 recall 更從約 42% 升至 76%。
- 領域外詞彙。Hugging Face 發布文指出,面對 out-of-domain 資料時模型有所提升;dense 模型的學習式壓縮,可能正好丟掉正式環境查詢所需要的細節。
Hugging Face 的數字也說明了視覺檢索為何特別適合這種方法:一張渲染後的頁面,對 colqwen2.5-v0.2 會產生約 755 個 token 向量;平均文字段落則約為 125 個。頁面裡的圖表、版面與表格越豐富,單一 pooled vector 必須丟棄的資訊就越多。
品質確實提升,但沒有神奇到改寫規則
最乾淨的對照來自 LightOn 的配對模型:LateOn 與 DenseOn 都使用相同的 149M 參數 ModernBERT backbone,也用相同訓練資料。兩者唯一差異在 head:前者使用 128 維 token 向量,後者則是單一 768 維文件向量。
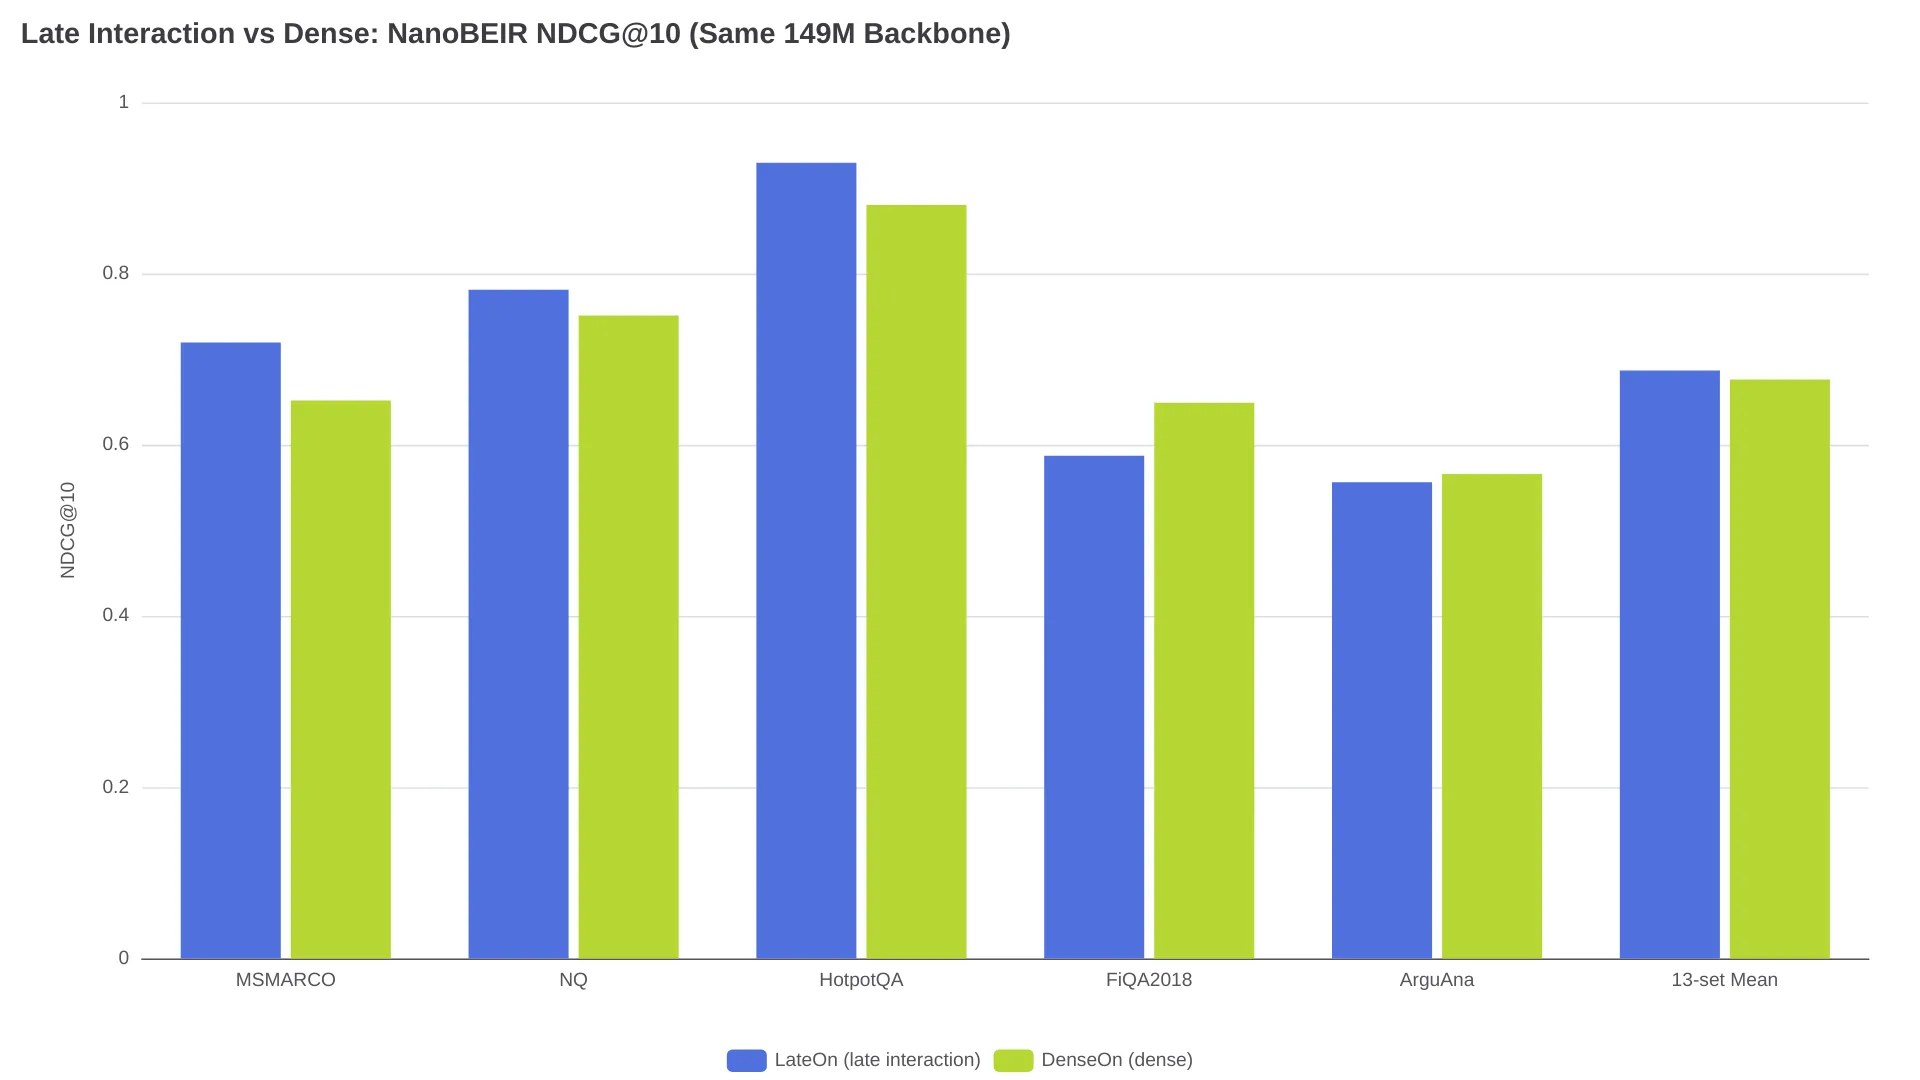
LateOn 在 13 個 NanoBEIR 資料集中贏了 9 個,平均 NDCG@10 為 0.6868,DenseOn 為 0.6764。在完整 15 資料集的 BEIR 上,成績是 57.22 對 56.20。不過 DenseOn 在 ArguAna、FiQA2018、SCIDOCS 與 SciFact 都直接勝出。這才是結果的真實輪廓:模型尺寸相同下有意義的平均提升,而不是跨世代的類別躍進。
維護者 Tom Aarsen 發布 v6.0 後,開發者 @saen_dev 問了實務工作者不斷重複的問題:「在特定領域語料上,它和 bi-encoder 相比表現如何?」(討論串)。坦白說,平均答案約是 1 個點,而顯著優勢主要集中在長文件。Hugging Face 自己的發布文也提醒,增益會因資料集而異,使用者應在自己的檢索任務上評估。
還沒壓縮前,索引就膨脹到 42 倍
Hugging Face 的實作範例針對 4,874 個 Natural Questions 段落建立索引。lightonai/LateOn 從中產生 608,414 個 token 向量,平均每段 124.8 個向量。
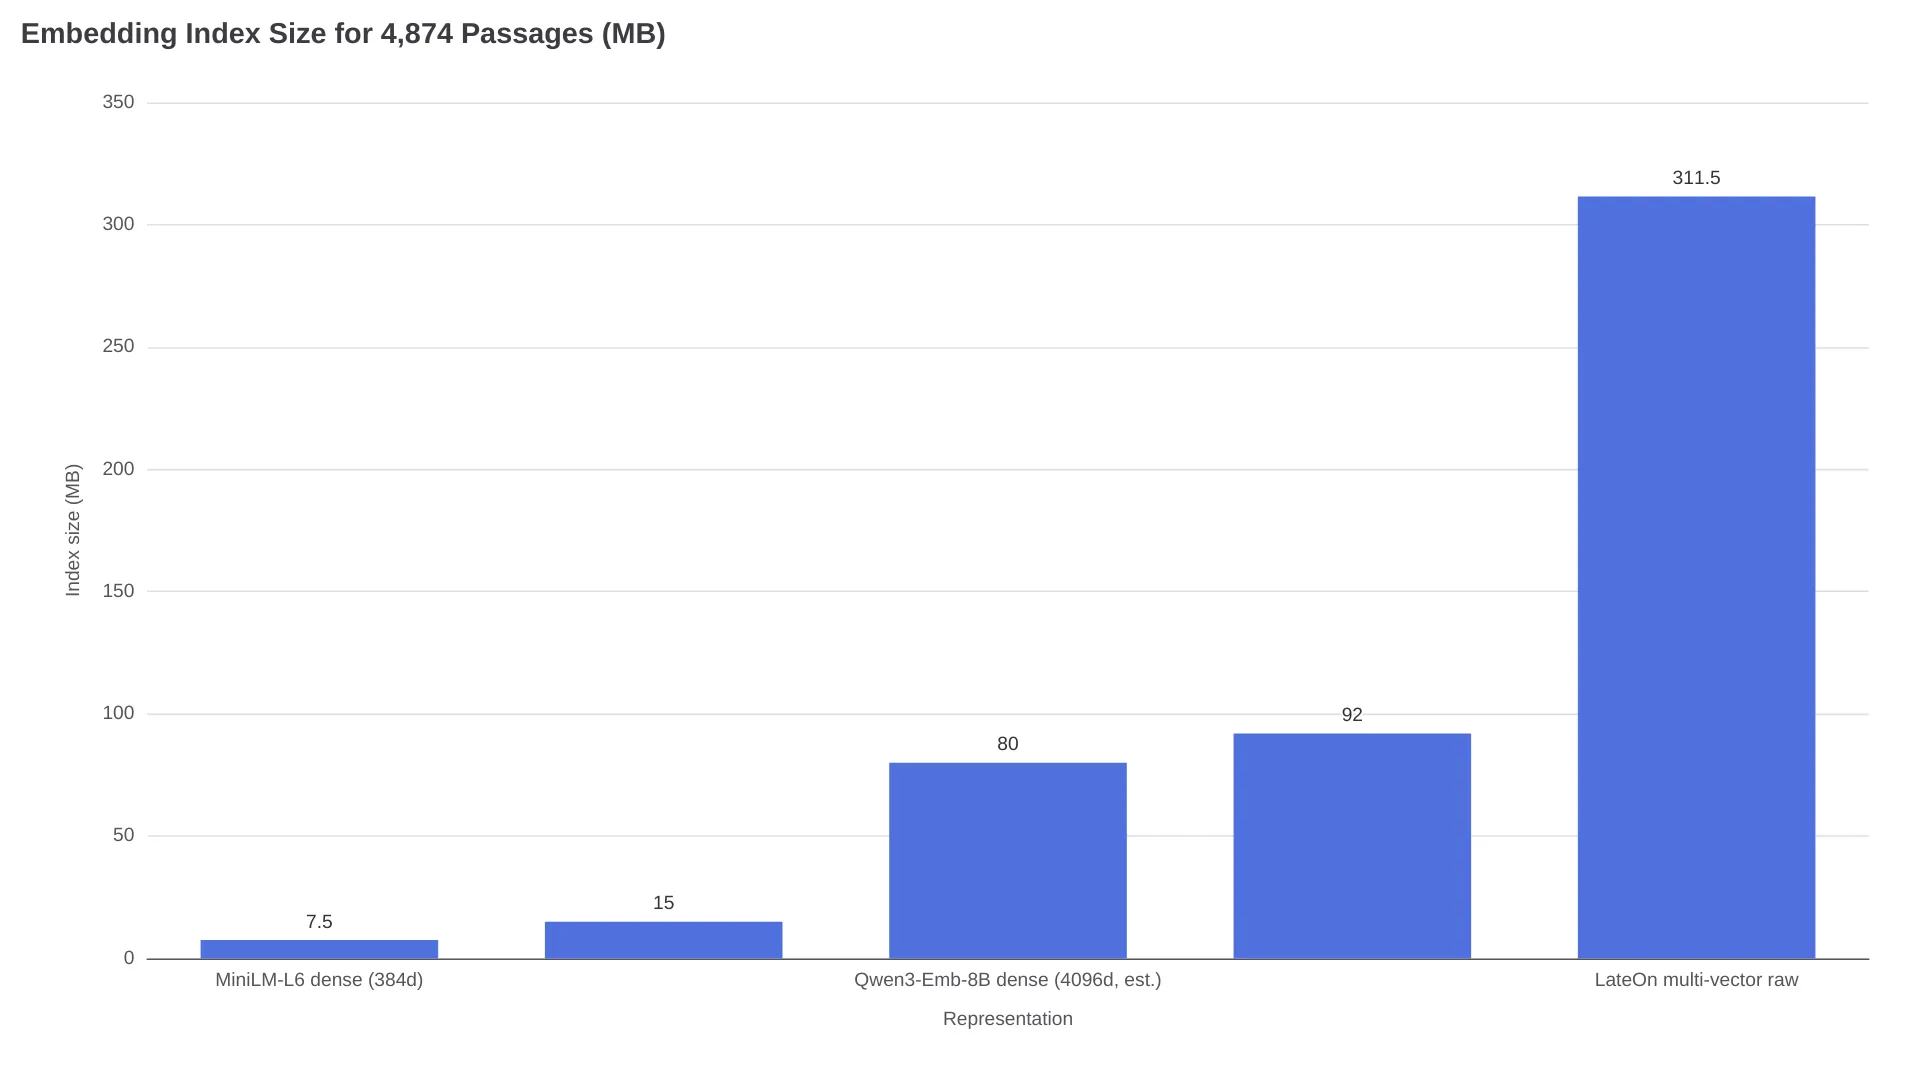
原始 float32 多向量索引大小為 311.5 MB。相同段落若使用 all-MiniLM-L6-v2 dense 模型,只需 7.5 MB,相差 42 倍,或每段 62 KiB。若與同級的 768 維 dense 模型 gte-modernbert-base 比較,差距仍有 21 倍(15 MB)。TopK 指出,依文件長度與精度而定,差距通常落在 10–100 倍;每次查詢的計分工作量,也可能是單向量比較的數千倍。
發布當天,一位開發者直接點出了上線時最棘手的問題:
Token pooling 才是決定能不能上線的關鍵。Late interaction 通常不是死在準確度,而是死在索引大小與記憶體。 - X 上的 @JudeJobs
換個尺度來看:若在同一語料上使用 4,096 維的 Qwen3-Embedding-8B dense 索引,大小約為 80 MB,已接近下文壓縮後 late-interaction 索引的 92 MB。
把索引縮小的三種手段
1. Token pooling。Sentence Transformers v6.0 內建 HierarchicalTokenPooling:它以 cosine distance 的 Ward linkage 對文件 token 向量分群,再用各群平均值取代原始向量。Pooling 預設只用於文件,因為查詢通常短,且對失真較敏感。針對這個 608,414 向量的語料:
| Pooling 倍率 | Token 向量數 | float32 索引 | 報告的檢索保留率 |
|---|---|---|---|
| 1(不壓縮) | 608,414 | 311.5 MB | 100% |
| 2 | 305,438 | 156.4 MB | 100.6% |
| 3 | 204,407 | 104.7 MB | 99.0% |
| 4 | 153,936 | 78.8 MB | 約 98% 的趨勢 |
完整語料的 pooling 約花 6 秒。LightOn 的正則化變體在 Hugging Face 發布文中聲稱,5 倍壓縮下仍保有 99.4% 品質;不過 Hugging Face 也註明,截至 v6.0 發布時,該 regularizer 的訓練尚未整合到函式庫中。
2. 壓縮索引。相同向量建立的 fast-plaid(Rust PLAID)索引佔用 92 MB,建置需 5 秒;在 RTX 3090 + i7-13700K 上,查詢回應時間為 11 ms。它屬於近似搜尋:Hugging Face 測試中,最高分從 11.92 漂移至 11.88,但排名維持不變。Weaviate 的 MUVERA 讓寫入快 3 倍、查詢快 1.8 倍,不過在其測試語料中,top 50 少了一筆正確結果。
3. 量化與推論調校。Qdrant 針對 token embedding 的 uint8 scalar quantization 實驗,記憶體降為四分之一,SciFact NDCG@10 僅從 0.70724 變為 0.70297,影響可忽略。Hugging Face 指出,fp16 加上 Flash Attention 的編碼吞吐量是 fp32 的 2.44 倍,沒有測得品質損失;CPU 上使用 int8 則約損失 0.4% 準確度。
將 2–3 倍 pooling 與壓縮索引疊加後,和 dense 的實際差距能從 42 倍降到個位數;代價是多了兩個需要調整的參數。
預設部署方式:第一階段檢索,第二階段 MaxSim 重排
對全部 4,874 份文件做窮舉 MaxSim,在單張 RTX 3090 上需 98 ms,端到端為 122.7 ms。對幾千份文件完全沒問題,但面對數百萬份文件,線性成本會成為災難。本文比較的三份部署指南都收斂到同一架構:第一階段先用便宜的 dense 或 sparse 方法取回候選,再以 late interaction 重排。
- Hugging Face 的範例先取 dense top 50,再用 MaxSim 重排。文件只需批次編碼一次,並透過矩陣乘法計分,比 cross-encoder 對每組樣本執行 forward pass 便宜得多。
- Qdrant 自 v1.10 起就提供原生多向量支援,其建議是將 late interaction 主要用於重排數百筆候選,而非全量掃描。
- Data AI Hub 的生產環境指南建議先以 hybrid retrieval 取 top 150,以 late interaction 重排至 20,接著可選擇用 cross-encoder 處理最終送往 LLM 的 top 5。
只做 rerank 的模式有一個硬限制:第一階段漏掉的文件,它無法救回來。而且周邊流程至今仍沒有定論:
幾乎不存在一套普遍適用的 chunking、retrieval 與 re-ranking 策略。 - u/gamerx88,r/MachineLearning
哪些資料庫支援多向量,實際表現如何
Hugging Face 的發布文以相同的 4,874 段語料測試主要引擎。下列是其測試結果,不是廠商行銷數字:
| 引擎 | 原生多向量支援起始版本 | 寫入/查詢(其測試) | 注意事項 |
|---|---|---|---|
| Qdrant | v1.10 | 26.3 s / 18 ms | 精確 MAX_SIM;建議使用 server |
| Weaviate | v1.29 | 41 s / 17 ms | MUVERA 較快但漏掉一筆正確結果;Windows 不支援 embedded mode |
| Vespa | 「多年來」 | 約 80 s / 預熱後 75 ms | 以 tensor expression 實作 MaxSim;預設第二階段只重排 100 筆候選,漏掉正確 top 3 中的 2 筆 |
fast-plaid | - | 5 s / 11 ms | 沒有 server;分數為近似值,但排名維持不變 |
| LanceDB | v0.15.0 | 未測試 | 原生 MaxSim |
| Milvus | v2.6.4 | 未測試 | 採用 array-of-structs 儲存 |
| VectorChord | - | 未測試 | 為 PostgreSQL 提供 MaxSim operator |
| Elasticsearch / OpenSearch | - | - | 僅支援 rescore;ES 功能在 Enterprise tier 中仍是 technical preview |
Hugging Face 的比較表也將 turbopuffer 的 late-interaction 索引列為 private beta。
Sentence Transformers v6.0 實際改變了什麼
在 2026 年 8 月 18 日以前,要執行 ColBERT 系列模型,通常得依賴獨立框架,例如 PyLate、Stanford ColBERT repo 或 colpali-engine。6.0 版讓 MultiVectorEncoder 成為函式庫的第四種一級模型類型,內建訓練、推論與可解釋性功能。它可載入 Sentence Transformers、PyLate、Stanford ColBERT 與 ColPali checkpoints;純 transformer 也能載入,但會使用需要訓練的隨機 projection。所需版本為 transformers v5.x、torch 2.2+ 與 huggingface-hub v1.x。
發布文件列出三個容易踩到的坑:
- 查詢與文件並不對稱。
encode_query()和encode_document()使用不同的 prompts、長度上限與 scoring masks。兩邊都直接呼叫通用encode(),是最快讓結果悄悄變差的方式。 - 截斷不會提醒你。一段 662-token 的內容送進 LateOn 300-token 的文件上限後,只產生 273 個向量,其餘內容被捨棄。提高到 512 雖然可行,但模型會偏離訓練分布,索引也會變大。
- Flash Attention 並非全都適用。包含 non-attend query expansion 的模型,例如
colbert-ir/colbertv2.0與answerai-colbert-small-v1,必須改用"sdpa"。
依 Hugging Face 公布的分數,支援模型橫跨兩個數量級:
| 級距 | 範例模型(參數量) | 分數(平均 NDCG@10) |
|---|---|---|
| Edge 文字模型 | mxbai-edge-colbert-v0-17m (17M) | 0.6407 NanoBEIR |
| 小型文字模型 | answerai-colbert-small-v1 (33M) | 0.6550 NanoBEIR |
| 文字模型領先者 | LateOn family (149M) | 0.6868–0.6897 NanoBEIR |
| 視覺文件模型 | colqwen2.5-v0.2 (3.8B) / webAI-ColVec1.1-8b (8.4B) | 0.5402 / 0.6580 NanoViDoRe |
哪些情況仍該選擇單向量 Dense 模型
最該避免的失誤,是替根本不需要多向量的工作負載導入多向量。若查詢很廣泛、偏主題式,例如「供應鏈相關文章」;內容很短,例如標題、FAQ 配對、推文;任務是分群、去重或推薦,也就是需要整體項目相似度的工作;又或者 dense 加 reranker 的流程已符合 recall SLO,而成本才是主要瓶頸,都應跳過它。Data AI Hub 指南還補充:以英文為主的 ColBERT checkpoints 在多語語料上,可能不如多語 bi-encoder 加 reranker 的組合;而寫入頻繁、即時變動的語料,也不適合 token 級索引。
常見問題:直接看數字
一般 dense 模型能當成多向量模型用嗎?
有時候可以,而且效果意外地好。Qdrant 的實驗直接取用 BAAI/bge-small-en——一個 33M dense 模型——輸出的 token embeddings,再以 MaxSim 計分:在 SciFact 上取得 0.73696 NDCG@10,勝過 0.69579 的 colbert-ir/colbertv2.0,也高於 bge-small 自己 pooled vector 的 0.68213。不過在 ArguAna 上結果相反,pooled dense 勝出。這是不用換模型就能新增 reranking 階段的合理技巧,不是保證有效的萬靈丹。
壓縮後的多向量索引能快多少?
在這個 4,874 段語料上:窮舉 MaxSim 為 98 ms,fast-plaid 為 11 ms;索引大小則從 311.5 MB 降至 92 MB。
多向量模型會取代 cross-encoder reranker 嗎?
就經濟性而言會:文件表示可預先計算,計分使用矩陣乘法,不必對每組 query-document 執行一次 forward pass。不過 Hugging Face 發布文仍將 cross-encoder 列為每對樣本最準確的選項,因此高要求流程仍會保留它處理最終 top 5–20。
Late interaction 值得用在 RAG 嗎?
若作為 hybrid 或 dense 候選結果上的 reranking 階段,值得,這也是上述三份部署指南都建議的模式。至於作為第一階段檢索器,只有在量測後確認第一階段 recall 才是失敗原因,且 token-vector 索引也符合預算時才該考慮。
選型速查表
| 你的工作負載 | 建議 |
|---|---|
| 識別字密集或多條件查詢、長文件、法律/技術文本 | 採用多向量檢索或重排——這正是 MLDR +26 點差距的適用範圍 |
| PDF、掃描頁面、表格、以頁面影像呈現的圖表 | 選擇 ColPali 系列多向量模型;不需要 OCR 流程 |
| 廣泛主題搜尋、短文本、分群/去重/推薦系統 | Dense 單向量;pooling 的損失在這裡無關緊要 |
| 品質已經接近目標,但預算吃緊 | 保留 dense 第一階段,對 top 50–150 加上 MaxSim 重排 |
| 數百萬份文件,成本受限 | Dense + cross-encoder reranker,或在量測後採用壓縮 late interaction(pooling factor 2–3 + fast-plaid) |
@JudeJobs 指出的取捨仍未有定論:壓縮保留率是在基準測試中量得,不是在雜亂的生產語料中。先用 factor 2 pooling,再根據你自己資料上的 recall,決定要沿著壓縮曲線走到多遠。