 AIREITER
在 FinanceBench 的測試中,Mistral 表示新推出的 Agentic Search 層,較單次 RAG 可將答案準確率提升 47 至 53 個百分點;若啟用完整導航迴圈,最高可增加 59 個百分點。這套測試涵蓋 368 份 SEC 文件、約 53,900 頁內容與 150 道問題,同時最多可減少三分之一的 token 用量。但代價也很明確:完整迴圈的 p90 延遲仍達 154 秒,平均則是 71 秒。
Mistral Agentic Search 於 2026 年 8 月 20 日公布,定位是處理申報文件、合約、掃描 PDF 等複雜企業文件的檢索層。它不是網路搜尋功能的升級版;若要換取更高準確度,就得接受這個以分鐘計的處理迴圈。
Mistral Agentic Search 到底是什麼?
Mistral Agentic Search 是在 2026 年 8 月 20 日推出的檢索層,會在既有索引外包上一個多步驟迴圈,並使用五種工具:search、open、navigate、read 與 grep。它可透過 Mistral Search Toolkit 使用,也已整合至 Studio 與 Vibe 的 Libraries。索引仍由你掌握,不必微調模型;代理迴圈專門處理單靠 chunk 檢索難以回答的問題。
五種工具如何接力找答案?
用 Mistral 提供的案例最容易理解這套機制:查詢 1953 曆年美國國防支出時,單次 search 雖找到 1 月至 6 月的數據,卻漏了 7 月至 12 月。Agentic Search 則進行兩次搜尋,找出 treasury_bulletin_1954_02.pdf,接著讀取第 15 頁的表 3,最終取得完整 12 個月數值,全年合計為 44,463 百萬美元。
| 工具 | 用途 |
|---|---|
search | 在索引中查詢可能的來源 |
open | 開啟已定位的文件 |
navigate | 移動至文件內的頁面、表格或段落 |
read | 擷取該位置的內容 |
grep | 比對精確 token、代碼或識別碼的模式 |
單次 RAG 會取回一組固定 chunks,並在單一回合內作答;檢索結果不夠好時,它無法主動再找另一份文件。這個迴圈則能交叉比對來源、沿著註腳與表格追查,也能從不完整結果中修正方向。Mistral 的說法是,這種取捨帶來的不是更多無效重試與來回,而是更少。
官方基準測試真正說了什麼
公告中列出兩組基準測試,皆由廠商自行報告,採用未調校的 Search Toolkit 預設設定;Mistral 對結果的定義是「這些是下限,不是上限」。FinanceBench(Islam et al., 2023;開放版本見 GitHub)包含 368 份 SEC 的 10-K、10-Q 與 8-K 申報文件,依 Mistral 統計每份約 147 頁,並有 150 道問題。Mistral 的測試設定以經人工標註校準的 LLM 判定答案。
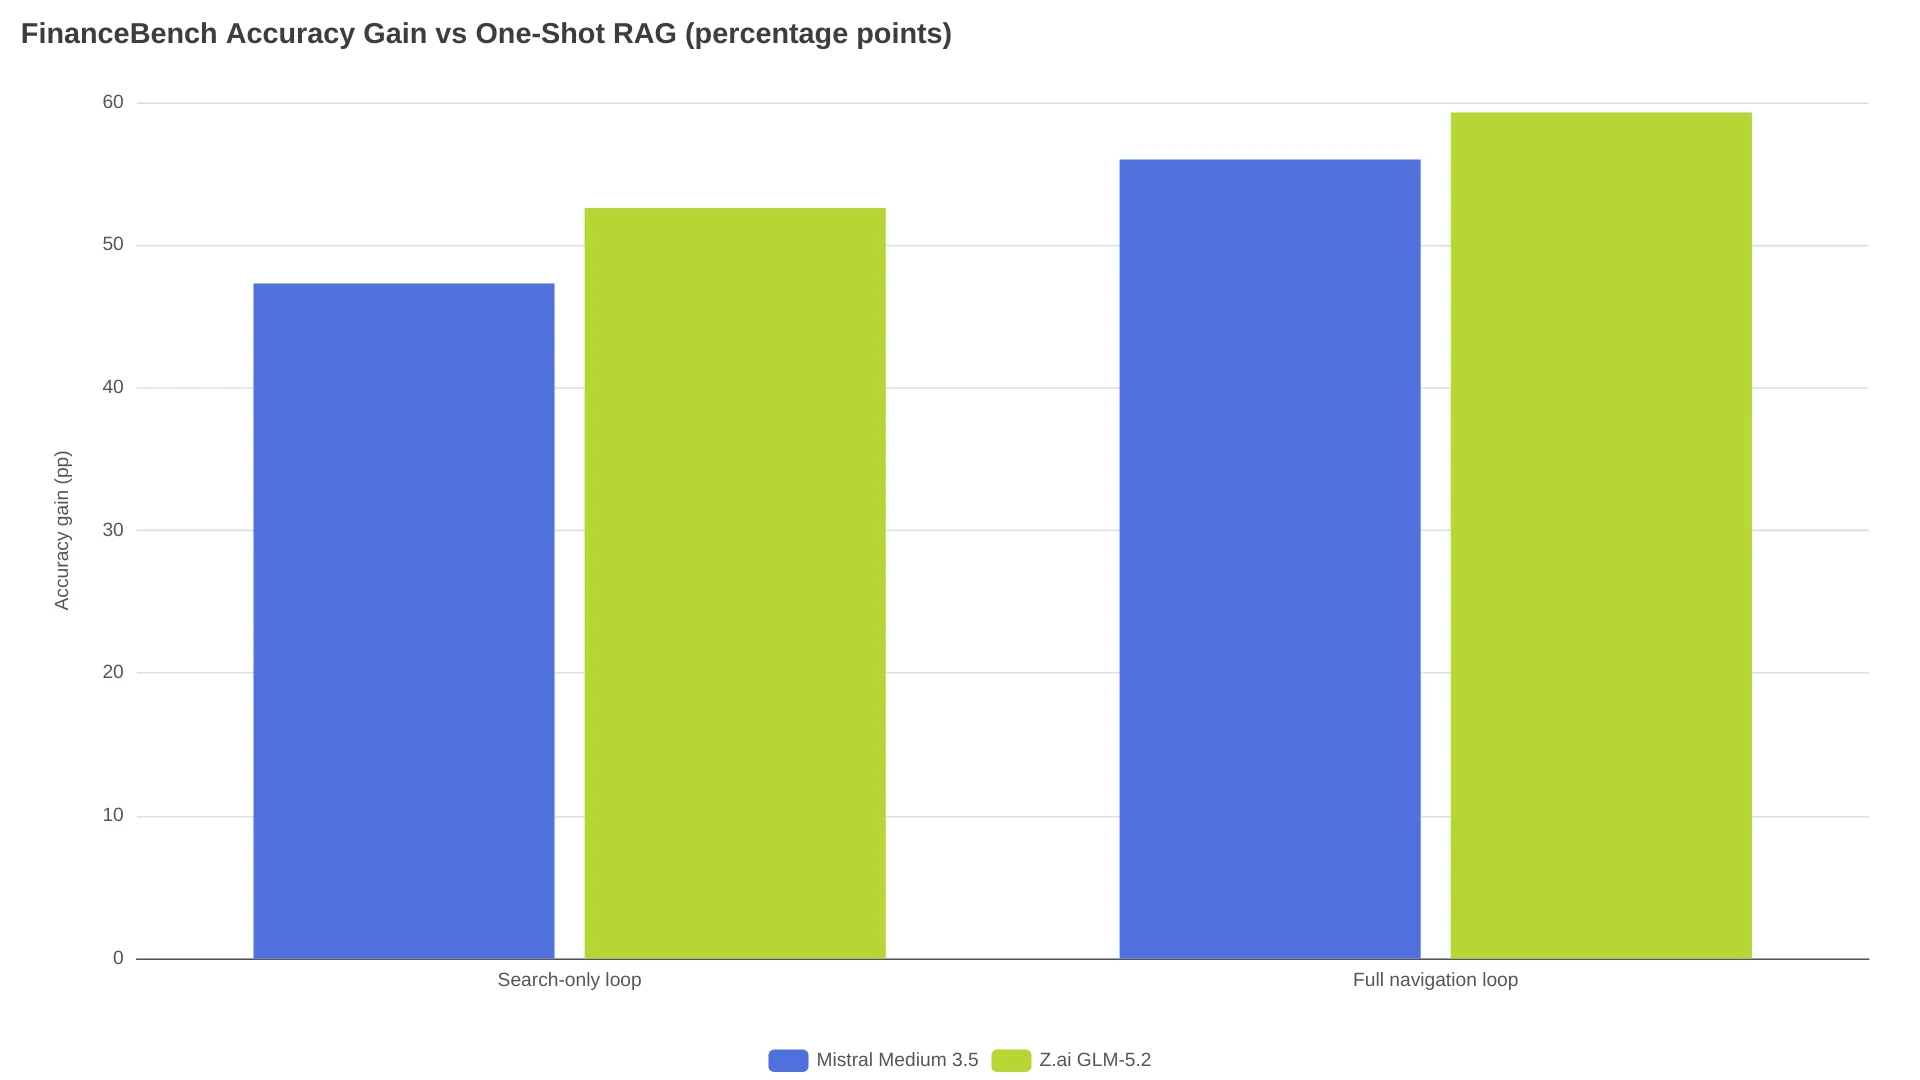
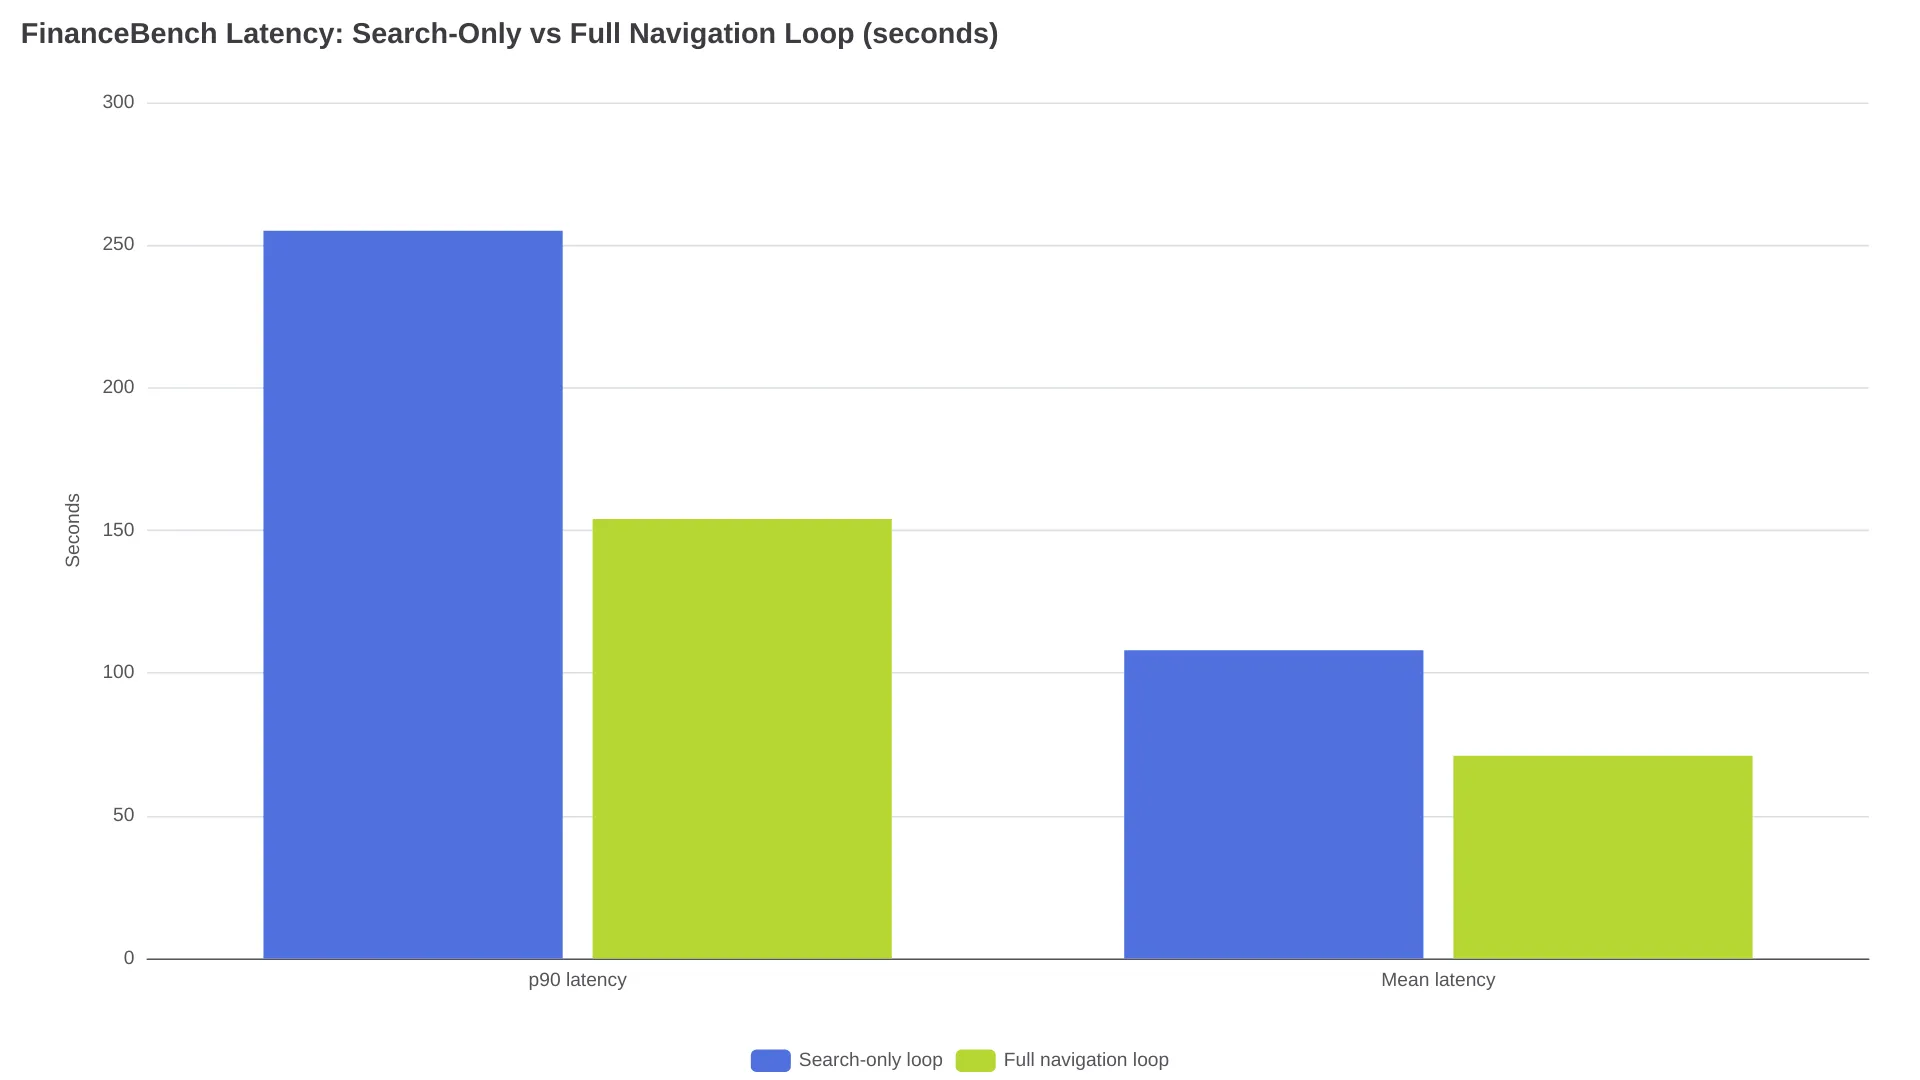
在僅搜尋的迴圈上加入導航工具,也就是 open、navigate、read 與 grep,Mistral Medium 3.5 再增加 8.7 個百分點,GLM-5.2 則增加 6.7 個百分點。相較於僅搜尋的迴圈,完整導航迴圈讓 Mistral Medium 3.5 少用 23.9% token,GLM-5.2 少用 33.7%。延遲也朝相同方向改善:p90 從 255 秒降至 154 秒,平均值則由 108 秒降至 71 秒。要注意比較基準:token 減量是相對於僅搜尋的 agentic 迴圈,不是相對於單次 RAG。
OfficeQA Pro 的難度更高:資料集收錄 696 期歷史美國財政部公報,約 89,000 頁以表格為主的掃描政府 PDF,並設有 133 道問題。GLM-5.2 在完整迴圈下達到 51.9% 準確率,增加 45.6 個百分點,意味著單次模式的基準為 6.3%;Mistral Medium 3.5 則提升 27.1 個百分點。導航最多還可減少 7.0% 的回合數。
Mistral 測試了自家的 Mistral Medium 3.5,以及第三方的 Z.ai GLM-5.2,兩者都呈現相同的提升模式。公告也引用 Kimi 的研究:在 Claude Code harness 下,GLM-5.2 在 OfficeQA Pro 的成績為 41.4%,而在 Mistral 的 harness 下則為 51.9%。由於未附上 Kimi 的第一手來源,這 10.5 個百分點的 harness 差距仍只是 Mistral 的說法。Mistral 的結論是「檢索品質會隨模型能力擴展」,意指瓶頸在 harness,而非模型本身。
哪些情境單次 RAG 反而更適合?
Mistral 自己也強調,索引檢索仍是基礎;Agentic Search 適合的是初始結果不足的情況。選擇關鍵主要在於文件型態與可接受的延遲預算:
| 你的工作負載 | 建議起點 |
|---|---|
| 短小、乾淨文件中的直接查詢 | 單次 RAG |
| 高量關鍵字或語意檢索 | 單次 RAG |
| 答案位於已知位置 | 單次 RAG |
| 包含表格與註腳的申報文件、合約、手冊 | Agentic Search |
| 掃描的表格密集型 PDF | Agentic Search |
| 答案分散於多份文件、需要交叉核對 | Agentic Search |
| 需要互動式延遲(秒級) | 單次 RAG |
如果產品無法接受 p90 達 154 秒,再高的準確率也無濟於事。但若是批次分析財務報表,情況就不同了。
Agentic Search 不等於 web_search
搜尋這項產品時,Google 會帶出 Mistral 的 websearch 文件,但兩者其實不同。web_search 與 web_search_premium 屬於 Agents API,會即時檢索網路並提供引用;依 Mistral API 定價頁面,每 1,000 次呼叫分別收費 30 美元與 50 美元,另加模型 token 費用。Agentic Search 則是反過來深挖你自己的已索引資料庫,不會查詢開放網路。兩者解決的問題不同,且只有其中一者已公開定價;公告中沒有任何 Agentic Search 的費率。
兩種開始方式
- Search Toolkit。提供擷取、embeddings 與索引功能的開放模組,可部署於雲端或地端環境,並可設定解析器、chunking、embedding 模型、Vespa schemas、ranking profiles 與混合檢索。
- Studio 與 Vibe Libraries。這是託管式途徑;Search Starter App 能以預設設定,針對你的語料建立本機索引。在開始調校前,這也是重現基準測試設定最快的方法。
無論採用哪種方式,先以相同的一組代表性問題測試單次 RAG 與完整迴圈,再比較答案品質、token 用量與 p90 延遲,最後才決定是否導入。
發布時仍未解答的問題
Mistral 尚未公布 Agentic Search 的定價,基準結果也由廠商自行報告;發布時尚無獨立實作測試可供驗證。最早的公開反應仍屬初步印象:
「mistral 剛把 agentic search 加進他們的 api,這步走對了。把類似 Perplexity 的搜尋包成原生 agent 工具,讓我們不用自己寫脆弱的網頁爬蟲流程,也不必管理 proxy rotation。」— AI 產品開發者 @AbdoKerdawy(X)
至於 token 的說法,已有質疑指出 Mistral 的公告尚未完全回答這個問題:
「Mistral 的 agentic search 檢索工具聲稱能把單次搜尋失敗減少超過 40%。如果它避開資料庫查詢,是否也能減少你必須花費的 token 數量?」— 獨立部落客 @therawlogs(X)
官方回答是:相較於僅搜尋的迴圈,token 可減少 24–34%。這是否能在基準資料集以外成立,正是透過開放的 FinanceBench 資料集進行獨立測試才能確認的事。
相鄰產品也面臨同樣的物理限制:Mixedbread 的 Toast-1 agentic search 模式,將迴圈限制為四輪與八次平行檢索呼叫,其文件也明確表示它比單次搜尋慢。對這一類產品來說,延遲就是為準確度支付的代價。
直接回答幾個重點
Mistral Agentic Search 能透過 Agents API 使用嗎?
不能。它透過 Mistral Search Toolkit,以及 Studio 和 Vibe 的 Libraries 提供;Agents API 的 web_search 則是另一項即時網路搜尋產品,定價也獨立計算。
Agentic Search 真的能減少 token 用量嗎?
依官方基準測試,在 FinanceBench 上,完整導航迴圈比僅搜尋的 agentic 迴圈少用 23.9–33.7% token;目前尚未有獨立重現結果。
哪些模型可搭配 Agentic Search?
Mistral 測試了 Mistral Medium 3.5 與 Z.ai GLM-5.2,兩者都有一致的提升。官方將這個檢索層描述為模型無關,且不需要微調。
Mistral Agentic Search 要多少錢?
Agentic Search 本身尚未公布價格。Mistral 定價頁面上的每 1,000 次呼叫 30 美元,屬於較早推出的 web_search agent 工具。
尚未解決的取捨其實很簡單:這是用分鐘級等待換取準確度。對申報文件、合約與掃描政府紀錄的批次工作來說,完整迴圈在 OfficeQA Pro 與 FinanceBench 分別提升 45 至 59 個百分點的準確率,並相較較慢的迴圈減少約三分之一 token,這樣的交換可以成立。但對任何面向使用者的功能而言,71 秒平均延遲依然難以接受。在 Mistral 以外的團隊重跑 FinanceBench 之前,頁面上最亮眼的數字終究仍是廠商自己的結果。
延伸閱讀:GLM-5.2 API guide 與 GLM-5.2 review,可了解 Mistral 測試中使用的另一款基準模型。