 AIREITER
2026 年 8 月 19 日,Liquid AI 在 LFM2.5-2.6B repo 裡,於原本的 Q4_0 旁新增了一個 1.59 GB 檔案。兩者大小相同、檔名幾乎一樣,模型卻不是同一回事。新版採用 QAD,也就是 quantization-aware distillation(量化感知蒸餾),能補回 4-bit 量化損失的大部分品質;但若下載到兩個檔案中錯的那一個,跑到的仍是未修補的舊版。
QAD 如何減少 4-bit 量化損失
QAD 是 quantization-aware distillation 的縮寫。Liquid AI 為 LFM2.5-230M、LFM2.5-350M、LFM2.5-1.2B-Instruct 與 LFM2.5-2.6B 這四個模型,在訓練階段就讓模型適應 Q4_0 的捨入誤差;高精度教師模型會在訓練時將知識蒸餾給量化後的學生模型。
換句話說,模型權重在訓練期間已經看過量化誤差,並學會繞開它。repo 裡原有的 Q4_0 則屬於後訓練量化(PTQ):先完成 BF16 模型,再將其直接捨入為低位元格式,過程中沒有任何機制補償誤差。根據 Liquid AI 的發布文章,四個 QAD checkpoint 在涵蓋推理、指令遵循、工具使用與代理行為的測試套件中,平均都能「達到約 97% 的 BF16 平均表現」;結果取五次執行的平均值。QAD 是訓練端的改良,不是新檔案格式,輸出仍是 llama.cpp 可直接執行的標準 GGUF Q4_0。
同尺寸、近似檔名:下載時最容易踩的坑
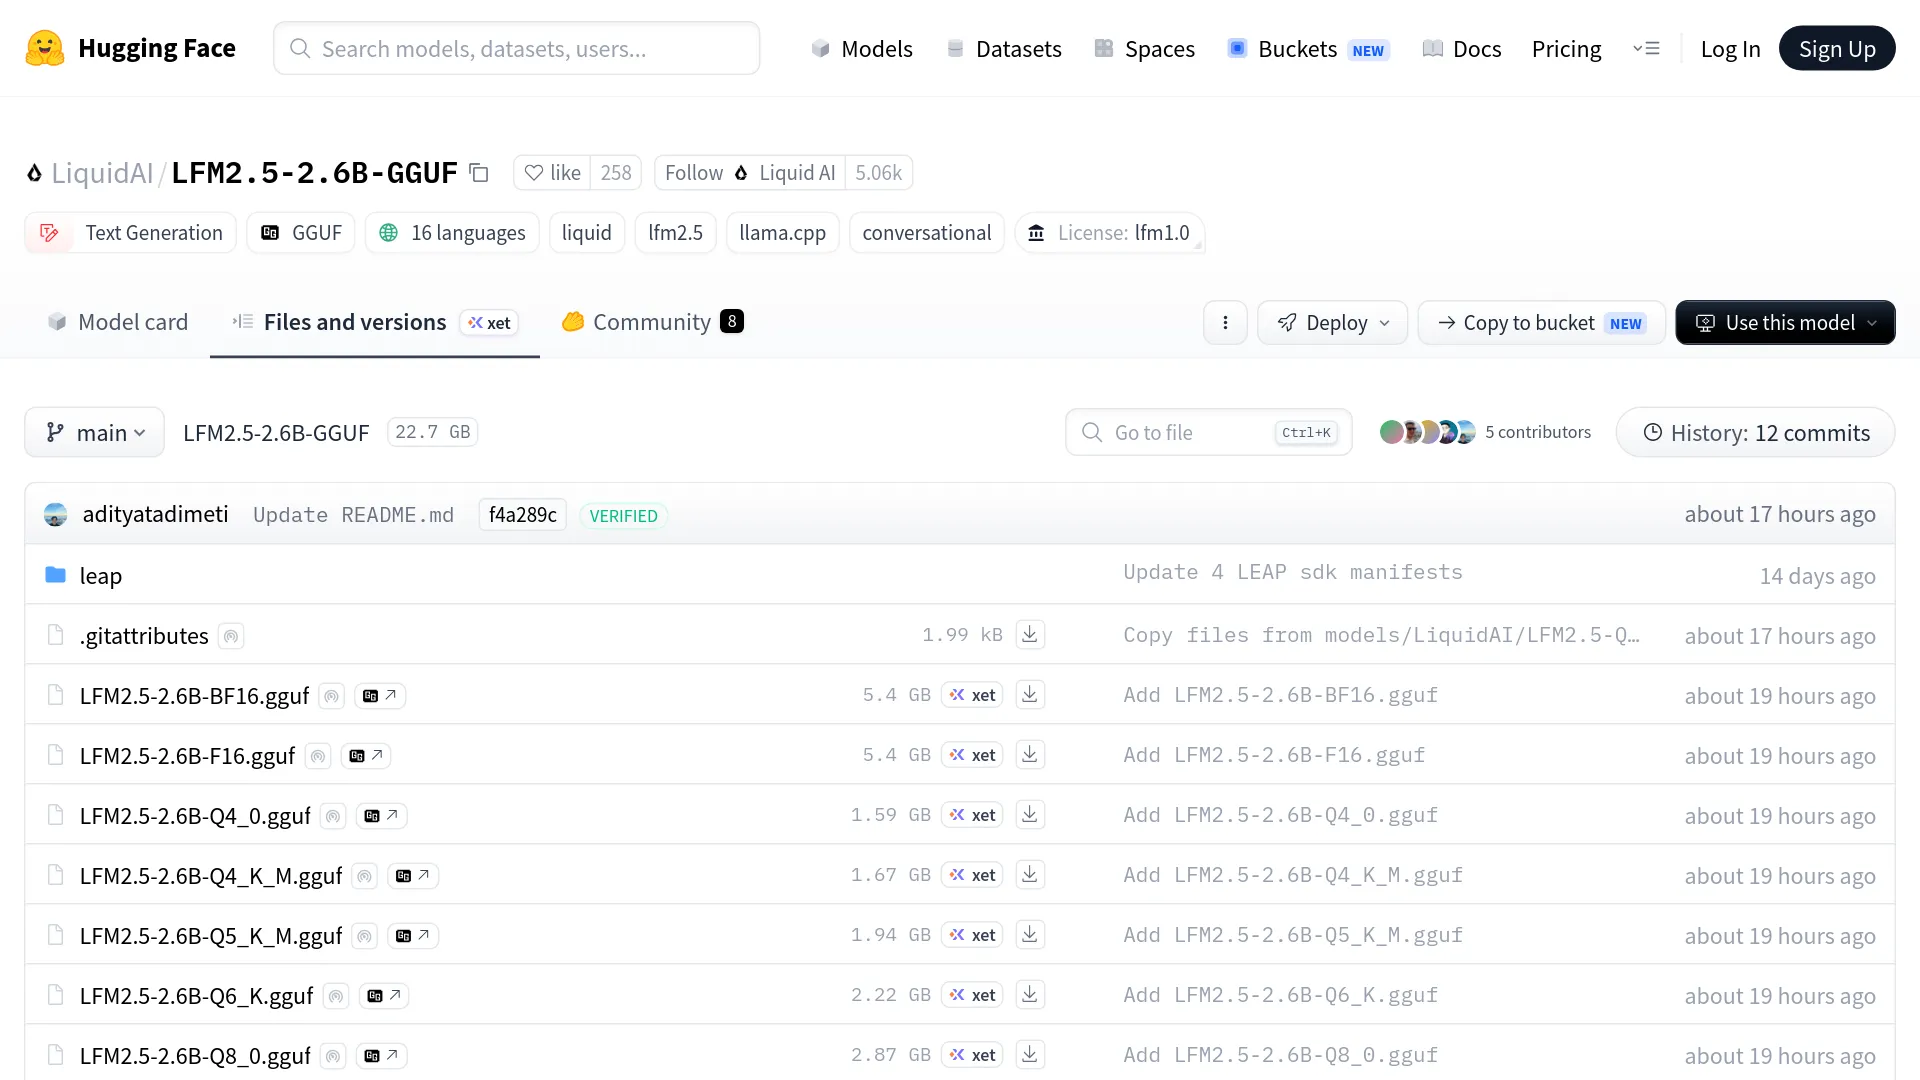
LFM2.5-2.6B repo 同時提供 LFM2.5-2.6B-Q4_0.gguf 與 LFM2.5-2.6B-QAD-Q4_0.gguf,兩者頁面上都標示為 1.59 GB。更麻煩的是,repo 預設範例指向的是 Q4_K_M,不是 QAD;直接複製貼上指令,兩個 QAD 檔都不會下載到。必須手動指定檔名。
發布後幾小時內,社群就已經出現困惑:
「要去哪裡下載?我在 Hugging Face 看得到,但不確定那是一般版本還是 QAD。可以指導一下嗎?」— X 上的 @Chitacc72
早期使用者 @MarMarLabs 比對 repo 檔案後發現,舊版與新版 Q4_0 的差異約只有 4 KB,在檔案瀏覽器裡幾乎無從辨識。解法是用 --hf-file 明確指定 QAD 檔名:
# Liquid AI 發布文章中的官方範例
llama-cli -hf LiquidAI/LFM2.5-350M \
  --hf-file LFM2.5-350M-QAD-Q4_0.gguf \
  -p "What is C. elegans?"

# 2.6B,採用官方 model card 的取樣參數
llama-cli -hf LiquidAI/LFM2.5-2.6B-GGUF \
  --hf-file LFM2.5-2.6B-QAD-Q4_0.gguf \
  -c 4096 --temp 0.1 --top-k 50 --repeat-penalty 1.1
230M 與 1.2B-Instruct repo 也同樣要用 --hf-file 指定檔案。至於 server 使用情境,@nicolasembleton 發現 Hugging Face 產生的指令並不完整後,貼出了可用的簡寫:llama serve -hf LiquidAI/LFM2.5-2.6B-GGUF:QAD-Q4_0。冒號後面的限定詞,就是選取 QAD build 的關鍵。
官方數據能證明什麼,不能證明什麼
Liquid AI 的 benchmark 表顯示,各 QAD checkpoint 保留了原始 BF16 基線品質的 96.5% 至 97.4%。測試套件包括 GPQA Diamond、MMLU-Pro、IFEval、IFBench、Multi-IF、BFCLv4;兩個小型模型另有 GSM8K,兩個較大型模型則加入 AIME25,全部取五次執行的平均值。
| Checkpoint | 保留的 BF16 品質 | 品質定位 | 解碼吞吐量 |
|---|---|---|---|
| LFM2.5-230M | 97.1% | 與 Q5_K_M 的差異落在變異範圍內 | 比 Q5_K_M 快 +4–33% |
| LFM2.5-350M | 96.5% | 與 Q5_K_M 的差異落在變異範圍內 | 比 Q5_K_M 快 +4–33% |
| LFM2.5-1.2B-Instruct | 97.4% | 與 Q4_K_M 相當 | 比 Q4_K_M 快 +3–14% |
| LFM2.5-2.6B | 96.6% | 與 Q4_K_M 相當 | 比 Q4_K_M 快 +3–14% |
吞吐量測試涵蓋四種目標裝置:MacBook Pro 與 NucBox EVO-X2 的 GPU,以及 Samsung Galaxy S26 Ultra 與 Raspberry Pi 5 的 Arm CPU。針對 230M 與 1.2B 模型,Liquid AI 也表示 QAD Q4_0 可對上 Unsloth 的 UD-Q4_K_XL;發布文章將後者稱為表現強勁的外部 PTQ checkpoint。
但發布文章沒有列出各 benchmark 的個別分數、各裝置的原始 tokens-per-second、檔案大小、RAM 用量或變異誤差條。已公布的內容只有百分比區間與「表現相當」的說法。社群很快就把檔案大小換算成更直觀的數字:
「所以我可以把本機的 LFM2.5-2.6B 從 F16 換成 QAD Q4_0,從 5.4 GB -> 1.6 GB、21 -> 64 tok/s……同時保留約 97% 的 BF16 表現?」— @firedUp_Neyu,根據 Liquid 的發布圖表解讀
其中檔案大小的計算無誤:官方 repo 中,F16 是 5.4 GB,QAD Q4_0 是 1.59 GB。不過 tok/s 數字是該使用者從圖表讀出的結果,不是 Liquid AI 以文字直接公布的數據。
發布公告沒交代的三件事
若你正在評估是否將部署換成這些檔案,以下三個缺口值得注意。
只有四個 checkpoint 支援。截至發布時,LFM2.5-VL-450M 與 LFM2.5-8B-A1B 都沒有 QAD build;X 上的發布討論串中,也已有使用者要求 Liquid AI 推出 8B 版本。如果你的裝置目標是這兩個模型,QAD 目前對你沒有影響。
imatrix 仍是未解問題。QAD 檔案雖為 Q4_0 訓練,但產製時未使用 importance matrix;量化圈使用者立刻點出了這件事:
「這個 QAD Q4_0 GGUF 產生時沒有使用 imatrix,而 imatrix 也能進一步提升經 QAD 訓練模型的品質。」— r/LocalLLaMA 的 u/Chromix_
不到 3B 的模型,本質上仍是不到 3B 的模型。量化補償不會提高模型的能力上限,LocalLLaMA 討論串已有實際案例。一位 NPU 使用者表示:
「我剛在 NPU 上實作 LFM2.5 2.6B 來做會議摘要。以這個尺寸來說確實令人印象深刻,但摘要品質仍遠不如更大的模型。」— u/DerDave
這個上限來自模型本身,不是量化方式。KikoCis 量化報告記錄到,即使在 Q8_0 下,SWE-bench Verified 的 6 個 instance 也只有 0 個解決。1.2B 使用者也回報品質會隨 runtime 而波動:某個 Ollama 設定中,10 個 prompt 有 9 個產生亂碼;另一個案例則是在單板電腦上以低於 5W 的功耗有效運作。若某項任務真的需要前沿品質,可透過低成本 LLM API,將本機輸出與大型模型交叉比對;跑完整組測試 prompt 的成本只要幾美分。
QAD Q4_0 與 Q4_K_M:該選哪個檔案?
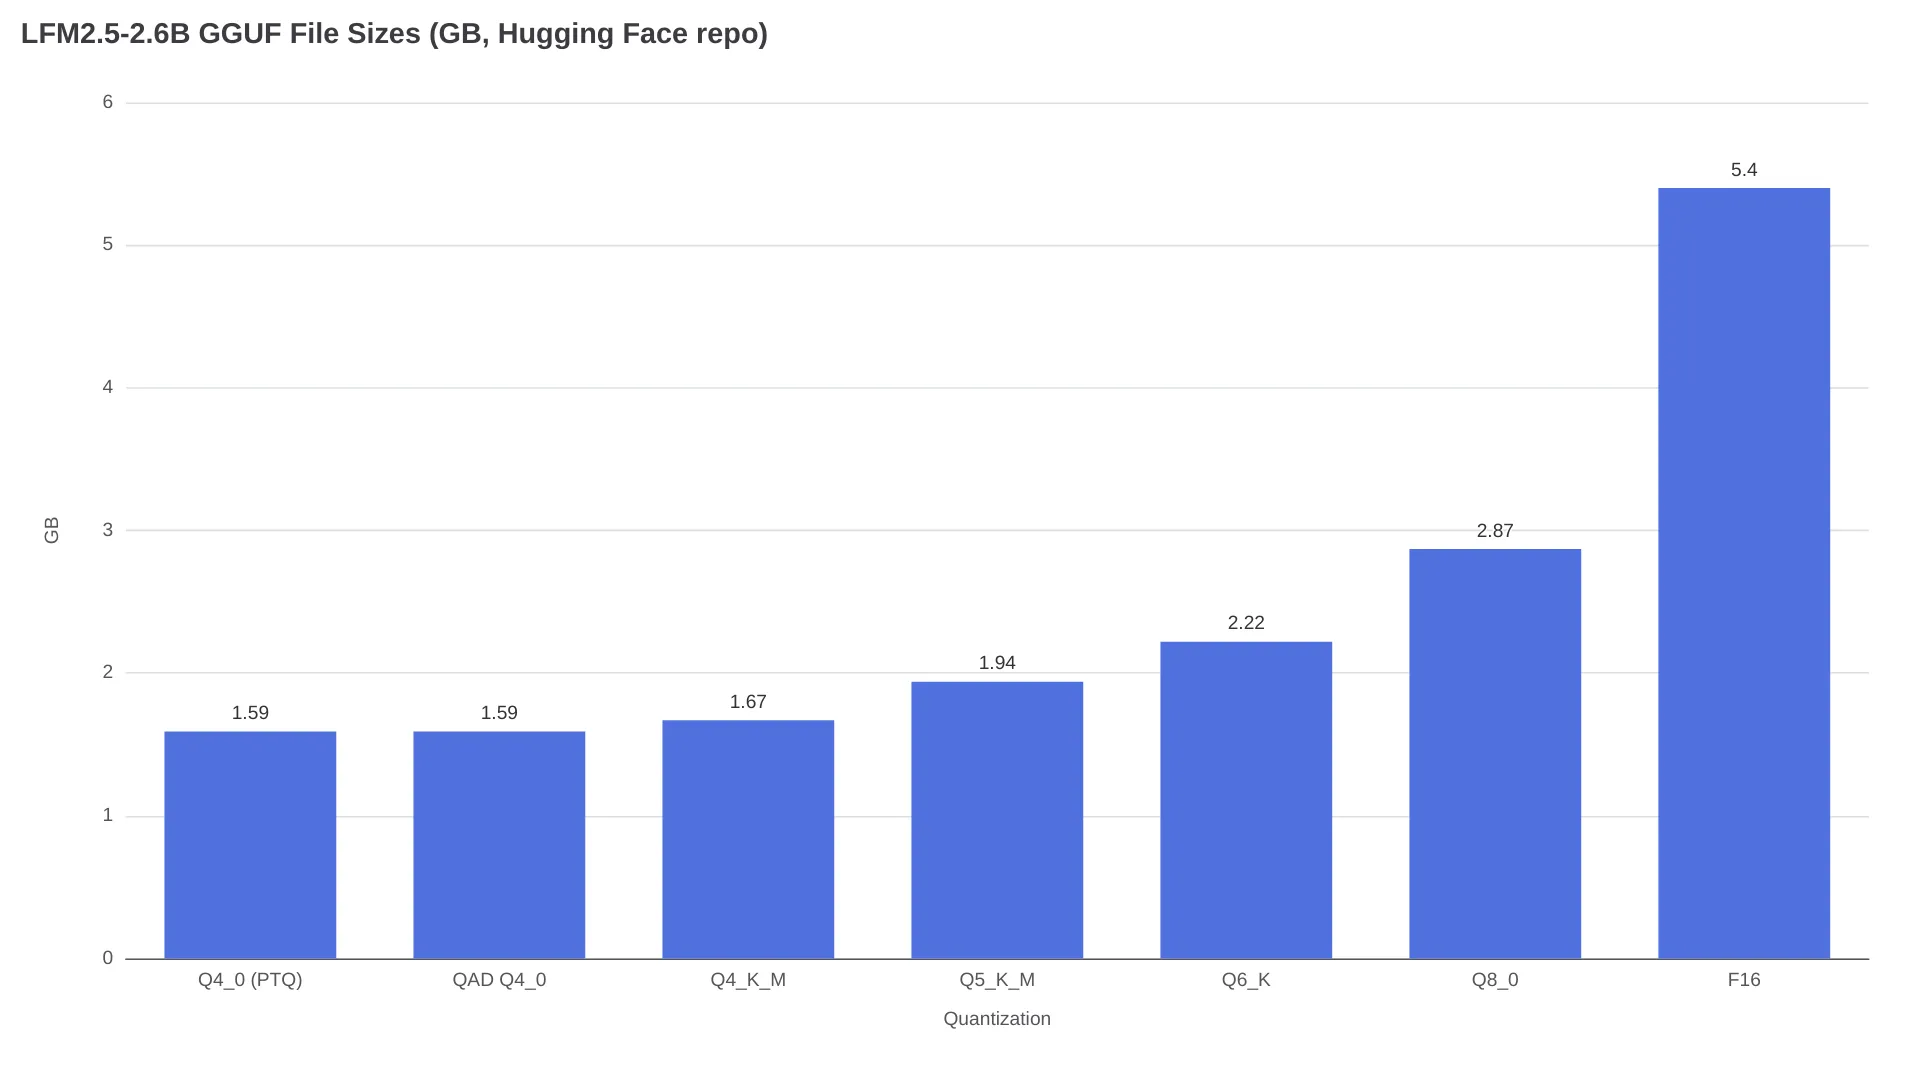
若是在這四個 checkpoint 上,以 RAM 緊張的 llama.cpp 部署為目標,QAD Q4_0 是值得優先測試的官方支援 4-bit 選項。它和一般 Q4_0 同樣是 1.59 GB,但透過訓練達到 Q4_K_M(1.2B、2.6B)或 Q5_K_M(230M、350M)的品質,解碼速度則分別快 3–14% 或 4–33%。若你已在使用 Q4_K_M 且 RAM 仍有餘裕,繼續用即可;80 MB 並不是你真正要解決的問題。
| 檔案(2.6B) | 大小 | 定位 | 適合選用時機 |
|---|---|---|---|
| Q4_0(舊版 PTQ) | 1.59 GB | 未修補的基線版本 | 跳過,現在已有 QAD |
| QAD Q4_0 | 1.59 GB | 保留 96.6% BF16 品質,對上 Q4_K_M | 3–4 GB RAM 預算、CPU 解碼、手機、Pi |
| Q4_K_M | 1.67 GB | Liquid 文件的預設建議 | runtime 無法選取 QAD 檔案 |
| Q5_K_M | 1.94 GB | 依 KikoCis,top-1 相對 F16 為 91.4% | 6 GB+ RAM |
| Q6_K / Q8_0 | 2.22 / 2.87 GB | 接近無損 | 8 GB+、品質優先 |
補充一下這些「相當」說法的背景:KikoCis 的 PTQ 階梯測試顯示,這個模型的 Q4_K_M 相對 F16,top-1 token agreement 為 84.36%;Q6_K 為 95.07%,Q8_0 為 98.23%。Liquid 的主張是,QAD 可在相同位元組數下補上 4-bit 的保真度缺口。不過這些是該公司跑五次後的數字,目前尚未有獨立複現。發布當日的討論中,有一句很好的校準:
「這不是『Q4_0 擊敗 K-quants』,而是這四個 checkpoint 曾針對 Q4_0 訓練。」— @MarMarLabs
不要把這項優勢泛化到其他模型;其他模型的 Q4_0 檔案仍是一般 PTQ。
記憶體部分,發布文章沒有提供 RAM 數字,可參考 KikoCis repo 的計算:2.6B 的 f16 KV cache 約為每 token 16 KB,32K context 約需 0.54 GB,原生 128K context window 約需 2.15 GB;加上 --cache-type-k q8_0 --cache-type-v q8_0 可讓快取用量減半。QAD Q4_0 權重為 1.59 GB,加上 32K context,未計 runtime overhead 約為 2.13 GB;128K 則超過 3.7 GB。4 GB 應視為偏緊繃的配置,務必在目標 runtime 上確認實際配置狀況。
常見問題
QAD Q4_0 比 Q4_K_M 好嗎?
就這四個 checkpoint 而言,Liquid AI 的數字顯示,QAD Q4_0 可在更小檔案與更高解碼速度下,達到 Q4_K_M 的品質;最小的兩個模型甚至對上 Q5_K_M。因此在 RAM 預算有限時,答案是肯定的。不過這些結果由廠商測得、重複五次,目前還沒有獨立複現。
Ollama 或 LM Studio 會自動選到 QAD 檔案嗎?
不會。依官方 repo 頁面,Ollama 文件中的方式是 ollama run hf.co/LiquidAI/LFM2.5-2.6B-GGUF:Q4_K_M,Hugging Face 的預設範例同樣指向 Q4_K_M。任何支援 GGUF 的 runtime 都可載入 QAD 檔案,但你必須明確指定檔名,或使用 :QAD-Q4_0 限定詞。
LFM2.5-2.6B QAD Q4_0 需要多少 RAM?
權重為 1.59 GB;KikoCis 的計算顯示,f16 KV cache 在 32K context 約需 0.54 GB,在 128K 則約需 2.15 GB。權重加快取、尚未計入 runtime overhead,32K 約為 2.13 GB,128K 約為 3.74 GB;使用 Q8_0 KV-cache 量化可將快取成本減半。
哪些 LFM2.5 模型有 QAD checkpoint?
截至 2026 年 8 月 19 日,只有 LFM2.5-230M、LFM2.5-350M、LFM2.5-1.2B-Instruct 與 LFM2.5-2.6B。VL-450M 和 8B-A1B 版本都沒有;不過使用者已在發布討論串中要求 Liquid AI 製作 8B QAD build。
LFM2.5 QAD checkpoint 可以商用嗎?
這些 repo 標示採用 LFM Open License v1.0。社群 repo 對條款的整理指出,年營收低於 $10M USD 的實體可商用;達到或超過該門檻,則需取得另一份 Liquid AI 商業授權(KikoCis 的整理)。正式出貨前,仍應自行閱讀完整授權條文。
97% 的說法已獲獨立驗證嗎?
尚未。96.5–97.4% 的保留率是 Liquid AI 在發布時公布、取五次執行平均的自家數據;本文撰寫時,尚未看到第三方針對 QAD 檔案的 benchmark,而 r/LocalLLaMA 對 imatrix 的疑問也仍未有定論。
今晚就自己跑一輪 A/B 測試
真正重要的是你的任務錯誤率,而不是 benchmark 平均數。挑十個真實 prompt,例如工具呼叫 JSON、你的資料擷取 schema、你的語言,然後以完全相同的設定分別執行兩個檔案:
llama-cli -hf LiquidAI/LFM2.5-2.6B-GGUF \
  --hf-file LFM2.5-2.6B-QAD-Q4_0.gguf \
  -c 4096 --temp 0.1 --top-k 50 --repeat-penalty 1.1 \
  -p "<your prompt>"

llama-cli -hf LiquidAI/LFM2.5-2.6B-GGUF \
  --hf-file LFM2.5-2.6B-Q4_K_M.gguf \
  -c 4096 --temp 0.1 --top-k 50 --repeat-penalty 1.1 \
  -p "<your prompt>"
請逐檔統計解析失敗與工具選錯的次數,不要只憑感覺判斷。這裡確實存在尚未完全解開的取捨:從紙面數據看,QAD Q4_0 的每 GB 品質平均值更好;但你的部署會遇到哪些失敗模式,例如推理耗盡 token 預算後出現空白回答、特定 temperature 下格式漂移,仍取決於 runtime 與任務本身。這個代價,只有你的十個 prompt 能替你定價。