 AIREITER
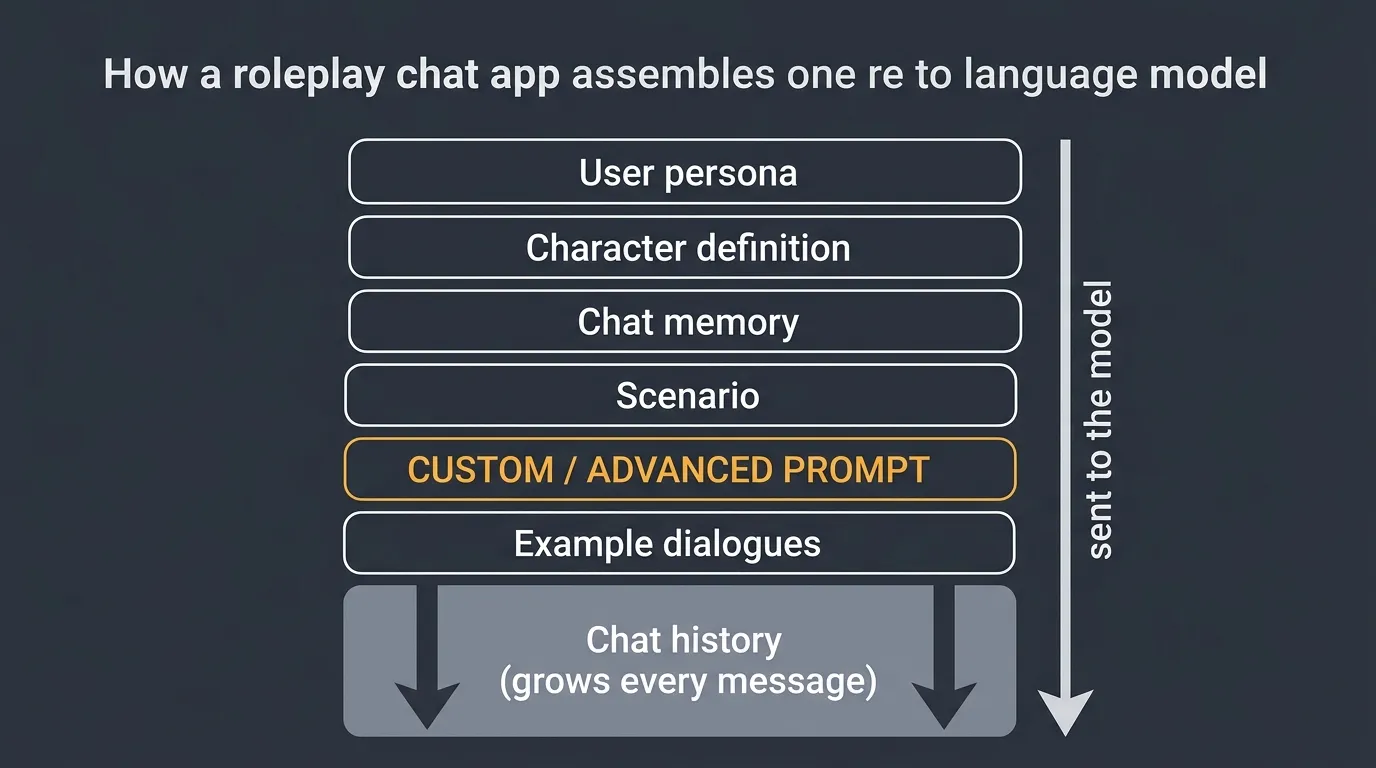
Janitor AI 提示詞「突然不管用」,很多時候不是被覆蓋,而是被埋到後面去了。平台公開的送出順序說明都指出,聊天記錄會排在你的提示詞區塊之後,因此每多傳一則訊息,你的規則就會離模型輸入的末端更遠。短小、針對症狀的區塊比較能撐住;800 字的萬用主提示詞反而不行。
先對症狀找欄位,再貼提示詞
以下各種資料都在描述同一組會以獨立區塊送進模型的欄位:角色定義、你的 persona、Chat Memory,以及提示詞欄位。貼錯地方,是複製來的提示詞完全沒反應的常見原因。先找到最符合你目前狀況的那一列,再一次只改一個地方。
| 你看到的情況 | 最可能的原因 | 最小幅度的修正 |
|---|---|---|
| 機器人替你的角色說台詞 | 第一則訊息或範例對話已經替你發言 | 先修正來源文字,再加入下面的使用者主導權區塊 |
| 規則維持了 20 輪,之後逐漸失效 | 提示詞被累積的聊天記錄埋住 | 把最關鍵的一條規則重申在 Chat Memory |
| 回覆膨脹成長篇大論 | 任何地方都沒有長度規則,或角色卡與提示詞中的規則互相矛盾 | 只寫一次段落數量規則 |
| 機器人把你剛說的話再重複一次 | 最近幾輪對話建立了這種模式 | 刪除或編輯造成問題的回覆,再加入禁止重述的句子 |
| 提示詞看起來完全被忽略 | 永久內容超過上下文額度,遭到截斷 | 刪減提示詞,不要刪故事 |
| 切換模型後,同一段提示詞表現不同 | 提示詞原本是按 proxy 的上下文設計,現在卻跑在 JLLM 上 | 按照後面的表格重新調整長度 |
有兩個習慣比任何範本都更有用:每次測試只改一個變數,並保留舊版本,方便隨時復原。
提示詞放在哪裡,以及撐不撐得到第 80 輪
Janitor AI 每一輪都會把多個獨立區塊組合成一個請求,而你編輯的欄位並不是模型最後讀到的內容。公開資料對具體順序的描述不完全一致,但它們共同指出的那一點,才是最重要的。
| 來源 | 提示詞欄位的位置 | 後面接著什麼 |
|---|---|---|
| 社群聊天機器人指南(個性、聊天記憶、情境、進階提示詞、最近訊息) | 5 個區塊中的第 4 個 | 最近訊息 |
| rshtola/jai-info,2026 年 4 月在 proxy 路徑上的觀察 | 第 2 個,緊接在全域提示詞之後 | 角色 persona、情境、使用者 persona、範例對話、摘要、lorebook |
| 涵蓋 JLLM 路徑的提示詞疑難排解文章 | 6 個區塊中的第 5 個 | 完整對話 |
三種排列方式都會在組合完成的區塊後面附上對話。這個共同點足以解釋社群討論中反覆出現的失效模式:規則並沒有停止送出,只是要和後面幾千個 token 的新文字競爭。它也解釋了為什麼有些人會發現,內嵌在訊息中的 OOC 句子,即使固定提示詞早已失去存在感,仍然能影響下一則回覆。原因很簡單:OOC 句子是在最後才送進去的。
如果你使用 proxy,jai-info 文件還補充了一個值得注意的細節:空白欄位會被直接省略,不會以空白區塊送出;而自訂提示詞也是 Janitor 不會用 <Scenario> 或 <UserPersona> 之類標籤包起來的少數區塊之一。你的文字會以未標記的形式出現,因此如果希望模型把它當成規則集合來讀,最好自行加上一行標題。
實際上,凡是希望到第 80 輪仍然有效的內容,都不該只放在提示詞欄位。Chat Memory 適合放一段由你自行維護的短摘要,隨事實變化而更新;提示詞欄位則拿來規定一般性的回覆行為。不要想當然地認為這種分工一定能撐住,請在第 80 輪實際確認。
五個提示詞區塊,一次只處理一個問題
前四個放在 Advanced Prompt 或 Custom Prompt 欄位;第五個則放進 Chat Memory。一次只貼一個,跑六輪,只有在你能明確說出差異時才保留。五個全部疊上去,正是很多人最後得到一段完全無法除錯的提示詞的原因。
阻止機器人替你的角色發言
這是 r/JanitorAI_Official 反覆出現的抱怨,也是最需要斟酌措辭的一類。不要只說機器人不該做什麼,而要明確寫出它應該寫什麼。
Write only {{char}}, the world, and side characters.
{{user}}'s dialogue, actions, thoughts and decisions belong to {{user}} alone.
When {{char}} would need {{user}}'s response, end the reply on the action or question that invites it.
Treat {{user}}'s latest message as the current truth of the scene.一篇被廣泛引用的社群疑難排解討論,建議同時在 persona 中明確定義巨集:寫上 {{user}} = Name,並說明 {{user}} 不是 {{char}}。不過預期還是要放低一點。在一篇討論機器人搶走使用者角色的長串文章中,有人對這個標準修正方案的評價是:
「It work 80%」——u/NextCompetition6019,r/JanitorAI_Official
限制回覆長度,但不要犧牲描述
Default to 2–3 paragraphs. Expand only when {{user}} asks for detail.
Lead with what {{char}} does and says in the current moment.
Open each reply with new material rather than restating {{user}}'s message.
禁止重述的那一句,比段落數量更重要。因為如果機器人先把你的輸入再說一遍,還沒開始推進故事,回覆的一半可能就已經用掉了。
固定觀點與時態
Narrate {{char}} in close third person, present tense.
Keep dialogue in quotation marks and actions in plain prose.
Match the register of {{user}}'s writing rather than escalating it.
很多人會跳過最後一行,但它其實最有用。這條規則能抑制文風逐漸浮誇的問題;而在傾向模仿你寫法的路徑上,它也提供了模型一個很具體的參考。
讓場景持續往前走
Advance one meaningful beat per reply.
Let {{char}} act on their own motives instead of waiting for instructions.
Leave at least one thread unresolved at the end of each reply.
這段只適合被動的機器人。它和長度上限一起使用時,可能讓場景推進得太急,所以兩段要一起測試後再決定是否保留。
放進 Chat Memory 的摘要區塊
這一段完全不該放在提示詞欄位。
Place: [where the scene is happening]
Goal: [what {{char}} wants right now]
Fact: [one confirmed thing about the relationship]
Open thread: [what is unresolved]
Correction: [the most recent thing {{user}} fixed]
Janitor AI 自己的 Advanced Prompting 101 說明文章,在各種社群指南中都被引用來支持一個做法:長對話開始遺忘內容後,應該加入短摘要,而不是繼續堆疊更多指令。重寫五行摘要,所佔的上下文會比再加一段規則少得多。
把規則寫成模型能執行的動作
同一篇說明文章建議,不要用「no」、「don't」、「never」和「stop」這類否定詞來堆規則,理由是你在命名某個行為時,也同時把它留在輸入裡:「no blood」仍然包含 blood。另一句被廣泛引用的原則是:重複就是雜訊。同一條規則換五種方式重寫,只會增加 token,不會增加服從度。
解法是加入路由式的行動條款。把每一條否定規則改寫成明確說明替代行為。
| 不要這樣寫 | 改成這樣 |
|---|---|
| 「Never speak for {{user}}」 | 「Write only {{char}}'s speech, thoughts and actions」 |
| 「Don't ask me what I want to do next」 | 「Where {{char}} would ask for direction, have {{char}} take one action alone」 |
| 「Don't be repetitive」 | 「Open each reply with an event that has not happened yet」 |
| 「Avoid short replies」 | 「Give each reply two paragraphs: one action, one line of dialogue」 |
「Avoid」和「refrain from」也不是什麼避開問題的魔法字眼,因為它們一樣會把不想要的行為帶進提示詞。如果角色卡或範例對話示範了你想禁止的事情,通常會是角色卡勝出。先修正來源,再考慮增加規則。
按照目前使用的模型調整提示詞長度
為 32k token proxy 上下文寫好的提示詞,直接貼到免費 JLLM 工作階段,往往就是大量「這個 preset 壞掉了」回報背後真正安靜發生的原因。Advanced Prompting 101 被引用最多的關鍵數字是:JLLM 的可用工作上下文大約為 8,000–9,000 個 token,而且 persona、角色定義、記憶、情境、你的提示詞和完整對話都要共同分用這個空間。
| 設定 | 工作上下文(proxy 設定文章中的報告值) | 合理的提示詞大小 |
|---|---|---|
| JLLM(內建、免費) | 約 8k–9k token | 3–5 條短規則;過長的 preset 會擠掉故事 |
| 透過 proxy 使用 DeepSeek | 通常設定為 16k–32k | 規則加上 2–3 組範例對話 |
| 透過 proxy 使用 GLM | 與 DeepSeek 類似 | 相同;切換後重新測試格式規則 |
估算上下文預算時,可以先記住一個實用換算:大約 1,000 個 token 等於 750 個字。那些把提示詞放在第 6 個區塊中的疑難排解文章,也把所有永久內容的上限設在 2,000 token,也就是 persona、角色卡、記憶和提示詞加起來的總量。社群聊天機器人指南的標準更保守,提醒進階提示詞一旦超過幾百個 token,就可能開始擠壓原本想用來補強的角色定義。
JLLM 和外部模型可能會把同一個機器人帶往不同方向,因此切換路徑時,先把它視為一次proxy 設定決策,再重新測試提示詞,不要假設原本的效果能直接沿用。
像 <JAILBREAK=ON> 或 <AUTOPLOT=ON> 這類括號指令,也常被當成 Janitor AI 設定到處流傳。但發布這些指令的清單都把它們描述為特定 proxy 使用的命令,並與 lorebook 代碼、每次請求切換模型等 proxy 專屬功能並列;Janitor AI 自己的文件則沒有定義它們。沒有對應解析器的路徑不會理解這些內容,它們只會以純文字形式佔用提示詞空間。
自訂提示詞到底值不值得保留?
這裡確實存在兩種截然不同的結果,而且分歧不在新手和老手之間。Janitor AI 的一位主要版主在 2023 年發文表示,自訂提示詞「可以大幅影響機器人的行為」,而不使用提示詞「可能改善」表現,最後又把結論收斂成必須自行反覆測試。主張刪掉 AP的討論串也會定期重新出現,回覆同樣分成兩派:有人表示清空欄位後,JLLM 的輸出更乾淨;也有人換上更長的區塊後,品質反而提升。
這兩種結果其實都符合前面說的送出順序。提示詞可以替模糊的角色卡補上結構,但如果角色卡本身已經寫得很好,提示詞也可能在範例、記憶和近期對話之間增加競爭。
所以問題不是「我的提示詞好不好」,而是「這個機器人到底需不需要提示詞」。用相同的六輪開場對話跑兩次,一次清空欄位,一次只放一個區塊,然後從四個面向評分:
- 它有沒有替你的角色寫台詞或動作?
- 聲音在六次回覆中是否維持一致?
- 場景有沒有推進,還是停滯並不斷重複?
- 它是否接受對話中途的修正?
在下結論前,先讓一個區塊經歷兩輪測試。如果第二輪仍然看不出差異,問題就不在措辭,而是在角色卡、第一則訊息或模型路徑。繼續增加規則,只會從故事手上搶走更多上下文空間。
Janitor AI 提示詞 FAQ
Janitor AI 提示詞要貼在哪裡?
開啟聊天的 API 或生成設定。如果使用 JLLM 路徑,尋找 Advanced Prompt 欄位;如果透過 proxy 連線,則尋找 Custom Prompt 欄位。
Advanced Prompt 和 Custom Prompt 有什麼差別?
社群通常把 Advanced Prompt 視為 JanitorLLM 的欄位,把 Custom Prompt 視為外部 API 和 proxy 的對應欄位。兩者都用來規定全域回覆行為,但在組合請求中的位置不同,因此切換路徑後,要重新測試原本的區塊。
為什麼我的 Janitor AI 提示詞用了一陣子就失效?
聊天記錄會附加在提示詞區塊後方,因此每多一則訊息,你的規則就會離輸入末端更遠。縮短提示詞,把不能失去的規則移到 Chat Memory;如果只是要修正單次回覆,則使用內嵌的 OOC 句子。
{{char}} 和 {{user}} 可以在自訂提示詞中使用嗎?
可以,它們分別是角色和你的 persona 所使用的標準巨集;根據 proxy 路徑範本的觀察,也會替換相同的佔位符。為了在測試時少一個變數,製作者仍然會在 persona 中寫清楚 {{user}} = Name。
Janitor AI 提示詞應該多長?
JLLM 建議使用三到五條規則;在 16k–32k 的 proxy 上下文中可以稍微增加,但所有永久內容加總仍應低於 2,000 token。五條能完整送達的規則,比二十五條最後被截斷的規則更有用。
整件事底下仍有一個尚未解決的取捨:提示詞要短到能在第 80 輪繼續發揮影響力,就不可能把你想要的一切都寫清楚;而我找不到任何公開的受控比較,能說明這條界線在 JLLM 和常見 proxy 模型上究竟位於哪裡。在這類研究出現以前,最站得住腳的預設做法是:使用一個小區塊、保存一份曾經有效的版本,並且在一個設計良好的機器人不需要提示詞時,願意把欄位清空。
延伸閱讀
- Janitor AI persona 範本介紹同一組上下文堆疊中與
{{user}}相關的部分 - 適合角色扮演的最佳 AI 模型介紹如何選擇能讓你的提示詞撐住的模型