 AIREITER
r/codex 最近反覆出現同一個問題:「原本用 GPT-5.5 extra-high,換到 5.6 該選 Sol 還是 Terra?」先講結論:GPT-5.6 Sol 的 API 標價與 GPT-5.5 完全一致,但代理型任務的基準表現更好。若工作負載是長時間運行的 agent 或網頁瀏覽任務,升級幾乎不需要額外付出模型單價。
不過,「價格一樣」不代表帳單一樣。Sol 新增了 GPT-5.5 沒有的快取寫入費,而且它會花更長時間推理;即使費率表沒變,單一任務的實際花費仍可能大幅增加。
標價沒變,實際成本結構變了
GPT-5.6 Sol 與 GPT-5.5 的標準 API 定價完全相同:每百萬 input tokens 為 $5.00、output tokens 為 $30.00,快取 input 則是 $0.50。我在 2026 年 7 月 29 日從 OpenAI 定價頁面核對了兩者:
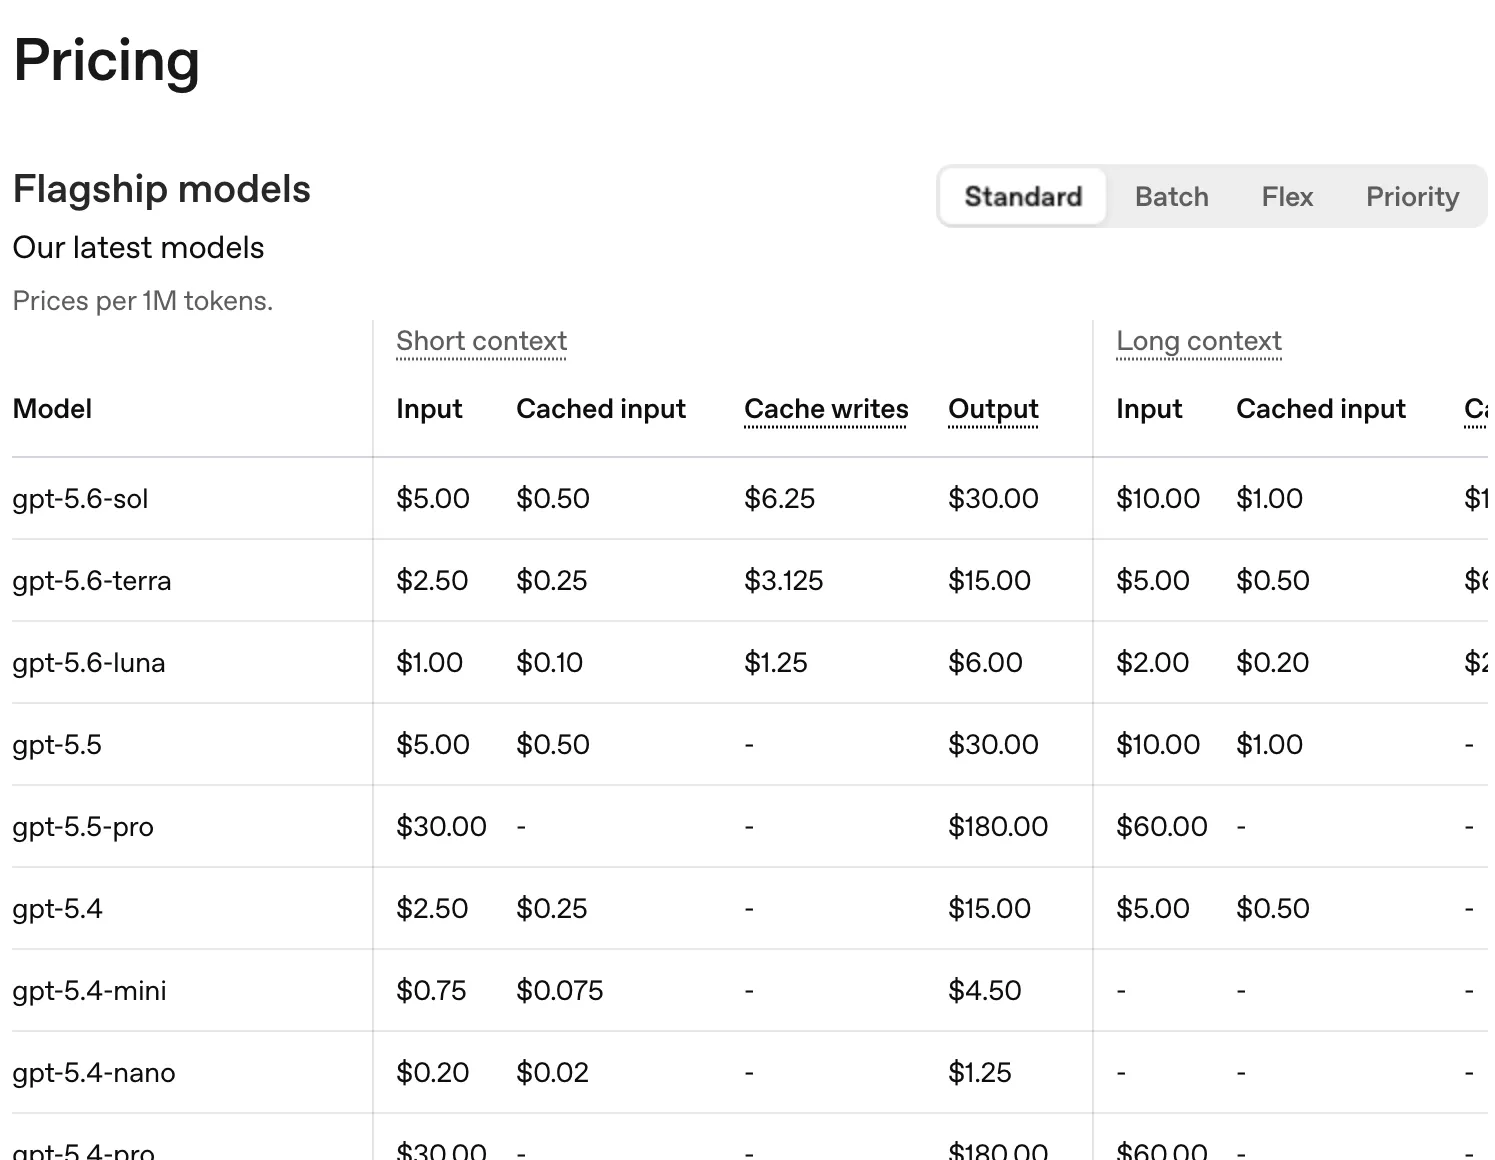
不過,表中有三個項目讓兩個模型出現實質差異:
| 計費項目 | GPT-5.6 Sol | GPT-5.5 |
|---|---|---|
| Input / Output(每 1M tokens) | $5.00 / $30.00 | $5.00 / $30.00 |
| 快取 input | $0.50 | $0.50 |
| 快取寫入 | $6.25 | 不收費 |
| 長上下文(>272K)input / output | $10.00 / $45.00 | $10.00 / $45.00 |
遷移時最容易被忽略的就是快取寫入費。GPT-5.6 引入明確的快取斷點,最短保存時間為 30 分鐘(運作方式可參考 Vellum 的說明)。快取寫入的費用是未快取 input 的 1.25 倍,但讀取仍享有 90% 折扣。按上表計算,寫入一段快取要 $6.25,每次讀取再加 $0.50;相較於每次直接重送未快取內容的 $5.00,只要第二次重用就開始划算。反過來說,若你的流程寫入快取的次數多於讀取次數,便會多出 GPT-5.5 從未收取的費用。
另一項成本則和思考時間有關。Sol 在回答前會推理得更久,而 reasoning tokens 是按 output 計費。已遷移的 Codex 使用者直接描述了這個現象:
「5.6 sol médium 的成本是 5.5-xhigh 的三倍,但程式碼品質相同(至少和 5.5 發布時相比是如此)。」— r/codex,「GPT 5.5 and 5.6 conversion table」
也就是說,費率表雖然相同,單一任務成本卻可能變成三倍,原因只是模型為了得出結果用了三倍 tokens。另一方面,OpenAI 的 GPT-5.6 發表公告指出,在其內部比較中,GPT-5.6 相比 GPT-5.5 少用了 22% input tokens 與 23% output tokens。兩種說法其實可以同時成立:單位推理的效率提升了,但高 effort 設定會讓模型思考更多;最終體感成本仍取決於你選擇的 effort 等級。
帳面能力真正升級在哪裡
從獨立評測來看,GPT-5.6 Sol 與 GPT-5.5 的純推理能力差距很小:Artificial Analysis 的 Intelligence Index v4.1 給 Sol(medium)54 分,GPT-5.5(high)則是 53 分;兩者混合成本皆為每百萬 tokens $4.35。真正拉開差距的是以下幾點:
- 首 token 延遲:Sol 為 4.13 秒,GPT-5.5(high)為 16.67 秒,相差 4 倍。對互動式工具,以及需要數十次循序呼叫的 agent 迴圈而言,這會是日常使用最有感的升級。
- Agent 基準測試:Sol 在 Terminal-Bench 2.1 取得 88.8%,BrowseComp 為 92.2%。這次版本最明顯的進步,集中在長時程工具使用任務。
- 上下文:Sol 提供 1M tokens,上限高於 GPT-5.5 的 922K;此外,它的推理可跨對話回合延續,相關說明也見於前述 Vellum 分析。
- 輸出速度:這是唯一退步之處。Sol 的串流速度為每秒 65 tokens,GPT-5.5 則是 77.3。大量內容生成工作不會更快,反而更慢。
CodeRabbit 的長時程程式開發測試套件涵蓋五種語言、超過 100 項任務,Sol 的通過率為 63.7%。在其程式碼審查基準中,Sol 比基線整合方案高出 7.4 個百分點;但有個重要但書:Sol 的審查精確率只有 31.6%,代表它能找回更多真實問題,也會帶來更多雜訊。測試團隊還記錄到,Sol 曾在一個簡單修改上沿著錯誤路徑執著地跑了 8 輪。它更擅長馬拉松式任務,不等於不會鑽牛角尖。
用三組相同提示詞實測
基準測試偏向獎勵長時程任務,但多數 API 呼叫其實很短。因此我在 2026 年 7 月 29 日,對 gpt-5.6-sol 與 gpt-5.5 各送出相同三組提示詞:一個 Python 日期處理 bug 修正、一個恰有兩個有效答案的限制邏輯謎題,以及一項帶有陷阱的嚴格 JSON 擷取任務。最後一題有個未附年份的日期,規則明定必須回傳 null,不能自行猜測。每項任務只呼叫一次 API,使用預設 reasoning effort、不使用工具、不重試。這只是小樣本測試,不是基準評測。
兩個模型都答對三題。GPT-5.5 使用 calendar.monthrange 修正了 12 月當機 bug;Sol 則自行寫出正確的閏年判斷表。兩者都找出恰好兩種有效的部署順序,JSON 擷取結果逐位元組完全相同,也都拒絕替「7 月 14 日」虛構一個年份。
但 tokens 消耗與速度呈現不同走向:
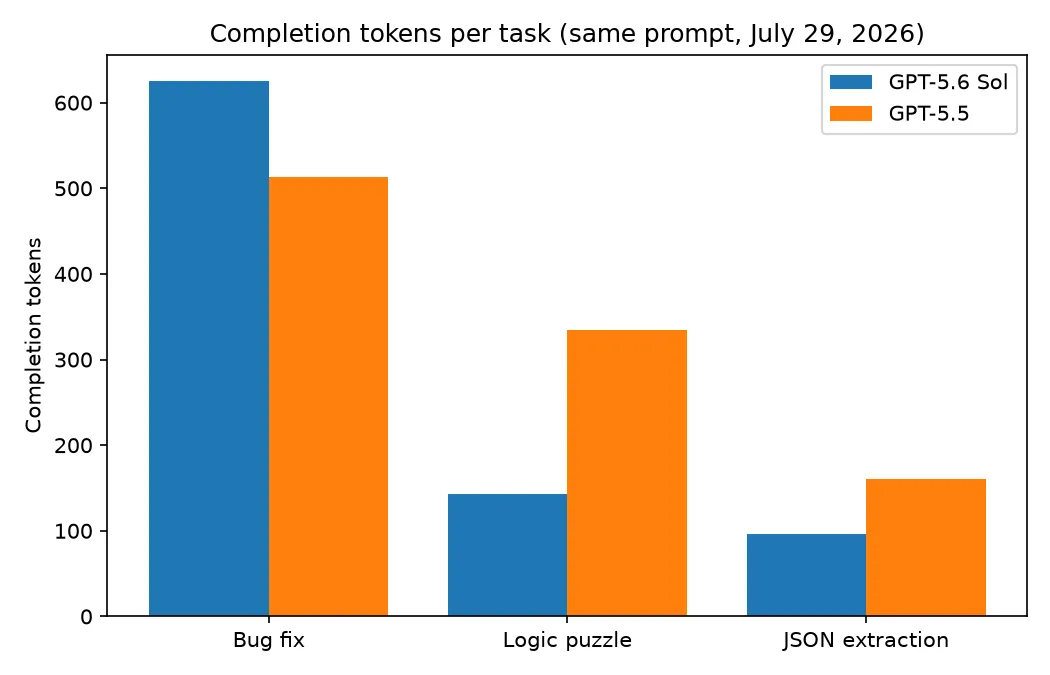
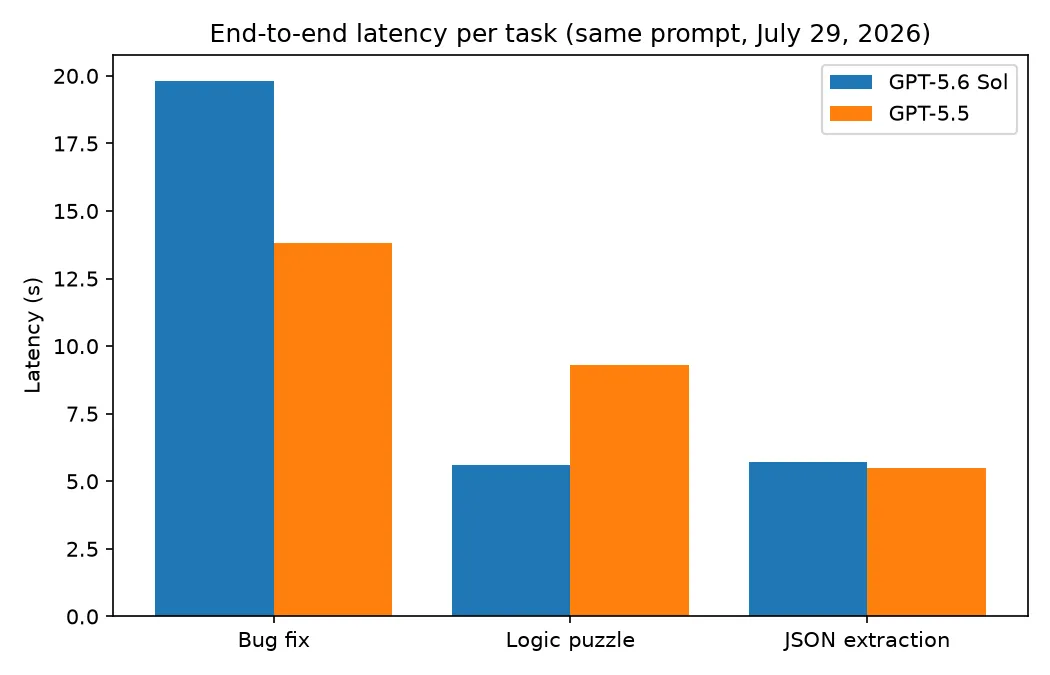
Sol 的 completion tokens 總數較少,為 864 對 1,007;但在程式碼任務上更慢也更冗長:Sol 花了 19.8 秒、用了 625 tokens,GPT-5.5 則是 13.8 秒、513 tokens。到了邏輯謎題,情況反過來,Sol 用 143 tokens、5.6 秒完成,GPT-5.5 則用 334 tokens、9.3 秒。觀察兩者後,我的結論是:面對短小、規格明確的任務,兩者可互相替代,這次測試本身不足以構成遷移理由。Sol 的升級價值完全建立在前述基準測試中的 agent 與長上下文工作。
GPT-5.5 的 effort 等級該怎麼對應 5.6
根據前述 Vellum 分析,直接使用 gpt-5.6 模型 ID 時,預設會路由到 gpt-5.6-sol。換句話說,只是替換別名的使用者,會直接進入旗艦等級,也會直接承擔旗艦成本,卻沒有主動選擇它。若你打算有意識地遷移,以下三項資料可作為對照基準:
- GPT-5.5 xhigh 對應 Sol medium:這是社群目前採用的實務對照。前面引用的 r/codex 回報認為,約在 GPT-5.5 品質持平的情況下,Sol medium 的單一任務成本約高 3 倍。把它當成應以自家提示詞驗證的起點,不要視為保證。若預算敏感的工作負載原本使用 5.5 high,則更接近 GPT-5.6 Terra,其定價為 $2.50/$15,僅為 Sol 費率表的一半。
- 最高檔位的思考時間會膨脹。ChatGPT Pro 使用者回報,某些任務上 GPT-5.6 會花 20–50 分鐘思考,而 5.5 Pro 原本只花 5–10 分鐘。這是 ChatGPT 端的觀察,但同一套推理堆疊在 API 中同樣以 output tokens 計費。三個 5.6 等級都可使用
reasoning.mode: "pro",因此最高成本是可選擇、而非強制啟用的。 - 舊提示詞可能反而拖累新模型。Every.to 的測試團隊發現,只有刪除過去為舊模型寫下的防禦性指令後,Sol 的輸出才明顯改善。例如「永遠再次檢查 X」這類規則,會讓 Sol 過度驗證、過度建構。遷移模型後,也應重新檢視 system prompt;GPT-5.5 時代所需的過度防護,現在可能成為成本負擔。
哪些人該換 Sol,哪些人該留在 5.5
如果你的工作負載偏 agentic,例如多步驟工具使用、瀏覽研究或 repo 規模的程式開發工作階段,應考慮改用 GPT-5.6 Sol。88.8% 的 Terminal-Bench 與 92.2% 的 BrowseComp 成績正是針對這類任務;首 token 延遲縮短 4 倍,也會在每次迴圈中持續累積效益。以同樣的 $5/$30 費率表來看,能力提升沒有增加單價,前提是額外產生的 reasoning tokens 和快取寫入費沒有吃掉這個優勢。1M 上下文與跨回合推理延續,也省去了 5.5 流程原本必須自行搭建的兩種 workaround。
如果流量主要是短小且規格明確的呼叫,例如擷取、分類、單次程式修正或大量生成,暫時留在 GPT-5.5 會更合理。我用三組提示詞實測的正是這類工作,兩者正確性持平;而 Sol 的串流速度較慢,每秒 65 對 77.3 tokens,讓大量工作反而處於劣勢。大量使用 prompt cache 寫入的流程,更應先將 $6.25 這一項成本算進去。若你升級真正想要的是在相近品質下壓低帳單,答案是 Terra,不是 Sol。
我這次的正面比較透過 AIReiter 完成;它在同一把 API key 下提供 gpt-5.6-sol 與 gpt-5.5,因此只要替換模型字串就能做完整 A/B 測試。請用自己的流量比較任務成功率、端對端延遲,以及每項任務的 completion tokens。
常見問題
GPT-5.6 Sol 比 GPT-5.5 好嗎?
在 agent 任務上,答案很明確:Terminal-Bench 2.1 為 88.8%、BrowseComp 為 92.2%,而且首 token 延遲低 4 倍。至於短小的一次性任務,獨立評分只差 1 分,Artificial Analysis 為 54 對 53;我的相同提示詞測試也沒有發現正確性差距。
GPT-5.6 Sol 比 GPT-5.5 貴嗎?
標價相同:每百萬 tokens 的 input 為 $5、output 為 $30。不過 Sol 多了 GPT-5.5 從未收取的 $6.25 快取寫入費,而且在較高 effort 設定下,每項任務會消耗更多 reasoning tokens。r/codex 使用者測得,在與 5.5 xhigh 品質持平時,單一任務成本約為 3 倍。
GPT-5.5 xhigh 在 GPT-5.6 中對應什麼?
Sol 的 medium effort 可提供相近的程式碼品質,但每項任務成本約為三倍。如果你更在意成本持平,而非能力上限,Terra 是較接近的經濟型對應選項。
升級後還能繼續用 GPT-5.5 嗎?
可以。GPT-5.5 仍列在 OpenAI 定價頁面上,費率未變,已於 2026 年 7 月 29 日核實,因此目前沒有非遷移不可的理由。
一張表做決定
| 你的工作負載 | 建議選擇 | 關鍵判斷依據 |
|---|---|---|
| 多步驟 agents、瀏覽、repo 規模程式開發 | GPT-5.6 Sol | Terminal-Bench 88.8%、首 token 延遲低 4 倍、費率表相同 |
| 短篇擷取/分類/單次修正 | GPT-5.5(暫時) | 相同提示詞測試持平;5.5 串流速度快 19% |
| 大量 prompt-cache 寫入 | GPT-5.5,或先重構架構 | Sol 新增 $6.25/1M 快取寫入費 |
| 相同品質、更低帳單 | GPT-5.6 Terra | $2.50/$15,為 Sol 價格的一半;請見前述 Terra vs 5.5 比較 |
| 最高思考深度 | Sol 搭配 reasoning.mode: "pro" | 5.5 花 5–10 分鐘的任務,可能思考 20–50 分鐘 |