 AIREITER
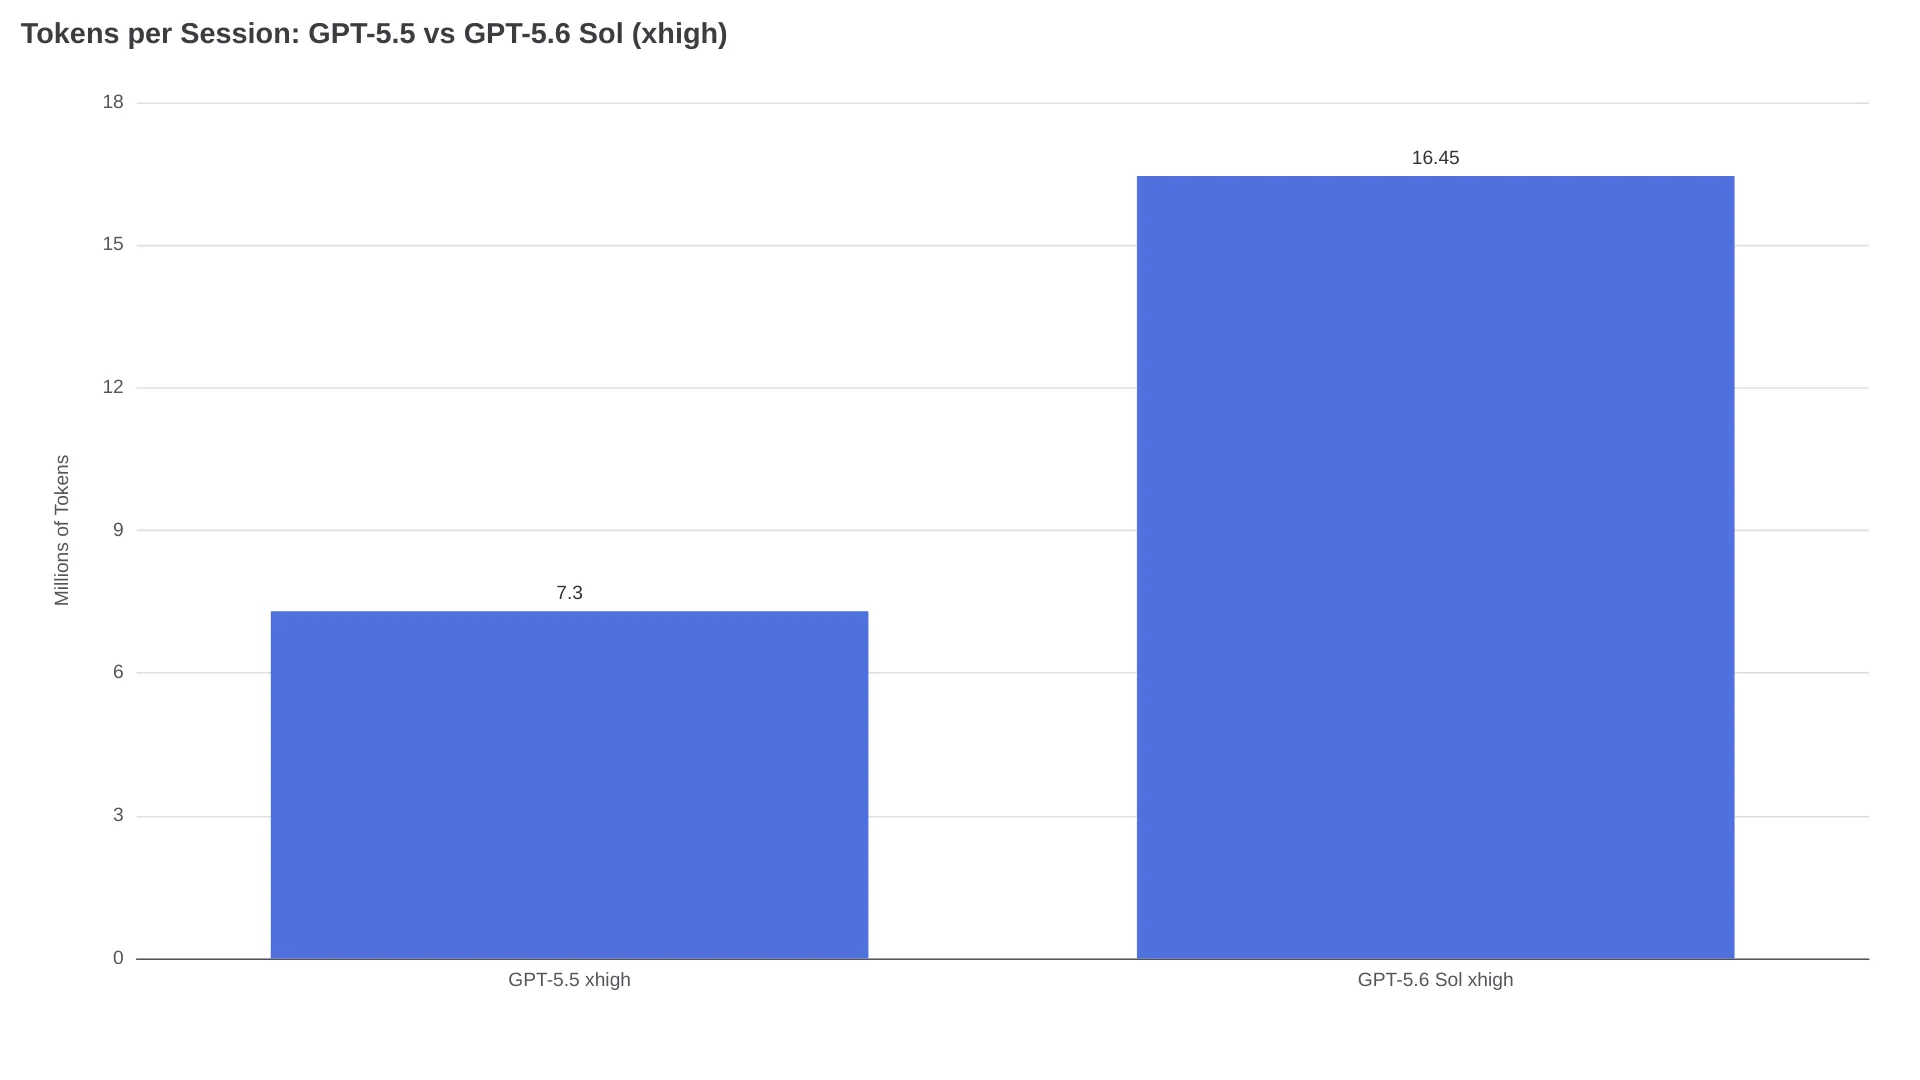
同樣的單價,GPT-5.6 Sol 跑起來卻可能讓費用翻倍以上。開發者在 1,715 次 Codex 工作階段中測得,GPT-5.6 Sol 平均每次消耗 1,645 萬 Token;相較之下,GPT-5.5 在可比的 1,667 次工作階段中平均為 730 萬 Token,前者是後者的 2.25 倍。更值得注意的是,Responses API 還有一項已有紀錄的缺陷,看來會讓 Sol 的計費 output_tokens 膨脹至 6 倍以上。如果你覺得 GPT-5.6 的帳單不太對勁,這個直覺很可能沒錯。
GPT-5.6 Sol 實際會吃掉多少 Token?
開發者 Vincent Schmalbach 追蹤了 Token 消耗量,比較兩個各為 14 天的 Codex 使用週期;在工作階段數量幾乎相同的前提下,對照 GPT-5.5 xhigh 與 GPT-5.6 Sol xhigh:
| 指標 | GPT-5.5 xhigh | GPT-5.6 Sol xhigh |
|---|---|---|
| 工作階段 | 1,667 | 1,715 |
| Token 總數 | 12.17B | 28.22B |
| 每次工作階段 Token 數 | 7.30M | 16.45M |
工作階段數只增加 2.9%,每次工作階段的 Token 用量卻增加了 125%。在工作負載大致相同的情況下,總消耗量從 121.7 億跳升到 282.2 億,是 2.32 倍。
OpenAI 定價頁面顯示,GPT-5.6 Sol 的輸入價格為每 100 萬 Token $5、輸出為每 100 萬 Token $30,與 GPT-5.5 完全相同。但 Token 用量若是 2.25 倍,每項任務的成本自然也約為 2.25 倍。此外,GPT-5.6 Sol 新增了快取寫入附加費,費率是輸入價格的 1.25 倍,GPT-5.5 則沒有這項費用。
「GPT 5.6 Sol 根本是 Token 熔爐。就連 medium 或 high 的 Sol 都像在狂吞 Token。5.6 以後只會用在複雜規劃或棘手 bug。」— r/codex 使用者
Schmalbach 原本可支撐一週高強度工作的三個訂閱,如今大約一天的中等用量就會耗盡。
Sol 為什麼用了更多 Token?
若以基準測試分數衡量,Sol 的效率其實優於競品。在 Artificial Analysis Coding Agent Index 中,達到相同分數時,它使用的輸出 Token 少於 Claude Fable 5。不過在真實工作階段裡,Sol 的推理方式更積極:會規劃、回頭檢查、驗證結果,並探索替代方案。代價就是每項任務燃燒更多 Token,儘管每一個 Token 產出的有效工作可能更多。
Responses API 的計費缺陷可能放大輸出 Token 數
除了真實用量本來就較高,Responses API 還出現一項已有紀錄的計算缺陷:它似乎會放大 output_tokens 欄位,而計費正是依此欄位進行。OpenAI 正在調查,但尚未公開確認根本原因。
一名開發者針對 710 次 GPT-5.6 呼叫、合計 22,922 次推理呼叫記錄了這個問題。GPT-5.6 是第一個會在單次回應中輸出多個 reasoning 項目的模型家族:Sol 的中位數 k=9,Terra 則是 k=4。API 中的累加器會在生成過程中,每出現一個推理項目就額外加上一次累積中的推理總數,疊加於原本正確的最終計數之上。
計算公式如下:
output_tokens ≈ R × (k + 3) / 2其中 R 是實際的推理 Token,k 是推理項目數。以 Sol 的中位數 k=9 計算,計費數字約會膨脹為 6 倍;Terra 的 k=4 則約為 3.6 倍。
實際帳單上會長什麼樣子?
已記錄案例中最極端的一筆,是單次 GPT-5.6 Terra 呼叫只回傳四個字元的答案 d1d4,卻被計費 466,818 個輸出 Token;實際推理 Token 僅有 21,064 個。
| API 回報項目 | 數值 |
|---|---|
output_tokens(計費) | 466,818 |
reasoning_tokens(實際) | 21,064 |
| 可見輸出 | d1d4(4 個字元) |
| 推理項目數(k) | 41 |
當 k=41 時,公式預測為 R × (41+3)/2 = 21,064 × 22 = 463,408,與計費金額的差距不到 0.7%。回報者也以計費儀表板交叉驗證:將 API 的 output_tokens 加總,並套用公開費率後,能重現儀表板上的費用,精確到美分的小數點後一位。在其 GPT-5.6 呼叫中,約 $320 的帳單有約 $284 屬於超額計費。
這個問題早在 GPT-5.6 之前就存在
當 k=1,也就是 GPT-5.6 之前的模型會輸出的單一推理項目時,公式可化簡為 R × 4/2 = 2R,代表固定 2 倍的超額計費。回報者以 2026 年 5 月OpenAI 自家的用量匯出資料驗證了這點:
| 模型 | 計費輸出 Token | 實際數量 | 比率 |
|---|---|---|---|
| o3-mini | 25,408,973 | 12,376,132 | 2.02x |
| gpt-5.4-nano | 11,718,610 | 5,844,140 | 2.00x |
| o1 | 778,989 | 335,944 | 2.01x |
| o4-mini(對照組) | 12,054,680 | 9,160,567 | 1.01x |
GPT-5.6 並非這個缺陷的起點;它只是第一個把推理切分成許多項目的模型,因而讓原本不易察覺的 2 倍問題,變成更驚人的乘數。原因在於推理會以約 512 Token 為一個區塊輸出,因此 k ≈ ceil(R/512)。代入公式後可得 output_tokens ≈ R²/1024 + 3R/2,代表超額計費會隨推理長度呈二次成長:思考量加倍,帳單大致可能變成四倍。
截至本文撰寫時的 2026 年 8 月,OpenAI 員工已回覆該錯誤報告並要求提供更多資料,但尚未公開確認修正方案或帳務調整。
7 月 30 日降價後的 GPT-5.6 最新定價
2026 年 7 月 30 日,OpenAI 將 Luna 降價 80%、Terra 降價 20%,Sol 的價格則維持不變。以下是OpenAI 定價頁面列出的現行費率:
| 模型 | 輸入(短) | 快取輸入 | 快取寫入 | 輸出(短) | 輸出(長) |
|---|---|---|---|---|---|
| GPT-5.6 Sol | $5.00 | $0.50 | $6.25 | $30.00 | $45.00 |
| GPT-5.6 Terra | $2.00 | $0.20 | $2.50 | $12.00 | $18.00 |
| GPT-5.6 Luna | $0.20 | $0.02 | $0.25 | $1.20 | $1.80 |
| GPT-5.5 | $5.00 | $0.50 | — | $30.00 | $45.00 |
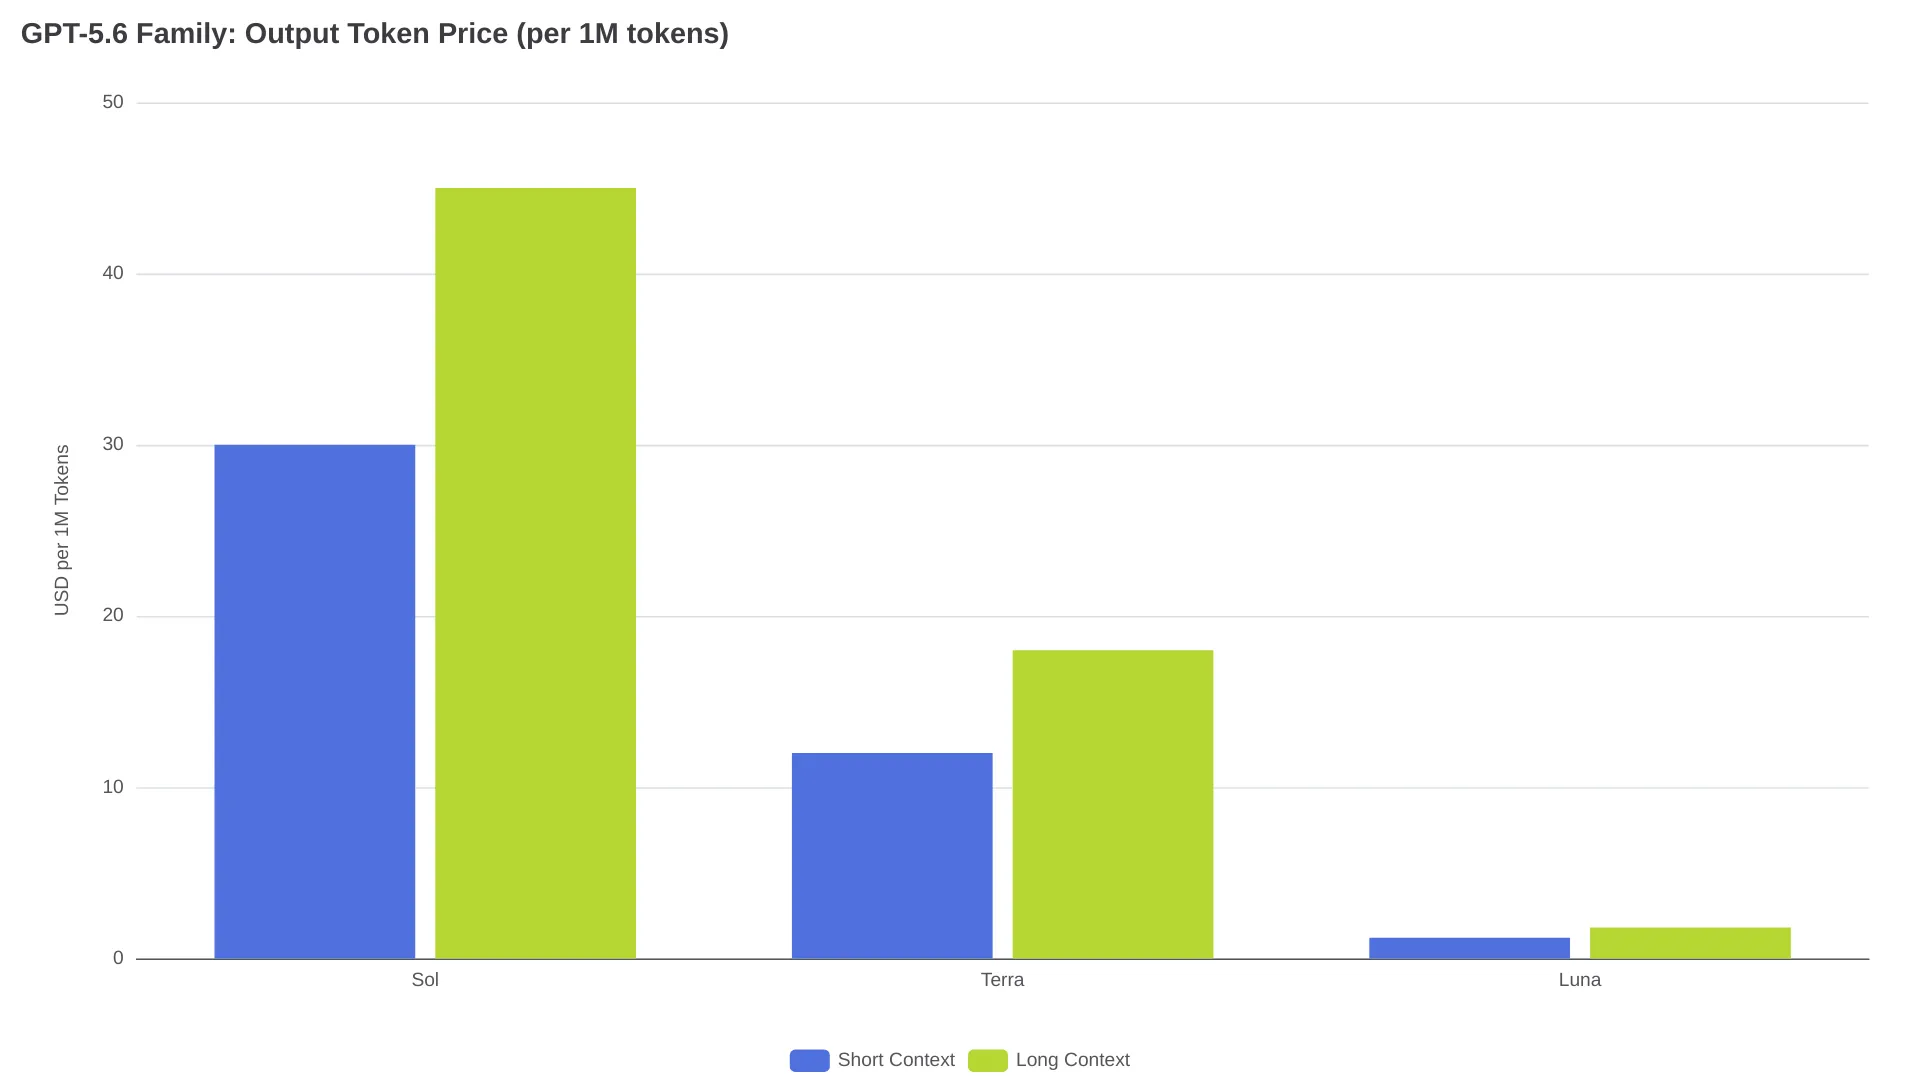
Sol 的單一 Token 單價與 GPT-5.5 相同,但每項任務的 Token 用量是 2.25 倍,因此實際每項任務成本約會翻倍。
快取寫入成了新的計費項目。GPT-5.6 的快取寫入費率是輸入費率的 1.25 倍,Sol 為每 100 萬 Token $6.25;GPT-5.5 並無這項費用。若你的工作負載快取命中率偏低,輸入成本會額外多出 25%,這是以前不存在的支出。
Luna 現在比 GPT-5.4 nano 更便宜。降價後,Luna 的價格為 $0.20/$1.20,相較於nano 的 $0.20/$1.25,已成為 OpenAI 產品線中最便宜的模型。
降低 GPT-5.6 Token 帳單的三種做法
一般任務改用 Terra
Terra 的輸出費率為每 100 萬 Token $12,比 Sol 的 $30 低 60%。在 Artificial Analysis Coding Agent Index 中,Terra 的分數略高於 Claude Fable 5。經過 7 月的 20% 降價後,Terra 的 $2.00/$12.00 定價也低於舊版 GPT-5.5 的費率。
那麼 Sol 何時還值得用?例如多步驟除錯、大型程式碼庫的架構規劃,以及安全分析。這類任務能從較長的推理鏈中獲益。至於一般程式開發、分析與內容生成,Terra 往往能以少得多的 Token 消耗,提供相近的結果。
降低推理強度設定
reasoning.effort 參數控制模型產生多少推理 Token,而已回報的計費缺陷會隨推理項目數(k)直接放大。在 medium 設定下,Sol 輸出的推理項目比 xhigh 少,因此計費膨脹也會等比例下降。
「我用 Terra Ultra,Token 用量看起來其實比 GPT 5.5 高效很多。」— r/codex 使用者
這種 Token 熔爐般的情況,主要集中在高推理強度的 Sol。把 reasoning.effort 從 xhigh 或 max 降至 medium 或 high,是影響成本最大的一項調整。
盡量提高快取命中率
GPT-5.6 加入了明確的快取斷點,且快取生命週期至少為 30 分鐘。讀取快取可享 90% 折扣,讓 Sol 的輸入成本從每 100 萬 Token $5.00 降至 $0.50;但寫入快取則要支付輸入費率的 1.25 倍,Sol 為每 100 萬 Token $6.25。
建議調整 Prompt 結構,將系統訊息與固定上下文放在快取斷點之前。損益兩平點取決於你的實際工作負載:快取寫入溢價是輸入費率的 25%,快取讀取則可省下 90%,因此只要讀取節省的費用超過寫入附加費就值得。若多數請求共用很長的系統 Prompt,通常很快就會對你有利。
常見問題
OpenAI 是否已承認這項計費缺陷?
OpenAI 員工 Mark G. 已於 2026 年 7 月 12 日回覆社群論壇的報告,要求提供 request ID 與時間戳記以便調查。截至 2026 年 8 月,尚未公開確認修正措施或追溯性的帳務調整。
如何確認我的帳戶是否受到計費缺陷影響?
針對任何含有多個推理項目的回應,將 usage.output_tokens_details.reasoning_tokens 與可見完成內容的 Token 數相加。如果 usage.output_tokens 比這個總和高出超過幾個百分點,帳單很可能受到論壇報告中所記錄的累積重複加總行為影響。你可以從 OpenAI 儀表板下載用量 CSV,並依模型逐一檢查。
我應該從 Sol 改用 Terra 嗎?
對大多數 API 工作負載而言,Terra 成本更低,且在程式設計基準測試上的表現具競爭力。Sol 的優勢則在最困難的任務:OpenAI 自家的基準測試顯示,Sol 在多步驟推理與安全研究上領先 Terra 最多,因為這些情境最能從更長的思考時間中獲益。