 AIREITER
GLM-5.3-Flash 的輸入費率每百萬 Token 只要 $0.15,但這還不是完整成本。快取命中率、輸出 Token 數量、強制啟用的推理機制,以及約 320B 參數的模型權重規模,才是決定該用 API 還是自架開放權重版本的關鍵。
目前正式生效的 GLM-5.3-Flash 價格
Z.AI 官方定價頁面列出,GLM-5.3-Flash 每 100 萬個新輸入 Token 收費 $0.15、快取輸入 Token 為 $0.03、輸出 Token 為 $0.50。官方目前另提供限時 5 折優惠,截止時間是 2026 年 9 月 9 日 24:00,時區為 UTC+8(新加坡時間)。
| GLM-5.3-Flash 計費項目 | 牌價/100 萬 Token | 優惠價/100 萬 Token |
|---|---|---|
| 新輸入 | $0.15 | $0.075 |
| 快取輸入 | $0.03 | $0.015 |
| 輸出 | $0.50 | $0.25 |
| 快取輸入儲存 | 限時免費 | 限時免費 |
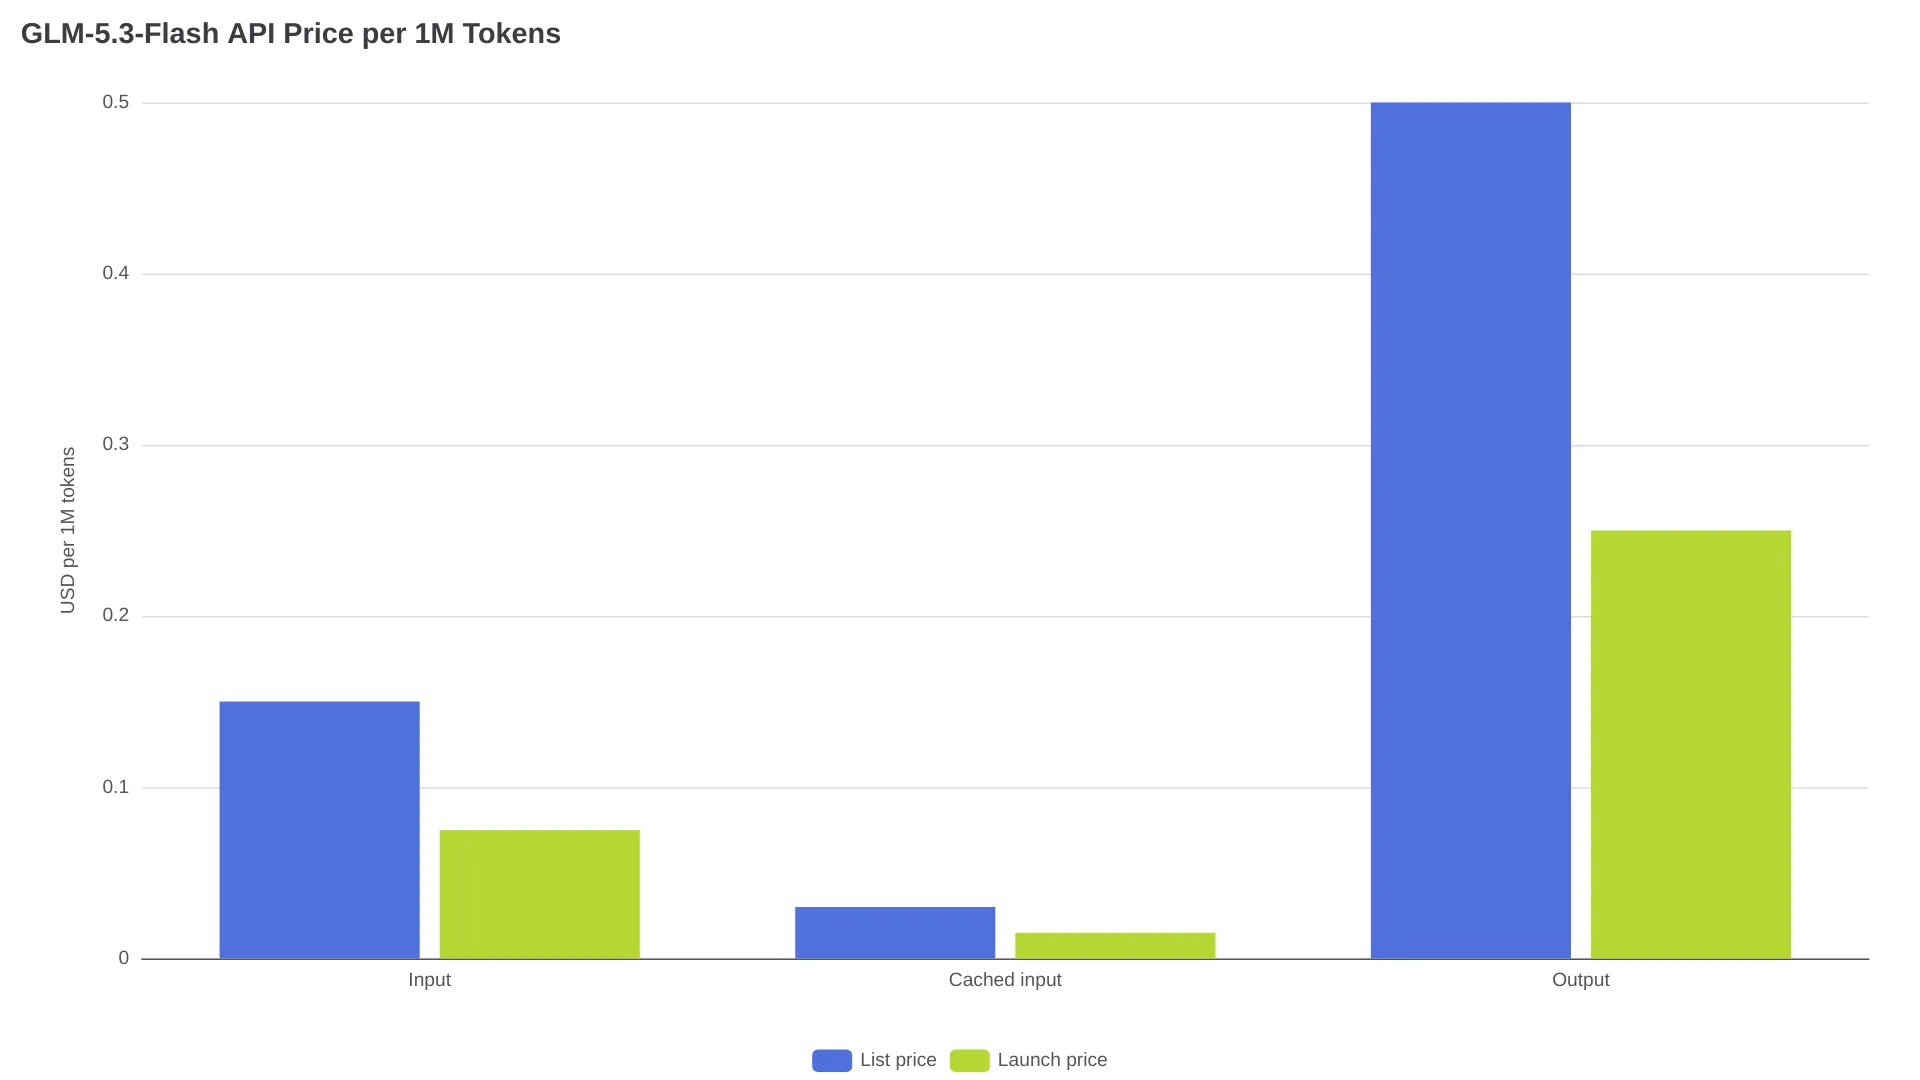
這 5 折應視為短期促銷,而不是正式上線服務的長期預算基準。Z.AI 的發布公告也指出,ox-alpha是先前的預覽版名稱。
同一份官方價目表中,標準版 GLM-5.3 的新輸入、快取輸入及輸出,每 100 萬 Token 分別為 $1.40、$0.26 與 $4.40。以牌價來看,Flash 的輸入與輸出成本都約低 89%。不過,這只是價格比較,不代表兩個模型在品質、延遲或實際運作特性上完全相同。
你買到的是 API 服務,不是一個縮小版的本機模型
GLM-5.3-Flash 是採 MIT 授權的開放權重多模態模型,總參數量為 320B,每個 Token 實際啟用 18B 參數。官方 Hugging Face 模型卡提供公開的 zai-org/GLM-5.3-Flash checkpoint,以及本機部署方式;Z.AI 的發布資料則描述它支援 100 萬 Token 上下文,以及文字、圖片與影片輸入。
所謂「18B active」指的是每次推理時被選中的專家計算量,並不是模型的總記憶體需求。完整權重、KV cache、執行期額外開銷、多模態處理與上下文長度,仍會左右本機部署是否可行。
| 取得方式 | 提供內容 | 主要限制 |
|---|---|---|
| Z.AI API | 依新輸入、快取輸入與輸出 Token 計費的託管推理服務 | 帳戶限制與推理延遲 |
| 官方 checkpoint | 可用於自架或微調的 MIT 授權權重 | 依精度與量化方式而定的高記憶體基礎設施需求 |
| 社群量化版本 | 可供部分本機執行環境使用的較小模型檔 | 建置品質、多模態支援、速度與相容性各有差異 |
低 Token 單價與低自架成本是兩件不同的事。流量忽高忽低時,API 是隨實際請求計費;自行架設則即使在閒置期間,也得預留推理容量。
實際工作負載怎麼算 API 費用
GLM-5.3-Flash 的成本取決於新輸入、被辨識為快取的輸入,以及模型產生的輸出,各自所占比例:
cost = (new_input_tokens / 1,000,000 × input_rate)
     + (cached_input_tokens / 1,000,000 × cached_rate)
     + (output_tokens / 1,000,000 × output_rate)
以牌價計算,1,000 萬個新輸入 Token 加上 200 萬個輸出 Token,總成本為 $2.50:輸入 $1.50、輸出 $1.00。促銷期間,同樣用量則為 $1.25。
| 工作負載 | 牌價計算方式 | 牌價總額 | 促銷總額 |
|---|---|---|---|
| 1,000 萬新輸入 + 200 萬輸出 | $1.50 + $1.00 | $2.50 | $1.25 |
| 200 萬新輸入 + 800 萬快取輸入 + 200 萬輸出 | $0.30 + $0.24 + $1.00 | $1.54 | $0.77 |
| 10 萬新輸入 + 1 萬輸出 | $0.015 + $0.005 | $0.020 | $0.010 |
Artificial Analysis顯示的每百萬 Token $0.10 混合費率,採用的是快取命中、輸入、輸出比為 7:2:1 的既定組合。這個數字適合拿來比較相同類型的工作負載,並不是 GLM-5.3-Flash 的通用費率。
要享有快取折扣,前提是請求確實命中快取。Z.AI 的Chat Completion 回應結構提供 usage.prompt_tokens_details.cached_tokens 欄位;因此生產環境的成本紀錄應保存這個欄位,而不是看到提示詞相似就假設一定有折扣。r/opencodeCLI 上有使用者這樣形容上市初期的經濟性:
「9 月 9 日前有 5 折優惠,而且它的上下文消耗比 dsv4f 好很多……」— u/CriteriumA,Reddit 討論串
折扣日期由 Z.AI 價目表確認;至於模型比較與使用感受,則是該留言者的個人觀點。穩定且重複的上下文有助於提高快取重用率,但輸出、重試、工具呼叫與帳戶限制等成本並不會因此消失。
一份簡潔的成本預估表
預算最好分成四項:新輸入、快取輸入、輸出與付費工具。Z.AI 將 Web Search 定價為每次 $0.01,因此代理程式頻繁搜尋時,實際花費可能超過只計 Token 的估算。
| 每月用量假設 | 牌價計算公式 | 每月成本 |
|---|---|---|
| 1 億新輸入 + 2,000 萬輸出 | 100 × $0.15 + 20 × $0.50 | $25.00 |
| 2,000 萬新輸入 + 8,000 萬快取輸入 + 2,000 萬輸出 | 20 × $0.15 + 80 × $0.03 + 20 × $0.50 | $23.40 |
| 100 次 Web Search 呼叫 | 100 × $0.01 | $1.00 |
這些只是算術範例,不是用量配額。重試請求與中途放棄的代理任務,應另外納入預算。若輸出量很高,設定合理的 max_tokens,並在適用情況下改用較低的 reasoning_effort,往往比微調一小段提示詞前綴更有影響。
遷移前先確認 Z.AI API 的限制
Z.AI API 的通用 Base URL 是 https://api.z.ai/api/paas/v4/,Chat Completions 端點為 https://api.z.ai/api/paas/v4/chat/completions。驗證方式採用 Bearer API key。Z.AI 在其API 介紹文件中,說明可透過自訂 Base URL 使用與 OpenAI 相容的 Python、Node.js 和 Java 客戶端模式。
目前的Chat Completion 參考文件在 thinking 與 reasoning 說明中提到 GLM-5.3-FLASH,但頁面渲染出的 model enum 並未顯示 glm-5.3-flash;官方定價頁與發布資料則有列出 Flash SKU。正式切換生產流量前,建議先用小型請求測試精確的託管模型 ID。
| 串接細節 | 已確認的限制 |
|---|---|
| 建議測試的託管模型 ID | glm-5.3-flash;請依即時帳戶 schema 確認是否接受 |
| 託管端點 | https://api.z.ai/api/paas/v4/chat/completions |
| 驗證方式 | Authorization: Bearer YOUR_API_KEY |
| Thinking | GLM-5.3-FLASH 會啟用 thinking;深度由 reasoning_effort 控制 |
| Reasoning effort | low、high 或 max |
max_tokens 上限 | 目前參數文件列為 131,072 |
| Coding Plan | 採用獨立的金鑰、端點與額度系統;不是通用 API 餘額。請參閱 Z.AI 的 Coding Plan 快速入門 |
Z.AI 將 max 設為預設推理強度。不同強度不會改變 Token 單價,但推理可能增加輸出用量與等待時間。至於帳戶限制,Z.AI 引導使用者查看帳戶專屬的速率限制儀表板;公開指引未提供適用於所有 API 帳戶的統一數值上限。
開放權重自架與託管 API,該怎麼選
官方模型卡提供 Transformers、vLLM、SGLang、TokenSpeed 與 KTransformers 的本機部署範例,但這些範例不代表一般消費級 GPU 就能實際部署。
若流量不固定,或手邊沒有高記憶體推理硬體,託管 API 通常更合適。當使用率長期穩定,或資料處理控制權的價值足以抵銷營運成本時,才可考慮分散式或本機部署。降精度的純文字版本,也未必能重現官方多模態配置。
什麼情況下值得考慮自行架設
GetDeploying 的估算指出,4-bit 部署約需 192 GB GPU 記憶體、8-bit 約需 384 GB,BF16 則為 768 GB。其估計一組 MI300X 配置每小時 $2.90,持續運行一個月約為 $2,088;在輸入與輸出比為 5:1 的條件下,API 與自架成本約在每小時 1,400 萬 Token 時打平。
這些是第三方估計,不是 Z.AI 對硬體需求的保證。192 GB 的 4-bit 配置被標記為緊繃;KV cache、執行期開銷、多模態處理、批次處理與閒置時間,都可能改變損益平衡點。做選擇前,應比較每小時基礎設施成本、使用率、每小時有效 Token 處理量、快取命中率,以及每個完成任務的成本。
GLM-5.3-Flash 與 GLM-5.3:選擇的分界點
Flash 與標準 GLM-5.3 的費率表與部署定位並不相同。
| 比較問題 | GLM-5.3-Flash | GLM-5.3 |
|---|---|---|
| 牌價輸入費率 | $0.15 / 1M | $1.40 / 1M |
| 牌價快取輸入費率 | $0.03 / 1M | $0.26 / 1M |
| 牌價輸出費率 | $0.50 / 1M | $4.40 / 1M |
| 限時優惠 | 2026 年 9 月 9 日 UTC+8 前享 5 折 | 未顯示對應的 Flash 優惠 |
| 開放權重 checkpoint | 列有官方 MIT checkpoint | 另有獨立模型頁面;不可推論權重相同 |
| 多模態定位 | 原生多模態;Z.AI 說明支援圖片/影片輸入 | 標準 GLM-5.3 的支援範圍應個別確認 |
| 本機部署 | 需要大型 checkpoint 與高記憶體推理環境 | 應參考其專屬模型與部署文件 |
如果重視 Token 成本、多模態輸入,或需要開放權重方案,而應用程式能接受強制推理與供應商限制,應先從 Flash 開始評估。只有在實測確認標準 GLM-5.3 額外的費率確實換來應用所需的能力或可靠性差異時,才適合選擇標準版。
常見問題
GLM-5.3-Flash API 目前怎麼計價?
官方牌價為每 100 萬 Token:輸入 $0.15、快取輸入 $0.03、輸出 $0.50;上方費率表也列出限時 5 折後的價格。
快取輸入一定適用 $0.03 費率嗎?
是,但前提是 Z.AI 將這些 Token 辨識為快取輸入。快取輸入儲存另列為限時免費,因此儲存狀態與快取命中的計費不能混為一談。
GLM-5.3-Flash 是開源模型嗎?
更精確的說法是:它是採 MIT 授權的開放權重 checkpoint。此授權允許廣泛使用,但這個總參數量 320B 的模型仍需要大量記憶體、相容的軟體與推理容量。
一般筆電能跑 GLM-5.3-Flash 嗎?
若要以完整精度實際部署,並不現實。即使第三方對 4-bit 的估算也約需 192 GB GPU 記憶體,而每 Token 僅啟用 18B 參數,並不會消除完整 checkpoint 的儲存與執行成本。
GLM-5.3-Flash 比 GLM-5.3 快嗎?
「Flash」反映的是成本與活躍計算量的定位,並非通用的延遲保證。Artificial Analysis在其測試環境中,測得透過 Z.AI 的輸出速度為每秒 48.7 個 Token,第一個回答 Token 的時間為 42.57 秒;推理時間與工作負載型態都可能主導實際體感回應速度。
Coding Plan 提供相同的 API 餘額嗎?
不提供。Z.AI 的 Coding Plan 快速入門說明,Coding Plan 使用獨立金鑰、獨立端點,且僅限官方支援的工具與產品使用。Coding Plan 訂閱不應直接換算成公開 API 的每 Token 美元預算。
如果流量不固定、硬體也不是既有成本,API 是風險較低的選擇;本機部署則是另一種經濟決策,取決於長期使用率、記憶體條件與資料控制需求。