 AIREITER
無論是把錄音整理成可用文字,還是從麥克風即時串流字幕,Gemini 3.5 Transcribe 都值得納入評估。它支援文字清理、自訂詞彙與多語言處理,但檔案 API 和 Live API 的限制差異很大:前者適合保存與後續處理的完整逐字稿,後者則適合短時間、低延遲的即時轉錄。
先講結論:除非需要即時字幕,否則優先選檔案 API
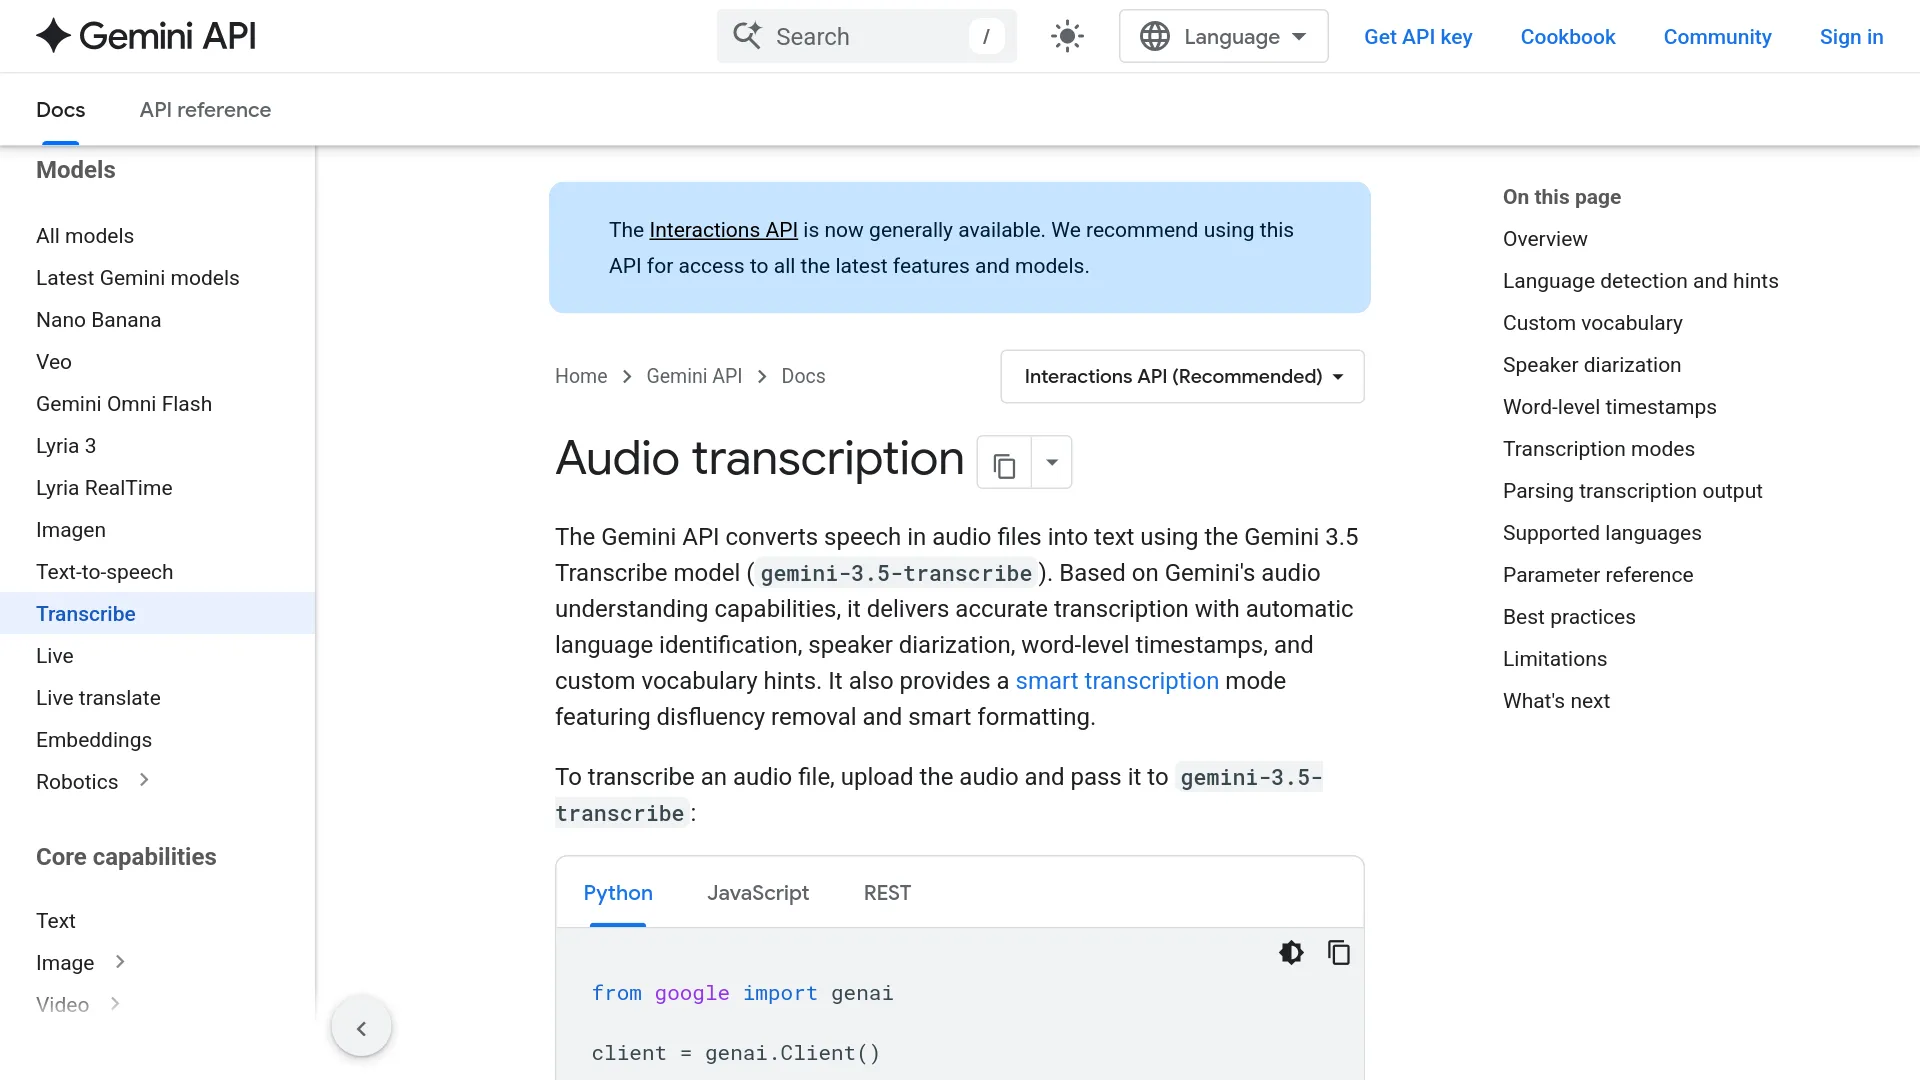
Gemini 3.5 Transcribe 是 Google 專門用於語音轉文字的模型系列,自 August 26, 2026 起以 public preview 形式提供。針對錄製音訊與即時音訊,Google 分別提供不同的模型 ID、傳輸方式、輸出事件與使用限制。
| 使用需求 | 模型 ID | API 路徑 | 重要限制 |
|---|---|---|---|
| 會議、通話、上傳的錄音 | gemini-3.5-transcribe | Interactions API | 標準 unary request 最長 1 hour;啟用 diarization 或 word timestamps 時最長 30 minutes |
| 即時字幕、麥克風輸入、語音介面 | gemini-3.5-transcribe-live | Live API | 連續工作階段最長 10-minute;不支援 live diarization 或 word-level timestamps |
如果目標是建立會議檔案、分析通話內容或製作字幕,建議從 gemini-3.5-transcribe 開始。若要做字幕預覽或 push-to-talk 介面,則使用 gemini-3.5-transcribe-live。Google 的錄製音訊轉錄指南與 Live API 指南分別說明了兩套工作流程。
目前仍是預覽版,正式上線前要先做實測
Google 在 August 26, 2026 宣布 Gemini 3.5 Transcribe,並列出可透過 Google AI Studio 與 Google Antigravity 使用的 developer API public preview。企業使用者則可透過 Gemini Enterprise Agent Platform 取得 preview 版本。預覽版的地區支援、配額與穩定性可能和正式提供的語音服務不同,因此在投入重要或大量工作負載前,應先用具代表性的音訊進行測試。
Gemini 3.5 Transcribe 的價格,換算成實際使用單位
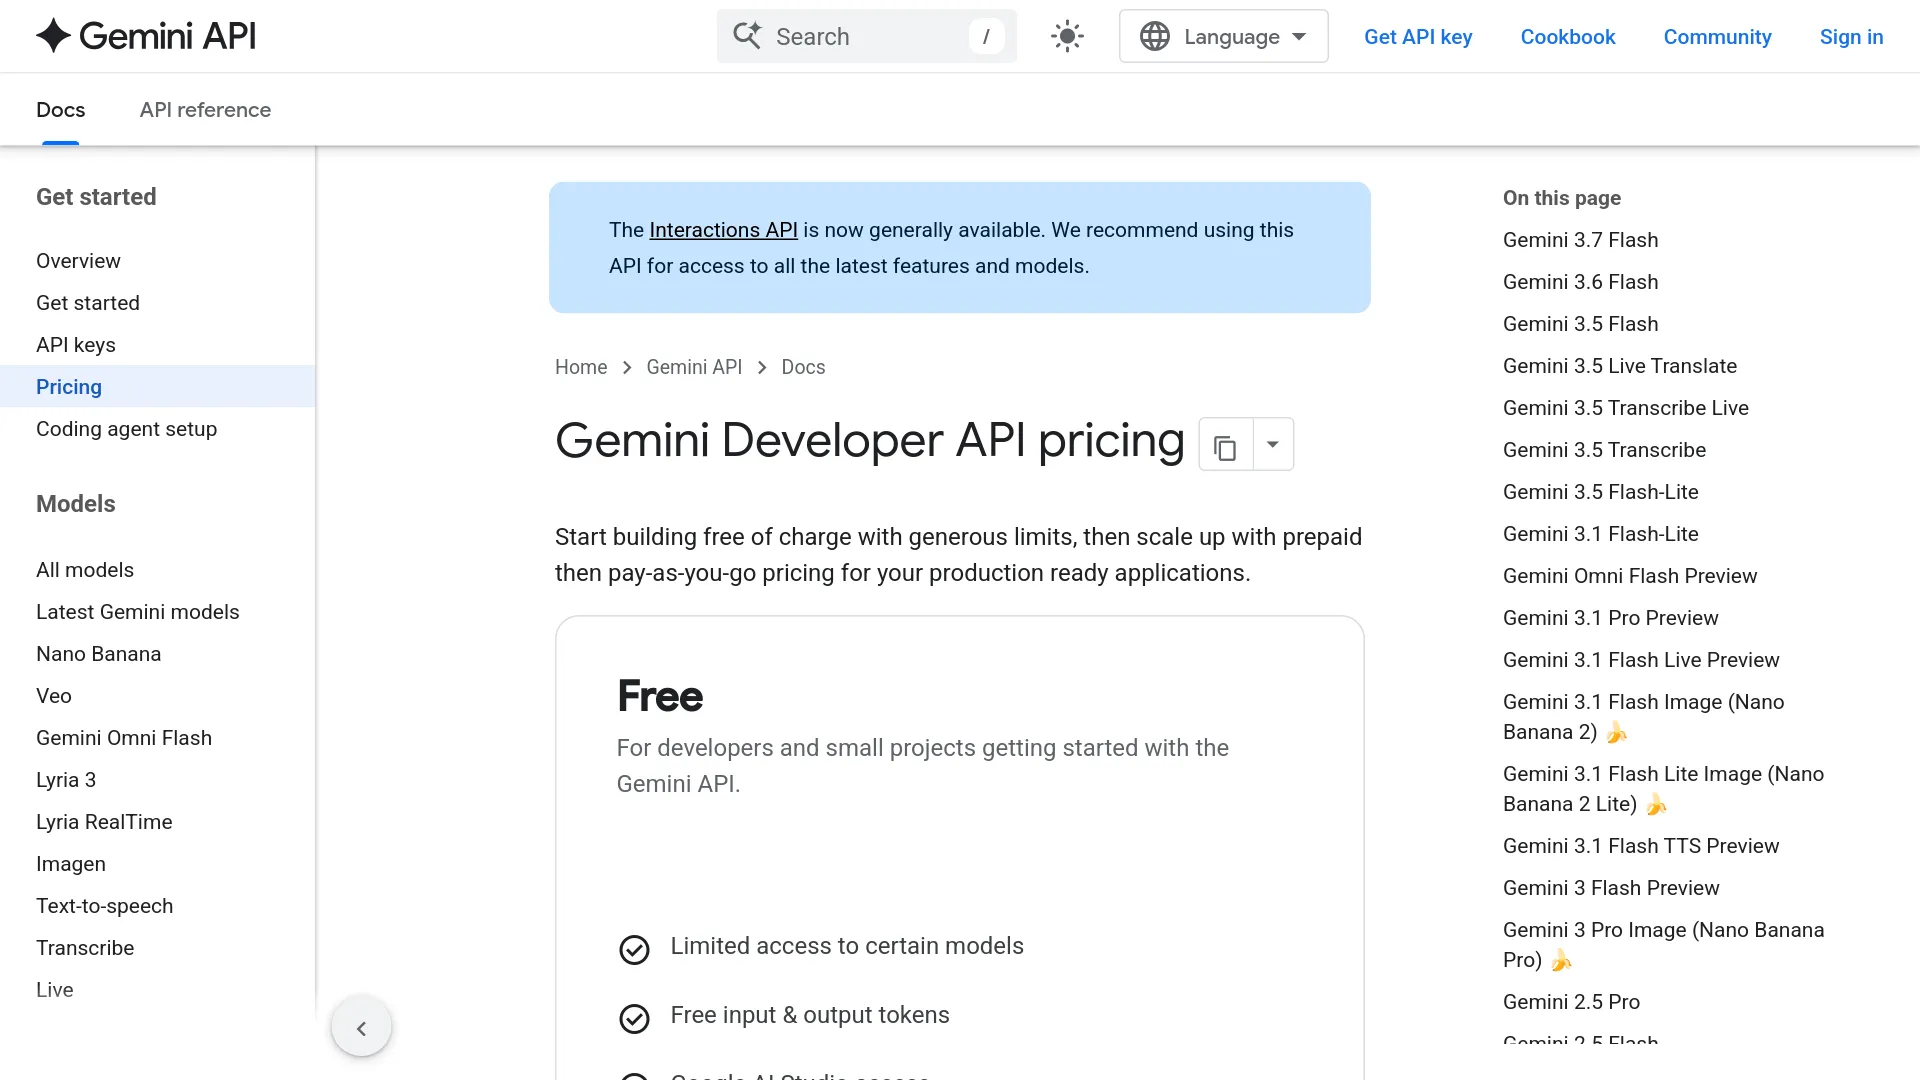
Google 的Gemini API 定價頁面採用 token 計價,而不是固定的轉錄費率。目前的價格資訊顯示,gemini-3.5-transcribe 的音訊輸入為每 million audio-input tokens $2,文字輸出為每 million text-output tokens $12。
Google 的音訊文件指出,音訊以每秒 32 tokens表示,也就是每分鐘 1,920 audio tokens。因此,在每 million tokens $2 的價格下,單算音訊輸入約為每分鐘 $0.00384,尚未包含文字輸出與其他可計費 token。
| 模型 | 公開定價基準 | 參考混合估算 | 參考 1-hour 估算 |
|---|---|---|---|
gemini-3.5-transcribe | $2/M audio-input tokens + $12/M text-output tokens | About $0.005/min | About $0.30/hour |
gemini-3.5-transcribe-live | Token-based live audio and text processing | About $0.009/min | About $0.54/hour |
混合估算會受到轉錄輸出量影響,因此只能作為規劃參考,並非保證的每分鐘固定費率。輸出內容較密集、重複傳送上下文,或加入更多指令,都可能改變實際帳單。由於預覽版價格可能調整,正式投入大量使用前,請再次確認目前的定價表。
正式環境最需要留意的功能取捨
逐字轉錄,還是整理成更好讀的文字?
VERBATIM 是 Google轉錄文件中的預設模式。它會保留語助詞、重複、停頓、說到一半的句子,以及原本口語中的更正。若轉錄內容要作為紀錄、證據、字幕來源,或交給品質控管流程使用,應選擇這個模式。
SMART 則是以可讀性為主的整理模式。它會移除口語贅詞與不流暢片段、處理自我更正、加入標點與結構,也能格式化日期、貨幣、數字、清單與段落。例如口頭說出的「Tuesday—no, Wednesday」,清理後可能只會留下「Wednesday」。
Smart mode 不相容於 speaker diarization 或 word-level timestamps。如果應用程式同時需要易讀筆記與可稽核性,建議先取得 verbatim 輸出,再另外複製一份進行清理。
自訂詞彙與語言切換
Google 文件指出,系統可在85+ locales之間自動偵測語言,也能處理 code-switching。如果已知音訊語言,可以提供 en-US 或 es-ES 這類 BCP-47 code,讓辨識結果偏向指定語言。
Custom vocabulary 最多可放入1,000 terms,但 Google 的實務建議是控制在100 terms or fewer,通常能得到較好的結果。詞彙表應以獨特的產品名稱、縮寫、人名、醫學術語或技術詞彙為主,不要塞入一般日常用語。
說話者標籤與單字時間戳記
錄製音訊可以回傳說話者歸屬與單字層級的時間資訊。API 文件列出的上限是eight speakers;Google 的發布文章則強調最多 three 的說話者歸屬,並將 three or more speakers 的支援標示為 experimental。
Word timestamps 必須在 verbatim mode 中啟用,會為每個單字提供開始與結束 offset。Google 警告,加入時間戳記可能降低整體轉錄準確度。此外,diarization 與 timestamps 也會把標準音訊長度上限從 one hour 降至 30 minutes。
| 需求 | 是否支援 | 注意事項 |
|---|---|---|
| 錄製音訊中的說話者標籤 | 是 | 文件列出的上限為 8;3+ attribution 屬於 experimental |
| 錄製音訊中的 word-level timestamps | 是 | 僅限 Verbatim mode;可能降低準確度 |
| 即時轉錄中的說話者標籤 | 否 | 需要辨識說話者時,請改用錄製音訊 |
| 即時轉錄中的 word-level timestamps | 否 | Live output 以增量與 utterance 為導向 |
| Smart mode 搭配標籤或時間戳記 | 否 | 需要這些註記時,請選擇 verbatim |
如何透過 Gemini 3.5 Transcribe API 傳送錄製檔案
Google 的錄製音訊指南將流程分成 three stages:先上傳檔案,再把回傳的 file URI 傳給 Interactions API,最後從 interaction.output_text 讀取完成的轉錄結果。
- 使用 Files API 上傳音訊。錄音超過幾秒,或之後還會重複使用檔案時,應採用這條路徑。
- 保存回傳的 file URI 與 MIME type,例如
audio/mp3。 - 透過 Interactions API 將 URI 傳給
gemini-3.5-transcribe。 - 讀取文字輸出;如果有要求相關資訊,也可以檢查
word_info註記中的說話者與時間資料。
官方 SDK 的流程可以濃縮成以下這段上傳與轉錄範例:
from google import genai

client = genai.Client()
file = client.files.upload(file="path/to/sample.mp3")

interaction = client.interactions.create(
    model="gemini-3.5-transcribe",
    input=[{
        "role": "user",
        "content": [{
            "type": "audio",
            "uri": file.uri,
            "mime_type": file.mime_type,
        }],
    }],
)

print(interaction.output_text)
在 Files API 上傳並取得 FILE_URI 後,REST request 可以簡化成這樣:
curl -X POST \
  "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gemini-3.5-transcribe",
    "input": [{
      "role": "user",
      "content": [{
        "type": "audio",
        "uri": "FILE_URI",
        "mime_type": "audio/mp3"
      }]
    }]
  }'
若要取得經過整理的轉錄稿,可以加入使用 smart mode 的轉錄設定:
{
  "generation_config": {
    "transcription_config": {
      "mode": { "type": "smart" },
      "language_codes": ["en-US"],
      "custom_vocabulary": ["Kubernetes", "BigQuery", "Acme Ledger"]
    }
  }
}
若需要說話者標籤與單字時間資訊,則改用 verbatim mode:
{
  "generation_config": {
    "transcription_config": {
      "mode": {
        "type": "verbatim",
        "diarization_mode": "speaker",
        "timestamp_granularities": ["word"]
      }
    }
  }
}
不要把 smart configuration 與 diarization 或 timestamps 一起使用。API 文件中的模式規則代表這是架構選擇,而不只是排版偏好。
即時轉錄的運作方式
Live API會使用 gemini-3.5-transcribe-live 建立雙向串流連線。用戶端持續送出音訊,並接收兩種文字事件:
interim_input_transcription:持續變動、低延遲的辨識結果,適合字幕或 UI 預覽。input_transcription:已定稿的文字,可寫入轉錄稿或應用程式狀態。
Google 的 live 指南指定音訊格式為 raw 16-bit PCM、16 kHz、mono、little-endian。指南建議每個 chunk 約100 milliseconds,每個 chunk 約包含1,024–2,048 frames。瀏覽器與行動裝置用戶端應使用受限制的 ephemeral tokens,而不是直接暴露一般 API key;Google 的範例採用 one-use token,效期為 30-minute。
Live endpoint 支援自動語言偵測、BCP-47 hints、custom vocabulary,以及 VERBATIM 或 SMART 輸出。不過它不支援 live speaker diarization 或 word-level timestamps。連續工作階段最長為10 minutes,因此更長的串流需要由應用程式自行管理工作階段並銜接轉錄內容。
在判斷每個回合的開始與結束時,Live API 提供 three approaches:
- Automatic VAD:由伺服器偵測語音開始與結束。
- Hybrid VAD:由用戶端偵測器發出語音結束訊號,伺服器偵測則作為 fallback。
- Manual VAD:push-to-talk 介面明確傳送 activity start 與 end events。
目前的測試證據能說明什麼,又不能說明什麼
Google 引述 Artificial Analysis 的結果,表示 streaming 的平均 WER 為4.0%,non-streaming 則為2.6%。發布文章另列出 FLEURS 的5.50% streaming WER與5.04% non-streaming WER,並表示相較於 Chirp 3,完成最終轉錄所需時間改善了 70%。
這些數據是供應商自行回報或引用的發布資料,並不是獨立完成的 Gemini 3.5 Transcribe 對照測試。公開的 koedesk STT benchmark曾測試 Gemini 3.5 Flash 與其他引擎,但沒有直接測量 Gemini 3.5 Transcribe。
早期使用者關注的問題包括檔案與即時轉錄的長度限制、WER 所使用的參考逐字稿,以及在安靜片段中辨識電話號碼或訂單編號是否可靠。實際導入前,應使用具代表性的音訊測試人名、ID、數字、說話者切換、時間資訊與延遲,不要只看平均 WER。
什麼時候適合用 Gemini 3.5 Transcribe,什麼時候應該先等等
| 情境 | 適配度 | 建議的起始設定 |
|---|---|---|
| 整理會議筆記或口述內容 | 高 | File API、SMART;已知語言時明確提供 language hint |
| 法律、合規或存檔紀錄 | 視情況而定 | File API、VERBATIM;關鍵段落人工複核 |
| 多說話者錄製通話 | 視情況而定 | File API、VERBATIM + diarization;每個工作階段控制在 30 minutes 內 |
| 與單字時間同步的字幕 | 視情況而定 | File API、VERBATIM + word timestamps;驗證時間與準確度 |
| 即時字幕 | 適合短時間工作階段 | Live API;只使用 final events 寫入已提交文字 |
| 長時間運作的語音代理 | 需要工程處理 | 在 10-minute limit 前切分工作階段,並處理重新連線 |
| 離線或機密的本機處理 | 不適合 | 文件中的工作流程會把音訊傳送到 Google service;可考慮 self-hosted ASR path |
Gemini 3.5 Transcribe 最適合放在更大工作流程的第一步:先清理口語、保留技術詞彙、辨識說話者,再把結構化文字交給後續系統。若需求只是便宜的逐字轉錄,或必須完全離線處理,它就不是理想選擇。
Gemini 3.5 Transcribe API FAQ
Gemini 3.5 Transcribe 免費嗎?
Google 為 Gemini API 使用提供 free tier,但配額與模型可用性可能變動。付費使用採 token 計價;目前定價頁列出的參考混合估算為 recorded transcription 約 $0.005 per minute,live model 則約 $0.009 per minute。
檔案模型和 live 模型有什麼不同?
gemini-3.5-transcribe 透過 Interactions API 處理上傳的錄音,並支援 recorded-audio diarization 與 word timestamps。gemini-3.5-transcribe-live 則透過 Live API 串流 raw PCM,回傳 interim 與 final events;每個工作階段最多 10-minute,且不支援 live diarization 或 word-level timestamps。
可以一次處理 three-hour recording 嗎?
使用 dedicated recorded-transcription configuration 時不行。標準 unary limit 是 one hour,啟用 diarization 或 word timestamps 後會降至 30 minutes。更長的流程需要由應用程式自行分段,並仔細處理上下文與說話者連續性。
可以離線使用 Gemini 3.5 Transcribe 嗎?
文件描述的工作流程會將音訊上傳或串流至 Google service。Google 沒有說明 Gemini 3.5 Transcribe 提供 offline 或 self-hosted 版本。
最穩妥的首次整合方式
先從實際工作負載中取一小段樣本,不要只拿乾淨的展示用音訊。對同一段音訊執行 two runs:第一次使用 verbatim mode,確認內容保真度;第二次使用 smart mode,評估可讀性。人名、數字、說話者切換、時間戳記偏移與成本,都應分開量測。
保留 raw transcript 作為唯一依據,將 smart output 用於面向使用者的筆記,並為上傳失敗或預覽模型變更準備 fallback。只有在用戶端能處理 100-millisecond PCM chunks、interim-versus-final events、ephemeral tokens,以及 10-minute session boundary 後,再切換到 Live API。