 AIREITER
Gemini 3.5 Flash 的輸出速度是 Gemini 3.1 Pro 的 2.6 倍,每個 Token 的成本低 25%,在 Artificial Analysis 的 Intelligence Index 也以 50 分領先 Pro 的 46 分。不過,Gemini 3.1 Pro 在 ARC-AGI-2 仍以 77.1% 對 72.1% 領先 5 個百分點;當上下文超過 128k Token,Flash 的長上下文檢索分數則會從 84.9% 降至 77.3%。該選哪一款,關鍵不在總分:Flash 適合追求吞吐量與工具呼叫延遲,Pro 更著重多步推理深度,而綜合基準分數往往把這兩種需求平均成一個數字,反而看不出你的工作負載真正需要什麼。
基準測試怎麼看:兩款模型各自贏在哪裡
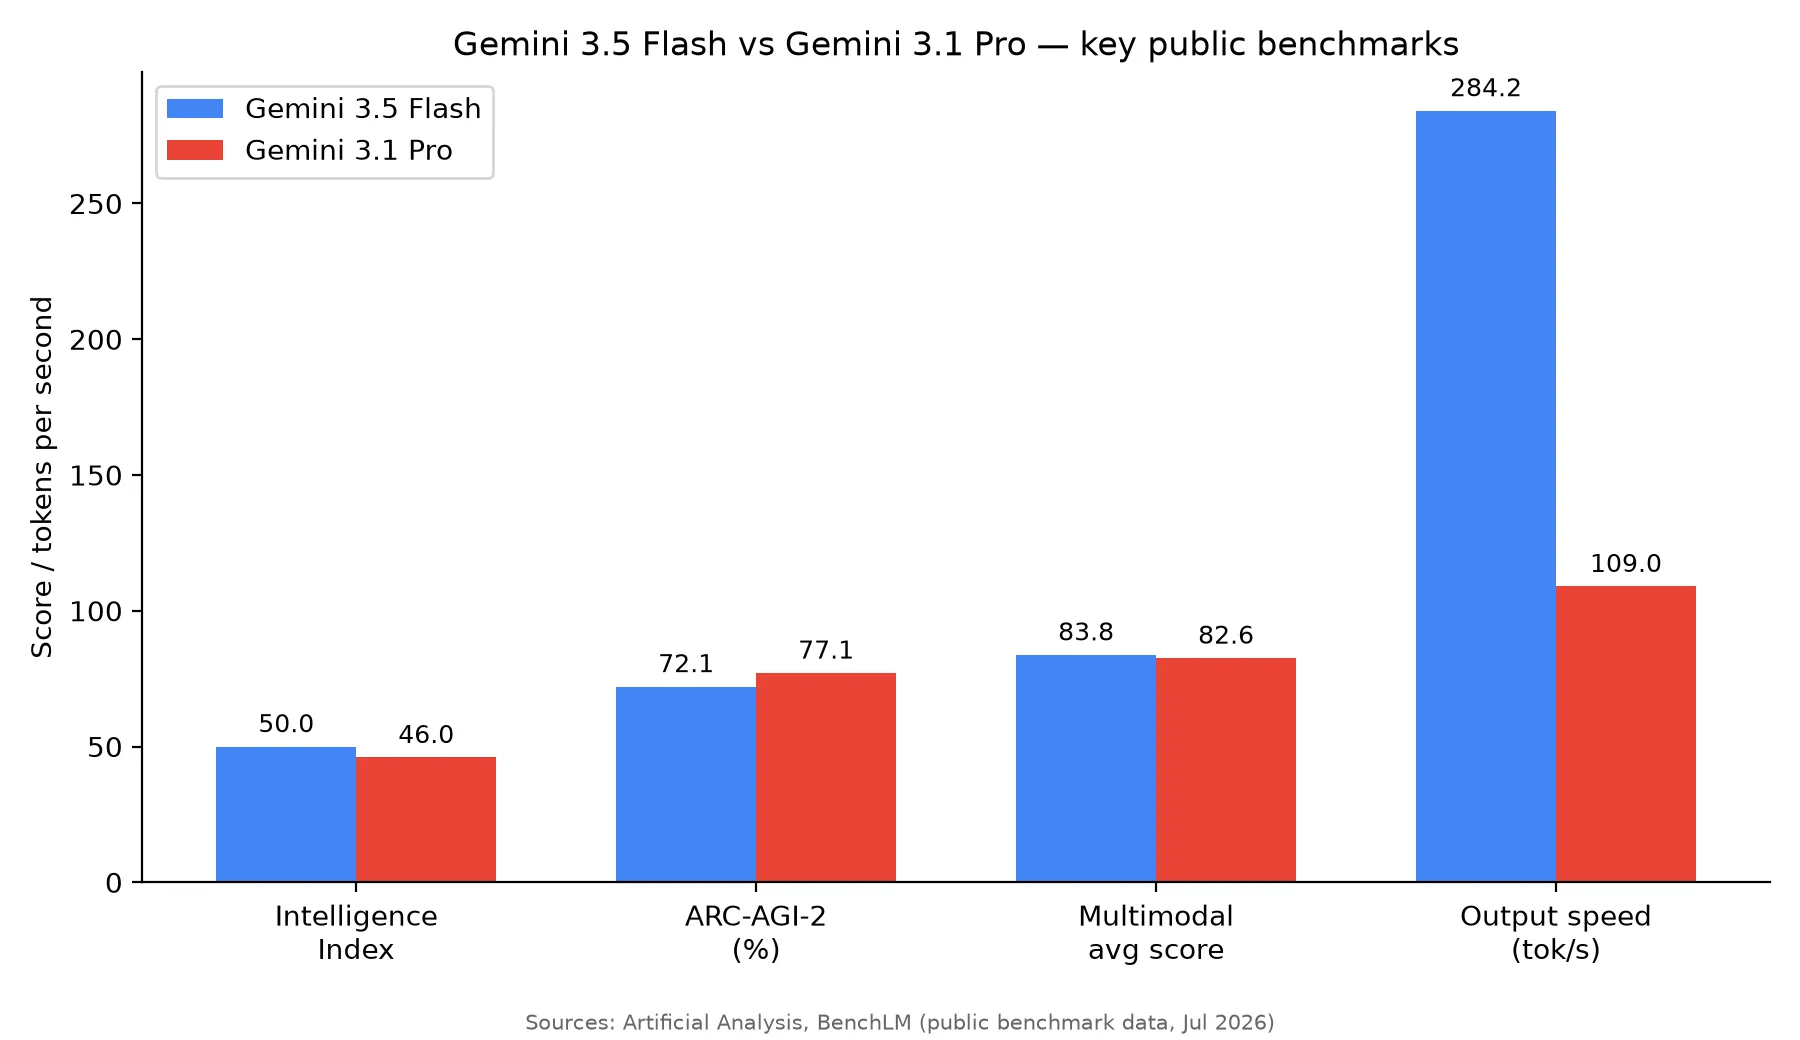
| 指標 | Gemini 3.5 Flash | Gemini 3.1 Pro | 勝出者 |
|---|---|---|---|
| Intelligence Index(Artificial Analysis) | 50 | 46 | Flash |
| ARC-AGI-2,抽象推理(BenchLM) | 72.1% | 77.1% | Pro |
| 128k 上下文下的 MRCR v2(nxcode) | 77.3%(較短上下文時為 84.9%) | 未公開相同長度的結果 | 資料不足 |
| 多模態平均分數(BenchLM) | 83.8 | 82.6 | Flash |
| 輸出速度(BenchLM) | 284.2 tok/s | 109 tok/s | Flash(2.6 倍) |
| GDPval-AA Elo,真實世界 Agent 任務(apiyi) | 1656 | 1314 | Flash |
衡量吞吐量與通用任務處理能力的指標,大多由 Flash 勝出。Pro 在 ARC-AGI-2 的推理深度有明確且已驗證的優勢;至於長上下文檢索,已有資料顯示 Flash 在超過 128k Token 後表現下滑,但 Pro 在相同長度下的分數尚未公開。因此,這項結果應視為尚無定論,而不是 Pro 已確定獲勝。相較於單一的 Intelligence Index 總分,這樣的差異更能對應到實際任務類型。
BenchLM 自己的比較方法也有一點需要留意:約 34 項同時公布兩款模型結果的基準中,僅有 3 個類別可以直接比較;Pro 有 14 項獨家結果,Flash 有 17 項,兩者的 thinking budget 設定也不一定一致。上表可作為大方向的參考:ARC-AGI-2 與 MRCR v2 的差距夠大,值得重視;但同一指標只差 1 到 2 分,則不該解讀成決定性差異。
Flash 的優勢在哪些情況會失效
在 BenchLM 的比較裡,ARC-AGI-2 的 5 分差距是兩款模型單一類別中最大的差異。ARC-AGI-2 特別設計來避免模型靠模式比對捷徑過關,因此同樣是 5 分差距,這裡比傳統基準測試更能反映推理深度。nxcode 的 MRCR v2 結果也提供了另一項同方向的證據:隨著上下文接近 128k Token,Flash 自身的檢索準確率會由 84.9% 下滑至 77.3%。Pro 在相同長度的分數沒有公開,所以這不能算是 Pro 在正面對決中勝過 Flash;但這確實是 Flash 已被記錄的退步,而 Pro 的基準表中沒有顯示同樣的弱點。
軼聞觀察,不是基準證據:一篇詢問使用者在困難任務中偏好哪款模型的 Reddit r/GeminiAI 討論串,有留言者形容 Flash「除了長上下文、抽象推理外,其他全都贏過 Pro」。這只是少數人的看法,不是數據;不過它剛好對應基準測試中呈現的兩個例外,最多只能當作一個輕度的交叉檢查,不能單獨當成證明。
定價與快取:真正拉開成本差距的地方
先看基本定價,兩者的價差其實沒有乍看之下那麼大:
- Gemini 3.5 Flash:每百萬輸入 Token $1.50,每百萬輸出 Token $9
- Gemini 3.1 Pro:每百萬輸入 Token $2,每百萬輸出 Token $12
帳面上是 25% 的折扣,不再是 Flash 相對舊款 Pro 模型曾有的 4 至 8 倍落差。真正更有影響力的是快取:
- Flash 的快取寫入免費;快取輸入成本為每百萬 Token $0.15
- Pro 的快取寫入費用為每百萬 Token $0.38;快取輸入為每百萬 Token $0.50,超過 Flash 快取輸入費率的 3 倍
只要工作流程會在多輪互動中重複傳送相同的系統提示或文件上下文,例如聊天 Agent、保留程式碼庫上下文的程式開發助理,或多輪客服機器人,這個快取差距就會迅速累積。單次請求幾乎看不出差異,但到了 1,000 輪的 Agent 工作階段,成本差別就很明顯。
而且這個價差並非固定不變。apiyi 的定價拆解指出,當上下文超過約 200k Token 後,兩款模型的價差會收斂至 25% 至 50%,因為在這個規模下,兩者的每 Token 成本結構開始趨近。如果你的工作負載主要是極長篇的一次性文件,而不是短小但重複的呼叫,Flash 的價格優勢就會減弱。
具體試算:假設一個客服機器人每天使用 1M 快取輸入 Token,並產生 500K 輸出 Token。Flash 的成本是快取寫入 $0,加上 $0.15 x 1(快取輸入)與 $9 x 0.5(輸出)= 每天 $4.65。Pro 處理相同工作負載,第一天為 $0.38(一次性快取寫入)+ $0.50 x 1(快取輸入)+ $12 x 0.5(輸出)= 約每天 $6.88;首次寫入後則降為每天 $6.50。一個月下來,約是 $140 與 $195 的差別,這還沒將真正需要 Pro 深度推理的請求納入計算。
Agent 迴圈:Flash 快得多,但不一定更可靠
nxcode 的 Agent 迴圈基準測試執行了一個 8 步驟的 Agent 迴圈,Flash 約 25 秒完成整個流程,Pro 則需 100 秒,形成 4 倍差距;步驟越多,差距累積得越明顯。在以真實世界知識工作 Agent 任務為核心的 GDPval-AA 中,Flash 的 Elo 分數為 1656,Pro 為 1314,342 分的差距也是整張基準表中最大的單項落差。
但前提是 Agent 迴圈能順利執行。ARC-AGI-2 與 MRCR v2 所呈現的推理及長上下文差距,合理地讓人預期:如果工具呼叫在迴圈中途回傳了意料之外的結果,Agent 必須重新規劃時,Flash 的容錯能力可能較低。這是根據前述推理深度數據做出的推論,不是另一項已經過基準測試的結論。若 Agent 有人類監督,並在步驟間檢查輸出,Flash 的速度優勢幾乎是直接受益;但若它要在沒有人介入的情況下自主執行許多步驟,在兩款模型的失敗率資料公布前,Pro 的推理優勢會是較安全的選擇。
該選哪一款?依任務判斷的決策矩陣
| 任務類型 | 建議模型 | 原因 |
|---|---|---|
| 日常程式開發(測試、PR 審查、程式語言轉換) | Flash | 速度與成本更有優勢,推理深度不是主要瓶頸 |
| 深度重構、全新演算法設計 | Pro | ARC-AGI-2 的差距會直接反映在多步驟邏輯推理 |
| 長文件檢索(超過 128k Token 的合約、研究語料) | Pro | Flash 在此長度有已記錄的 MRCR v2 退步;Pro 的分數雖未公開,但沒有已知弱點的模型是更穩妥的預設選擇 |
| 高量批次生成 | Flash | 免費快取寫入與 2.6 倍吞吐量在大規模使用時最重要 |
| 有人類檢查輸出的受監督 Agent 工作流程 | Flash | 可享有速度優勢,同時避開無人監督的可靠性風險 |
| 無人監督、高風險的 Agent 鏈 | Pro | 沒有人在迴圈中途攔下錯誤時,推理深度優勢是較安全的選擇 |
| 頻繁多輪呼叫,重複使用相同上下文 | Flash | 快取輸入定價約為 Pro 的三分之一 |
以上多數情境可用一條簡單規則處理:除非符合以下三種情況之一,否則優先使用 Flash——上下文超過 128k Token 且檢索準確性很重要;任務涉及抽象或多步驟推理,例如全新演算法、法律或研究綜整;或 Agent 在無人監督下要執行超過少數幾個步驟。只要命中其中一項,就較適合選 Pro;若三項皆不符合,Flash 的速度與快取定價使它成為成本更低的預設選擇。
常見問題
Gemini 3.5 Flash 比 3.1 Pro 更好嗎?
在速度、成本與通用基準測試上,是的。但在抽象推理(ARC-AGI-2)上,Gemini 3.1 Pro 仍領先 5 個百分點。至於超過 128k Token 的長上下文檢索,Flash 有已記錄的退步,而 Pro 的同等分數尚未公布,因此這項比較仍無定論,不能視為 Pro 已確認勝出。哪一款「更好」,取決於你的任務屬於哪個類別。
Gemini 3.5 Flash 比 3.1 Pro 便宜多少?
基本輸入與輸出定價約便宜 25%:每百萬 Token 為 $1.50/$9,對比 $2/$12。更大的節省來自快取:Flash 的快取寫入免費,快取輸入成本約為 Pro 的三分之一,對多輪或高用量工作負載尤其重要。
Gemini 3.5 Flash 適合寫程式嗎?
適合日常工作,例如產生測試、PR 審查、不同程式語言間的轉換。但若是深度重構或全新演算法設計,Pro 在抽象推理基準上的優勢通常會反映在輸出品質上。
Gemini 3.5 Flash 的長上下文處理能力好嗎?
在較短的上下文長度下,表現不錯,MRCR v2 檢索準確率可維持在 84.9%。但超過 128k Token 後會降至 77.3%,對多文件合約審查等任務而言是有意義的差距。Gemini 3.1 Pro 在相同長度的分數尚未公開,因此這應視為 Flash 已知的限制,而不是 Pro 已確認的優勢。
結論
對大多數日常與高量工作來說,Gemini 3.5 Flash 是更好的預設選擇:它更快、快取更便宜,且通用基準上的差距通常不足以改變取捨。Gemini 3.1 Pro 的較高成本,則在抽象推理與無人監督的 Agent 鏈中更有價值;面對超過 128k Token 的長文件,Flash 自身數據已顯示弱點,而 Pro 的結果既未證實也未排除這點。因此,在決定採用哪一款之前,這類情境值得自行測試。
本比較整理自公開基準數據(Artificial Analysis、BenchLM、nxcode 與 apiyi),並非第一手 API 實測。Gemini 3.1 Pro上市時的定位是著重推理,與 Flash 主打速度的方向不同。截至本文撰寫時,Gemini 3.5 Pro 尚未推出;報導指出預計在 2026 年 7 月發布。因此,這篇內容應視為當前快照;等到下一版 Pro 上市後,兩款模型與這份比較都需要重新檢視。