 AIREITER
「Sonnet 5 接近 Opus 4.8,但更便宜」是 Anthropic 自己的主打說法。我們想知道這個說法在什麼情況下開始不成立,因此我們透過 Claude Code CLI 將四個相同的任務分別送到這兩個模型中,並從每次 API 回應中記錄實際成本、耗時,以及工具呼叫次數。最關鍵的一項是:把 Sonnet 5 的 xhigh effort 提升到與 Opus 4.8 預設行為相當的程度,而我們測得的價格差距幾乎消失了——同時 Opus 4.8 以大約一半的時間完成。
Sonnet 5 與 Opus 4.8 一覽
Claude Sonnet 5 | Claude Opus 4.8 | |
|---|---|---|
發佈 | 2026年6月30日 | |
上下文視窗 | 1M tokens | 1M tokens |
最大輸出 | 128K tokens | 128K tokens |
價格(每 1M tokens 輸入/輸出) | $5/$25 | |
快速模式 | 不支援 | 支援(研究預覽),在高級定價下最高可達約 2.5x 輸出速度 |
努力等級 | low / medium / high / xhigh / max | low / medium / high / xhigh / max |
定位 | 更便宜、以代理式功能為重點的 Sonnet 級模型 | Anthropic 的旗艦、最高準確度選項 |
Context window 和 max output 是相同的——在這裡不是差異點。不同的一點是:Sonnet 5 採用新的 tokenizer,Anthropic 表示,對於相同的文字,它會產生「大約多 30% 的 tokens」,因此從 Sonnet 4.6 沿用過來的 max_tokens 預算或成本估算,無法直接套用。
官方基準比較
根據 Anthropic 自身的揭露,並結合由 llm-stats.com 所做的第三方分析,這個模式是一致的:Sonnet 5 在少數幾項基準測試中勝出或打成平手,而 Opus 4.8 在其他大多數項目中領先,通常只以個位數幅度勝出。
基準 | Sonnet 5 | Opus 4.8 | 差距 |
|---|---|---|---|
Terminal-Bench 2.1 | 80.4% | 74.6% | Sonnet 5 +5.8 |
Humanity's Last Exam(含工具) | 57.4% | 57.9% | 幾乎持平 |
Humanity's Last Exam(不含工具) | 43.2% | 49.8% | Opus +6.6 |
SWE-bench Verified | 85.2% | 88.6% | Opus +3.4 |
SWE-bench Pro | 63.2% | 69.2% | Opus +6.0 |
Toolathlon | 54.3% | 59.9% | Opus +5.6 |
OSWorld-Verified(電腦使用) | 81.2% | 83.4% | Opus +2.2 |
CursorBench | 61.2% | 63.8% | Opus +2.6 |
USAMO 2026 problems | 79.5% | 96.7% | Opus +17.2 |
有兩點特別突出。Opus 4.8 的最大領先是在高難度數學(USAMO),而不是程式設計——程式設計上的差距(SWE-bench、Terminal-Bench)都只有個位數,甚至 Sonnet 5 在其中一項還是直接勝出。在加入工具的通用推理(HLE with tools)方面,兩者的表現也相當接近,可說是不分上下。
還有一個值得注意的安全數字,雖然它不是能力基準:根據同樣的披露,在沒有額外防護的瀏覽器使用情境中,Sonnet 5 量測到的提示注入攻擊成功率為 0.93%,而 Opus 4.8 為 31.5%。Anthropic 尚未針對這一特定落差公布詳細說明。如果你正在打造任何具代理性、會在未監督情況下瀏覽開放網路的系統,與其假設旗艦模型自動就是更安全的預設,不如先測試你自己的防護機制。
我們親自進行了四項正面對決測試
目前市面上大多數內容,要不是彙整了上方的官方基準表,就是分享主觀的單一模型印象。我們沒有找到受控、使用相同提示詞的成本與延遲比較,因此我們自行進行了測試。
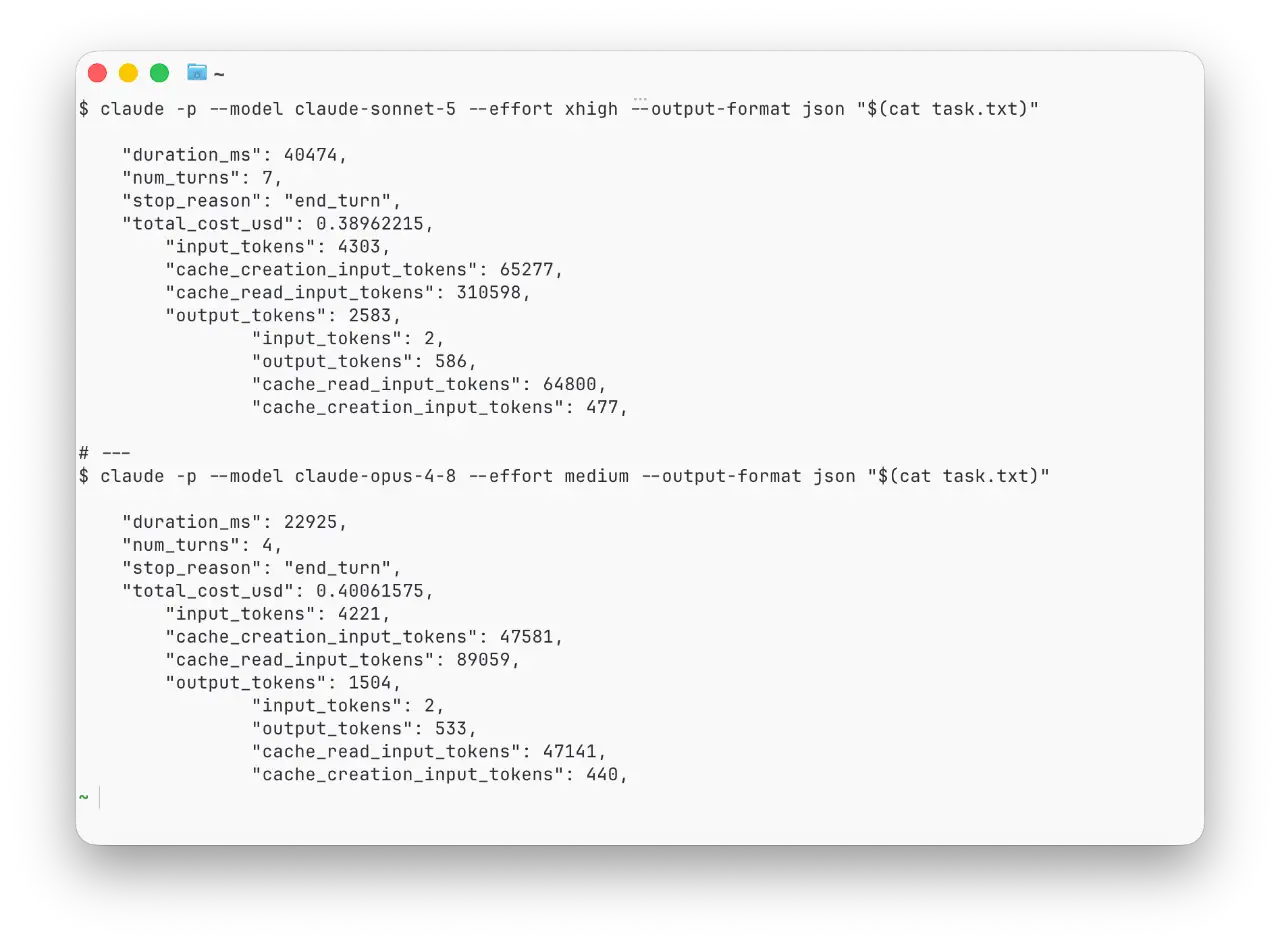
方法: 四項任務,於 2026-07-01 執行,每次都透過 Claude Code CLI 將相同提示詞傳送給 claude-sonnet-5 和 claude-opus-4-8(claude -p --model <id> --effort <level> --output-format json)。成本、持續時間與回合次數皆直接讀取自每次執行的 API 回應,而非根據 token 數量估算。每種模型/effort 組態在每項任務只執行一次——這是真實數字,來自單次執行,而非經統計平均的樣本。請將每個差距的大小視為方向性而非精確值;在我們進行的每一項測試中,方向都一致。
測試 1:成本反轉檢查
我們最想回答的問題是:當你把 Sonnet 5 的 effort level 提高,以補償更困難的任務時,它是否仍然更便宜?我們將與 Test 2 相同的編碼任務(如下)在 Sonnet 5 xhigh 與 Opus 4.8 medium 上進行測試。
設定 | 成本 | 持續時間 | 回合數 | 結果 |
|---|---|---|---|---|
Sonnet 5, effort | $0.390 | 40.5s | 7 | 8/8 tests pass |
Opus 4.8, effort | $0.401 | 22.9s | 4 | 7/7 tests pass |
3% 的成本差異——基本上可視為打平——而 Opus 4.8 在其 較低 努力設定下,只用了 57% 的時間,對話輪次也幾乎只有一半。兩者都產出了正確、可運作的程式碼。這與人們已經在 Hacker News上指出的情況一致:那裡有一位留言者估計,Opus 4.8 在 medium reasoning 下大約花費 $0.45,而 Sonnet 5 在 xhigh/max 下對於可比工作大約花費 $0.52。
測試 2:在相同努力程度下的編碼任務
相同提示,兩個模型都使用 high effort:撰寫一個高效的 longest-palindromic-substring 函式,產生涵蓋邊界情況的測試案例,執行它們,修正任何失敗的部分。
設定 | 成本 | 持續時間 | 回合數 | 結果 |
|---|---|---|---|---|
Sonnet 5 (high) | $0.378 | 37.4s | 7 | 8/8 pass |
Opus 4.8 (high) | $0.439 | 28.9s | 5 | 8/8 pass |
兩者都採用了相同的以中心向外擴展方法,並且在第一次執行時就通過了所有測試。Opus 4.8 更快達成,且所需輪次更少,但費用約高出 16%。當品質相同時,這一項僅憑速度就由 Opus 勝出。
測試 3:寫作 / 知識工作
一個沒有單一正確答案的商業判斷提示:建議一家 12 人的 SaaS 公司,在其 Series A 融資即將於六週後完成前,是否應花 3-4 週時間遷移到第二個 AWS 區域以進行災難復原。
設定 | 成本 | 持續時間 | 輪次 |
|---|---|---|---|
Sonnet 5 (high) | $0.072 | 14.7s | 1 |
Opus 4.8 (high) | $0.084 | 22.7s | 1 |
兩者基本上給出了相同的建議——跳過完整遷移,改為推出一個輕量級的備份/操作手冊即可——而且推理品質相近。Sonnet 5 花了大約三分之二的時間,成本也低了 14%。這是唯一一個測試,能清楚看出「Sonnet 5 在知識型工作上表現依然不錯」這個結論。
測試 4:代理式查詢——Sonnet 5 真的會「過度思考」嗎?
有些 Reddit 討論串把 Sonnet 5 描述為比 Opus 4.8 更容易對簡單請求想太多。我們測試了一個真的很簡單的任務:加總目錄樹中每個 .py 檔案的位元組大小,並回報哪個子目錄擁有最多這類檔案。
設定 | 成本 | 持續時間 | 回合數 |
|---|---|---|---|
Sonnet 5 (high) | $0.119 | 18.5s | 3 |
Opus 4.8 (high) | $0.120 | 12.1s | 2 |
兩者都得出了相同且正確的答案。成本幾乎只差一點四捨五入的誤差,但 Sonnet 5 多花了一次工具呼叫回合,而且耗時約長 50%。這確實是對「想太多」抱怨的一個實際、雖然不算大的數據點——而且這也與測試 1 相符:Sonnet 5 往往需要更多步驟才能到達同一個結果。
那麼你究竟應該使用哪一個?
若要處理需講求速度的程式設計任務、涉及大量工具呼叫的 agentic workflows,或任何你原本會想把 Sonnet 5 的 effort 提高到
high以上才敢信任輸出的情況,請選擇 Opus 4.8——這正是 Sonnet 5 的成本優勢會消失的情境。若要處理高量、預算敏感的工作,以及一般知識/寫作任務,請選擇 Sonnet 5,但請將它維持在
medium或higheffort。不要因為「求個保險」就反射性地把它調到xhigh——價格優勢就是在這裡崩盤的。兩者皆可 用於簡單查詢與單輪請求;我們測得的實際差異只是多一輪對話和幾秒鐘,而不是答案錯誤。
常見問題
Claude Sonnet 5 實際上比 Opus 4.8 更便宜嗎?
在相同的努力等級下,是的——而且相當明顯。但若將 Sonnet 5 提高到 xhigh 來因應更困難的任務,差距可能會縮小到幾個百分點,而在較低努力設定下的 Opus 4.8 則完成得更快。在假設自己正在省錢之前,先確認你實際運行的努力等級。若要查看涵蓋 Haiku、Sonnet 和 Opus 的完整價格清單,請參閱我們的 Claude API 定價指南。
Claude Sonnet 5 與 Sonnet 4.6 怎麼選?
這是世代升級,不是模型層級的選擇——而且成本也不會朝同一個方向變動。Sonnet 5 在 Terminal-Bench 上比 Sonnet 4.6 高出兩位數,但在我們自己的正面成本測試中,Sonnet 5 在我們嘗試的每個努力等級下都比 Sonnet 4.6 更昂貴,主要是因為新的 tokenizer。完整測試與數據請見 Sonnet 5 vs Sonnet 4.6: Is It Actually Cheaper?
Claude Sonnet 5 與 Opus 4.6 的比較公平嗎?
其實不是——Opus 4.6 比 Opus 4.8 落後一個世代。如果你正在決定今天要用哪個,應該拿它和 Opus 4.8 比較,而不是和它的前一代。
這兩者的上下文視窗有不同嗎?
不——兩者都提供 1M-token 的上下文視窗和 128K 的最大輸出。
為什麼 Opus 4.8 在瀏覽器使用中的提示注入率高得多?
根據 Anthropic 的揭露,在未增加額外防護的情況下為 31.5%,相較之下 Sonnet 5 為 0.93%,特別是在無人監督的 browser-use 情境中。Anthropic 尚未公布詳細說明。請將此視為一個理由,去測試你自己的特定防護措施,而不是假設旗艦模型自動就是更安全的預設選項。
附錄:精確提示詞與原始輸出
對於任何想要重現這一點的人,以下是我們在每次測試中發送的完整提示詞(Test 1 和 Test 2 使用了相同的編碼提示詞,只是努力程度不同)。
測試 1 & 2 — 程式撰寫提示:
撰寫一個 Python 函式 `longest_palindromic_substring(s: str) -> str`,它會回傳
s 中最長的回文子字串,並使用比
暴力法 O(n^3) 更有效率的方法(例如以中心擴展或 Manacher 演算法)。將其
儲存到 solution.py。

然後撰寫 test_solution.py,至少包含 6 個測試案例,涵蓋:空字串、
單一字元、全部相同字元、沒有長度超過 1 的回文、偶數長度回文,以及奇數長度回文。

使用 pytest 執行測試,並確保它們全部通過。如果有任何失敗,請修正
程式碼並重新執行,直到全部通過。回報最終的 pytest 輸出。
測試 3 — 寫作/知識工作提示:
你正在為一家小型 SaaS 公司提供建議(12 名員工、$80k MRR,目前僅部署在單一 AWS region),評估是否要在他們的 Series A 募資前擴展到第二個 AWS region 以進行 disaster recovery;募資將在 6 週後完成。

Engineering 估計這次遷移需要 3-4 週,且在這段期間會耗用團隊大部分產能,並延遲兩個客戶要求的功能。

請寫一篇約 350 字的高階建議:他們應該現在就做、延後做,還是找一條折衷路徑?請以取捨為基礎加以說明。不要前言,直接給出建議。
測試 4 — agentic 查詢提示詞:
在目前的目錄樹中,找出所有副檔名為 .py 的檔案,將它們的
總大小(以位元組為單位)加總,並告訴我哪一個單一子目錄(工作目錄的直接子項)按數量包含最多 .py 檔案。只要這兩個
數字/答案,不需要寫入任何新檔案。
以下是 Test 1 中 Sonnet 5 (xhigh) 執行的實際 API 回應,已裁剪為與成本和時間相關的欄位:
{
  "duration_ms": 40474,
  "num_turns": 7,
  "stop_reason": "end_turn",
  "total_cost_usd": 0.38962215,
  "usage": {
    "input_tokens": 4303,
    "cache_creation_input_tokens": 65277,
    "cache_read_input_tokens": 310598,
    "output_tokens": 2583
  }
}
那是 Claude Code CLI 對該次執行回傳的未編輯 total_cost_usd、 duration_ms 和 token 計數——上方 Test 1 表格中的數字就是直接來自這類欄位,每次執行對應一個 JSON 回應。