 AIREITER
一個 27B 模型塞進手機裡,聽起來像是行銷話術;但 PrismML 的 Bonsai 27B 確實做到了。這款以 Qwen3.6 27B 為基礎的三元量化模型,最小的 1-bit 版本僅 3.9GB,可在 iPhone 17 Pro 上以約每秒 11 個 token 的速度運行。模型權重採 Apache 2.0 授權免費提供,而三元版本仍保有超過原始 FP16 模型 95% 的基準測試表現。不過,這個成績並非各項能力平均維持:數學與程式撰寫接近原版,工具呼叫與視覺能力則明顯下滑。若你想在裝置端處理推理或寫程式,Bonsai 27B 很有吸引力;若工作仰賴 Agent、多步工具操作,它目前就不是最穩妥的選擇。
27B 模型為何能縮到手機裝得下?
一般 FP16 格式的 27B 模型約需 54GB 記憶體,遠超過手機可提供的容量。Bonsai 27B 能壓到 6GB 以下,關鍵在於以極小的離散數值取代完整精度的權重。
三元版本將每個權重限制為 -1、0、+1 三種值,理論上每個權重只承載約 1.58 bit 的資訊。PrismML 再加入 FP16 分組縮放:每一組權重保存一個全精度縮放係數,讓被壓縮後的數值仍能落在合適的量級。計入這些係數後,實際成本約為每個權重 1.71 effective bits。更激進的 1-bit 二元版本則移除 0,只保留 -1 與 +1,降至約 1.125 effective bits。
有兩件事尤其值得注意。第一,這是端到端量化:embedding、attention、MLP 區塊與 language-model head 全數量化,沒有留下任何全精度元件作為支撐。第二,Bonsai 的基底是 Qwen3.6 27B,一個擁有 278 億參數、採混合 attention 的因果模型,因此也繼承了 262K token 上下文視窗與多模態輸入能力。
三元版或 1-bit 版:該下載哪一個?
PrismML 提供兩種版本,選錯了不是白白多佔記憶體,就是犧牲不必要的品質。取捨很直接:檔案越小,準確度越低。
| 版本 | 每權重 effective bits | 大小 | 保留品質 | 適合用途 |
|---|---|---|---|---|
| 三元版 (-1, 0, +1) | ~1.71 | 5.9GB | >95% FP16 表現 | 桌機、重視輸出品質的工作 |
| 1-bit 二元版 (-1, +1) | ~1.125 | 3.9GB | >90% FP16 表現 | 手機、記憶體空間有限的環境 |
若要在手機上跑,只有 1-bit 版本能落在 iPhone 17 Pro 可用的記憶體餘裕內。筆電或桌機若有較充足的空間,三元版本只多出 2GB,卻能換回數個百分點的準確度;只要輸出品質比檔案體積重要,通常值得選它。
基準測試透露的真相:哪些能力掉得最多?
官方公布的成績來自三元版本;它在 15 項 thinking-mode 基準測試中的平均分數為 80.49。其中幾項突出成績如下:
| 基準測試 | 分數 | 衡量能力 |
|---|---|---|
| MATH-500 | 99.20 | 從學校到競賽等級的數學能力 |
| AIME 2025 | 90.84 | 高難度競賽數學 |
| HumanEval+ | 93.90 | 程式碼生成 |
| BFCL v3 | 74.41 | 函式/工具呼叫 |
把這些分數放在一起看,就能看出 Bonsai 27B 的能力輪廓。數學與程式能力都在 90 分以上,工具呼叫卻停在 70 分區間。這正是使用前最需要理解的一點:量化對推理與寫程式的保留程度,遠高於 Agent 工作流所需的結構化、多步驟行為。
上述數字都由 PrismML 自行公布,在獨立測試累積前,較適合當作參考起點,而非最終結論。與其只看 80.49 的平均值,更該留意各任務的細項成績,以及實際會遇到的失敗模式。早期測試者指出,三元版本偶爾會卡進推理迴圈;而極端量化對長上下文穩定性的傷害,也往往比單一任務分數所呈現的更明顯。正式依賴它之前,最好先用自己的提示詞快速測試。
實際推論速度與硬體表現
壓縮得再漂亮,如果推論速度不夠實用也沒有意義。所幸在足夠的硬體上,Bonsai 27B 的速度確實可用。以下是 PrismML 公布的數據:
| 裝置 | 1-bit | 三元版 |
|---|---|---|
| iPhone 17 Pro | 11 tok/s | — |
| Apple M5 Max | 87 tok/s | 58 tok/s |
| NVIDIA RTX 5090 | 163 tok/s | 134 tok/s |
手機上的每秒 11 個 token 適合聊天與短篇推理,談不上飛快,但已足以使用。M5 Max 上的每秒 87 個 token 則很快;若把網路往返時間也算進去,本機推論在短提示詞情境下可能比呼叫雲端 API 更快。PrismML 也以 intelligence density,也就是每 GB 可換得的基準分數,來描述這項成果:Bonsai 約為 0.53,約是全精度基準模型的十倍。
目前可用的四種 Bonsai 27B 運行方式
權重開放意味著它沒有唯一的「安裝方式」。以下四條路徑都能使用,從完全免設定到自行掌控完整環境都有。
直接在 iPhone 上跑
Locally AI iOS app 可直接在裝置端執行 1-bit、3.9GB 的版本,不需要帳號或伺服器。這是最符合「27B 跑在手機上」承諾的方案;權重下載完成後,即使離線也能完整運作。
在瀏覽器裡試用
PrismML 發布了可在瀏覽器分頁內運行 1-bit 模型的 WebGPU kernels,完全不必安裝。這是決定是否要佔用磁碟空間前,最快體驗 Bonsai 27B 的方法;前提是你的電腦配有支援 WebGPU 的 GPU。
部署到自己的電腦
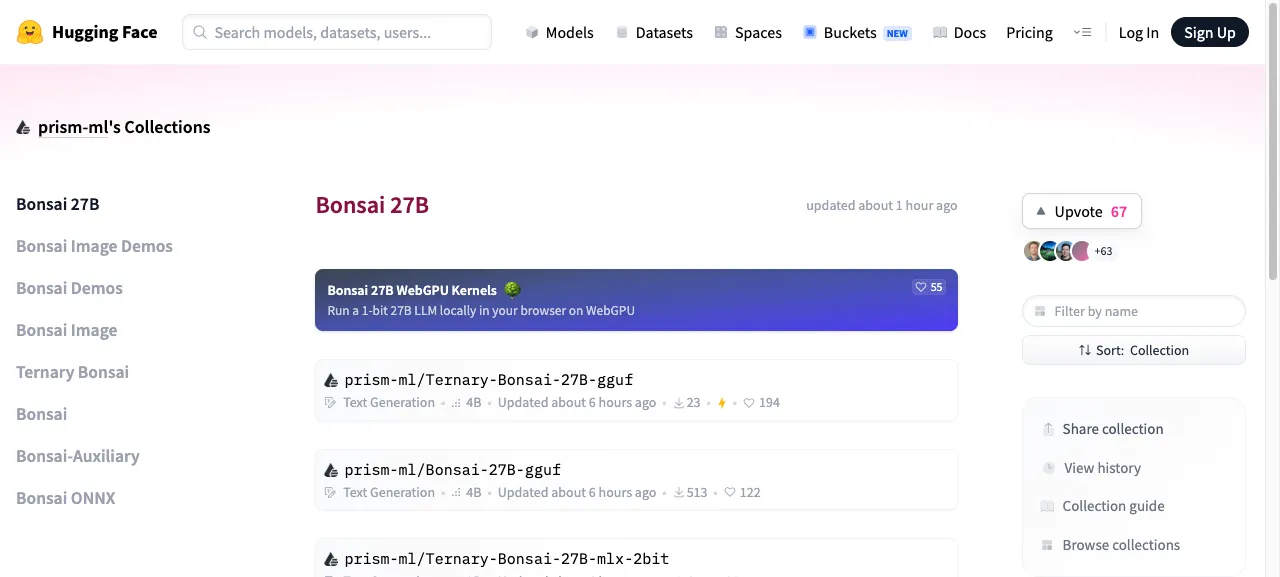
GGUF、MLX 與 ONNX 權重均可在 Hugging Face 和 GitHub 取得,並採 Apache 2.0 授權。主要儲存庫為 prism-ml/Bonsai-27B-gguf(1-bit)與 prism-ml/Ternary-Bonsai-27B-gguf(三元版),另有 MLX 2-bit 與 ONNX 版本。1-bit 版本的可用儲存空間與 RAM 約需預留 4GB,三元版則約需 6GB。不過工具鏈的成熟度仍落後於模型發布速度:權重雖能在多個 runtime 載入,熱門本機應用程式如 LM Studio 在發布時尚未提供完整支援,因此可能需要一些手動設定。
透過託管 API 使用
若不想自行管理權重,Together.ai 提供三元版本的標準 API,支援完整 262K 上下文視窗、視覺輸入與 JSON mode。發布促銷期間,輸入價格標示為每百萬 token $0.00;由於促銷價格可能變動,規劃預算前仍應確認目前費率。
Bonsai 27B 與 Gemma 4 12B QAT 怎麼選?
最常被拿來比較的是 Gemma 4 12B QAT。這款 Google 的量化感知訓練模型容量約 7GB,只比 Bonsai 的三元版本大一些。
兩者各自在不同面向占優勢。受惠於 27B 基礎模型,Bonsai 27B 在數學與程式基準測試上明顯領先 Gemma。Gemma 在視覺與工具呼叫方面通常更穩定,權重稍大、量化強度較低,也使它成為手機上的較可靠通用選擇。如果你的裝置端工作以推理和程式碼為主,Bonsai 更值得選;若大量處理圖片或函式呼叫,Gemma 4 12B QAT 會是更安全的選項。
哪些人真的適合用 Bonsai 27B?
如果你需要離線、私密的裝置端推理或程式協助,並持有 iPhone 17 Pro 等級裝置或性能足夠的筆電,Bonsai 27B 值得一試。對極端量化有興趣的人,也會發現它很有研究價值:27B 模型能在瀏覽器分頁中運行,本身就是重要里程碑;開放的 Apache 2.0 授權也讓實驗門檻更低。當你想要本機選項時,它也很適合與其他值得用於程式開發的開放免費模型並列考慮。
但目前不建議把它用在依賴可靠工具呼叫的正式 Agent 系統、對視覺結果要求嚴格的任務,或推理迴圈失敗會造成高成本的任何場景。這類需求仍應優先選擇壓縮程度較低的模型,或透過 API 使用全精度模型。
常見問題
Bonsai 27B 可以免費使用嗎?
模型權重採 Apache 2.0 授權免費提供,因此可免費下載與運行。透過 Together.ai 託管使用則適用其 API 計價;發布期間曾列為每百萬輸入 token $0.00,請確認目前價格。
Bonsai 27B 真的能在手機上跑嗎?
可以。1-bit 版本只有 3.9GB,透過 Locally AI app 可在 iPhone 17 Pro 上以約每秒 11 個 token 運行;下載完成後可完全離線使用。
Bonsai 27B 的能力和完整 Qwen3.6 27B 一樣嗎?
很接近,但不完全相同。三元版本保留超過全精度模型 95% 的基準效能,1-bit 版本則超過 90%。其中數學與程式能力的保留最完整,工具呼叫的落差最大。
該下載哪一個 Bonsai 27B 檔案?
手機或記憶體吃緊的裝置,請選 1-bit 版本(prism-ml/Bonsai-27B-gguf,約 3.9GB)。若使用有充足空間的桌機或 GPU,則選三元版本(prism-ml/Ternary-Bonsai-27B-gguf,約 5.9GB),以換取額外幾個百分點的準確度。Apple Silicon 與跨平台 runtime 另有 MLX 2-bit、ONNX 版本可用。
什麼是三元量化?
三元量化會將每個模型權重儲存為三種數值之一,也就是 -1、0 或 +1,而非完整精度數字,因此能大幅縮小模型。FP16 縮放係數則用來讓壓縮後的權重大致維持正確量級。
Bonsai 27B 支援圖片嗎?
支援。它繼承 Qwen3.6 27B 的多模態能力,可接受圖片與文字輸入,並輸出文字。不過在這種壓縮程度下,視覺能力的保留不如數學與程式能力。