 AIREITER
公開排行榜對 Veo 3.1 的提示詞遵循度評價落差很大:有一份給了 7.8 分,另一份則是 9.2 分,卻都沒有公開實際使用的提示詞。我們因此在 2026-07-30 設計兩組各含十個可逐項核對元素的提示詞,交給六款模型生成。結果顯示,模型之間的差距沒有排行榜看起來那麼大;真正拉開差距的,是你下的是哪一類指令,而非模型品牌。
哪款 AI 影片模型最能照提示詞執行?
本次測試中,Seedance 2.0 Fast 遵循的指令最多:20 項可檢查元素中命中 19 項,難度較高的提示詞更拿下乾淨的 10/10。Kling 3 Turbo 與 Veo 3.1 同為 18 分,Wan 2.7 得 17.5 分,Grok Imagine 為 16 分;Hailuo 02 Pro 因略過整段事件順序,以 15.5 分墊底。針對較難提示詞再跑三次後,這個排序依然不變。Sora 2 則完全無法完成測試。
| 模型 | 直述提示詞 | 壓力測試提示詞 | 總分 /20 | 每支影片成本 | 每秒成本 | 等待時間 |
|---|---|---|---|---|---|---|
| Seedance 2.0 Fast | 9.0 | 10.0 | 19.0 | $0.83 | $0.165 | 121–132 秒 |
| Kling 3 Turbo | 9.5 | 8.5 | 18.0 | $0.45 | $0.090 | 45–54 秒 |
| Veo 3.1 | 9.0 | 9.0 | 18.0 | $1.25 | $0.156 | 88–95 秒 |
| Wan 2.7 | 9.0 | 8.5 | 17.5 | $0.40 | $0.080 | 103–104 秒 |
| Grok Imagine | 8.0 | 8.0 | 16.0 | $0.09 | $0.015 | 43–49 秒 |
| Hailuo 02 Pro | 9.0 | 6.5 | 15.5 | $0.29 | $0.049 | 166–185 秒 |
| Sora 2 | — | — | — | — | — | 5 次提交失敗 |
價格取自公開的點數費率:Kling、Seedance、Wan、Hailuo 與 Grok 參考 Kie 的價格表;Veo 3.1 與 Sora 2 則參考 AIReiter 模型頁面。表中的每秒成本,是以各模型實際回傳的影片長度換算,而不是依照送出的設定值。
該怎麼選,取決於你的鏡頭需求:
- 提示詞含有數量、順序或「絕對不動」 → 選 Seedance 2.0 Fast。它是唯一把這十項元素全數做對的模型,較高價格買到的正是這份可靠性。
- 反覆調整視覺風格,而非事件順序 → 選 Kling 3 Turbo。遵循度幾乎相同,價格約一半,等待時間也只有三分之一。
- 只想確認提示詞是否能被讀懂 → 選 Grok Imagine,每秒只要 $0.015。它的 16/20 主要是少了一次入鏡動作。
- 有順序的連續動作 → 不要選 Hailuo 02 Pro,它直接跳過了一整個事件。
Sora 2 在 2026-07-30 的 03:57 至 03:59 UTC 間,針對兩組提示詞與三次間隔重試的五次提交,全部回傳 UPSTREAM_BUSY / Upstream service is busy or upgrading。沒有扣款、沒有影片,也沒有分數。
測試方法:兩組提示詞,20 個可逐項驗證的元素
兩組提示詞中的每個子句,都對應到畫面裡可明確確認的內容。我們沒有使用「電影感」、「8K」或「有氛圍」這類無法計分的字眼。每組十項元素,分別標示為 ✓(1 分)、~(部分符合,0.5 分)或 ✗(0 分)。這不是畫質或時間一致性評測:一支影片可以很漂亮、很穩定,卻悄悄漏掉一半指令。Grok Imagine 的輸出更像 3D 渲染,而不是實拍影像,但這不會讓它被扣分。
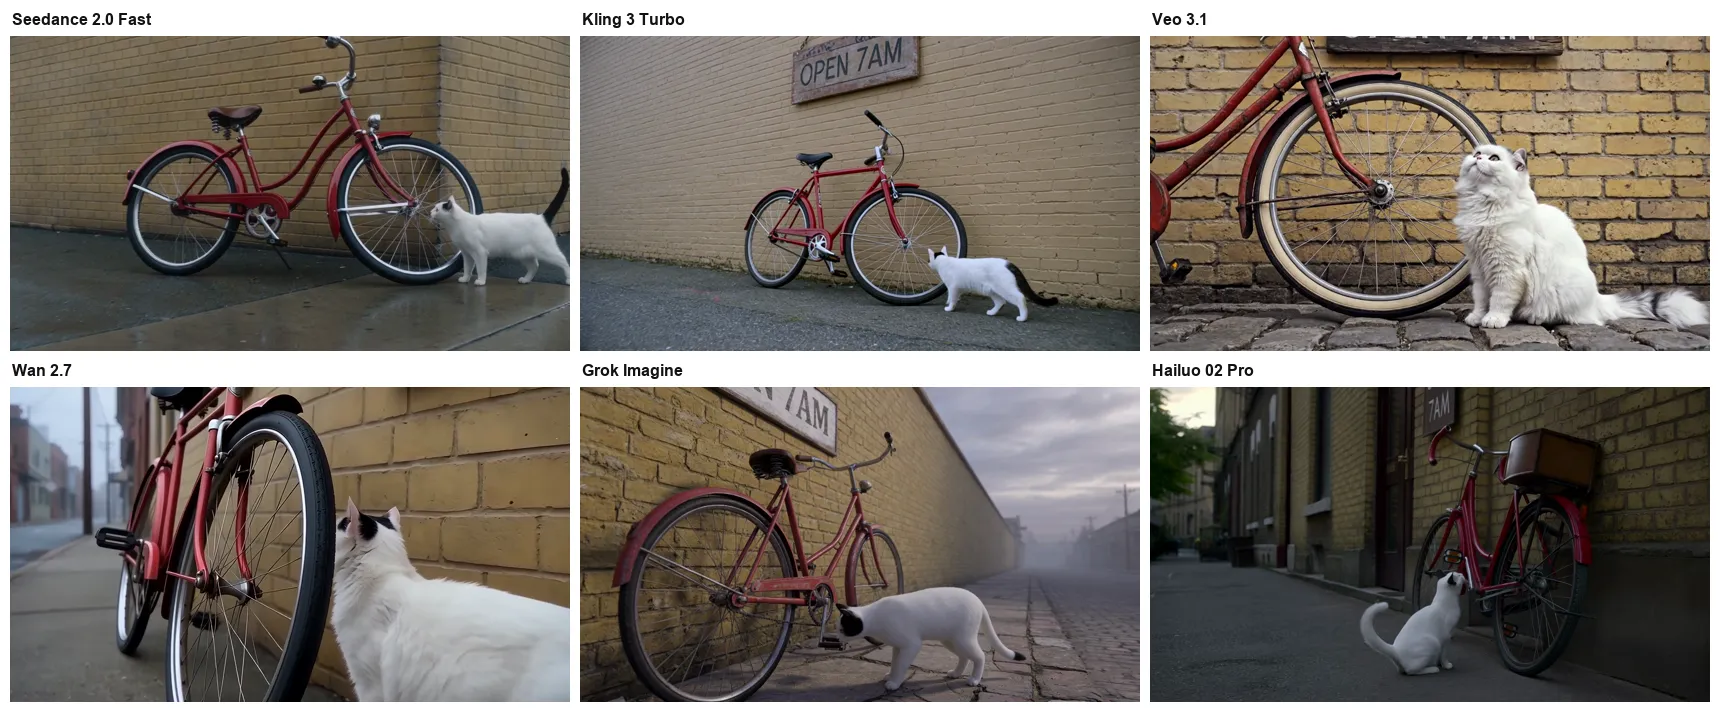
直述提示詞測試模型能否組合出指定場景,十項元素就是提示詞明確點出的十件事:一輛紅色復古自行車、靠在黃色磚牆上、一隻只有一隻黑耳朵的白貓、從畫面右側進入、停在前輪旁並抬頭看、招牌文字為 OPEN 7AM、鏡頭由廣角推至中景、攝影機維持地面高度、陰天光線且沒有太陽、畫面中沒有任何人。
A single red vintage bicycle leans against a yellow brick wall on an empty
street at dawn. A white cat with one black ear walks in from the right side of
the frame, stops beside the front wheel, and looks up. A wooden sign above the
bicycle reads "OPEN 7AM". The camera dollies in slowly from a wide shot to a
medium shot, staying at ground level. Overcast morning light, no sun, no people
anywhere in the shot.
壓力測試提示詞則針對數量、事件順序與否定指令。十項元素包括:剛好三隻鴨子、三隻大小全程一致、排成一列坐在木桌上、沒有手或人物、中間的鴨子先倒下、左邊的鴨子之後倒下、右邊鴨子完全不動、固定機位、純白背景,以及從正上方打下的硬光。
Three identical yellow rubber ducks sit in a row on a wooden table. No hands and
no people appear at any point. First the middle duck tips over onto its side;
about two seconds later the duck on the left tips over. The duck on the right
never moves. The camera is locked off: no zoom, no pan, no push in. Plain white
background, hard light from directly above.
模型看到提示詞前,可能已經被改寫
其中兩款模型預設啟用提示詞改寫器:Wan 2.7 的 prompt_extend,以及 Hailuo 02 Pro 的 prompt_optimizer。官方文件都標示其預設值為 true。若直接提交提示詞而不調整這些設定,最後被評分的並不是你親手寫下的文字。本次測試一律設為 false;維持預設開啟時,測到的不只是模型,還包括改寫器的表現。
還有些參數根本不會照設定執行。所有影片原本都要求 5 秒、720p、16:9,但三款模型自行覆寫了設定。因此上方的每秒價格是依照實際回傳結果計算,不是依送出參數計算:
| 模型 | 送出設定 | 實際回傳 | 扣除點數 |
|---|---|---|---|
| Seedance 2.0 Fast | 5 秒、720p、16:9 | 5.0 秒、1280×720 | 165(33/秒) |
| Kling 3 Turbo | 5 秒、720p、16:9 | 5.0 秒、1280×720 | 90(18/秒) |
| Veo 3.1 | 5 秒、16:9 | 8.0 秒、1280×720 | 每次呼叫 125 |
| Wan 2.7 | 5 秒、720p、16:9 | 5.0 秒、1280×720 | 80(16/秒) |
| Grok Imagine | 6 秒(下限)、720p、16:9 | 6.0 秒、1280×720 | 18(3/秒) |
| Hailuo 02 Pro | 5 秒、720p、16:9 | 5.9 秒、1920×1080 | 57 |
Hailuo 02 Pro 文件列出的輸入項目只有提示詞與兩個開關,因此沒有其他參數可設定;兩次測試都回傳 1080p。Veo 3.1 不論送出什麼設定都回傳 8 秒,而 Grok Imagine 文件則載明最短為 6 秒。
六款模型都做對了什麼?
粗略的構圖並不是這六支影片的失分點。所有模型都生成了一輛紅色復古自行車靠著黃色磚牆,也都正確呈現畫面文字「OPEN 7AM」,沒有一個字出錯。六款模型同樣遵守了兩項否定指令:六支街景影片裡都沒有人,而六支鴨子影片中的固定鏡頭也都沒有移動。
模型容易失手的四類指令
數量與屬性細節
「一隻只有一隻黑耳朵的白貓」在六次結果中只被完整遵守一次。Hailuo 02 Pro 生成了唯一一隻全身白色、僅有單側黑耳朵的貓。Kling 3 Turbo 與 Veo 3.1 做出了黑耳朵,卻額外加上黑尾巴;Wan 2.7 讓兩隻耳朵都帶有黑色斑塊;Grok Imagine 畫成完整的暹羅貓面罩;Seedance 2.0 Fast 則幾乎全白,只在一側耳尖留下淡淡深色污漬。
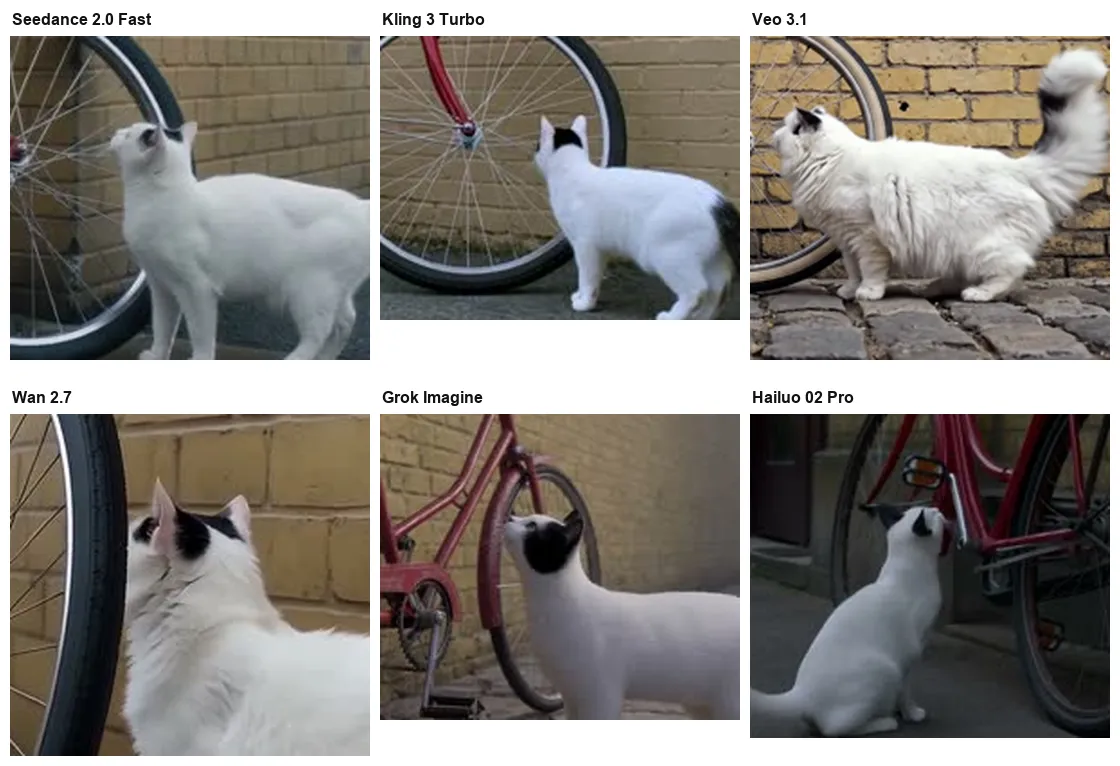
每一款模型都理解「白貓帶有黑色標記」,但除了 Hailuo 之外,沒有模型把「一隻」當成精確數量。在這六個輸出裡,屬性數量的可靠度明顯低於粗略構圖。
事件順序與時間點
鴨子提示詞要求明確的事件順序:中間先倒、左邊再倒、右邊永遠不動。四款模型正確完成:Kling 3 Turbo 在 2.0 秒與 4.9 秒倒下;Seedance 2.0 Fast 在 2.0 秒與 3.5 秒;Wan 2.7 在 1.0 秒與 4.0 秒;Veo 3.1 在 1.6 秒與 4.8 秒。沒有任何一款精準達成指定的兩秒間隔,但六支影片中的右側鴨子都沒有移動。
Hailuo 02 Pro 則完全沒有完成。中間那隻鴨子從未倒下,反而是左側鴨子轉成側面,並膨脹到接近原本的兩倍大,而三隻鴨子全程站立。
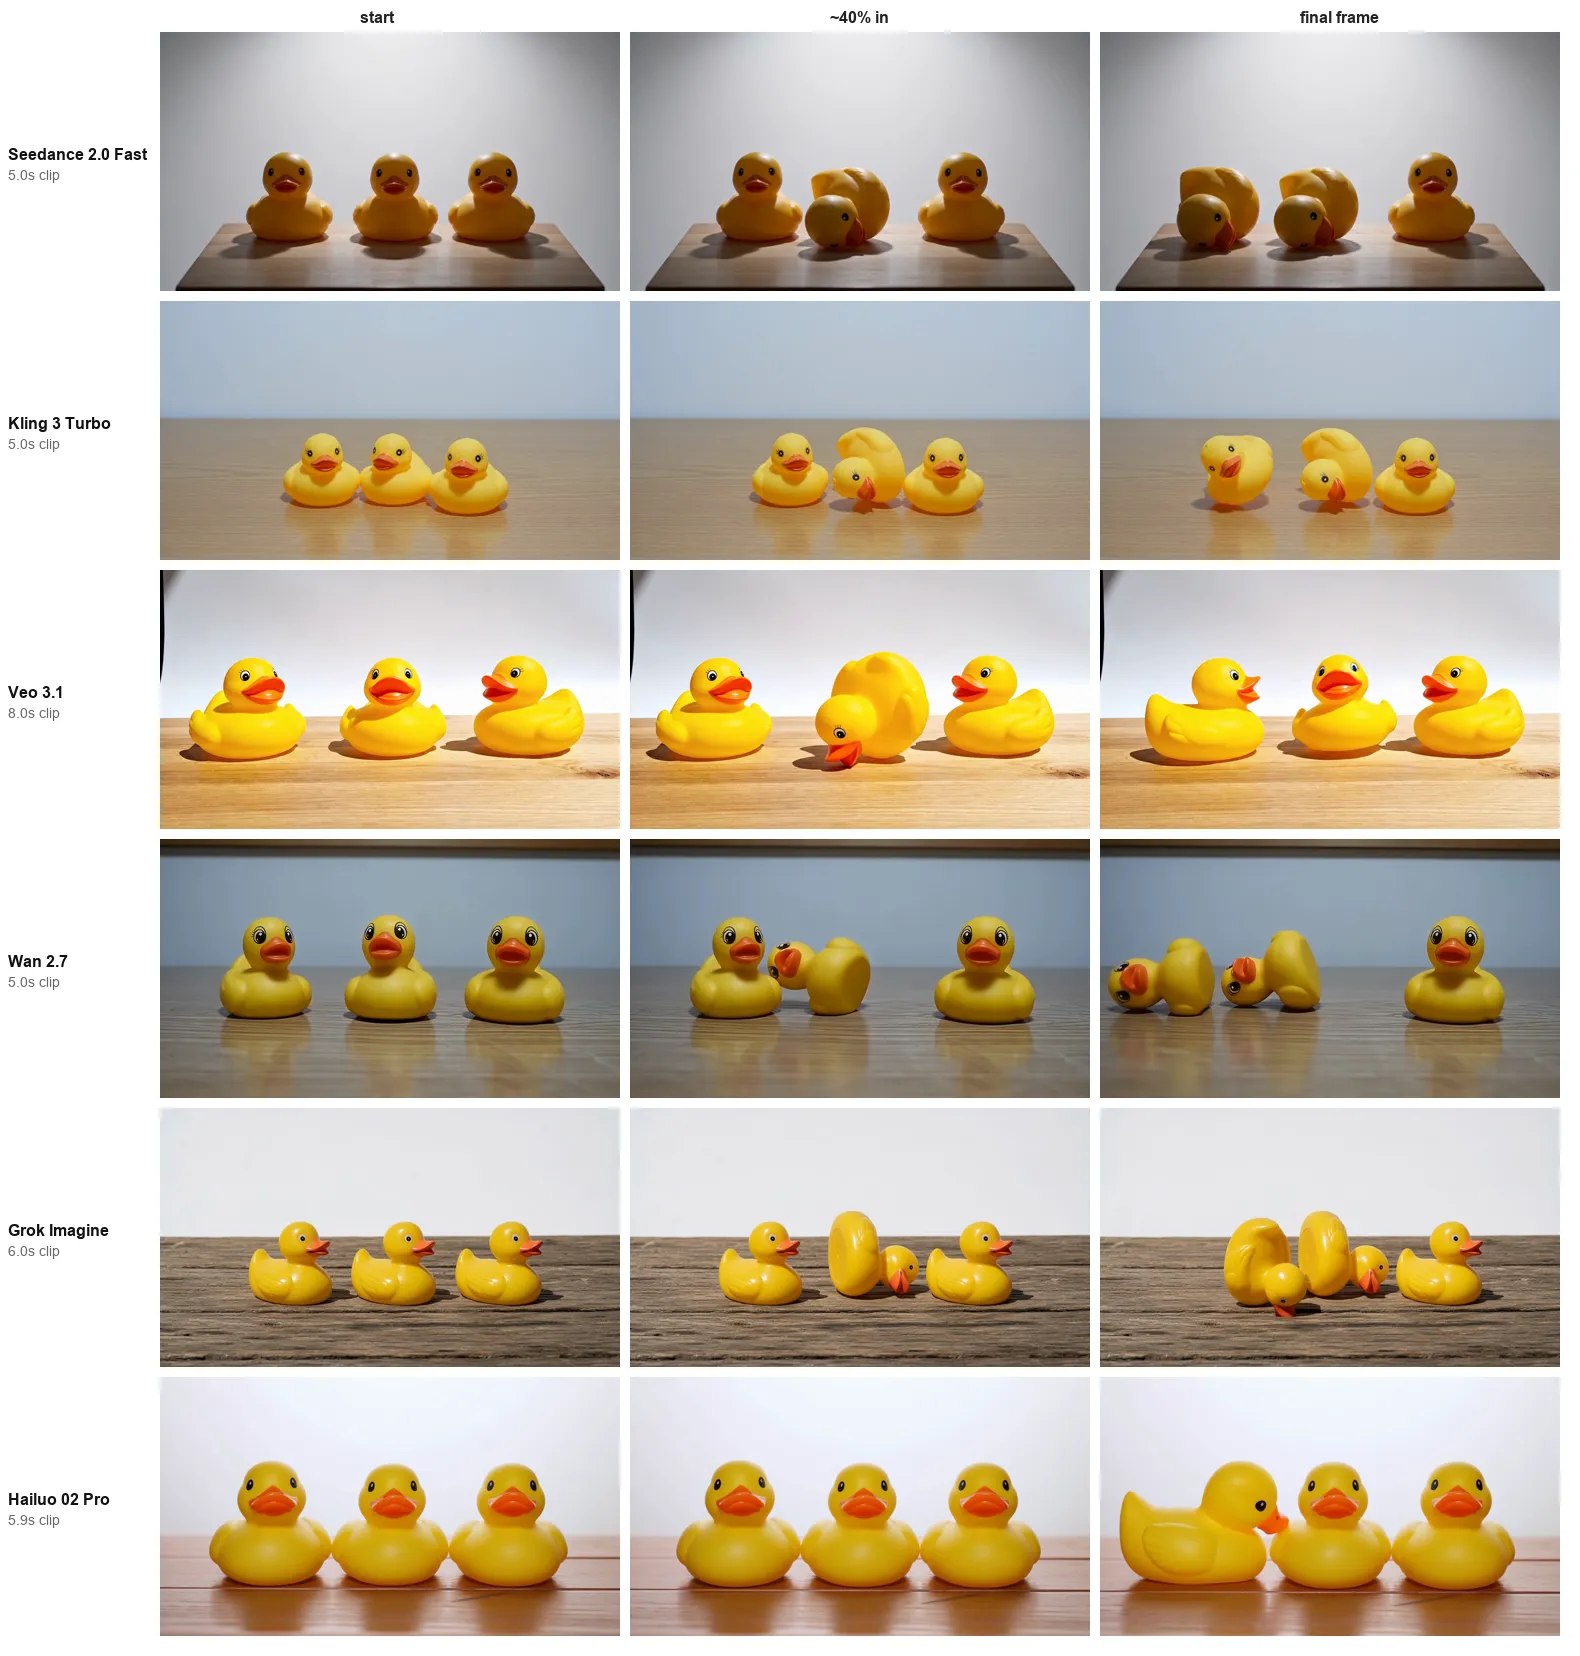
Grok Imagine 讓鴨子依正確順序倒下,卻是向前倒在喙上,而非側倒。Veo 3.1 的順序正確,但兩隻倒下的鴨子在最終畫格前又自行站起來了——事件發生了,狀態卻沒有維持。
鏡頭指令的紀律
固定機位獲得所有模型一致遵守,但明確指定的運鏡則不是如此。Wan 2.7 與 Veo 3.1 都從要求的廣角推至中景開始,接著卻持續推到極近特寫;Wan 最後只剩裸露的輪圈,貓甚至完全離開畫面。Grok Imagine 的移動幅度小到幾乎看不出推鏡。Hailuo 02 Pro 是唯一違反「維持地面高度」的模型,鏡頭大約位於臀部高度,其餘五款則都保持低機位。
物件一致性
物件在移動時會改變大小。Hailuo 的左側鴨子長到接近起始尺寸的兩倍,Grok Imagine 兩隻倒下的鴨子都明顯變大,Kling 3 Turbo 與 Veo 3.1 的倒下鴨子也略有增大。只有 Seedance 2.0 Fast 與 Wan 2.7 從第一格到最後一格,都讓三隻鴨子維持相同大小。
尺寸一致性通常沒人特別下指令,也往往沒人察覺它出了問題。
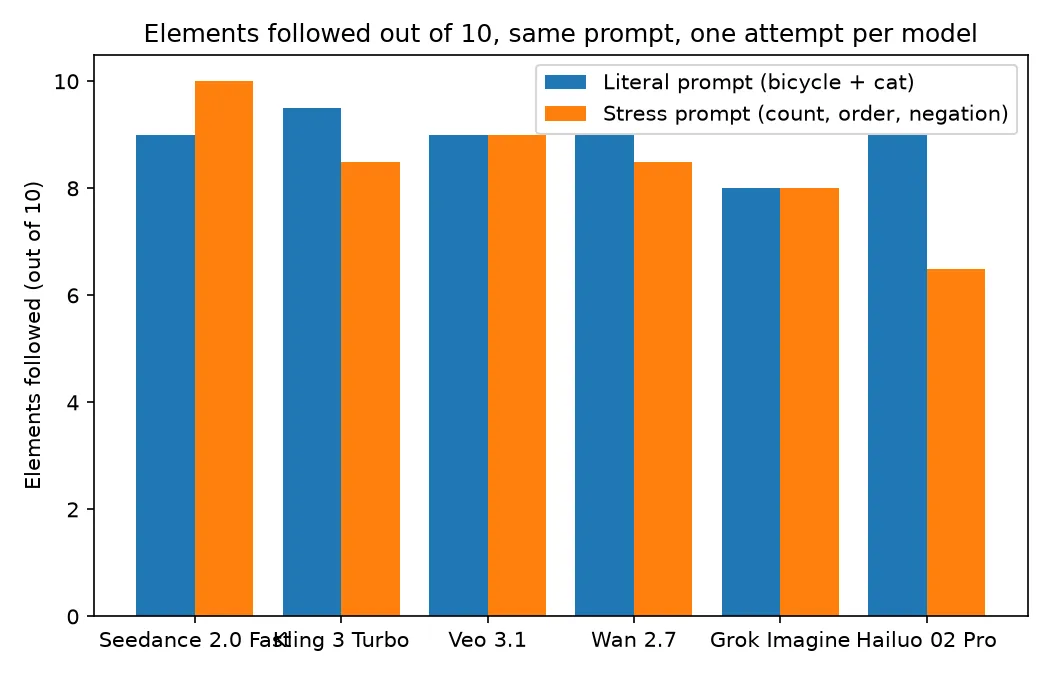
六款模型中有五款在靜態場景測試集中於 8.0–9.5 分,直到面對數量與順序事件才拉開差距,Hailuo 在此少了 2.5 分。簡單鏡頭下,選哪款模型差異不大;提示詞一出現數字,模型選擇就變得很重要。
重新跑一次,排名還站得住嗎?
對於我們重新測試的三款模型來說,答案是肯定的。每款都針對壓力測試提示詞再嘗試兩次,並使用相同標準評分,分數區間沒有重疊。
| 模型 | 第 1 次 | 第 2 次 | 第 3 次 | 中位數 | 區間 |
|---|---|---|---|---|---|
| Seedance 2.0 Fast | 10.0 | 9.5 | 10.0 | 10.0 | 9.5–10.0 |
| Kling 3 Turbo | 8.5 | 8.0 | 8.0 | 8.0 | 8.0–8.5 |
| Hailuo 02 Pro | 6.5 | 6.5 | — | 6.5 | n=2 |
Kling 3 Turbo 三次都把要求的純白背景畫成藍灰色牆面,這是穩定偏好,而非抽樣雜訊。Hailuo 02 Pro 兩次都重現完全相同的失敗:中間鴨子不倒,左側鴨子膨脹至接近兩倍。Hailuo 第三次測試受到每日點數上限阻擋,因此其中位數僅基於兩個樣本。
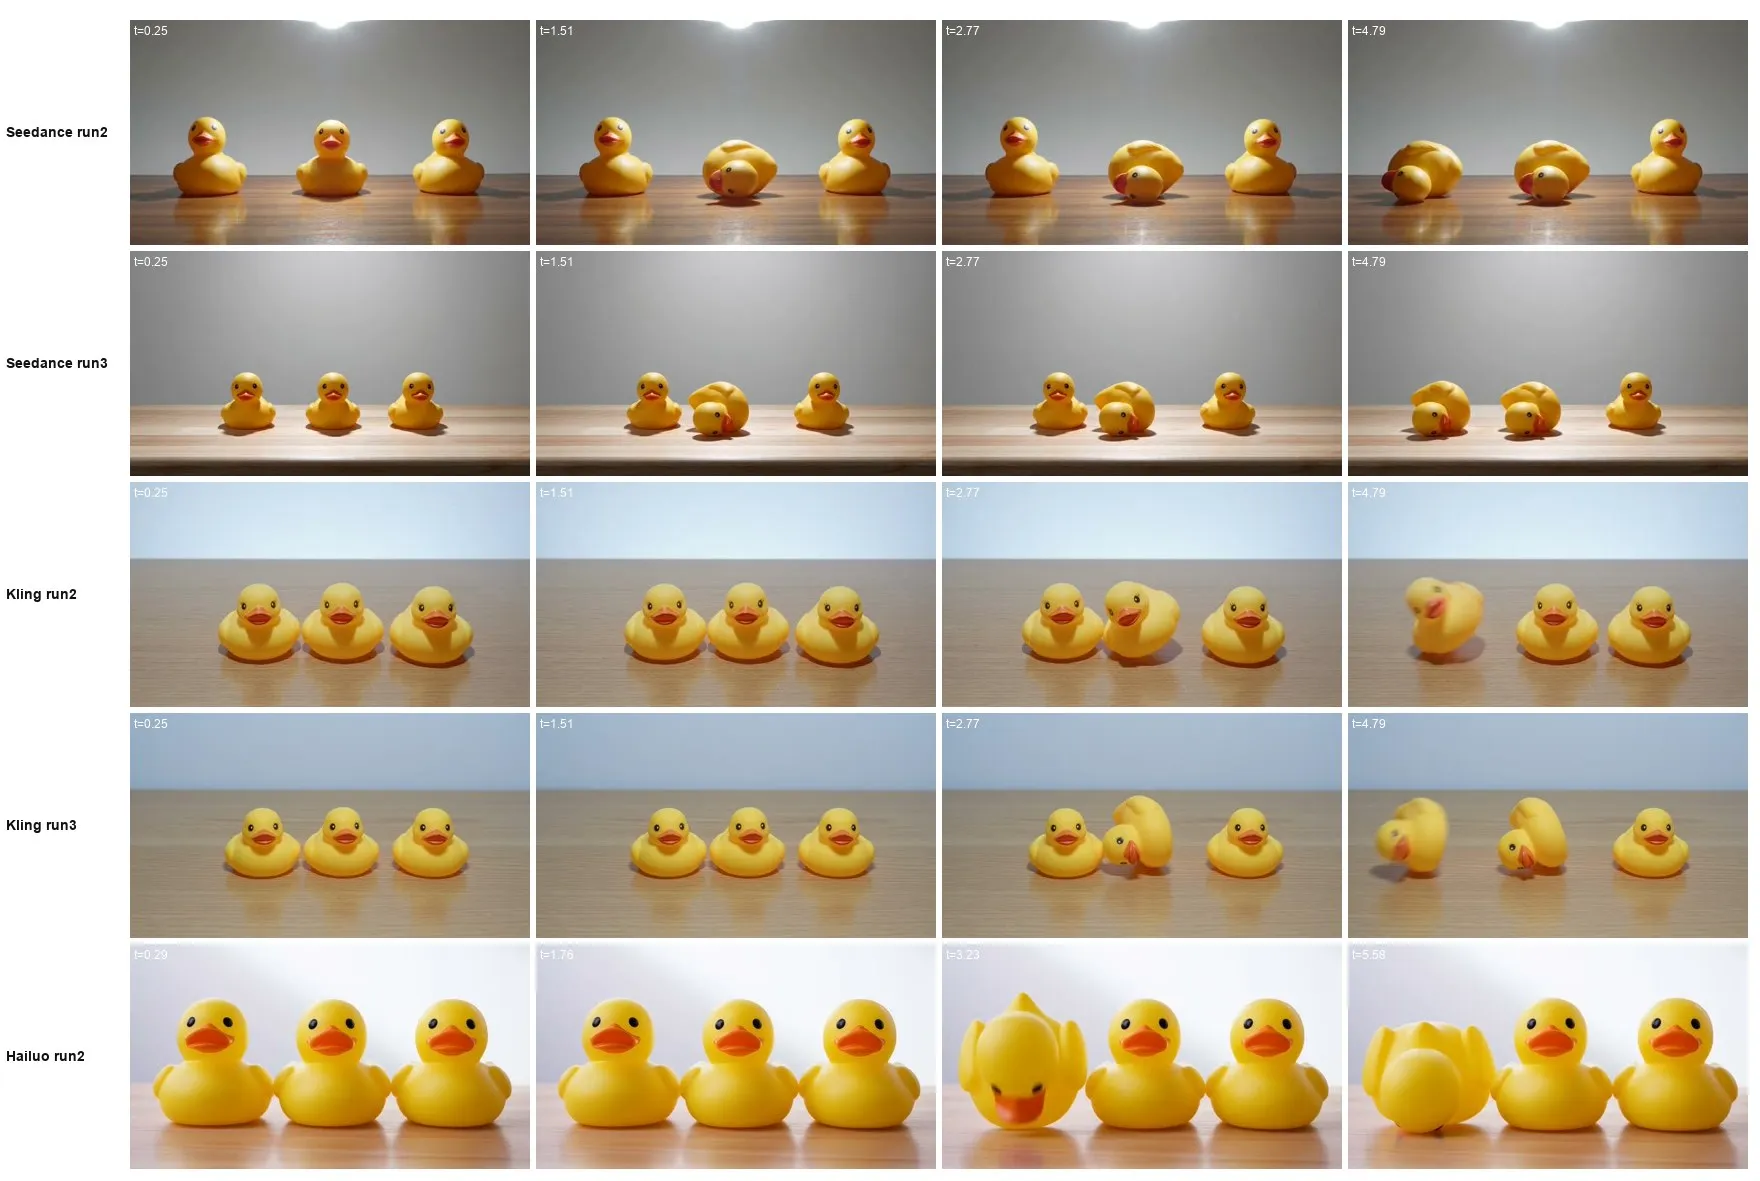
重跑時還出現一個單次生成看不出的新現象。Kling 3 Turbo 在第 2 次測試中讓中間鴨子倒下後,又在最終畫格前站起來;這與 Veo 3.1 唯一一次測試裡出現的狀態回復問題相同。事件可以被觸發,狀態卻未必能持續。
當模型不聽話時,重試到底要花多少?
價格與速度沒有固定關係。Hailuo 02 Pro 是每支影片成本第二低的模型,卻以 166–185 秒成為最慢的一款;Kling 3 Turbo 則在 45–54 秒內交出 18/20 的成績。每支影片的價格也會讓短片模型看起來更便宜:Veo 3.1 每支 $1.25,高於 Seedance 2.0 Fast 的 $0.83,但 Veo 回傳 8 秒、Seedance 只有 5 秒,換算每秒後兩者幾乎相同,分別為 $0.156 與 $0.165。
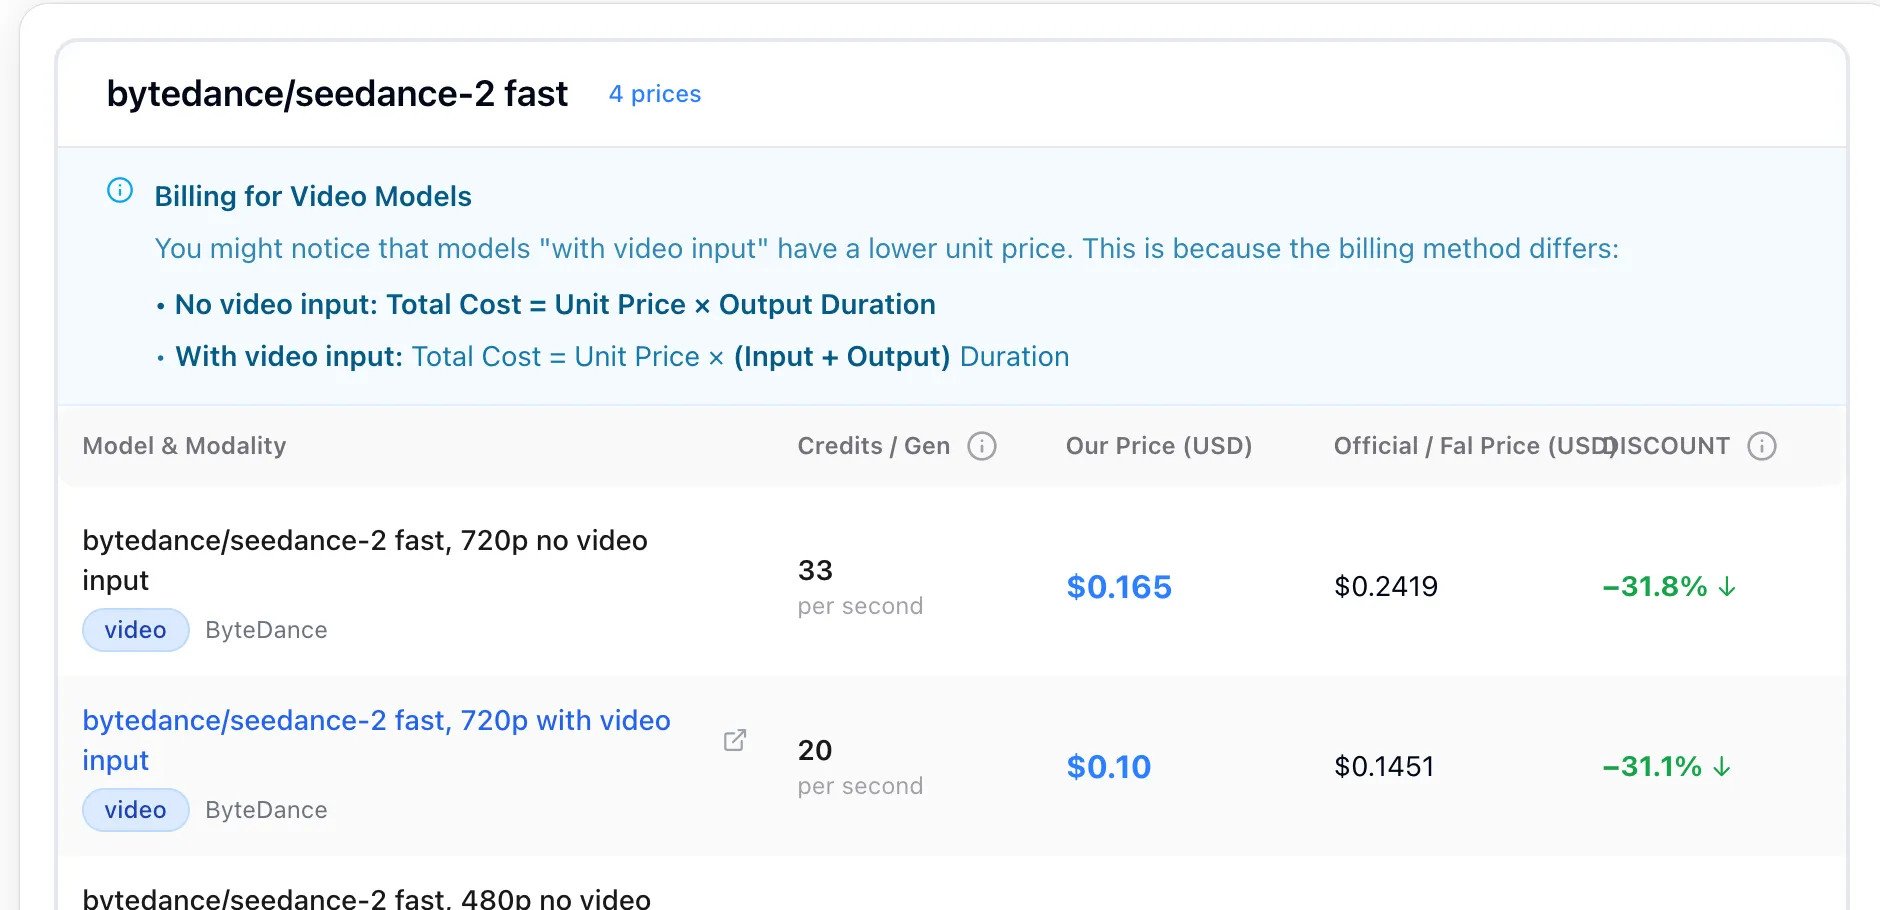
本文背後的 17 支影片共花費 1,387 Kie 點數與 250 AIReiter 點數;以每美元可購得 200 點與 100 點計算,總成本為 $9.44。五次失敗的 Sora 2 提交沒有產生費用。生成本身不貴;真正昂貴的是因為第四項元素消失、檢查清單又沒抓到,而得重生三次。
正如一位 r/SoraAi 使用者所說:「不管我把提示詞寫得多清楚、多詳細或多嚴格,SORA 總是忽略基本的視覺指令。」逐元素評分能把這種抱怨轉成具體清單:究竟是哪一條指令被忽略,而這正是你可以據以調整的資訊。
把這套測試用在自己的鏡頭清單
- 挑一條真實提示詞改寫,讓每個子句都能驗證——把「電影感」換成攝影機高度、光線方向,以及運鏡結束時應停留的畫面。
- 生成前先拆成有編號的元素清單。十項就夠;務必寫下來,否則你會憑記憶評分,對模型過度寬容。
- 關閉提示詞改寫器。在 Wan 將
prompt_extend設為false,在 Hailuo 將prompt_optimizer設為false;比較前也要確認你的平台是否還有自己的改寫功能。 - 以相同時長與解析度,將完全相同的字串送往兩到三款模型,並記錄每款模型悄悄覆寫了哪些設定。
- 檢查完整影片,並以開頭、中段與最後畫格作為檢查點——短暫的狀態失誤可能發生在抽樣畫格之間。之後只重跑那些漏掉你真正重視元素的模型。少一隻黑耳朵或許無妨;倒下的鴨子又站起來則不行。
若想直接重現我們的測試,Veo 3.1、Seedance 2 Fast 與 Sora 2 的模型頁面,列出了本文使用的精確模型 ID 與每秒點數價格。
常見問題
哪款 AI 影片生成器最準確?
在這次測試中是 Seedance 2.0 Fast:20 項可檢查元素命中 19 項,也是唯一在數量、順序與否定指令上完全過關的模型。不過在簡單場景中,六款裡有五款的準確度幾乎相同;真正能區分排名的是帶有事件順序的提示詞。
Seedance 比 Veo 3.1 或 Sora 2 更好嗎?
Seedance 2.0 Fast 比 Veo 3.1 高出 1 分,為 19 比 18;每支影片價格則約為後者的三分之二,兩者都正確執行了鴨子倒下的順序。我們無法為 Sora 2 排名——它在 2026-07-30 的五次提交全都於上游失敗,因此沒有分數,並非分數偏低。
Kling 3 Turbo 適合提示詞很複雜的工作嗎?
若速度比事件順序更重要,答案是肯定的。Kling 3 Turbo 在直述提示詞拿下六款最高的 9.5/10,並在 45–54 秒內回傳;但壓力測試少了 1 分,因為提示詞要求純白背景,它卻生成藍灰色牆面。
提示詞寫得更長,會提高遵循度嗎?
不會單靠長度就提高。本測試的直述提示詞比壓力測試提示詞更長,但所有模型在前者分數都更高,原因是它描述的是靜態排列,而不是數量與事件順序。
這項測試還無法回答的問題
三次生成足以顯示這些分數並非抽樣雜訊,卻還不足以構成基準測試。只有 Seedance、Kling 與 Hailuo 進行重跑;Veo 3.1、Wan 2.7 和 Grok Imagine 仍各只測試一次。兩組提示詞也都是單一鏡頭、沒有對話、長度不足十秒,因此最可能在真實剪輯流程中出問題的指令類型——多鏡頭連續性、台詞、具名角色再次出場——完全沒有被測試。上述排名告訴你誰最能遵循一個描述明確的鏡頭;它能否撐過整份鏡頭清單,則是下一項、而且截然不同的測試。
延伸閱讀: Seedance 2.0 vs Kling 3.0 vs Sora 2 vs Veo 3.1 · AI camera movement prompts, tested