 AIREITER
Sonucu en baştan verelim: Kısa formatlı İngilizce veya Çince ses içerikleri üretiyorsanız Seed Audio 1.0'ı bugün denemeye değer; ancak resmi API yerine üçüncü taraf bir ağ geçidi üzerinden. ByteDance'in modeli, tek bir istemden diyalog, arka plan müziği ve ses efektleriyle komple bir ses sahnesi oluşturabiliyor. Çok konuşmacılı diyalogları müzik miksajıyla birlikte üretmesi, onu yalnızca TTS ya da müzik odaklı araçlardan ayırıyor. Buna karşılık üç önemli sınır var: Her üretim en fazla iki dakika, yalnızca İngilizce ve Çince konuşuyor, resmi API ise hâlâ yalnızca davetle erişilebiliyor ve açıklanmış bir fiyatı bulunmuyor. Tüm ayrıntılar aşağıda.
Seed Audio 1.0 tam olarak ne yapıyor?
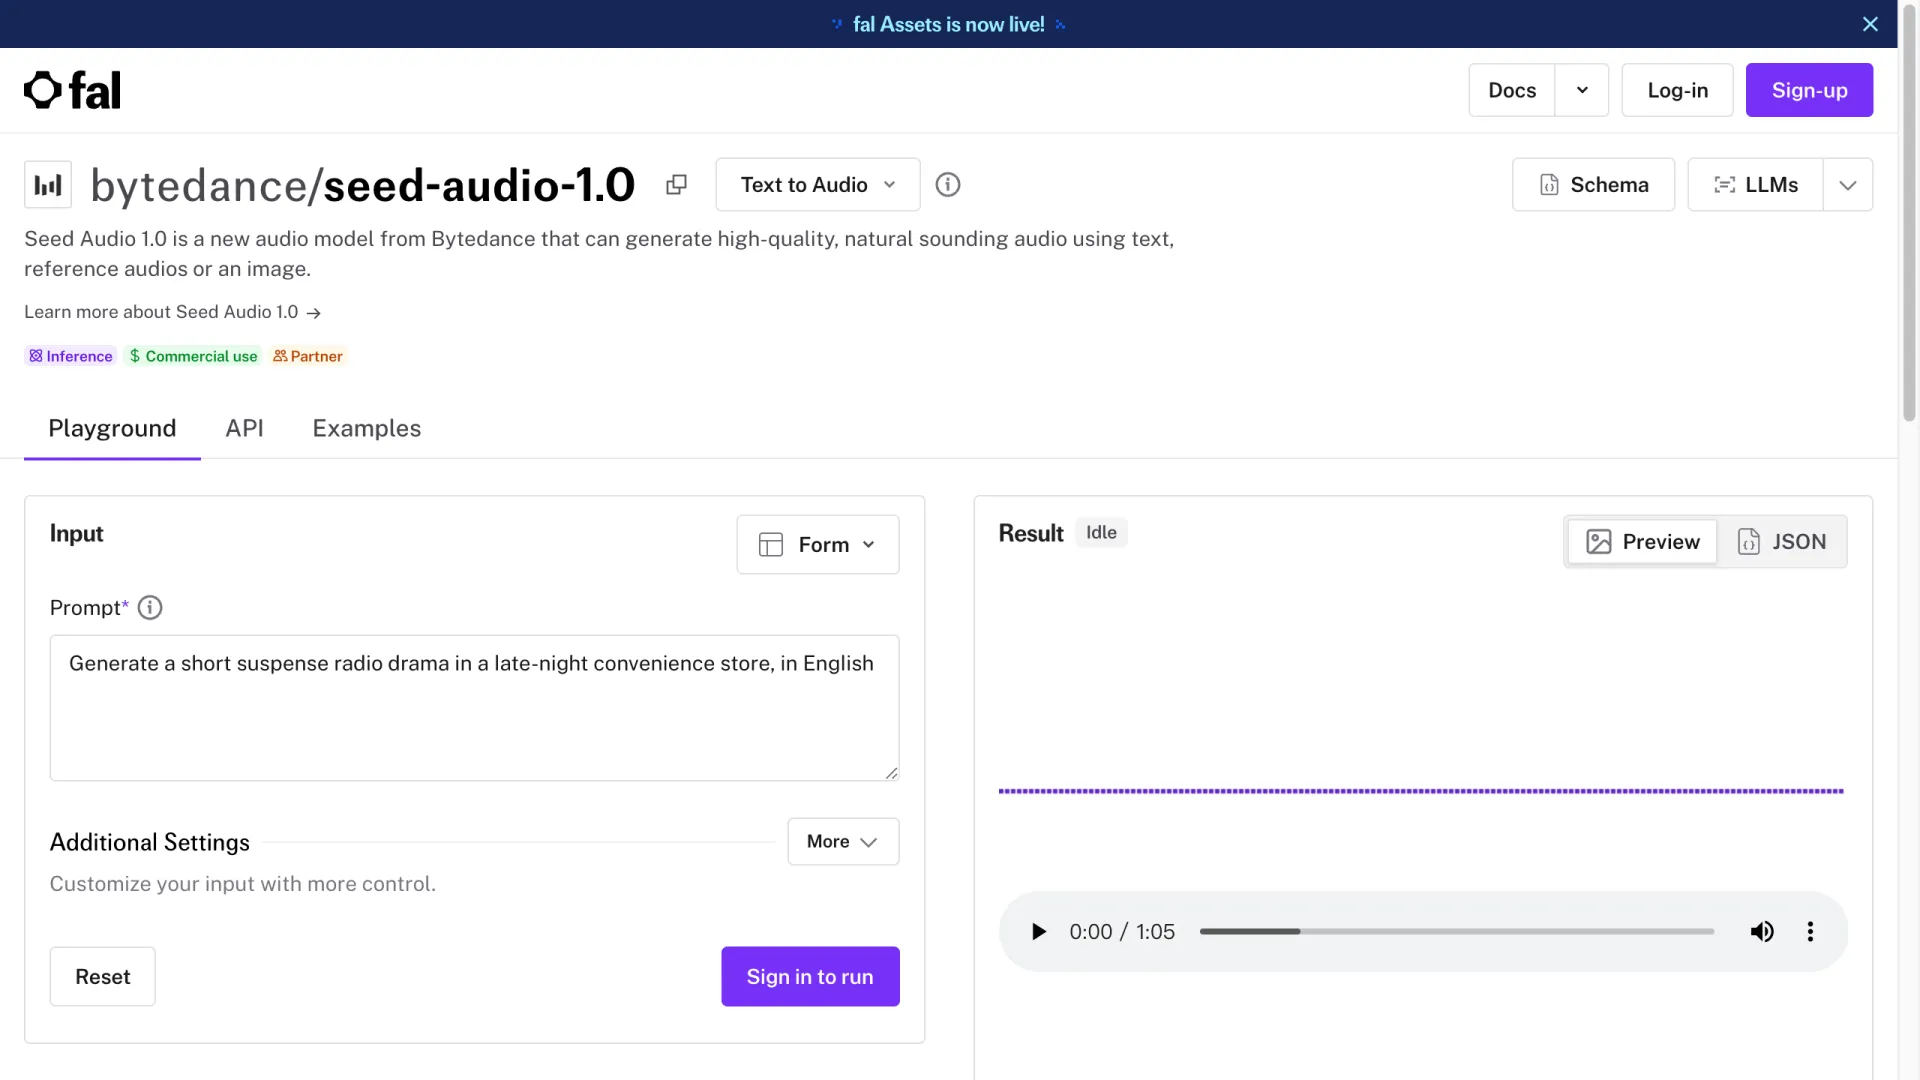
Ses araçlarının çoğu tek bir işe odaklanır: metni sese dönüştürmek, müzik üretmek ya da ses efekti oluşturmak. Seed Audio 1.0'ın tam adı Doubao-Seed-Audio 1.0 ve bu üç işi tek zaman çizelgesinde, tek geçişte bir araya getiriyor. Örneğin "gece geç saatte bir markette geçen gerilimli radyo tiyatrosu" gibi bir istem verdiğinizde; konuşma replikleri, ortam sesleri ve mikslenmiş müzik altyapısıyla tamamlanmış bir kayıt döndürüyor.
Model üç farklı modda çalışıyor. Text-to-audio (T2A), yazılı bir açıklamadan sahne oluşturuyor. Text-and-audio-to-audio (TA2A), metne ek olarak referans klipler alıyor; böylece ses ve üslubu yönlendirebiliyorsunuz. Düz TTS ise yalnızca temiz bir anlatım sesine ihtiyaç duyduğunuz durumlar için. Hangi modu kullanacağınız, modele verdiğiniz girdiye göre belirleniyor.
Şu noktayı netleştirmekte fayda var: Bu bir ses klonlama aracı mı? Seed Audio 1.0, tek bir sesle birden fazla karakteri canlandırabiliyor ve referans klibin tonunu taklit edebiliyor. Ancak sonuç, belirli bir gerçek kişinin kimliğine bağlı bir kayıt değil, sentezlenmiş ses oluyor. Bu nedenle onu adı belirli bir kişinin rızasız klonlanması olarak değil, zero-shot ses stili üretimi olarak görmek gerekir. Model, ByteDance'in önceki Seed-TTS ve Seed-Music araştırmalarını temel alıyor; konuşmadaki ifade gücü ile müzik üretiminin aynı modelde buluşmasının sebebi de bu.
Kullanım kararını belirleyen teknik sınırlar
Önce kullanım senaryonuzun bu katı limitlere uyup uymadığını kontrol edin. fal ve EvoLink model listelerinde karşılaştırılarak doğrulanan kritik değerler şunlar:
| Özellik | Değer |
|---|---|
| Üretim başına maksimum çıktı | 120 saniye (2 dakika) |
| Metin istemi sınırı | ~1.500–2.000 karakter (kaynaklar farklı; konsolda doğrulayın) |
| Referans ses | Her biri ≤30 saniye olacak şekilde en fazla 3 klip |
| Diller | Yalnızca İngilizce ve Çince |
| Çıktı formatları | WAV, MP3, PCM, OGG Opus |
| Örnekleme hızları | 48K / 24K / 16K / 8K |
| Kontroller | Hız, perde, ses seviyesi (SSML yok) |
| Faturalandırma modeli | Çıktı süresine göre |
En çok zorlayan sınır iki dakikalık tavan. Tam uzunlukta bir podcast bölümü veya uzun anlatım için metni parçalara ayırıp kayıtları birleştirmeniz gerekir; bu da bölümler arasında ton farkı oluşması riskini doğurur. fal'ın model notları, tek üretimdeki süreyi on dakikaya yaklaştıracak, açık süre kontrolü ve daha geniş dil desteği getirecek planlı bir güncellemeye işaret ediyor. Uzun format sizin işinizse bunu beklemek mantıklı olabilir.
Fiyatlandırma henüz net değil
Ortada henüz resmi bir fiyat yok. Temmuz 2026 itibarıyla Volcengine, Seed Audio 1.0 için saniye başına bir ücret açıklamadı. Model Volcano Ark üzerinde hâlâ yalnızca davetle kullanılabiliyor; resmi ücretler genellikle genel kullanıma açılışla birlikte belirleniyor. fal ve EvoLink gibi ağ geçitleri de sabit bir fiyat yayınlamıyor; çıktı süresine göre ücretlendiriyorlar (maliyet = üretilen saniye × ücret). Dolayısıyla yeniden denemeler de faturaya yansıyor. Ortalıkta dolaşan token bazlı rakamları dikkate almayın; süre bazlı çalışan bir ses modeli için token faturalandırması uygun değil.
Bugün nasıl erişebilirsiniz?
Pratikte iki erişim yolu var ve deneyimleri birbirinden oldukça farklı.
Resmi yol Volcano Ark. Seed Audio 1.0 burada yalnızca davetle sunuluyor. Başvuru yapıyor, erişim için bekliyor ve ByteDance'in kendi konsolunu kullanıyorsunuz. Model genel kullanıma açıldığında ve resmi fiyat geldiğinde, en yetkili kaynak burası olacak.
Daha uygulanabilir seçenek ise üçüncü taraf ağ geçitleri. fal, modeli bytedance/seed-audio-1.0 adıyla beyaz liste zorunluluğu olmadan barındırıyor. Standart bir anahtarla API üzerinden uç noktaya erişebilirsiniz; EvoLink de benzer erişim sağlıyor. Davet beklemeden modelle üretim yapmak isteyenlerin bugün kullandığı yol büyük ölçüde bu.
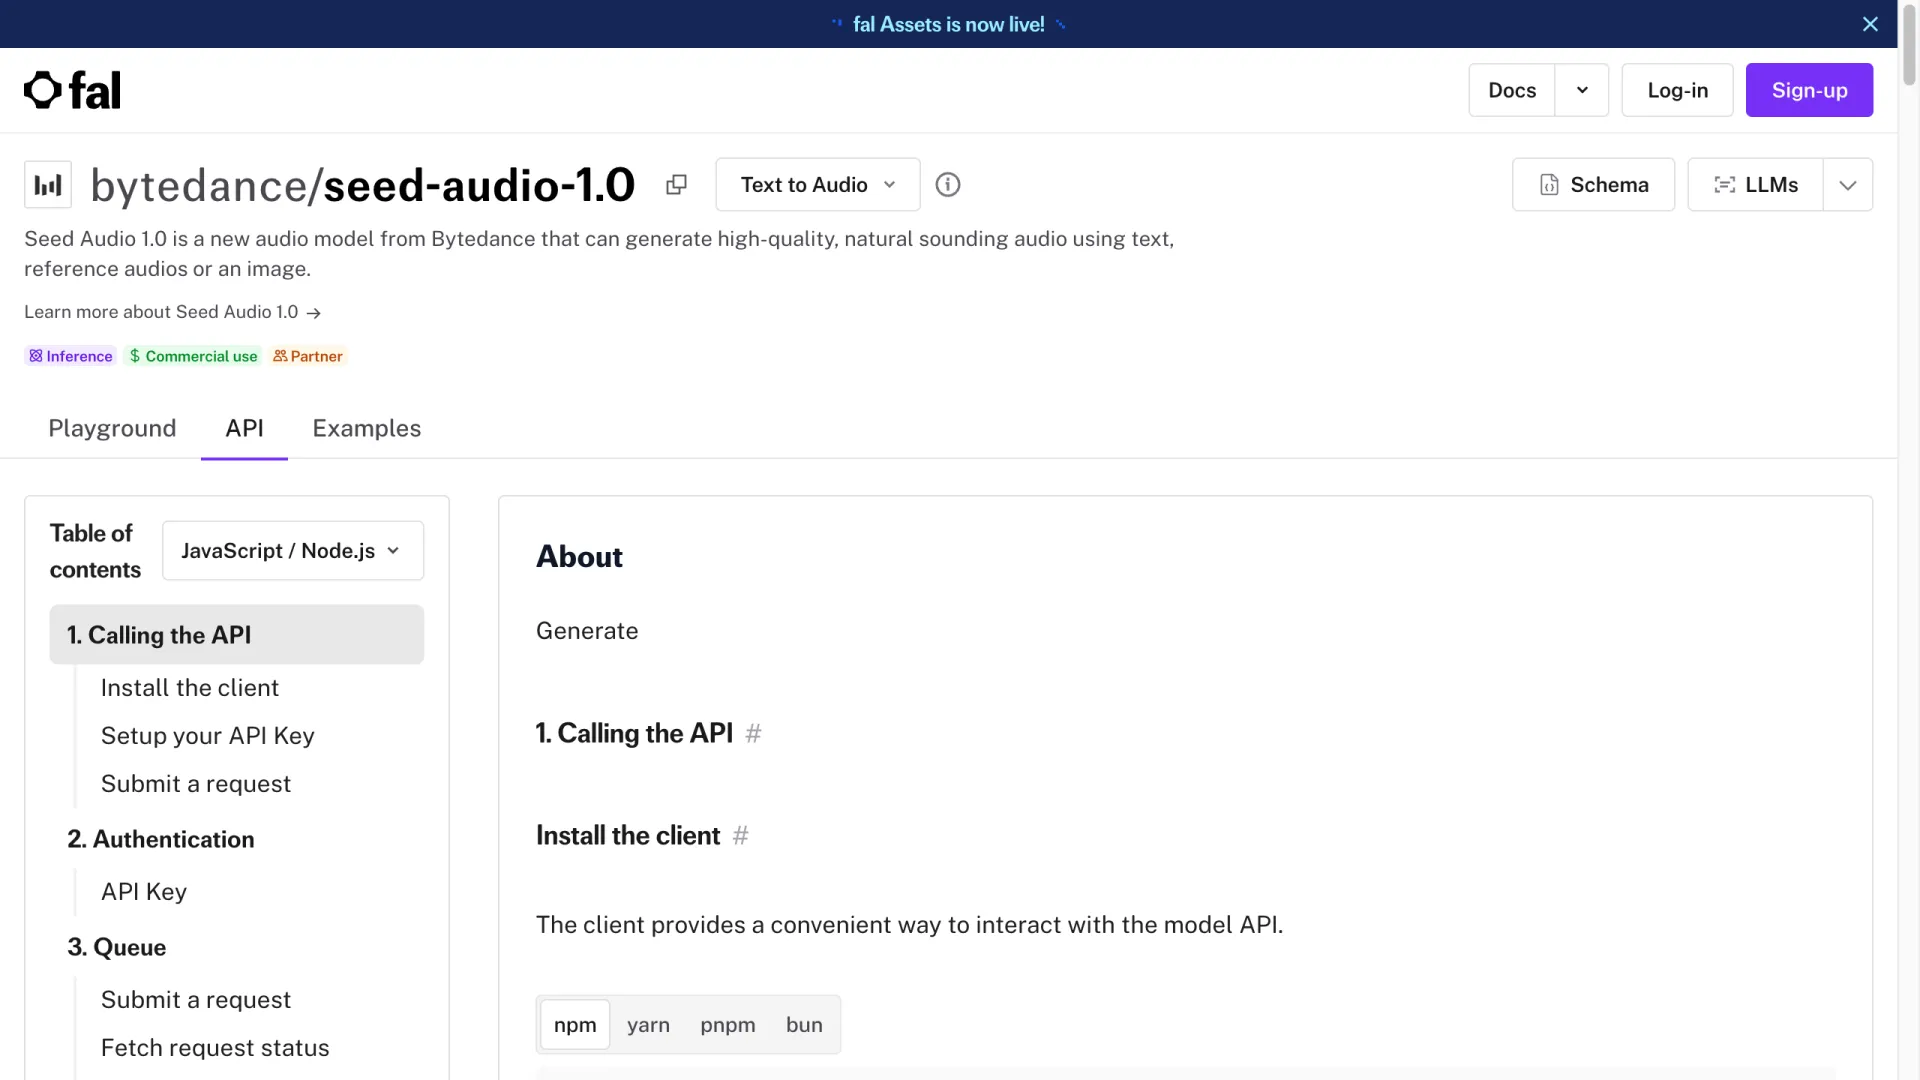
Çağrı düzeni, standart kuyruk tabanlı bir API akışı: istemciyi kurun, anahtarınızı tanımlayın, istemi gönderin ve sonuç için sorgulama yapın. Daha önce bu yöntemle barındırılan üretken bir modeli entegre ettiyseniz öğrenmeniz gereken yeni bir şey yok. Geliştirici deneyimiyle ilgili daha fazla ayrıntı için fal.ai incelememize göz atabilirsiniz.
İlk deneme için diyalog, ambiyans ve tempoyu aynı anda sınayan kısa, çok konuşmacılı bir sahne iyi bir tercih olur. Örneğin: "gece geç saatte bir markette geçen 30 saniyelik gerilimli radyo tiyatrosu, İngilizce." Modelin isteminizi nasıl yorumladığını öğrenirken başarısız bir denemenin maliyetini düşük tutmak için ilk klibi 30 saniyenin altında tutun.
Seed Audio 1.0, ElevenLabs, Stable Audio ve AudioCraft karşılaştırması
Burada asıl önemli olan, klip başına kalite kıyası değil; her aracın hangi iş için tasarlandığı.
| Araç | Temel güçlü yanı | Sahne miksajı | Diller | Ses kontrolü |
|---|---|---|---|---|
| Seed Audio 1.0 | Tam ses sahneleri (konuşma + müzik + SFX) | Evet, tek geçişte | EN, CN | Zero-shot stil oluşturma |
| ElevenLabs | Konuşma ve ses klonlama | Yalnızca konuşma | 30+ | En güçlü klonlama |
| Stable Audio | Müzik ve ses üretimi | Tek parça | Yok (müzik) | İstem tabanlı |
| AudioCraft | Açık kaynak müzik/SFX | Tek parça | Yok (müzik) | İstem tabanlı |
Birden fazla dilde en iyi saf konuşma kalitesine veya hassas ses klonlamaya ihtiyacınız varsa ElevenLabs hâlâ önde. Tek başına müzik üretmeniz gerekiyorsa Stable Audio ya da Meta'nın AudioCraft'ı bu iş için tasarlanmış durumda. Seed Audio 1.0'ın farkı ise diyalog, müzik ve efektleri düzenlenebilir, tutarlı bir sahnede buluşturması; buradaki diğer araçların hiçbiri bunu tek API çağrısında yapmıyor.
Güçlü yönleri ve eksikleri
Öne çıktığı noktalar: Çok konuşmacılı diyalog ve müzikle efektleri tek geçişte miksleme, modelin temel cazibesi. fal'ın kullanım kılavuzunda anlatılan klibi uzatma, bir bölümü in-paint etme ve kayıtları birleştirme gibi düzenleme iş akışları da onu tek seferlik bir üreticiden çıkarıp üretimde kullanılabilir bir araca dönüştürüyor.
Sınırlı kaldığı noktalar: İki dakikalık sınır, uzun içeriklerde klipleri birleştirmeyi zorunlu kılıyor. Yalnızca İngilizce ve Çince desteklemesi, küresel ses çalışmalarının çoğunu kapsam dışı bırakıyor. Çevrimdışı üretim yapan bir model olduğu için gerçek zamanlı sesli asistanlar için doğru seçenek değil. Üstelik resmi erişim hâlâ davet gerektiriyor.
Şimdiden kullanmaya değer mi?
İçeriğiniz İngilizce veya Çinceyse ve kısa formatta kalıyorsa — dublaj, sesli kitap kesitleri, kısa video müzikleri, prototip radyo tiyatroları — Seed Audio 1.0'ı bugün bir ağ geçidi üzerinden denemeye değer. Sahneyi tek geçişte üretmesi, konuşma, müzik ve efekt katmanlarını elle birleştirme işini ortadan kaldırıyor.
Gerçek zamanlı etkileşim, desteklenmeyen bir dil veya kesintisiz uzun ses kaydı gerekiyorsa bekleyin. Genel kullanıma açılış ve planlanan süre güncellemesi denklemi değiştirecek. Bu arada canlı kullanım senaryoları için Qwen Audio 3 gibi gerçek zamanlı bir model daha uygun. Diğer kullanıcılar içinse bu, tam geçiş yapmaktan çok "bir ağ geçidinde test edin, mevcut sisteminizi çalıştırmaya devam edin" dönemi.
Sık sorulan sorular
Seed Audio 1.0 ücretsiz mi?
Hayır. Ücretsiz resmi bir katman bulunmuyor. Volcano Ark API'si yalnızca davetle erişilebilir durumda ve erişim sağlandığında çıktı süresine göre ücretlendiriliyor. Üçüncü taraf ağ geçitleri ise kendi sayaçlı ücretlerini uyguluyor.
Seed Audio 1.0 sesimi klonlayabilir mi?
Referans klibin stilini taklit edebilir ve birden çok rolü seslendirebilir; ancak belirli bir gerçek kişinin sabit klonunu değil, sentezlenmiş konuşma üretir. Bunu doğrudan kimlik klonlama aracı olarak görmemelisiniz.
Seed Audio 1.0 hangi dilleri destekliyor?
Lansman itibarıyla yalnızca İngilizce ve Çince. fal'ın model notlarına göre daha geniş çok dilli destek, planlanan güncellemenin yol haritasında yer alıyor.
Üretilen ses ne kadar uzun olabilir?
Bugün her üretim en fazla 120 saniye olabilir. Planlanan güncelleme, açık süre kontrolüyle tek üretimdeki uzunluğu on dakikaya yaklaştırıyor.
Resmi bir Seed Audio 1.0 API'si var mı?
Evet, Volcengine'in Volcano Ark platformunda mevcut; ancak şimdilik yalnızca davetle erişilebiliyor. Beyaz liste olmadan açık erişim için bytedance/seed-audio-1.0 modelini barındıran fal gibi bir ağ geçidi kullanabilirsiniz.
Seed Audio ile Seed Music arasındaki fark nedir?
Seed-Music, ByteDance'in daha önceki müzik odaklı araştırmasıydı. Seed Audio 1.0 ise bu müzik yeteneğini konuşma ve ses efektleriyle birleştirerek tek bir sahne üretim modeline dönüştürüyor.