 AIREITER
Qwen Audio 3.0 Realtime, Qwen'ın güncel ürün ailesindeki gerçek zamanlı ses katmanı. Kullanıcıyla neredeyse telefon görüşmesi hissi verecek kadar düşük gecikmeyle konuşup karşılık verebilen bu yapı, Alibaba platformunda Qwen3-Omni / Qwen3.5-Omni Realtime API üzerinden sunuluyor. qwen3-omni-flash-realtime gibi model kimlikleri konuşmalı deneyimin merkezinde yer alırken, yalnızca metni sese çevirmek için Qwen-TTS-Realtime, transkripsiyon içinse qwen3-asr-flash kullanılıyor. Barındırılan omni Realtime modelleri 100'ün üzerinde dili tanıyor, kesintileri destekleyen tam çift yönlü çalışıyor ve konuşma başına maliyeti sentin çok altında kalıyor.
Başlamak için en hızlı yol, WebSocket üzerinden qwen3-omni-flash-realtime kullanmak. Aşağıda modellerin görevlerini, maliyetlerini, OpenAI Realtime ve Gemini Live karşısındaki konumunu ve ilk kurulumu bulacaksınız. Tüm teknik özellikler, fiyatlar ve model kimlikleri birincil kaynaklarına bağlandı; ağırlıklı olarak Alibaba'nın Model Studio Realtime dokümantasyonu ve Qwen3-Omni model kartı kullanıldı. Bu alan hızlı değişiyor; bir rakam güncelliğini yitirmişse bağlantıdaki kaynağı esas alın.
Qwen ses modellerinin adlandırma mantığı
Qwen'ın ses tarafı birkaç nesle yayılıyor. Doğru modeli seçmek için bu ayrımı bilmek yeterli:
Qwen-Audio(2023) veQwen2-Audio, sesi anlayan modellerdi: ses alır, metin üretirlerdi. Sesli yanıt vermezlerdi.- Güncel nesilde ses yetenekleri omni modellerine dahil edildi.
Qwen3-OmniveQwen3.5-Omni; metin, görsel, ses ve video kabul edip hem metin hem de doğal konuşma üretebiliyor. - Gerçek zamanlı çalışma bir sunum katmanı. Aynı omni modeller, Realtime API üzerinden çağrıldığında model kimliklerinin sonuna
-realtimeekleniyor.
Bu nedenle "Qwen Audio 3.0 Realtime" ifadesi, gerçek zamanlı kullanılan Qwen3-Omni ailesini anlatıyor. Rehberin geri kalanı da bu altyapıya odaklanıyor.
Üç parçalı Qwen gerçek zamanlı ses altyapısı
Burada tek bir modelden çok bir işlem hattı düşünmek daha doğru. Üretim ortamındaki bir ses uygulaması genellikle üç Qwen modeline dokunur; bunları birlikte de ayrı ayrı da kullanabilirsiniz.
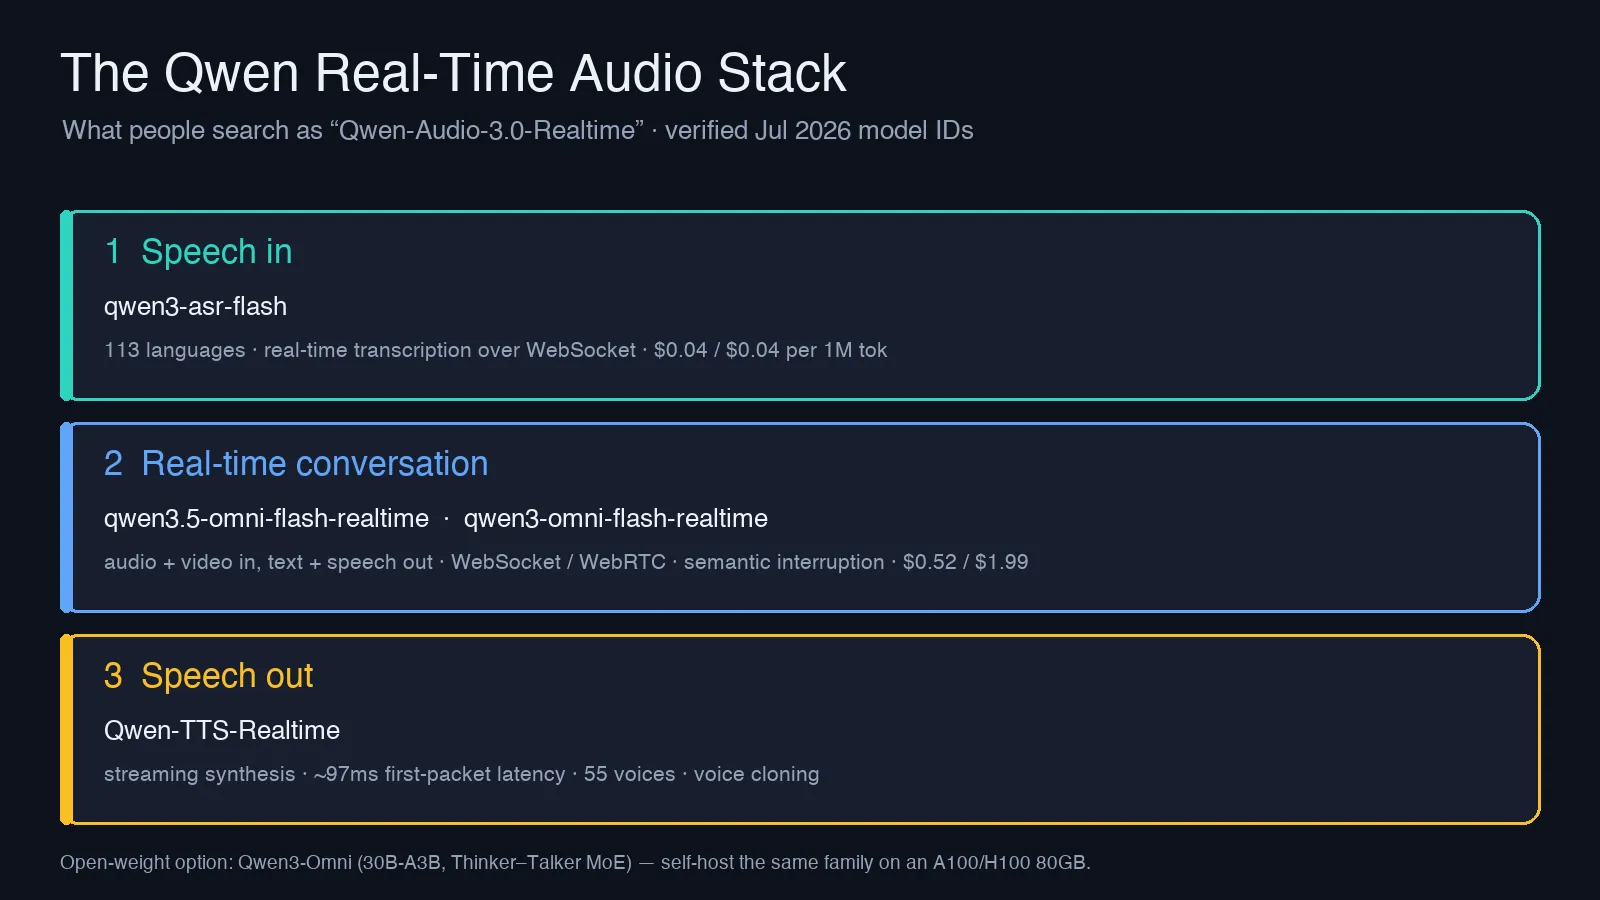
- Ses girişi —
qwen3-asr-flash. Canlı altyazılar ve sesli ajan arayüzleri için optimize edilmiş, WebSocket üzerinden çalışan akışlı konuşma tanıma modeli. Çok geniş bir dil yelpazesinde transkripsiyon yapıyor ve düşük maliyetli bir transkripsiyon iş gücü olarak fiyatlandırılıyor. - Gerçek zamanlı konuşma —
qwen3.5-omni-flash-realtime,qwen3-omni-flash-realtime,qwen3.5-omni-plus-realtime. Sistemin çekirdeği burası: ses ve video kareleri girdi olarak alınır; metin ve sentezlenmiş konuşma çıktı olarak üretilir. Her istek için bağlantıyı yeniden açmak yerine, dönüşler boyunca açık kalan kalıcı bir bağlantı kullanılır. - Ses çıkışı —
Qwen-TTS-Realtime. Yalnızca metni sese dönüştürmeniz gerektiğinde kullanılacak özel akışlı metinden sese modelidir. Örneğin, metin tabanlı bir LLM'in ürettiği yanıtı sesli okutmak için idealdir.
Orta katmanda omni Realtime modelini kullanıyorsanız, sesi uçtan uca işlediği için çoğu zaman ayrıca ASR ve TTS çağrısı yapmanız gerekmez. Ayrı modeller, kendi STT çözümünüzle Qwen TTS'i bir araya getirmek gibi esnek kurulumlar için var.
Gerçekte önemli olan teknik özellikler
Aşağıdaki rakamlar pazarlama sayfalarından değil, Model Studio Realtime dokümantasyonundan alındı.
| Özellik | Qwen Realtime API (omni ailesi) |
|---|---|
| Ses girişi | PCM, 16 kHz |
| Ses çıkışı | PCM, 24 kHz |
| Diğer girişler | Görsel / video kareleri (JPG, 1080p'ye kadar, kodlama sonrası 256 KB) |
| Konuşma tanıma | 113 dil ve lehçe (barındırılan API) |
| Konuşma üretimi | 36 dil ve lehçe |
| Sesler | Toplam 55 ses (47 çok dilli, 8 lehçeye özgü), ayrıca 3.5 modellerinde ses klonlama |
| Bağlantılar | WebSocket (Bearer kimlik doğrulama, manuel veya sunucu taraflı VAD) ve WebRTC (SDP müzakeresi) |
| Maksimum oturum | WebSocket üzerinden 120 dakika |
| Ek özellikler | Anlamsal kesinti, function calling, otonom web araması, ses seviyesi / hız / duygu için sesli kontrol |
Bu maddelerden birkaçının özellikle altını çizmek gerekiyor. Anlamsal kesinti, modelin kullanıcının gerçekten araya girdiğini mi yoksa yalnızca "hı hı" gibi geri bildirim verdiğini mi ayırt edebilmesi demek. Doğal bir sesli ajanla sinir bozucu olan arasındaki farkı bu yaratıyor. WebRTC desteği ise tarayıcıda çalışan uygulamalar için önemli; yankı engelleme ve jitter sorunlarını sizin yerinize ele alıyor. Ayrıca 113 dil tanıma rakamı barındırılan API için geçerli. Aşağıda değinildiği gibi, açık ağırlıklı sürüm daha dar bir dil kapsamına sahip.
Gecikme tarafında, özel Qwen-TTS-Realtime akış yolu Qwen3-TTS akış dokümanlarına göre yaklaşık 97 ms ilk paket gecikmesini hedefliyor. Konuşmanın anlık hissettirip hissettirmediğini belirleyen sayı bu. Ancak bu değer, tam yanıtın değil ilk ses parçasının gelme süresi. Tüm konuşma döngüsünde Thinker–Talker mimarisi akış için tasarlanmış; Qwen3-Omni teknik raporu, gecikmeyi azaltmayı hedefleyen çoklu kod kitabı tasarımını anlatıyor. Topluluk testleri ise tam çift yönlü, kesintiye açık dönüşlerde sesten sese yanıt süresini 250 ms altı aralığında gösteriyor. Gerçek sonuçlar bölgeye, ağınıza ve yüke bağlıdır; tek bir manşet rakama güvenmek yerine kendi trafiğiniz üzerinde ölçüm yapın.
Qwen gerçek zamanlı ses fiyatları
Qwen'ın barındırılan gerçek zamanlı fiyatları, kapalı gerçek zamanlı API'lerden belirgin biçimde düşük. Aşağıdaki milyon token başına giriş / çıkış ücretleri, Portkey'nin DashScope model dizininde listeleniyor. Bu üçüncü taraf toplayıcı Alibaba fiyatlarını yansıtıyor; taahhüt vermeden önce güncel rakamı Model Studio konsolundan doğrulayın:
| Model | Giriş / 1M tok | Çıkış / 1M tok |
|---|---|---|
qwen-omni-turbo-realtime | $0.27 | $1.07 |
qwen3-omni-flash-realtime | $0.52 | $1.99 |
qwen3-asr-flash (transkripsiyon) | $0.04 | $0.04 |
Çağrı başına karşılığı ne? Ses, token açısından yoğun bir içerik: bir dakikalık ses yaklaşık 427 token tüketiyor. Kullanıcının 5 dakika, modelin de 5 dakika konuştuğu 10 dakikalık bir sesli görüşme düşünün. qwen3-omni-flash-realtime üzerinde bu, yaklaşık 2.135 giriş ve 2.135 çıkış tokeni eder; yani yaklaşık $0.001 giriş + $0.004 çıkış ≈ 10 dakikalık görüşme başına yarım sent. Ölçek büyüse bile gerçek zamanlı ses ucuz kalıyor. Sürpriz yaratabilecek kalem, konuşulan yanıtların girişe göre yaklaşık 4 kat pahalı olması nedeniyle çıkış tarafındaki konuşma süresi.
Bütçe planlamadan önce iki noktayı daha dikkate alın:
- Ücretsiz kota var, ancak bölgeye bağlı. Singapur (uluslararası) uç noktası, 90 gün boyunca 1 milyon giriş ve 1 milyon çıkış tokenini ücretsiz sundu; ABD uç noktası ise sunmadı. Kotalar değişebilir. Bu avantajı planınıza dahil etmeden önce bölgenizdeki güncel teklifi Model Studio konsolundan doğrulayın.
qwen3.5-omnikatmanında sabit ücret yerine istek boyutuna göre fiyat dilimleri uygulanıyor. Bu nedenle tek ve geniş bağlamlı bir istek, birkaç küçük isteğe kıyasla farklı bir fiyat bandına girebilir. Taahhüt vermeden önce bunu gerçek trafik yapınızla test edin.
OpenAI Realtime ve Gemini Live karşısındaki yeri
2026 ortasında, genel amaçlı üst seviye LLM sağlayıcıları arasında öne çıkan üç gerçek zamanlı sesten sese seçenek OpenAI Realtime API, Google Gemini Live ve Qwen'ın omni Realtime ailesi. ElevenLabs, Deepgram, Cartesia ve Hume gibi uzman ses sağlayıcıları TTS ve STT tarafında güçlü rakipler; ancak bu karşılaştırma tam çok modlu model yaklaşımına odaklanıyor. Aylık değişebilen rakip fiyatlarını sıralamak yerine, seçimi şu şekilde değerlendirmek daha doğru:
- Maliyet. Yukarıdaki çağrı başı ücretler üzerinden Qwen, barındırılan üst seviye model seçeneklerinin düşük maliyetli ucunda yer alıyor. Karşılaştırma için OpenAI Realtime ses ücretleri girişte dakika başına yaklaşık $0.06, çıkışta ise $0.24 seviyesinde seyretti (fiyat dökümü burada). Bu hesaba göre
qwen3-omni-flash-realtimeüzerinde yaklaşık yarım sente mal olan aynı 10 dakikalık görüşme, OpenAI tarafında $1.50 seviyesine yaklaşıyor. Tüm bu fiyatlar değiştiği için farkı esas almadan önce iki tarafın da güncel ücretini doğrulayın; ancak aradaki makas büyük. Ayrıca bu üç seçenek içinde, marjinal maliyeti sıfıra yaklaştırmak için kendi altyapınızda çalıştırabileceğiniz açık ağırlıklı sürümü olan tek model Qwen. - Açıklık. OpenAI Realtime ve Gemini Live yalnızca kapalı API olarak sunuluyor. Qwen3-Omni açık ağırlıklarla geliyor; dolayısıyla uygulamanızı farklı bir model davranışına göre baştan yazmadan barındırılan yapıdan kendi sunucunuza geçebilirsiniz.
- Kalite. Üçüncü taraf incelemeler, en üst
qwen3.5-omni-pluskatmanının bazı ses-anlama testlerinde Gemini 3.1 Pro'ya yetiştiğini veya onu geçtiğini bildiriyor. Herhangi bir tek benchmark'ı sonuç değil başlangıç varsayımı olarak görün; kendi ses verinizle test edin. - Ekosistem. OpenAI ve Google bugün daha gelişmiş araçlara, SDK'lara ve topluluk örneklerine sahip. Qwen'ın dokümantasyonu yeterli, ancak daha fazla ham WebSocket/WebRTC spesifikasyonuna dayanmanız gerekecek.
Pratik sonuç şu: maliyet veya ileride kendi altyapınızda çalıştırabilme seçeneği önemliyse Qwen en güçlü tercih. En olgun SDK deneyimini istiyor ve bunun ücretini ödemeyi kabul ediyorsanız OpenAI ile Google, kullanım kolaylığı açısından hâlâ önde. Kapalı alternatiflerin ayrıntılı maliyet analizi için aşağıdaki ilgili kaynaklara bakabilirsiniz.
Hangi sürümü seçmelisiniz?
| İhtiyacınız | Kullanılacak model |
|---|---|
| En düşük maliyetli barındırılan tam ses döngüsü | qwen3-omni-flash-realtime |
| En iyi barındırılan kalite, daha uzun oturumlar, ses klonlama | qwen3.5-omni-plus-realtime |
| Yalnızca transkripsiyon gerekiyorsa | qwen3-asr-flash |
| Yalnızca metinden sese dönüşüm gerekiyorsa | Qwen-TTS-Realtime |
| Veriler kendi donanımınızdan çıkmamalıysa | Açık ağırlıklı Qwen3-Omni'yi (30B-A3B) kendi altyapınızda çalıştırın |
3.5 katmanları, daha sade qwen3-omni-flash'in 8 dönüş sınırına karşılık ses klonlama, daha uzun bağlam ve diyalog sınırları ekliyor: 100 dönüşe ve saklanan ses için 600 saniyeye kadar çıkıyor. Prototip geliştiriyorsanız Flash ile başlayın; ancak adını koyabildiğiniz bir sınıra ulaştığınızda Plus'a geçin.
Erişim ve kurulum seçenekleri
Barındırılan servisle doğrudan erişim. Alibaba Cloud Model Studio üzerinden API anahtarı oluşturun; ardından Bearer kimlik doğrulamasıyla bir WebSocket bağlantısı açın. Tarayıcı uygulamalarında SDP POST üzerinden WebRTC müzakeresi de yapabilirsiniz. PCM sesi yukarı akıtırsınız; karşılığında PCM ses ve metin alırsınız. Soket yönetimini elle yapmak istemiyorsanız DashScope Python SDK, Realtime arayüzünü sarmalıyor. Temel bağlantı kısa bir örnekle şöyle görünüyor; hata yönetimi eklenmedi:
import os, json, base64, websocket

MODEL = "qwen3-omni-flash-realtime"
url = f"wss://dashscope-intl.aliyuncs.com/api-ws/v1/realtime?model={MODEL}"
ws = websocket.create_connection(
    url, header=[f"Authorization: Bearer {os.environ['DASHSCOPE_API_KEY']}"]
)

# 1. configure the session: voice, output format, server-side turn detection
ws.send(json.dumps({
    "type": "session.update",
    "session": {
        "voice": "Cherry",
        "output_audio_format": "pcm24",
        "turn_detection": {"type": "server_vad"},
    },
}))

# 2. stream microphone audio up as base64 PCM 16 kHz frames
ws.send(json.dumps({
    "type": "input_audio_buffer.append",
    "audio": base64.b64encode(pcm_frame).decode(),
}))

# 3. read events back; response.audio.delta carries PCM 24 kHz to play
while True:
    event = json.loads(ws.recv())
    if event["type"] == "response.audio.delta":
        play(base64.b64decode(event["audio"]))
Sunucu taraflı VAD kullanıldığında, kullanıcının konuşmayı ne zaman bitirdiğine model karar verir. Dönüş sınırlarını kendiniz belirlemek istiyorsanız manuel moda geçin. Etkinlik akışı OpenAI Realtime yapısına oldukça yakın olduğundan, mevcut Realtime istemci kodları küçük değişikliklerle taşınabilir. API zamanla geliştiği ve Singapur ile ABD dağıtımları arasında farklılıklar bulunduğu için, yayına çıkmadan önce alan adlarını, ses listesini ve bölgesel uç noktayı Realtime dokümanlarından doğrulayın.
Kendi altyapınızda çalıştırma. Açık ağırlıklı Qwen3-Omni, Thinker–Talker Mixture-of-Experts tasarımı kullanıyor: toplam 30B, etkin olarak yaklaşık 3B parametre. Alibaba, düz Transformers yerine vLLM kullanılmasını öneriyor. Tam 30B modelin BF16 çıkarımı için üçüncü taraf dağıtım rehberleri, tek bir 80GB kartı (A100 veya H100) alt sınır olarak gösteriyor. RTX 4090 gibi 24 GB kartlar tam ağırlıklar için yeterli değil; gerçi kuantize edilmiş sürümler bu eşiği düşürüyor.
Asıl zorluk, gerçek zamanlı sunumun toplu çıkarımdan daha karmaşık olması. Kendi altyapısında çalıştıranlar, eşzamanlı yük altında takılmaları önlemek için KV önbelleğini sınırlamaları gerektiğini ve tek karttaki token veriminin barındırılan API'nin gerisinde kaldığını bildiriyor. Akışa göre optimize edilmiş sunum katmanları bu farkın önemli bölümünü kapatabiliyor: Red Hat AI ve vLLM üzerinde çalışan mühendisler, işlem hattı aşamalarını örtüştürmenin 3 saniyelik bir klip için konuşma üretimini yaklaşık 8 saniyeden 0.5 saniye civarına düşürdüğünü aktardı. Bu ciddi bir kazanım, ancak ek mühendislik gerektiriyor. Kendi altyapınızda çalıştırmak token başına maliyeti ortadan kaldırırken GPU ve operasyon maliyeti ekler; bu yüzden prototiplerden çok yüksek ve istikrarlı hacimlerde anlamlıdır.
Bugün gerçek zamanlı omni ses için standart yol DashScope uç noktası. Altyapınızda zaten birden fazla sağlayıcıyı tek geçit üzerinden yönlendiriyorsanız önüne bir toplayıcı koyabilirsiniz. Ancak önce ilgili toplayıcının belirli Qwen gerçek zamanlı model kimliklerini desteklediğini doğrulayın; birçok aktarma servisi metin ve görsel modelleri taşısa da gerçek zamanlı ses katmanını sunmuyor.
Geliştirmeden önce bilmeniz gereken sınırlar
- Oturumlar 120 dakika ile sınırlı. Destek hattı veya uzun süreli özel ders gibi daha uzun senaryolarda, soketler arasında bağlamı taşıyan yeniden bağlantı mantığı gerekir.
- Bölge hem ücretsiz kotayı hem erişilebilirliği etkiler. İlk kayıt olduğunuz uç nokta yerine, uygulamayı gerçekten dağıtacağınız uç noktada test yapın.
- Barındırılan sürüm ile açık ağırlıklı sürüm aynı değil. Barındırılan API 113 dilde tanıma ve 36 dilde üretim sunuyor. Açık ağırlıklı Qwen3-Omni sürümü ise daha dar bir kapsamda çalışıyor: 19 ses-giriş ve 10 ses-çıkış dili. Belirli bir dil kritik gereksinimse, yayına alacağınız tam sürüm üzerinde doğrulama yapın.
- Gerçek zamanlı maliyet istek sayısıyla değil konuşma süresiyle artar. Ses token yoğun olduğundan, çok konuşan bir kullanıcı kısa konuşan bir kullanıcıdan daha pahalıya gelir. Faturanızı çağrı adedine göre değil, konuşma dakikalarına göre modelleyin.
Sık sorulan sorular
Qwen 3 ses desteği sunuyor mu?
Evet. Qwen3-Omni modelleri yerel olarak çok modlu çalışır: ses, metin, görsel ve videoyu girdi olarak alabilir; gerçek zamanlı metin veya konuşma yanıtı üretebilir.
Qwen yalnızca sesi anlamıyor, ses de üretebiliyor mu?
Evet. Yalnızca metin üreten ilk Qwen-Audio'dan farklı olarak omni Realtime modelleri ve Qwen-TTS-Realtime konuşmalı ses çıktısı üretiyor. 3.5 katmanında ses klonlama da bulunuyor.
Qwen gerçek zamanlı ses ücretsiz mi?
Ücretsiz deneme kotası bulunuyor: geçmişte uluslararası (Singapur) uç noktası için 90 gün boyunca 1 milyon giriş ve 1 milyon çıkış tokeni sunuldu. Bunun ardından token başına ücretlendirme uygulanıyor. Tamamen açık ağırlıklı Qwen3-Omni ise kendi GPU'nuzu sağladığınızda ücretsiz çalıştırılabilir.
Qwen sesi yerel olarak nasıl çalıştırabilirim?
Açık ağırlıklı Qwen3-Omni'yi (30B-A3B) indirin ve vLLM ile sunun. Tam modeli BF16 olarak çalıştırmak için yaklaşık 80GB'lık bir karta, yani A100 veya H100'e ihtiyacınız var. Daha küçük tüketici GPU'ları tam ağırlıkları değil, yalnızca kuantize edilmiş sürümleri çalıştırabilir.
İlgili kaynaklar
Birincil kaynaklar:
Alternatiflerin fiyatlandırması: