 AIREITER
OpenAI tarafında adında “fast” ya da “ultra” geçen üç ayrı seçenek var; ancak saniyede 750 token hızına ulaşan yalnızca biri. 13 Ağustos 2026'da duyurulan OpenAI Ultrafast mode, GPT-5.6 Sol'u Cerebras'ın wafer-scale çiplerinde Standard hızının 14 katına kadar çıkaran yeni bir API servis katmanı. Şimdilik önemli bir engel var: erişim yalnızca davetle sağlanıyor ve OpenAI fiyat bilgisini paylaşmış değil. Bu nedenle bugün satın alınabilen en hızlı katman, milyon token başına $10/$60 fiyatlı Fast mode olmaya devam ediyor.
ultra, Fast mode ve Ultrafast: Üç İsim, Üç Farklı Anlam
GPT-5.6 Sol kullananların karşısına hız çağrışımı yapan, fakat birbirinden farklı üç etiket çıkıyor. Aralarındaki farkı tek tabloda netleştirelim.
| Ad | Nedir? | Nasıl erişilir? | Sol fiyatı (1M token başına) | İlan edilen hız |
|---|---|---|---|---|
ultra reasoning ayarı | Tek bir görev için alt ajanları ve ek işlem gücünü kullanan reasoning/çalışma modu | Ayrı satın alınan bir API katmanı değil, Codex ayarı | Ayrı bir fiyatı yok; kullanım limitlerini hızla tüketir | Tasarım gereği daha yavaş |
| Fast mode | 30 Temmuz 2026'da Priority adıyla değiştirilen API işleme katmanı | Herhangi bir API isteğinde service_tier="fast" | $10 giriş / $60 çıkış (kısa bağlam) | Standard'ın 2.5 katına kadar |
| Ultrafast mode | GPT-5.6 Sol için Cerebras destekli, 13 Ağustos 2026'da önizlemeye açılan API katmanı | Sınırlı önizleme, yalnızca seçili müşteriler | Açıklanmadı | Standard'ın 14 katına kadar |
Aslında bu seçenekler farklı yönlere odaklanıyor: ultra, hızı kapsamlı sonuçlar uğruna ikinci plana atan alt ajanlı çalışma modu. Ultrafast mode ise aynı modelde doğrudan çıktı üretim hızını hedefliyor. İkisinin arasında yer alan Fast mode, OpenAI'nin Fast mode sayfasında ayrıca belgelenen ve satın alınabilen gecikme süresi yükseltmesi.
13 Ağustos Önizlemesinde Sunulanlar
Resmî duyuru beş noktayı açık biçimde doğruluyor: Ultrafast önce OpenAI API'de sunulacak, yalnızca GPT-5.6 Sol ile çalışacak, Standard işleme hızının 14 katına ve saniyede 750 çıktı tokenına kadar ulaşacak, Cerebras tarafından desteklenecek ve Jane Street, Podium, Basis ile Rogo'nun da aralarında bulunduğu seçili müşterilere sınırlı önizleme olarak açılacak.
Buna karşılık, satın alma kararı için kritik dört bilgi paylaşılmadı: token başına fiyat, model ID'si, hız limitleri ve gecikme SLA'sı. Duyuruda adı verilmiş herhangi bir benchmark da bulunmuyor.
OpenAI'nin sunduğu kanıt, tek bir prompt ile 3D depo simülatörü oluşturan Ultrafast ve Standard Sol'un yan yana demosundan ibaret. Rogo'dan Alex Wang'in şu sözü, yaklaşımın özetini veriyor: “Ultrafast, karmaşık finansal araştırmaları gerçek zamanlı bir etkileşim gibi hissettiriyor.”
2.5 Kattan 14 Kata: Hız Farkı Pratikte Ne Sağlıyor?
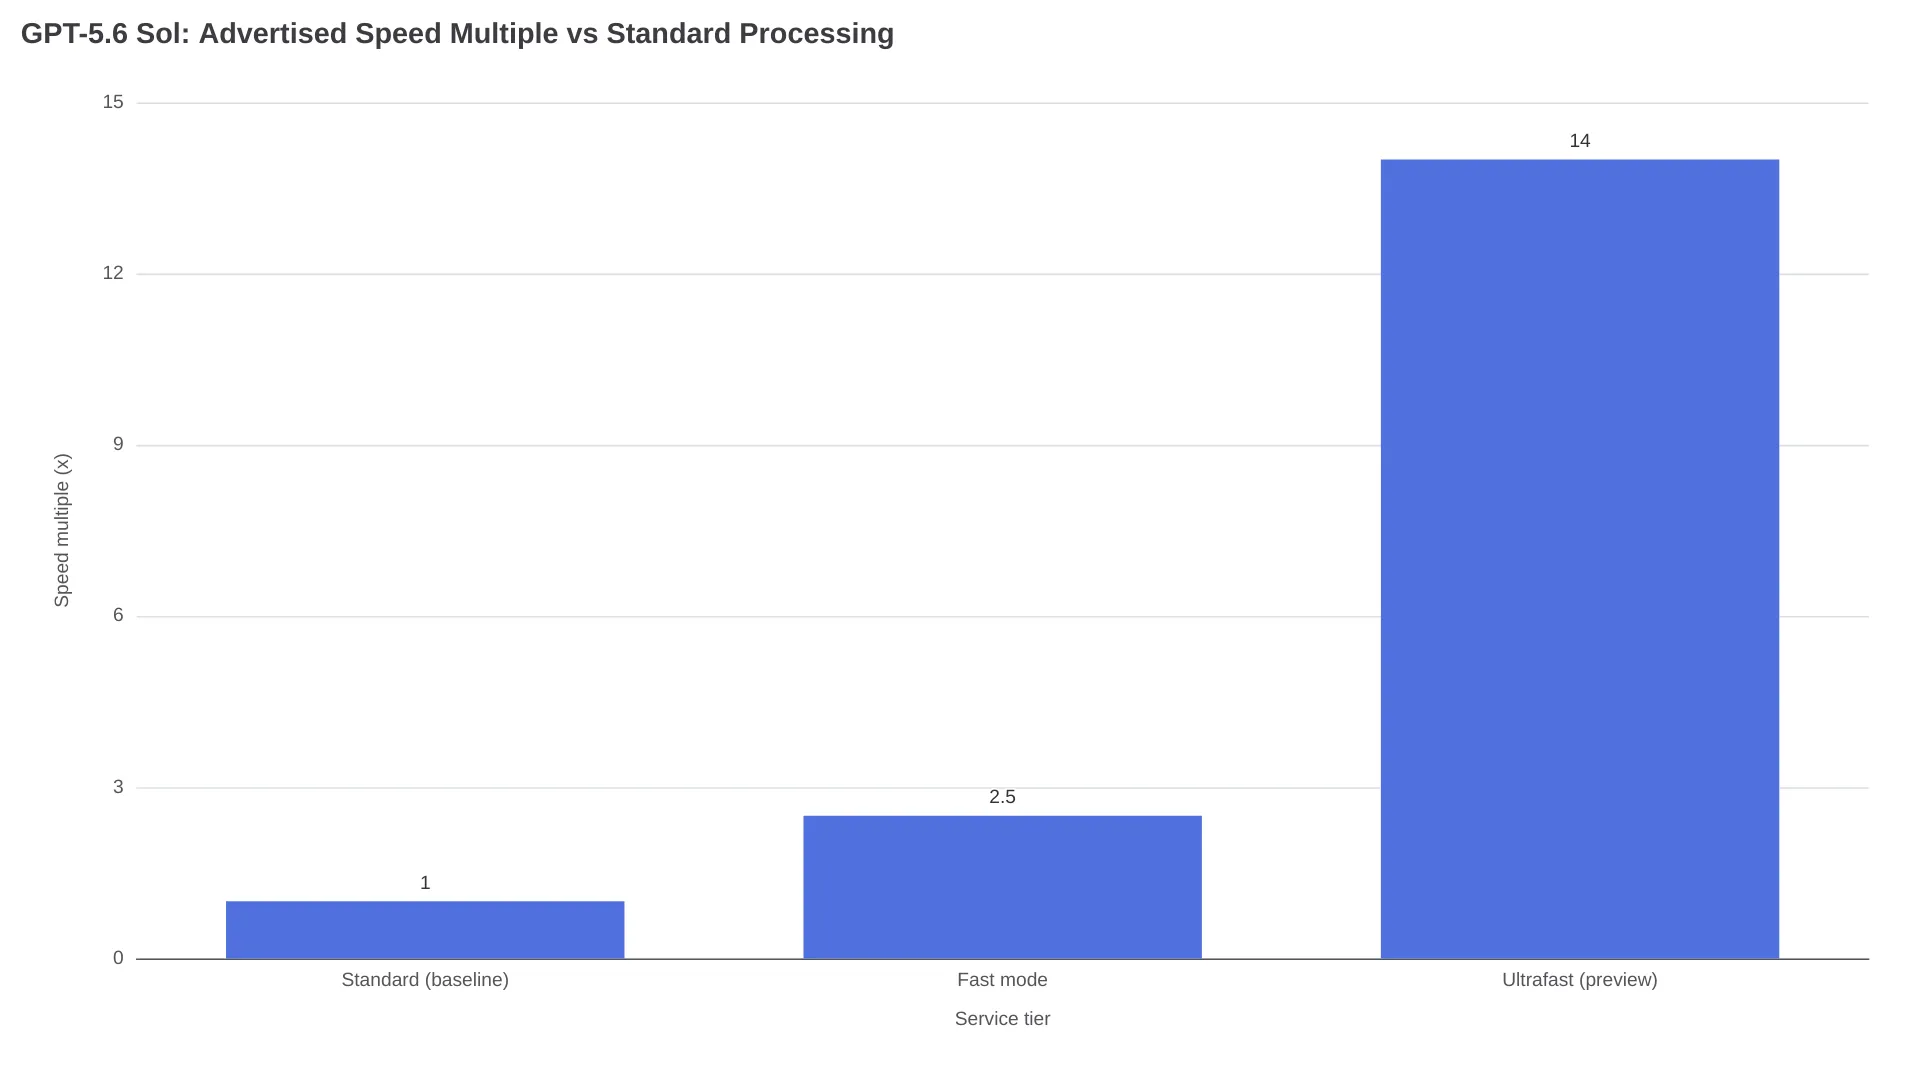
Önce önemli bir ölçüm notu: saniyede 750 token, ilan edilen çıktı üretim kapasitesi; Fast mode için verilen değer ise bir SLA alt sınırı. Metrikler ilişkili olsa da aynı şeyi ölçmüyor. 750'yi 14'e bölmek, Standard Sol'un saniyede yaklaşık 54 token ürettiğini gösteriyor. Buna göre 10.000 tokenlık bir çıktı Standard'da yaklaşık 186 saniye, Fast mode'un Enterprise SLA alt sınırı olan saniyede 80 token hızında en fazla 125 saniye, Ultrafast'te ise yaklaşık 13 saniye sürer.
| İş yükü | Standard (~54 tok/s, hesaplanmış) | Fast mode (SLA ≥80 tok/s) | Ultrafast (ilan edilen 750 tok/s) |
|---|---|---|---|
| 10.000 tokenlık çıktı | ~186 sn | ≤125 sn | ~13 sn |
| 5 turlu ajan döngüsü, tur başına 1.000 token | ~93 sn | ≤63 sn | ~7 sn |
r/AIToolsPerformance'da dolaşan rakamlar, karşılaştırmaları Artificial Analysis ve Cerebras'a atfediyor: Ultrafast'in Claude Fable 5'ten 11 kat, Fast mode'daki Opus 4.8'den ise 5 kat daha hızlı olduğu; 2.500 soruluk Humanity's Last Exam çalışmasını Fable 5'in 78 saat 27 dakikasına karşılık 11 saat 11 dakikada tamamladığı belirtiliyor. Bunların tamamı üretici tarafından bildirilen veriler; henüz bağımsız bir tekrar doğrulaması yok.
Önizleme Dışındakilerin Bilmediği Fiyat
Ultrafast için kamuya açık bir fiyat yok. Duyuruda herhangi bir ücret belirtilmedi ve topluluk da doğrudan bu boşluğa odaklandı. r/AIToolsPerformance'daki bir paylaşımın ifadesiyle: “Blogun söylemediği şey fiyat. Önizleme dışındaki hiç kimse bunun ne kadara mal olduğunu bilmiyor.”
Bugün eldeki temel referans, GPT-5.6 Sol için milyon token başına açıklanmış fiyatlandırma:
| Katman | Giriş (kısa bağlam) | Çıkış (kısa bağlam) | Giriş (uzun bağlam >272k) | Çıkış (uzun bağlam) | Önbellekli giriş |
|---|---|---|---|---|---|
| Standard | $5.00 | $30.00 | $10.00 | $45.00 | $0.50 |
| Fast mode | $10.00 | $60.00 | $20.00 | $90.00 | $1.00 |
| Ultrafast | açıklanmadı | açıklanmadı | açıklanmadı | açıklanmadı | açıklanmadı |
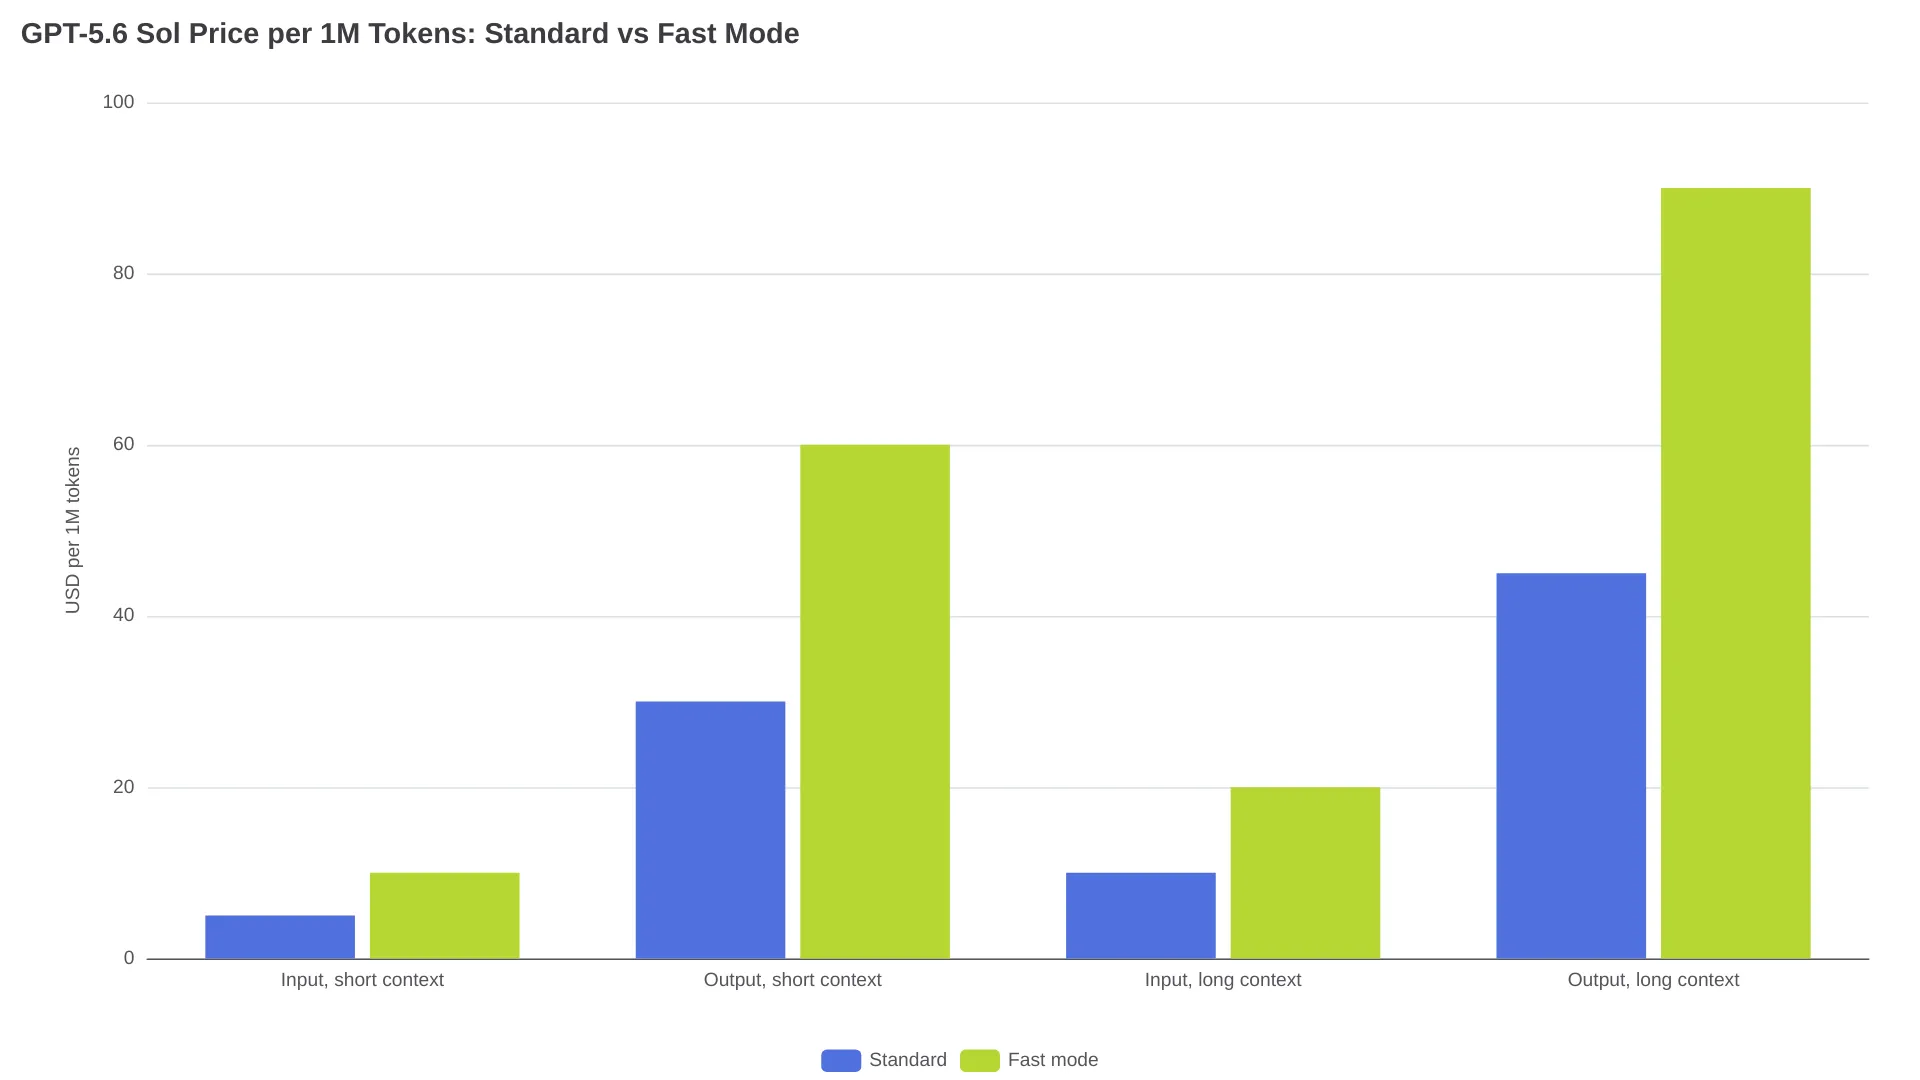
Fast mode, Sol için Standard fiyatının tam 2 katını alıyor; ancak kamuya açık bilgiler bu çarpandan hareketle Ultrafast fiyatı tahmini yapmaya yetmiyor. Fiyatlar iki yönde de değişebilir; örneğin OpenAI, 30 Temmuz'da Terra/Luna fiyatlarını düşürdü. Gecikme süresi bütçesi yapanlar için Fast mode'un ayrıntıları da önemli: dakikada 1 milyon tokenı aşar ve 15 dakikadan kısa sürede trafiği %50'den fazla artırırsanız, fazla istekler sessizce Standard katmanına düşürülür, service_tier="Default" döner ve Standard fiyatlarından ücretlendirilir.
Erişim Durumu: Bugün Nasıl Giriliyor?
Ultrafast erişimi herkese açık bir bekleme listesiyle değil, davet yoluyla ilerliyor. OpenAI, kapasite arttıkça önizlemenin genişleyeceğini belirtiyor ve duyuru sayfasında erişim güncellemeleri için kayıt formu sunuyor. Temmuz ayındaki haberler ise erken dönem Sol erişiminde yalnızca yaklaşık 20 kuruluş bulunduğunu yazmıştı.
Bu altyapının bir geçmişi var: OpenAI'nin Cerebras ortaklığı 14 Ocak 2026'ya uzanıyor ve 750 MW wafer-scale kapasite ayırıyor. Aynı donanımda GPT-5.3-Codex-Spark saniyede 1.000 tokenı zaten aşmıştı.
Davet Gelmeden Hızlı Çıktı Almak
Fast mode şu anda tüm API müşterilerinin kullanımına açık ve etkinleştirmek tek parametre eklemeyi gerektiriyor:
/v1/responsesveya/v1/chat/completionsüzerindeki isteğeservice_tier="fast"ekleyin.- Eski
service_tier="priority"değerleri çalışmaya devam ediyor. Mevcut modeller kullanım panellerinde hâlâpriorityolarak görünürken, GPT-5.6 sonrasındaki modellerdefastgösterilecek. - Tüm proje için varsayılan ayarlamak isterseniz Project settings -> Default Service Tier -> Fast yolunu izleyin.
| Fast mode modeli | 1M token başına fiyat (giriş / çıkış) | Gecikme SLA'sı |
|---|---|---|
| GPT-5.6 Sol | $10 / $60 | >80 tok/s |
| GPT-5.6 Terra | $4 / $24 | >70 tok/s |
| GPT-5.6 Luna | $0.40 / $2.40 | >100 tok/s |
Üç model içinde en yüksek SLA alt sınırı Luna'da. Önbellek okumaları giriş maliyetini %90 azaltıyor; yaklaşık 30 dakikalık TTL ile Standard Sol'da bu fiyat $0.50/M seviyesinde. Bu yüzden uzun ömürlü bir oturum, hangi katmanda olursanız olun yeni isteklerden daha avantajlı. Katmanları gerçek trafikle denemek için GPT-5.6 API endpoint, üç modelin tamamını tek arayüz üzerinden sunuyor.
Sık Sorulan Sorular
Ultrafast mode, ChatGPT veya Codex'te kullanılabiliyor mu?
Hayır. Ultrafast ilk olarak OpenAI API'de sunuluyor ve duyuruda ChatGPT ya da Codex erişimi için bir tarih verilmiyor.
GPT-5.6 Sol'u Cerebras üzerinde çalıştırmak çıktı kalitesini değiştiriyor mu?
OpenAI, Ultrafast'i farklı bir model olarak değil, aynı GPT-5.6 Sol'un daha hızlı sunulması olarak konumlandırıyor. Şu ana kadarki tek kalite iddiası, Cerebras'ın bildirdiği, kalite düşüşü olmadan 5.6 kat GDP-Val hızlanması. Bu sonuç henüz bağımsız bir benchmark tarafından tekrarlanmadı.
Ultrafast mode için gecikme SLA'sı var mı?
Yayınlanmış bir SLA yok. Fast mode, Enterprise müşterileri için >80 token/sn p50 SLA'sı ve %99.9 çalışma süresi sunuyor; Ultrafast için önizleme döneminde açıklanmış bir SLA bulunmuyor.
Ultrafast mode hangi modelleri destekliyor?
Yalnızca GPT-5.6 Sol. Terra ve Luna, Fast mode desteğine sahip ancak Ultrafast önizlemesine dahil değiller.
Ultrafast mode ne kadar tutacak?
Resmî bir fiyat açıklanmadı. Fast mode'un Standard Sol'a göre yayımlanmış 2 katlık fiyat farkı, eldeki tek referans noktası.