 AIREITER
Liquid AI, metin, görüntü, ses ve omni etkileşimi yaklaşık 2 milyar parametreli altı modele yayıyor. Ancak 27 Ekim 2026 itibarıyla Liquid'in kendi fiyat sayfasında LFM3 için bir tarife bulunmuyor. Bu eksik bilgi, LFM3'ün şu aşamada uygun fiyatlı bir uç cihaz uzmanı mı yoksa yalnızca indirip kendi altyapınızda barındıracağınız bir model ailesi mi olduğunu belirliyor.
LFM3 kısaca: Şimdilik API fiyatı olmayan altı adet 2B uzman model
LFM3, tek bir checkpoint değil; Liquid AI'ın cihaz üzerinde çalışacak uzman yapay zekâ çözümleri için geliştirdiği üçüncü nesil temel model ailesi. Tüm modeller, 22 trilyon token üzerinde önceden eğitilmiş LFM3-1.7B-Base omurgasını paylaşıyor. Ailede altı model var: LFM3-1.7B, LFM3-VL-2B, LFM3-Audio-2B, LFM3-Omni-2B, d1-2B ve d1-Omni-2B (duyuru).
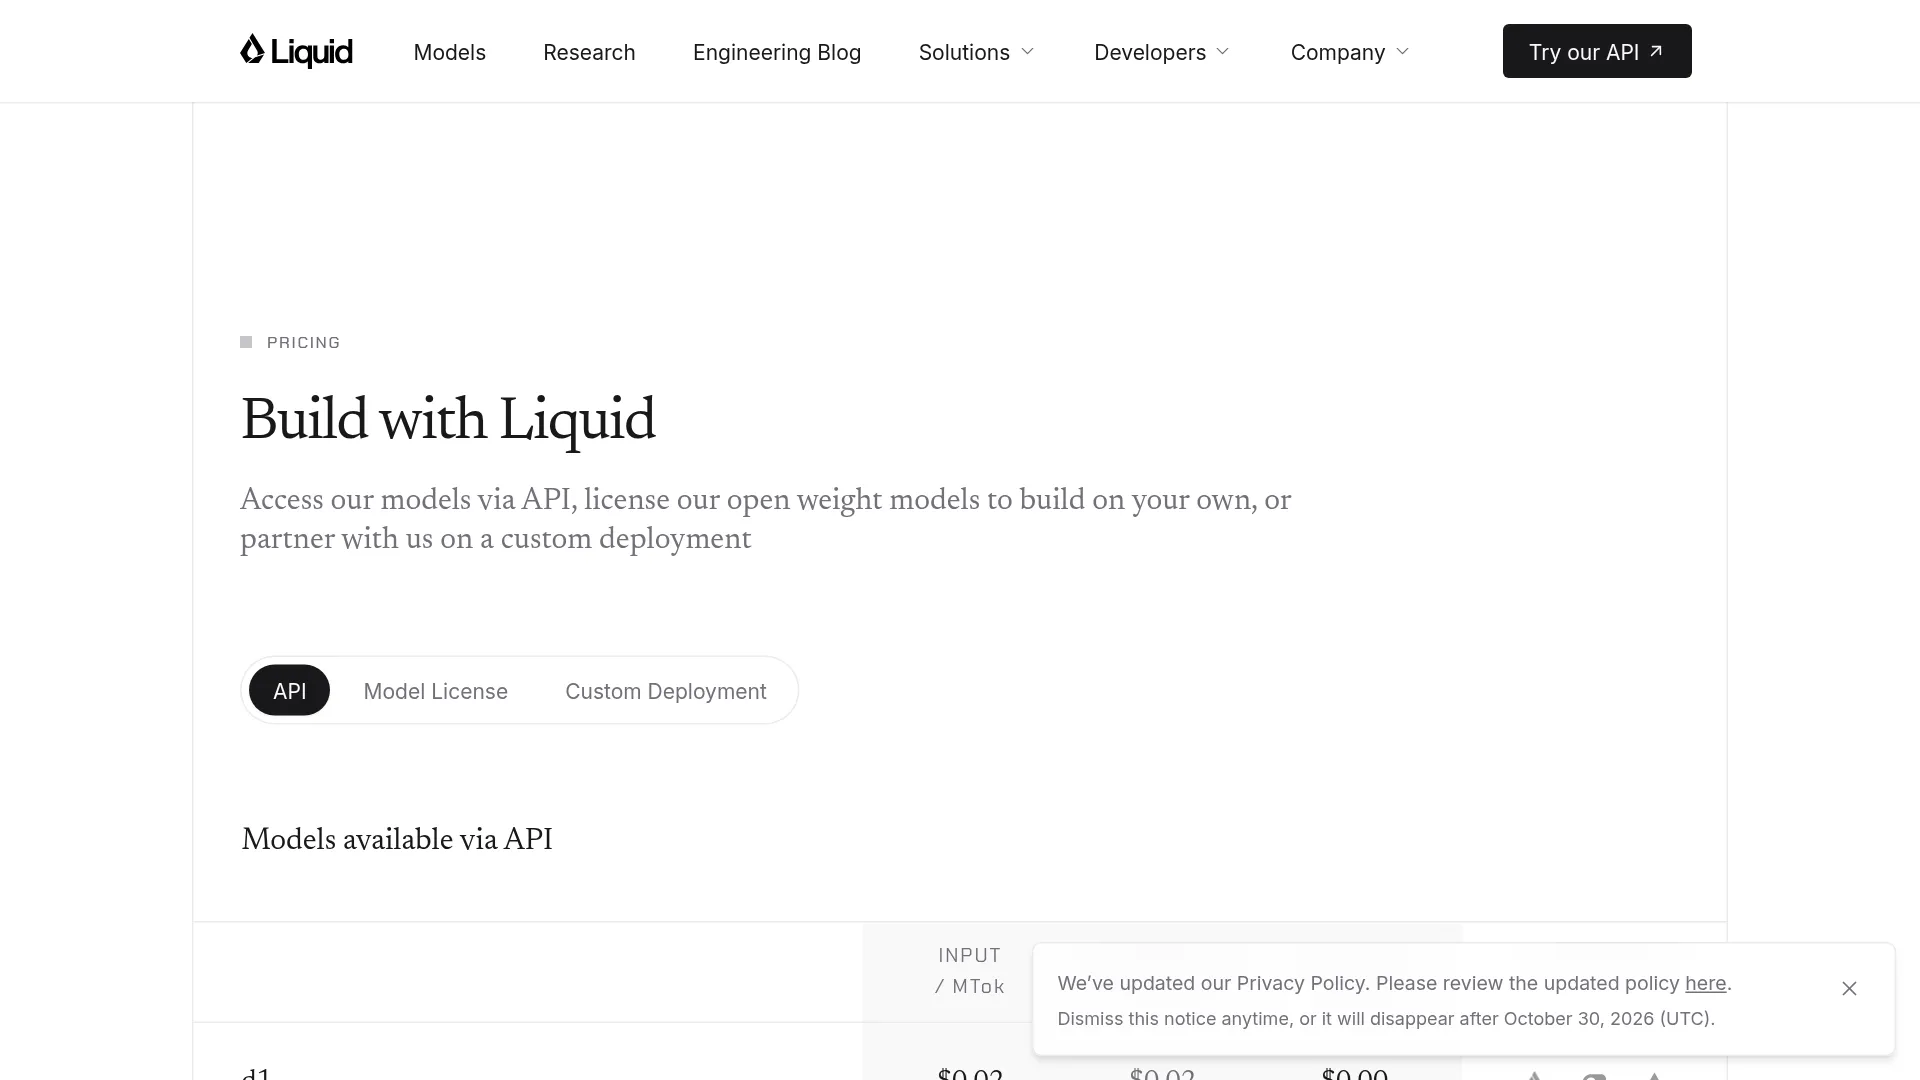
Liquid AI'ın fiyat sayfasını 27 Ekim'de kontrol ettim: LFM3 listede yok; yalnızca aşağıdaki tabloda yer alan d1, d1-ultra ve LFM2.5 tarifeleri bulunuyor. LFM3 duyurusunda ağırlıkların Hugging Face, Liquid Playground ve Liquid API üzerinden sunulduğu belirtiliyor. Ancak bugün doğrudan kontrol edilebilen seçenekler yalnızca ilk ikisi. Yeni kuruluşlara hâlâ $2 değerinde ücretsiz Liquid Console kredisi veriliyor (fiyatlandırma).
Altı modelin farkı: Hangi iş için hangisini seçmeli?
Altı LFM3 checkpoint'i aynı omurgayı kullanıyor; ancak kabul ettikleri girdiler ve ürettikleri çıktılar farklı.
| Model | Yaklaşık boyut | Girdiler | Çıktılar | Şunun için kullanın |
|---|---|---|---|---|
| LFM3-1.7B | 1.7B | Metin | Metin | Yerel ajanlar, araç çağrıları, yapılandırılmış çıktı |
| LFM3-VL-2B | 1.9B | Metin, görüntü, video | Metin | Görüntü ve video anlama, görsel ajanlar |
| LFM3-Audio-2B | 2B | Metin, ses | Metin, konuşma | Sesli sohbet, tanıma, sentez ve 18 dilde çeviri |
| LFM3-Omni-2B | 2B | Metin, görüntü, video, ses | Metin, konuşma | Birleşik çok modlu asistan |
| d1-2B | 2B | Metin, görüntü, video | Kalibre edilmiş yanıtlar | Sınıflandırma, veri çıkarma, tek geçişli kararlar |
| d1-Omni-2B | 2B | Metin, görüntü, video, ses | Kalibre edilmiş yanıtlar | Güven skorlarıyla çok modlu algılama |
LFM3-1.7B, 256K tokenlık bir bağlam penceresine ve 24 katmanlı üçlü hibrit mimariye sahip: 13 geçitli kısa evrişim katmanı, 256 tokenlık pencere kullanan 5 kayan pencere dikkat katmanı ve 6 global dikkat katmanı (duyuru). Son 3,5 trilyon tokenlık ara eğitim aşamasında ajan izleri ve araç çağrıları kullanılmış. Liquid'in metin modelini Hermes Agent, Pi ve OpenClaw benzeri çalışma katmanları için konumlandırmasının nedeni de bu (duyuru). LFM3-VL-2B, Liquid'in video girdisi alabilen ilk görsel modeli. LFM3-Omni-2B ise film müziğiyle kareleri birlikte işleyebilen ilk omni-modal modeli (duyuru).
Karar modelleri diğerlerinden farklı çalışıyor. d1-2B ve d1-Omni-2B, otoregresif üretim yapmak yerine tek bir ileri geçişte olasılıklarıyla birlikte kalibre edilmiş yanıtlar döndürüyor (duyuru). Üreticinin bildirdiği karar gecikmesi, d1-2B için NVIDIA H100 üzerinde 5.7 ms, AMD MI325X üzerinde 3.8 ms. 10 saniyelik ses klibi işlendiğinde d1-Omni-2B için bu değerler sırasıyla 12.4 ms ve 8.2 ms'ye çıkıyor (duyuru).
Liquid'in iddiaları ve bağımsız olarak doğrulanabilenler
Liquid AI'ın benchmark sonuçları üretici tarafından paylaşılan veriler. Bağımsız testler yayımlanana kadar bunları üretici iddiası olarak değerlendirmek gerekiyor. Aşağıdaki tüm rakamlar Liquid'in duyurusundan alınmıştır.
| Model | Üreticinin bildirdiği metrik | LFM3 sonucu | Önceki model / rakip sonucu |
|---|---|---|---|
| LFM3-1.7B | WebArena-Verified | 38.42 | 3.02 (LFM2.5-2.6B) |
| LFM3-1.7B | Boyut / hız | LFM2-1.2B'ye kıyasla 8K'da %35 daha az parametre, parametre başına yaklaşık %25 daha hızlı | — |
| LFM3-VL-2B | 62 görsel ortalaması / encoder | 71.4 ortalama; 2.2 kat daha az FLOP ile 164M encoder | 57.6 ortalama; Qwen3.5-2B encoder seviyesinde olduğu iddia ediliyor |
| LFM3-Audio-2B | UTMOSv2 / gecikme | 3.83; ilk token için minimum 50 ms; M4 Max CPU'da gerçek zamanın 87 katı | 3.22 (LFM2.5-Audio-1.5B) |
| d1-2B | ImajevBench | 75.5 | 64.0 (d1-3B) |
Doğrudan doğrulayabildiğim kısım şu: Hugging Face'teki LiquidAI LFM3 koleksiyonunda altı modelin tamamı quantized, MLX ve ONNX varyantlarıyla listeleniyor. LM Studio kataloğunda da LFM3 varyantları masaüstü kullanımına sunulmuş durumda. Puanları kesin sonuç değil, bir yön göstergesi olarak görmek gerek. Toplu ortalamalar OCR, grounding ve video alt testlerindeki farkları gizleyebilir. Ayrıca 4-bit için verilen 1GB değeri KV cache'i ve uygulama yükünü kapsamıyor.
"Günümüzde bir şeyleri ne kadar hızlı geliştirebildiğiniz gerçekten çılgınca." — @Nklockiewicz, MLX/ExecuTorch kullanarak iPhone'da uçak modunda LFM3 çalıştırırken 40 tok/s (kaynak)
"Genellikle hız ve zekâ açısından sınıflarından daha iyi sonuç veriyorlar; ancak benim deneyimimde henüz 'gerçek işler' için yeterince akıllı değiller." — u/spaceman_, r/LocalLLaMA (kaynak)
Üretime geçmeden önce okunması gereken $10M lisans sınırı
Liquid AI'ın açık ağırlık lisansı, şirket geliri yıllık $10 milyon seviyesini aşana kadar ücretsiz (fiyatlandırma). Geliştiriciler, araştırmacılar, kâr amacı gütmeyen kuruluşlar ve yıllık geliri $10M'nin altında kalan şirketler tüm açık LFM modellerini indirebilir, çalıştırabilir, ince ayar yapabilir ve üretimde kullanabilir. İnce ayar modellerini gizli tutabilir; ağırlıkları copyleft zorunluluğu olmadan mobil, uç cihaz veya şirket içi sistemlerde çalıştırabilir (fiyatlandırma).
Yıllık geliri $10M'nin üzerindeki şirketlerin, fiyatı dağıtım ölçeğine göre satış ekibi tarafından belirlenen ücretli kurumsal lisansa geçmesi gerekiyor. Araştırma, eğitim ve kâr amacı gütmeyen kullanımda gelir sınırı olmadan ücretsiz lisans devam ediyor (fiyatlandırma). LFM Open License, bu eşiğin üzerinde ücretsiz ticari kullanım hakkını sona erdiriyor. Ağırlıkları ticari bir uygulamaya gömmeden önce atıf, yeniden dağıtım ve ihracat koşullarını hukuk ekibinizle doğrulayın.
Yerelde çalıştırma: 1GB pratikte ne anlama geliyor?
LFM3-1.7B'nin 4-bit sürümü yaklaşık 1GB yer kaplıyor; ancak bu rakam yalnızca ağırlıkları ifade ediyor (duyuru). Çalışan süreç ayrıca çalışma zamanını, uzun bağlam için KV cache'i ve varsa görüntü ya da ses encoder'larını belleğe yüklüyor. Bu nedenle, özellikle video kareleri veya ses klipleri işleyen VL ve Omni sürümlerinde 1GB'ın üzerine ek RAM ayırmanız gerekir.
LFM3-1.7B ile başlayın; VL, Audio veya Omni sürümlerini yalnızca gerçekten ihtiyaç duyduğunuzda ekleyin. Benchmark öncesinde her model kartındaki ek bağımlılıkları kontrol edin. LFM3 için Ollama, LM Studio, llama.cpp, MLX ve ONNX seçenekleri Hugging Face koleksiyonunda ve LM Studio kataloğunda listeleniyor.
Bir model kartındaki örnek trust_remote_code=True gerektiriyorsa commit hash'ini sabitleyin, repo kodunu inceleyin veya önce izole bir ortamda çalıştırın. Çünkü bu seçenek, depoda gönderilen kodu çalıştırır. Liquid, duyurusunda 18 ses dilinden söz ediyor; ancak her dil için kalite tablosu paylaşmıyor. Bu nedenle İngilizce dışındaki çıktıları kendi verinizle test edin.
Şimdilik API erişimi: Nereden çağrılıyor, ücretlendirme nasıl?
LFM3 için API erişimi duyurulmuş olsa da Liquid'in herkese açık fiyat sayfasında ayrı bir tarife bulunmuyor. Sayfa çağrıları Liquid Console, OpenRouter ve Vercel AI Gateway üzerinden yönlendiriyor (fiyatlandırma).
| 27 Ekim'de listelenen API modeli | Girdi / MTok | Önbelleğe alınmış girdi / MTok | Çıktı / MTok |
|---|---|---|---|
| d1 | $0.02 | $0.02 | $0.00 |
| d1-ultra | $0.042 | $0.042 | $0.00 |
| LFM2.5-24B-A2B | $0.05 | $0.025 | $0.70 |
| LFM3-1.7B / VL / Audio / Omni metin tarifeleri | Listelenmiyor | Listelenmiyor | Listelenmiyor |
Şu an için fiyatlandırma açısından söylenebilecek net şey bu: LFM3'ü token başına bir ücret kalemi olarak değil, kendi altyapınızda çalıştırma maliyeti ve mühendislik zamanı olarak bütçelendirin. Bugün bir sağlayıcı LFM3 token fiyatı veriyorsa bunu listelenen d1 ve LFM2.5 taban tarifeleriyle karşılaştırın; ayrıca hizmetin Liquid Console'u proxy'leyip proxy'lemediğini veya kendi ağırlıklarını mı sunduğunu doğrulayın. Listelenen d1 çıktısının milyon token başına $0.00 olması, yüksek hacimli inceleme hatlarında d1'i potansiyel olarak cazip kılıyor.
LFM3 SSS
LFM3 API'si ne kadar?
Liquid AI, 27 Ekim 2026 itibarıyla LFM3 için ayrı bir token başı fiyat yayımlamıyor. Herkese açık sayfada yalnızca d1, d1-ultra ve LFM2.5-24B-A2B tarifeleri gösteriliyor.
LFM3 ticari kullanım için ücretsiz mi?
LFM Open License kapsamında yıllık geliri $10M'nin altında olan şirketler için ticari üretim kullanımı ücretsiz. Daha büyük şirketlerin ücretli kurumsal lisans alması gerekiyor.
LFM3 telefonda veya dizüstü bilgisayarda çalışır mı?
Evet. Metin modeli, çalışma zamanı yükü hariç yaklaşık 1GB 4-bit bellekle çalışabiliyor. Ollama, LM Studio, llama.cpp, MLX ve ONNX seçenekleri mevcut. VL, Audio ve Omni sürümleri ise encoder'lar ve medya işleme nedeniyle daha fazla belleğe ihtiyaç duyuyor.
Edge ajanları için LFM3, Qwen veya Gemma'dan daha mı iyi?
İncelediğim lansman günü sonuçlarında bağımsız bir karşılaştırma bulamadım. Liquid'in Qwen3.5-2B ve Qwen2.5-Omni-7B karşısındaki üstünlük iddiaları üretici tarafından paylaşılan sonuçlara dayanıyor (duyuru). Bu yüzden geçiş yapmadan önce LFM3'ü kendi çalışma katmanınızda Gemma ve Qwen ile test edin.
LFM3'ü tek GPU ile ince ayar yapabilir miyim?
Liquid; SFT, DPO, GRPO ve devam eden ön eğitim için notebook'lar sunuyor ve her modelin tek GPU üzerinde ince ayar yapılabildiğini belirtiyor (duyuru). Ancak gerekli VRAM veya veri kümesi boyutuyla ilgili gereksinimleri yayımlamış değil.
Uygun fiyatlı özel uzman mı, yoksa çalışma katmanınıza ihtiyaç duyan küçük bir genel model mi?
LFM3; verilerin cihazdan çıkmaması, medyanın yerel kalması veya yüksek işlem hacminin token başına bulut maliyetlerini pahalı hale getirmesi durumunda anlamlı bir seçenek. Buna karşılık geniş kapsamlı bilgi, uzun ve yaratıcı akıl yürütme ya da çalışma katmanı ayarı yapmadan doğrudan yüksek kalite bekleyenler için eksikleri var. Bir varyantı indirip kendi istemleriniz ve donanımınız üzerinde ölçün; kararı lansman grafiği değil, bu sonuç versin.