 AIREITER
Bir istem 100.000 tokenı aşana kadar Haiku 5.5, Sonnet 5.5'in yalnızca yirmide biri kadar maliyetli. Ancak bu sınır geçildiğinde fark 4 kata iniyor; ajan döngüleri de çoğu ekibin beklediğinden hızlı biçimde bu noktaya ulaşıyor. Kısa ve tekrarlanabilir API işleri için Haiku 5.5 yeterli. Hata ayıklama ve çok adımlı kodlama işlerinde ise Sonnet 5.5 hâlâ fiyat farkını hak ediyor.
Fiyat farkı 100K sınırına kadar 20 kat: kritik eşik burada
Claude Haiku 5.5 ve Claude Sonnet 5.5, kâğıt üzerinde aynı kapasiteyi sunuyor; ancak faturalandırma tarafında ciddi biçimde ayrışıyor. Her iki modelde de 1M token bağlam penceresi ve 128K token maksimum çıktı sınırı bulunuyor. Model kimlikleri ise claude-haiku-5-5 ve claude-sonnet-5-5. Anthropic'in Haiku 5.5 duyurusuna ve Sonnet 5.5 duyurusuna göre Sonnet 5.5, 28 Eylül 2026'da; Haiku 5.5 ise 7 Ekim 2026'da kullanıma sunuldu. Claude platformunun Sonnet 5.5 belgeleri de aynı 1M bağlam ve 128K çıktı sınırlarını listeliyor.
| Özellik | Claude Haiku 5.5 | Claude Sonnet 5.5 |
|---|---|---|
| Model kimliği | claude-haiku-5-5 | claude-sonnet-5-5 |
| Çıkış tarihi | 7 Ekim 2026 | 28 Eylül 2026 |
| Bağlam / maksimum çıktı | 1M / 128K | 1M / 128K |
| 100K altı girdi / çıktı | 1M başına $0.10 / $0.50 | 1M başına $2 / $10 |
| 100K üzeri istem | 1M başına $0.50 / $2.50 | 1M başına $2 / $10 (kademe yok) |
| Önbellek okuma | 1M başına $0.01 | 1M başına $0.10 |
| Varsayılan effort | medium | high |
Bunlar Anthropic'in liste fiyatları. APIKO'nun Anthropic fiyatlandırma özetine göre Haiku 5.5, istem tokenları 100.000'i geçtiğinde önbellek okuma ve yazma dahil olmak üzere isteğin tamamına yüksek kademeyi uyguluyor.
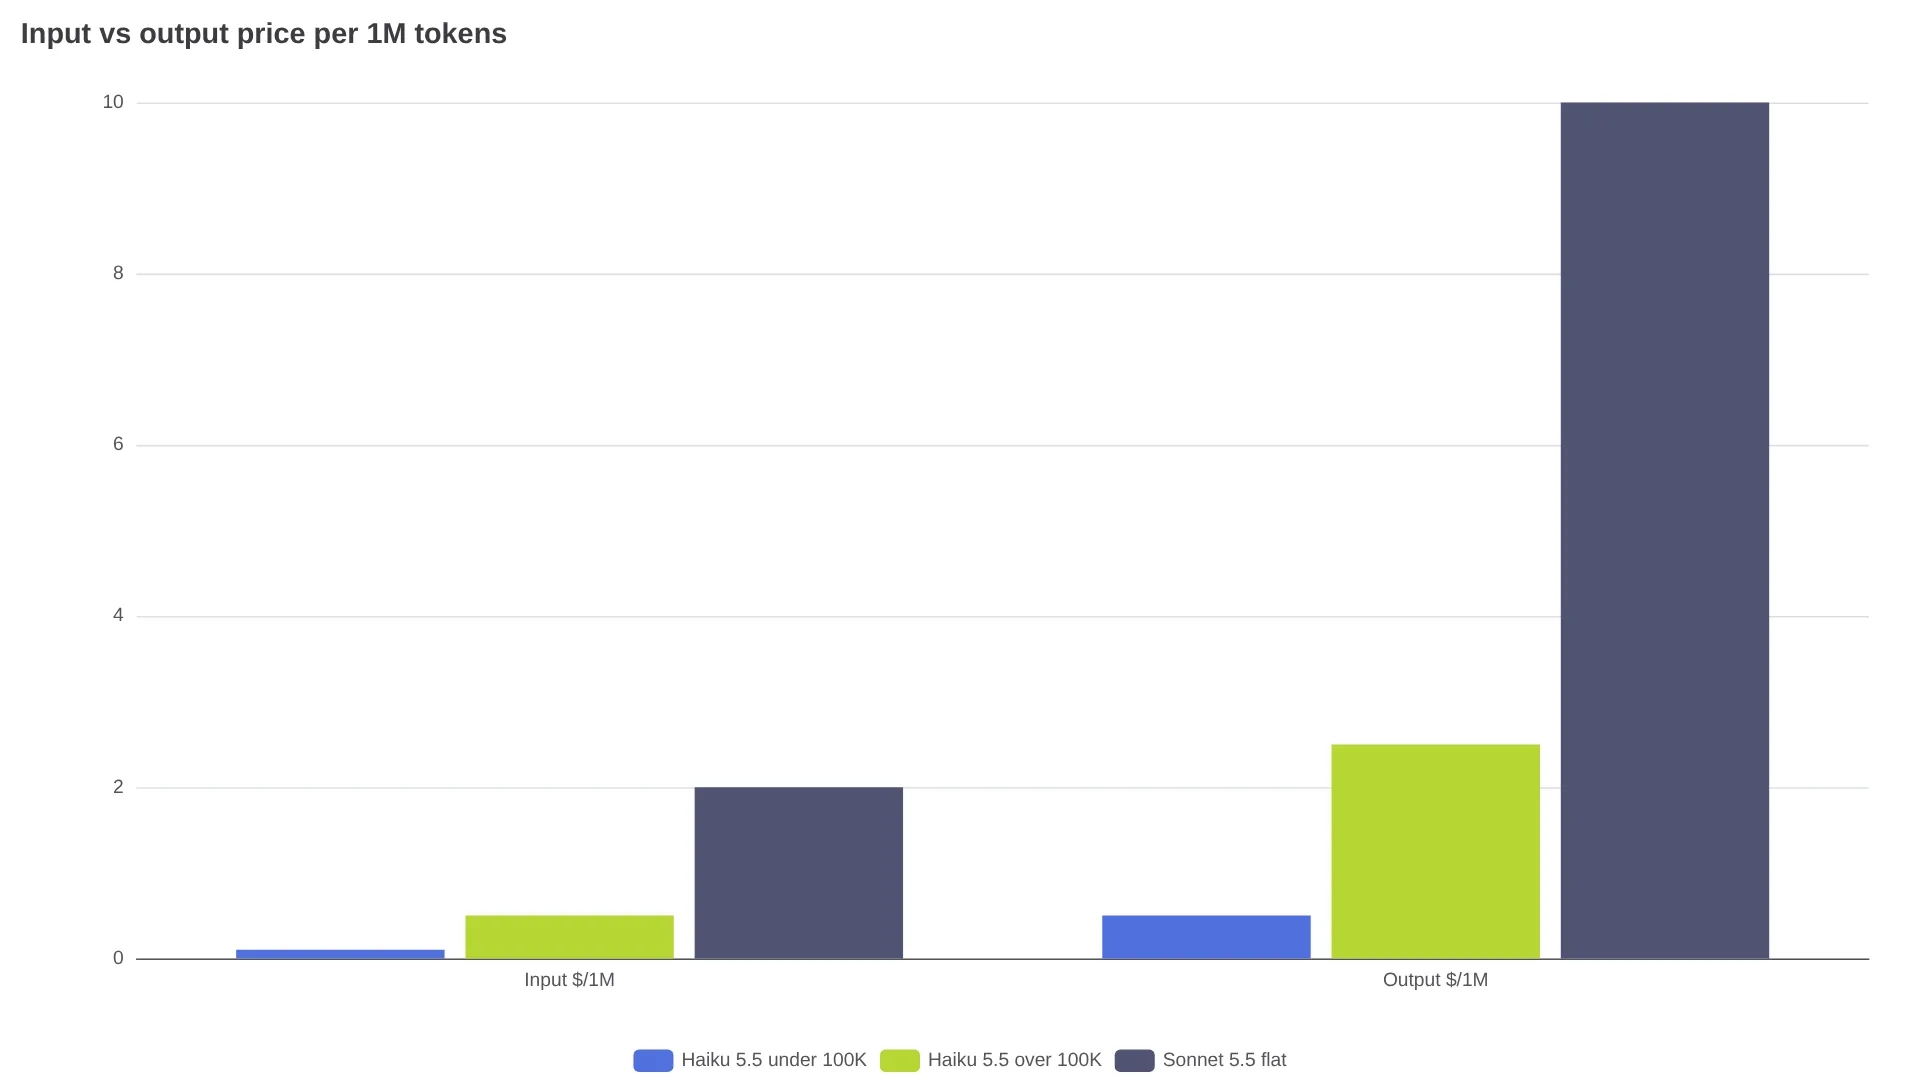
Her biri 99K token belge ve 1K çıktı içeren 1.000 özdeş belgenin işlenmesi, liste fiyatıyla yaklaşık $10.40 tutuyor (APIKO aynı işlem için kendi fiyatlarıyla $4.54 hesaplıyor). 101K tokenlık 1.000 belge ise liste fiyatıyla yaklaşık $53.00'a mal oluyor. Belge başına yalnızca 2.000 ek token, maliyeti beş katına çıkarıyor. Aynı 101K'lık işlem Sonnet 5.5'te yaklaşık $212.00 tutuyor. Bu hesap, APIKO'nun Haiku 5.5 ve Sonnet 5.5 testinde bildirdiği liste fiyatlarından yapıldı. Her çağrıda 10K girdi ve 1K çıktı bulunan 1.000 çağrılık örnek bir toplu işlem ise Sonnet 5.5'te $30.00, Haiku 5.5'te $1.50 tutuyor; bu da Sim'in Sonnet 5.5 ve Haiku 5.5 fiyat karşılaştırmasına göre %95 tasarruf anlamına geliyor.
Gerçek ajan döngüleri bu eşiğe farkında olmadan ulaşabiliyor. r/ClaudeAI'deki Haiku 5.5 token kullanımı başlığında bir kullanıcı, geçmiş ve araç çıktıları biriktikçe işlemlerin yaklaşık yirminci model çağrısında 100K sınırını geçtiğini aktardı. Sonraki 164 çağrının 145'i yüksek kademeden ücretlendirilmiş. Aynı başlıkta önerilen çözümler; işleri küçültmek, dosya kapsamını daraltmak, test çıktısını susturmak ve tek bir uzun konuşma yerine yeni alt ajanlar başlatmak. Kısa işler Haiku'da ucuz kalıyor. Uzun bağlamlı işlem hatlarında ise Sonnet maliyet hesabına baştan dahil edilmeli.
"Haiku 5.5'in düşük fiyatı yalnızca 100K bağlamın altında geçerli. 100K üzeri girdide fiyat 5 katına çıkıyor; çeviri ve özetleme gibi küçük işler tasarruf sağlıyor, uzun bağlamlı işler ise Sonnet kullanmalı." — @zookmas1314
Model odaklı daha kapsamlı incelemeler için Claude Haiku 5.5 API fiyatları ve Claude Sonnet 5.5 API incelemesi ve fiyatları yazılarına da göz atabilirsiniz.
Haiku 5.5 ve Sonnet 5.5 benchmark sonuçları hangi farkı gösteriyor?
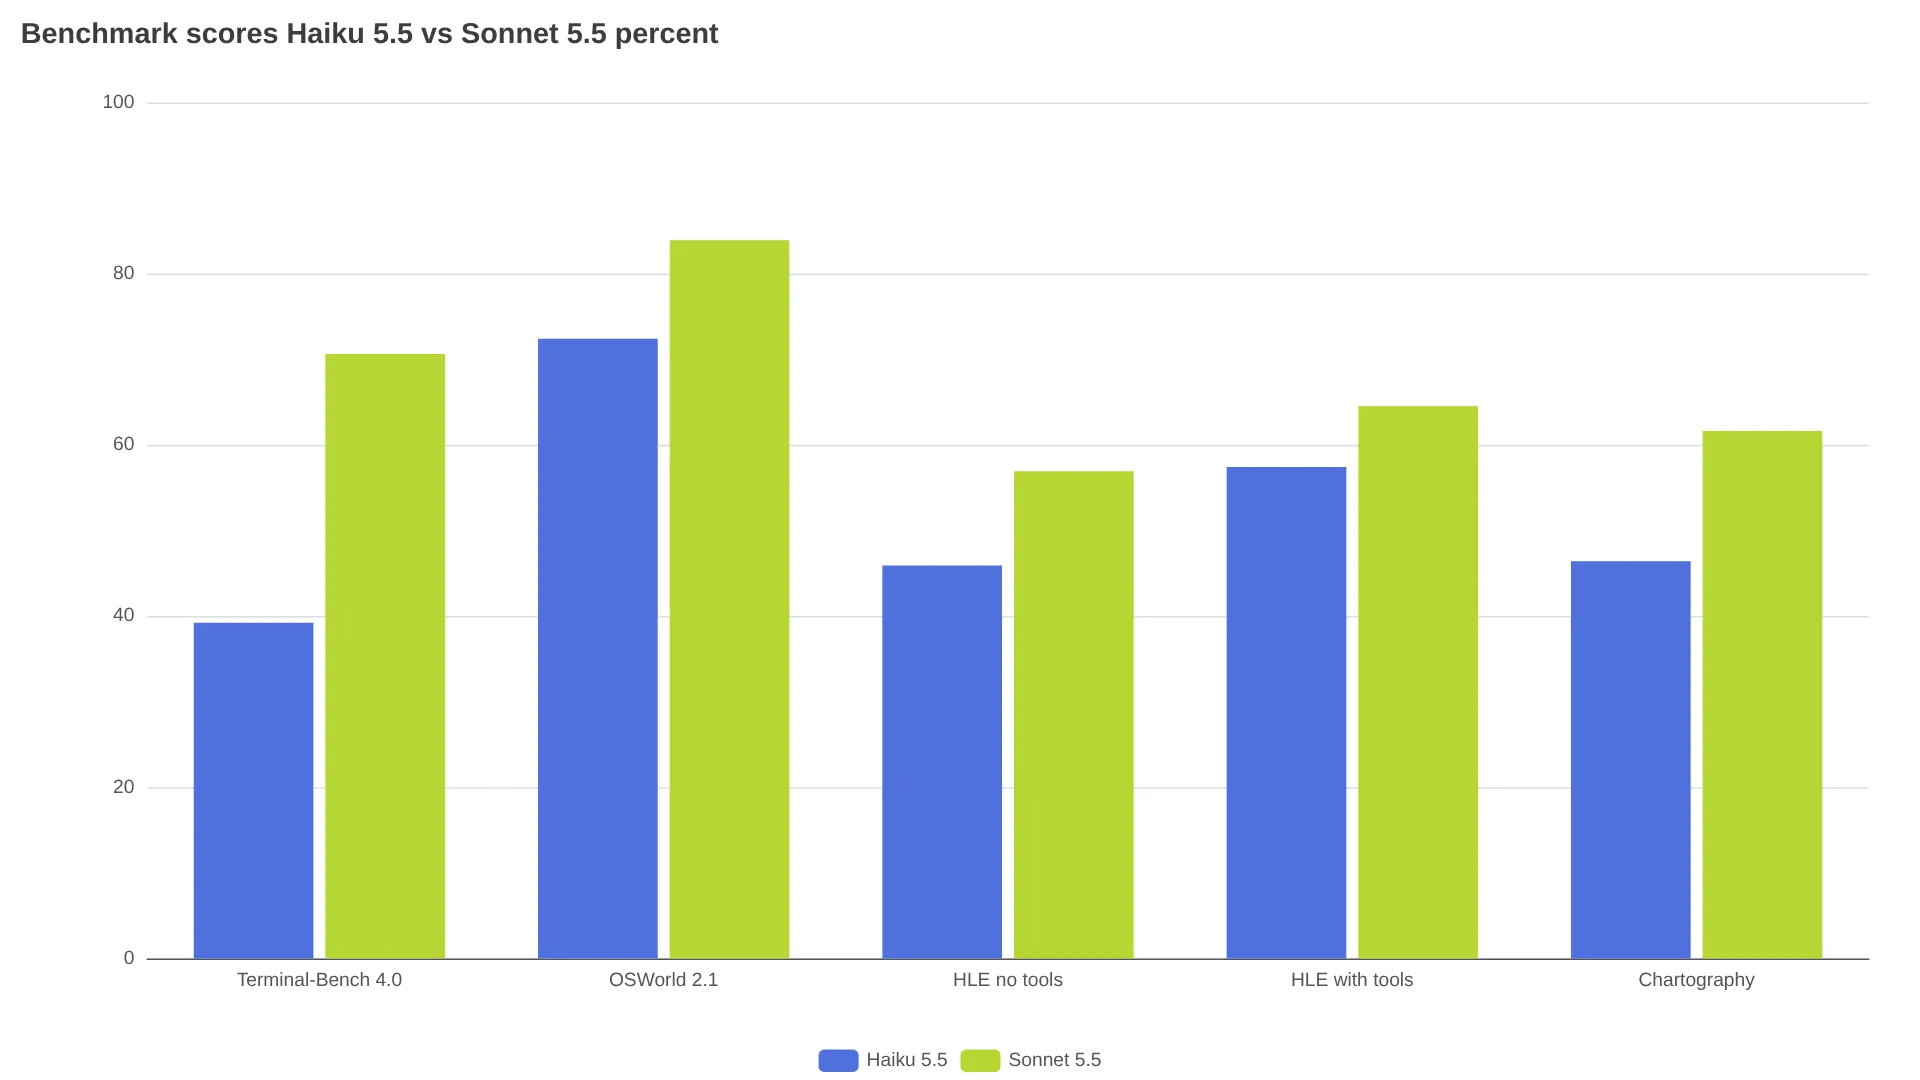
Anthropic'in yayımladığı benchmark sonuçlarında Sonnet 5.5, şirketin raporladığı tüm doğrudan karşılaştırmalarda önde. Fark, ajanların kod yazıp çalıştırdığı senaryolarda en belirgin hâline geliyor. Ajan tabanlı kodlama testi Terminal-Bench 4.0'da Haiku 5.5 %39.2, Sonnet 5.5 ise %70.6 sonuç veriyor. Bilgisayar kullanımı testi OSWorld 2.1'de fark daha dar: %72.4'e karşı %83.9. Araçsız Humanity's Last Exam sonuçları %45.9 ve %56.9; araçlarla birlikte ise %57.4 ve %64.5. Bu veriler, APIKO'nun karşılaştırmasında derlenen benchmark tablosundan alınmıştır.
Effort ayarları bu farkı daraltabiliyor veya büyütebiliyor. Aynı karşılaştırmada aktarılan Artificial Analysis sonuçlarında Haiku xhigh ve Sonnet medium, Intelligence Index'te 41 puanla neredeyse aynı Terminal-Bench sonuçlarına ulaşıyor (%29.3'e karşı %29.8). Buna karşın Haiku xhigh görev başına $0.12, Sonnet medium ise $0.48 tutuyor. Süreler sırasıyla 295 saniye ve 122 saniye. Bu veri setinde hiçbir Haiku yapılandırması, Sonnet'in varsayılan high ayarındaki 47 puana ulaşamadı. Bu maliyetler Haiku'nun 100K üzeri kademesini içermiyor; dolayısıyla uzun bağlamlı işler için bunları en düşük maliyet seviyesi olarak değerlendirmek gerekir.
Dar kapsamlı veri çıkarma ve sınıflandırma işlerinde Sonnet'in kodlama avantajına ihtiyaç yok. Buna karşılık ana kodlama ajanı, uzun araç döngüleri ve görsel akıl yürütme gerektiren işler (Chartography'de %46.4'e karşı %61.6) Sonnet'ten faydalanıyor. Tek bir Elo veya endeks puanını genel bir kalite sıralaması gibi okumayın. Bir Reddit testinde Haiku-medium, karma Rust ve eski kod tabanında Sonnet'le aynı sonucu $0.08'e karşı $1.68 maliyetle verdi. Aynı iş akışında Haiku-high ise kalite artışı sağlamadan 385 istek yaptı. Bu sonuçlar, r/ClaudeCode'un kontrollü Haiku 5.5 kodlama testinde paylaşıldı.
Model etiketi değil effort ayarı önemli: Haiku low ve Sonnet low
"Haiku çok uzun cevap veriyor" şikâyetlerinin önemli bir bölümü varsayılan effort ayarından kaynaklanıyor. Haiku 5.5 varsayılan olarak medium, Sonnet 5.5 ise high kullanıyor; düşünme yapılandırması da modele göre değişiyor. Belgelerde ve APIKO'nun davranış notlarında belirtildiği üzere Haiku, {"type": "disabled"} ile düşünmeyi kapatırken Sonnet, high ve altındaki effort seviyelerinde {"type": "between_tools"} kullanıyor. xhigh/max seviyelerinde ise adaptive veya belirtilmemiş thinking ayarı devreye giriyor. Ayrıntılar için Claude platform belgelerine ve APIKO'nun davranış notlarına bakılabilir.
APIKO'nun 10 Ekim 2026'da Messages endpoint'i üzerinden gerçekleştirdiği 22 görev ve 528 istekten oluşan değerlendirmede Haiku low 66 çalıştırmanın 65'ini geçti. Sonnet ise yapılandırmaya bağlı olarak 64 ila 66 aralığında kaldı. Bu kısa görevlerde Haiku'nun gateway maliyeti yaklaşık on sekizde birdi. Thinking'i tamamen kapatmak Haiku'nun sonucunu 56/66'ya düşürdü; başarısızlıklar ağırlıklı olarak akıl yürütme ve katı format gerektiren CSV toplamı ile kod izleme gibi görevlerde görüldü. Varsayılan medium ayarındaki Haiku 66/66 başarı sağladı; ancak çoğunluğu düşünme tokenlarından oluşan çıktı tokenları, Haiku low ayarının 4.4 katına çıktı.
Bu veriler ve kullanıcı deneyimleri ışığında pratik kurallar şöyle:
- Sınıflandırma, yönlendirme, veri çıkarma ve kısa JSON gibi sınırları belirli işlere Haiku'nun varsayılan
mediumayarıyla değil,lowile başlayın. - Amaç Haiku fiyat seviyesinde daha iyi kaliteyse Sonnet
low'a geçmeden önce Haikuhighveyaxhighayarlarını deneyin. APIKO'nun karşılaştırmasında aktarılan Artificial Analysis verilerine göre Haikumax, Sonnetlow'un 36 puanına karşı 43 puan aldı ve maliyet yaklaşık %60 seviyesindeydi. - Hata ayıklama, çok adımlı uygulama ve Haiku-high'ın ek gecikmesinin kalite kazandırmadığı uzun araç dizileri için Sonnet
mediumve üzerini ayırın. - Paylaşılan kodda thinking ayarını modele göre açıkça belirleyin. Haiku'ya
between_toolsveya Sonnet'edisabledgönderen tek bir şablon, APIKO'nun gateway testine göre upstream'den 400 hatası döndürüyor.
"Ana orkestratör ve inceleyici olarak Opus/Sonnet, angarya işleri yapan çalışan olarak da Haiku; her özellik için yeni bir Haiku örneği." — r/ClaudeAI'de u/ohrajaaa
Yönlendirmeyi zorluk seviyesine değil, sessiz hatanın sonucuna göre yapın
Doğru yönlendirme sorusu "Bu görev zor mu?" değil, "Haiku makul ölçüde hatalı davranır ve hiçbir inceleyici bunu fark etmezse ne olur?" olmalı. Alıntılanan çeşitli kullanıcı testlerinde aynı tablo ortaya çıkıyor: Haiku, yargı gerektiren işlerde sessizce hata yapabiliyor; doğrulamanın pahalı olduğu durumlarda ise Sonnet fiyat farkını karşılıyor.
| Görev şu özelliklere sahipse | Öncelikli model |
|---|---|
| Duygu sınıflandırma, ticket yönlendirme, izin bilgisini JSON'a çevirme, log özetleri, OCR ve açıklama, SQL seçimi, sıkıştırma alt ajanları | Haiku 5.5 |
| Kod tabanında arama, tek dosyalık düzenlemeler, tek turlu belge işleme | Haiku 5.5 |
| Ana kodlama ajanı, gerçek hata ayıklama, çok adımlı refactor, bilgi doğrulama, belge kaynaklandırma | Sonnet 5.5 |
Kullanıcılar, yüksek hacimli ve tek turlu Haiku iş akışlarında 3 kat hız ve ciddi kullanım azalması bildirdi. r/ClaudeAI'deki "Haiku 5.5 ne için en uygun?" başlığında bir kullanıcı, birkaç megabayt belgeyi birkaç dolara işlediği bir örnek de paylaştı.
Altı görevlik bir alt ajan karşılaştırmasında Haiku ucuzdu ancak araştırma ve olgusal yargı gerektiren işlerde belirgin biçimde daha az güvenilirdi. r/ClaudeCode'un Haiku, Sonnet ve Opus alt ajan testine göre bazı dosyalar atlanıyor ve sonuç dışarıdan "temiz bir çıktı gibi" görünüyordu. Aynı başlıktaki koruma kuralı oldukça net:
"Çıktı bir eylemi tetikliyorsa … ya daha büyük bir modele gönderilmeli ya da daha büyük bir model tarafından kontrol edilmeli." — r/ClaudeCode'da u/vladgladi
Üretim ortamları için bir uyarı daha var: Haiku'da yapılandırılmış çıktı uyumluluğu kendiliğinden garanti değil. APIKO değerlendirmesinde low ayarında katı format hatası kaydedildi; doğru etiketler çıplak bir dizi yerine JSON nesnesi içine sarılmıştı. r/ClaudeCode kullanıcıları da aynı kontrollü kodlama testinde düşük effort seviyelerinde doğrulamanın atlandığını ve kısıtlamaların göz ardı edildiğini bildiriyor.
Üretimde dayanıklı bir Haiku öncelikli kurulum
Kurulum kodu, APIKO'nun 10 Ekim tarihli, belgelenmiş kalıplara dayanan gateway testinde görüldüğü gibi modele özgü thinking ayarını, araç seçimini ve geçmişi doğru yönetmeli. Haiku zorunlu tool_choice kullanımını kabul ederken Sonnet bunu upstream'de reddediyor; Sonnet için auto veya yapılandırılmış çıktılar kullanılmalı. Ayrıca Haiku, Sonnet'in thinking bloklarını okuyamıyor. Geçmiş yalnızca sona eklenerek tutulursa Sonnet, Haiku'nun thinking bloklarını okuyabiliyor; düzenlenmiş Sonnet bloklarını yeniden oynatmak ise 400 hatasına yol açabiliyor.
Kullanıcıların bağımsız biçimde tekrar tekrar benimsediği Haiku öncelikli yaklaşım şöyle:
- İlk geçişte sınıflandırma, veri çıkarma veya taslak oluşturma için Haiku 5.5'i
loweffort ile çağırın. Thinking'i tamamen kapatmak içinthinking: {"type": "disabled"}kullanın. - Yalnızca izin verilen etiketleri veya şemaya uygun JSON'u kabul edin; belirsiz, geçersiz ya da sonuçları kritik olan her şeyi Sonnet 5.5'e,
mediumeffort ile yükseltin. - Alt ajanları taze ve geçici tutun: tek bir konuşmayı 100K'nın üzerine taşımak yerine her dosya veya özellik için yeni bir Haiku örneği kullanın.
- Çıktı bir eylemi tetikliyor, mesaj gönderiyor veya üretim kodunu değiştiriyorsa inceleyici olarak Sonnet ya da Opus kullanın.
"Ne yapılacağını ve kalitesini nasıl kontrol edeceğinizi biliyorsanız Haiku çok iyi." — r/ClaudeCode'da u/Awric
Anthropic, @ClaudeDevs üzerinden Haiku 5.5'i Sonnet veya Opus'un yanında özetleme gibi yüksek hacimli işlerde kullanılacak bir alt ajan olarak konumlandırıyor. Kullanıcıların paylaştığı bir başka kurulumda Haiku sürüleri repo araması yaparken Sonnet diff'leri ve testleri yönetiyor; bu yaklaşım @mirku21 tarafından aktarılmış.
Haiku 5.5 ve Sonnet 5.5 SSS
Haiku 5.5, Sonnet 5.5'ten ne kadar ucuz?
Liste fiyatında 100K istem tokenının altında 20 kat daha ucuz ($0.10/$0.50'e karşı 1M başına $2/$10), 100K'nın üzerinde ise 4 kat daha ucuz ($0.50/$2.50'e karşı $2/$10). Önbellek okumaları 1M başına $0.01'e karşı $0.10.
Haiku 5.5 ve Sonnet 5.5 aynı bağlam penceresine mi sahip?
Evet. Anthropic ve platform belgelerine göre her iki model de 1M token bağlam penceresi ve 128K maksimum çıktı sunuyor.
Haiku 5.5 üretimde API kullanımı için yeterli mi?
Dar kapsamlı, yüksek hacimli ve denetlenebilir işler için genellikle evet; özellikle de low effort ve şema doğrulamasıyla. Ana ajan kodlaması ve yoğun yargı gerektiren araştırmalarda ise kullanıcılar Sonnet 5.5'e kıyasla daha yüksek hata ve yanlış pozitif oranları bildiriyor.
Kodlama ajanları için hangi model daha iyi?
Ana ajan ve hata ayıklama için Sonnet 5.5 (Terminal-Bench'te %70.6'ya karşı %39.2). Arama, yazım ve tek dosyalık alt ajan işleri için ise Sonnet veya Opus inceleyicisi eşliğinde Haiku 5.5.
Haiku'nun 100K fiyat eşiğinin altında nasıl kalırım?
Belgeleri eşik aşılmadan bölün, alt ajanların kapsamını hedef dosyalarla sınırlayın, ayrıntılı test çıktılarını susturun ve her görev için yeni alt ajanlar başlatın. Ajan geçmişi yaklaşık 20 çağrıda 100K'yı aşabiliyor.
Bir konuşmayı ortasında Sonnet 5.5'ten Haiku 5.5'e taşıyabilir miyim?
Sorunsuz biçimde taşıyamazsınız. Haiku, Sonnet'in thinking bloklarını okuyamıyor; bu nedenle ya Sonnet'te kalmalı ya da Haiku'da yeni bir konuşma başlatmalısınız. Haiku geçmişini Sonnet'e taşımak ise geçmiş yalnızca sona eklenerek tutulduğu sürece akıl yürütmeyi koruyor.
Kaçınamayacağınız tek ödünleşim
| İş yükünüz şu özelliklere sahipse | Seçim | Nedeni |
|---|---|---|
| Yüzlerce sınıflandırma, veri çıkarma, özetleme ve JSON normalizasyonu | Haiku 5.5, low | Doğrulama kullanıldığında kısa görevlerde Sonnet'e yakın başarı oranı ve yaklaşık 1/18 maliyet |
| Tek bir büyük kod tabanı, uzun araç döngüleri, doğru yapılması gereken hata ayıklama | Sonnet 5.5 | Terminal-Bench'te 31 puanlık üstünlük ve daha az sessiz hata |
| 100K sınırını aşan belgeler | İki modeli de fiyatlandırın | Haiku'nun 5 katlık kademesi farkın çoğunu ortadan kaldırıyor; sınırın üzerinde Sonnet yalnızca 4 kat daha pahalı |
| Sessiz bir hatanın üretime çıkabileceği her iş | Haiku taslağı ve Sonnet incelemesi | Doğrulanmış başarı başına maliyet, nominal token fiyatından daha önemli |
Haiku 5.5 deneme başına fiyatıyla kazanıyor. Ancak inceleme ve yeniden çalıştırmalar token maliyetini belirlediğinde Sonnet daha ucuz hâle gelebilir. Yönlendirme sistemini bu ayrım üzerine kurarsanız iki model de kumar olmaktan çıkar.