 AIREITER
Kendi altyapınızda çalıştırabileceğiniz bir model arıyorsanız, iki seçenek arasında bugün için net bir fark var: MiniMax M3.1 Flash ağırlıkları indirilebilir durumda, Kimi K3.1 Pro ağırlıkları ise henüz yayımlanmadı. Moonshot, tam ağırlıkları 4 Kasım 2026'ya kadar sunacağını söylüyor. Dolayısıyla bu hafta self-hosted bir checkpoint'e ihtiyacınız varsa Hugging Face'ten çekebileceğiniz tek seçenek MiniMax.
Hugging Face'te şu an yalnızca MiniMax ağırlıkları var
MiniMax, M3.1 Flash ağırlıklarını yaklaşık 22–23 Ekim 2026 tarihlerinde Hugging Face'te minimax-community lisansıyla yayımladı. Lansman haberlerine göre model ModelScope üzerinden de erişilebilir durumda (Cocoloop). Kimi'nin resmi teknik blogu ise Kimi K3.1 Pro'nun bugün Kimi.com, uygulamaları, Kimi Code ve Kimi API üzerinden kullanılabildiğini; tam model ağırlıklarının ise 4 Kasım 2026'ya kadar geleceğini belirtiyor (kimi.com).
MiniMax M3.1 Flash ve Kimi K3.1 Pro: teknik tablo
MiniMax M3.1 Flash açık ağırlıkları, yaklaşık 428 milyar toplam parametreye ve token başına 23 milyar aktif parametreye sahip, yerel multimodal bir MoE model. Metin, görsel ve video alıyor; metin üretiyor ve 1M tokene kadar bağlam penceresi sunuyor (MiniMax'ın lansman yazısı). Kimi K3.1 Pro ise resmi olarak 1M token bağlam penceresine sahip, 3T sınıfı bir MoE şeklinde tanımlanıyor (kimi.com). Toplam 2.8T / aktif 104B parametre rakamları Moonshot'ın resmi açıklamasından değil, lansman haberlerinden geliyor (ArtificialWatch, ExplainX).
| Başlık | MiniMax M3.1 Flash | Kimi K3.1 Pro |
|---|---|---|
| Toplam / aktif parametre | ~428B / token başına 23B | 3T sınıfı; lansman haberleri 2.8T / 104B aktif bildiriyor |
| Hugging Face deposu | MiniMaxAI/MiniMax-M3.1-Flash, yayında | 24 Ekim 2026 itibarıyla yok; 4 Kasım'a kadar bekleniyor |
| İndirme boyutu | Yaklaşık 252 GB | Bilinmiyor; MiniMax'ın yoğunluğunda (~parametre başına 0.59 GB) 2.8T'lik bir checkpoint TB sınıfında olur |
| Bağlam | 1M tokene kadar (kuruluma bağlı) | 1M token |
| Girdi / çıktı | Metin, görsel, video girişi; metin çıktısı | Multimodal, metin çıktısı; self-hosted kullanımda kesin modaliteler doğrulanmış değil |
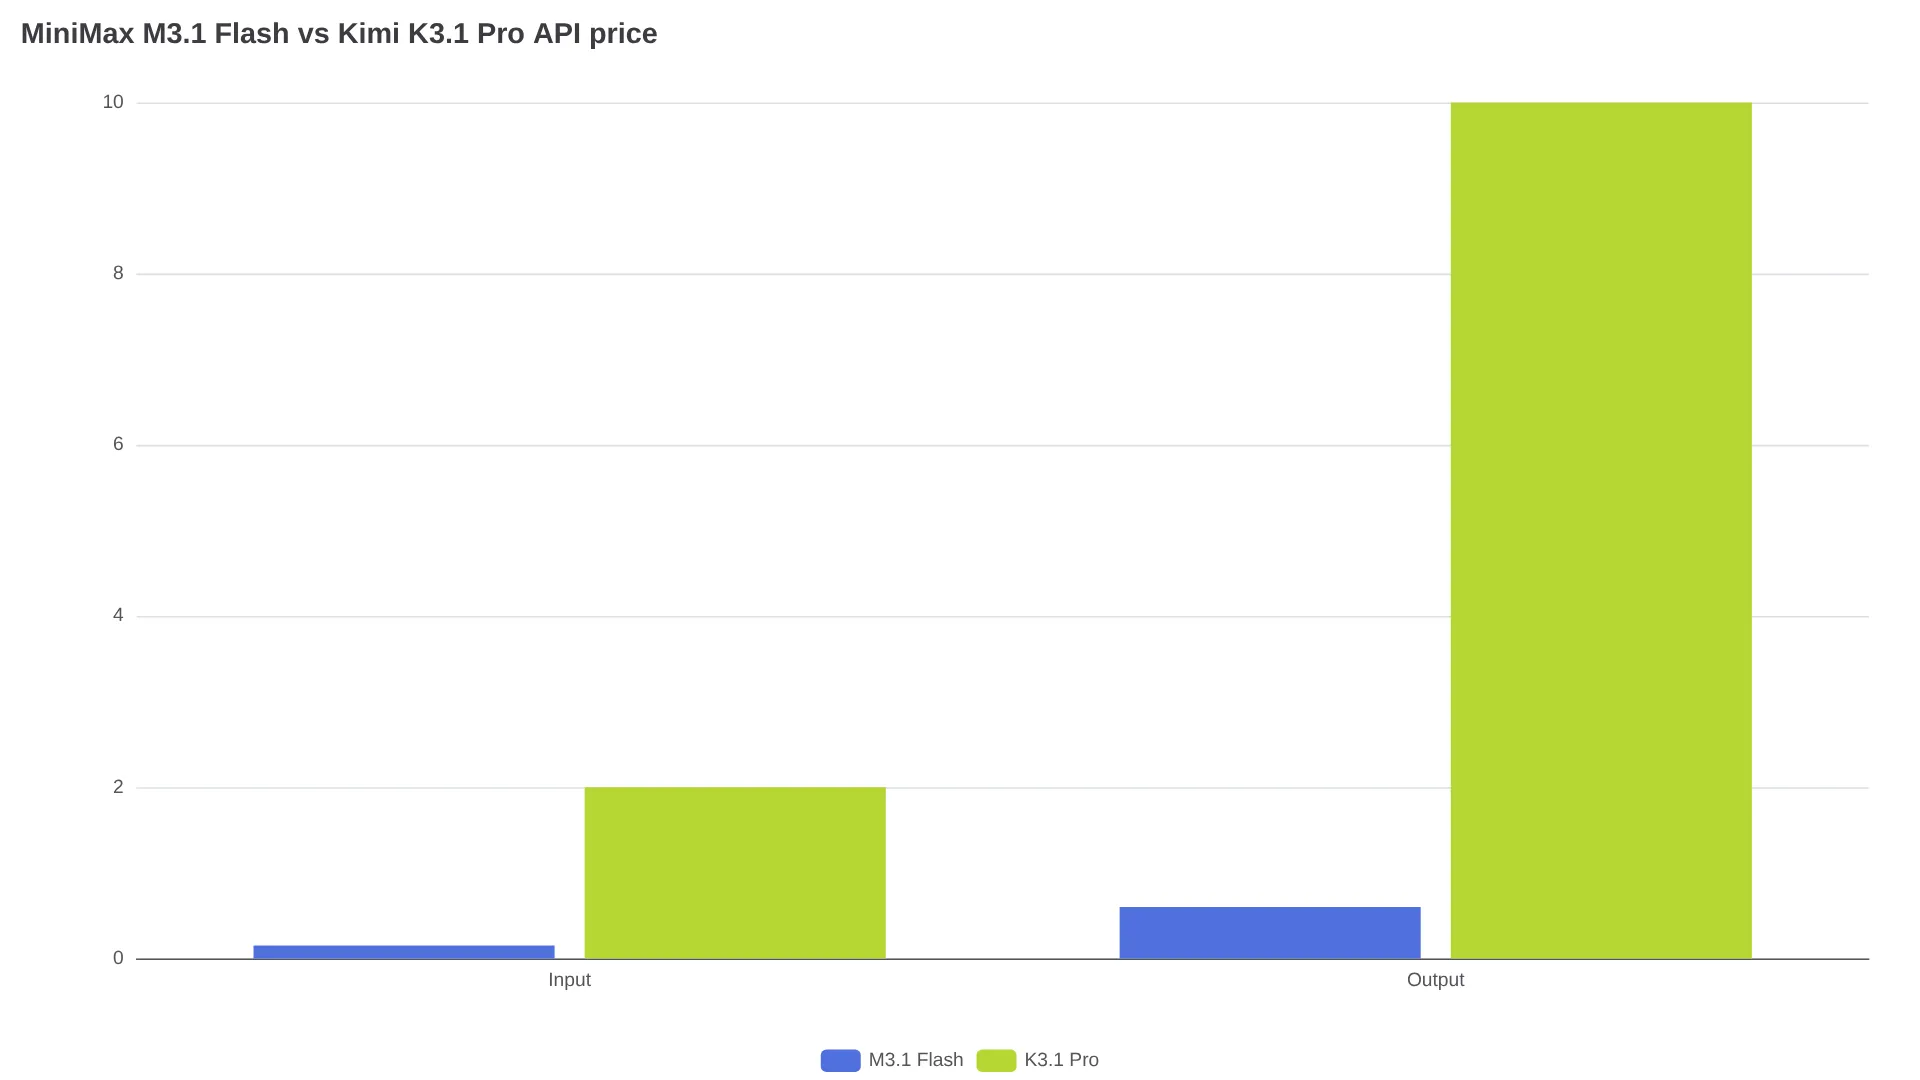
| Resmi API fiyatı | 1M token başına $0.15 girdi / $0.60 çıktı / $0.015 önbellekli girdi (MiniMax) | 1M token başına bildirilen $2 girdi / $10 çıktı (ArtificialWatch) |
| Serving seçenekleri | SGLang, vLLM, TokenSpeed; çoklu çip için FlagOS | Henüz açıklanmadı; API model kimlikleri kimi-k3.1-pro / kimi-k3.1-pro-highspeed (Kimi dokümantasyonu) |
| Önerilen örnekleme | Temperature 1.0, top-p 0.95; reasoning için low–max | Kimi benchmark yapılandırmasına göre maksimum reasoning effort, temp 1.0, top-p 0.95 |
MiniMax checkpoint'ini resmi komutla indirmek için:
hf download MiniMaxAI/MiniMax-M3.1-Flash --local-dir MiniMax-M3.1-FlashBenchmark'a başlamadan önce eksiksiz dosya setinin yanı sıra DSpark draft head, tokenizer ve yapılandırma dosyalarının da geldiğini kontrol edin. MiniMax, sonuçların resmi ağırlıklar için geçerli olduğunu; üçüncü taraf quantization sürümlerinin farklı davranabileceğini özellikle belirtiyor.
Aşağıdaki benchmark sonuçlarında, bağımsız olarak işaretlenmeyen her rakamı üretici beyanı olarak değerlendirmek gerekiyor:
| Benchmark | M3.1 Flash (üretici) | Üreticinin kıyasladığı rakip |
|---|---|---|
| Automation-Bench v1.0.6 | 62.8 | DeepSeek V4.1 Flash-1017: 60.5 |
| BankerToolBench | 76.2 | Opus 5: 76.2 (berabere) |
| LOCA-Bench 256K | 60.3 | GPT-5.6 Sol: 60.0 |
| DeepSWE v1.1 | 73.7 | DeepSeek V4.1 Flash-1017: 77.0 |
| OSWorld 2.0 | 61.7 | Opus 5: 70.6 |
| Terminal-Bench 4.0 | 38.1 | Opus 5: 51.8 |
Atıf yapılan bağımsız bir anlık değerlendirme, M3.1 Flash'ı %53.78 ile orta grupta, 26 model arasında 16. sırada gösteriyor; uzun soluklu görev skorları ise zayıf (Vals). Kimi'nin kendi grafiği, K3.1 Pro'nun Agents' Last Exam (43.2) ve SWE Marathon (51.7) dahil gösterilen 14 testin 6'sında lider olduğunu iddia ediyor. Terminal-Bench 4.0 sonucu da 65.7.
252 GB'lık indirmeyi çalıştırmanın maliyeti
Depo yaklaşık 252 GB yer kaplıyor. Parametre başına 4 bit hesapla yalnızca 428B parametre yaklaşık 214 GB ediyor; buna KV cache ve çalışma zamanı tamponları dahil değil. Kullanılabilir bir bağlam uzunluğu için birkaç adet 80 GB sınıfı GPU planlamak gerekiyor. NVIDIA'nın RTX Spark hesabı, yerel çalıştırma için DGX Station'ı veya 4x DGX Spark 128 GB kümesini işaret ediyor (X gönderisi). X'teki self-hoster kullanıcıları da 252 GB'lık indirme ve bu donanım eşiğinin sıradan masaüstlerini devre dışı bıraktığını, buna karşılık API'nin ucuz kaldığını belirtiyor (@bufcapy).
Önce API tarafındaki hesabı yapmak mantıklı, çünkü MiniMax API olağan dışı derecede ucuz. 1M token başına $0.15 girdi ve $0.60 çıktı fiyatıyla, günde 10M girdi + 2M çıktı token tüketimi 10 × $0.15 + 2 × $0.60 = $2.70, yani ayda yaklaşık $81 tutar.
Başabaş hesabı, aylık küme maliyetinin token başına API maliyetine bölünmesiyle yapılır. 1M girdi token için $0.15 fiyatında, aylık her $150 kiralama bedeli 1B girdi tokene eşittir; 1M çıktı token için $0.60 fiyatında ise aylık her $600, 1B çıktı tokene karşılık gelir. Kendi kiralama teklifinizi ve mühendislik süresini buna ekleyin: self-hosting ancak bu oranlardaki aylık API faturanız toplam maliyeti aştığında veya politikalar ağırlıkların kendi sınırlarınız içinde kalmasını gerektirdiğinde avantajlıdır. Kimi tarafında fark daha da büyük: bildirilen 1M token başına $2/$10 API fiyatı, barındırılan seçeneği girdi için MiniMax'ın yaklaşık 13 katına, çıktı için yaklaşık 17 katına çıkarıyor. Bu nedenle gelecekteki 2.8T parametreli bir checkpoint'in TB sınıfı depolamayı ve çok düğümlü kümeyi haklı çıkarması için çok yüksek, sürekli bir throughput sunması gerekir.
İlk günden self-hosting ile neler mümkün?
İlk gün framework desteği var, ancak eksiksiz değil. Model kartı SGLang, vLLM ve TokenSpeed'i; çoklu çip kurulumu için de FlagOS'u listeliyor. SGLang için Docker imajları bulunurken Transformers, KTransformers, unsloth ve ATOM entegrasyonları yayımlandığı sırada hâlâ geliştiriliyordu. Bir dağıtım yapan kullanıcı, vLLM için H100/H200 örnek yapılandırmasının tam 1M yerine 256K token hedeflediğini; video girdisini kapattığını ve DSpark speculative decoding'i etkinleştirmediğini not etti (@sancaksofttech). İndirilen ağırlıklar aynı olsa da her kurulum tüm özellikleri açmıyor.
r/LocalLLaMA'da sık dile getirilen kaygı şu: "Flash", küçük model boyutunu değil, inference ekonomisini anlatıyor:
Quantization ile 256GB'a sığar mı? Umut ediyorum — u/BawbbySmith, r/LocalLLaMA
Donanımdan önce lisans şartlarına bakın
M3.1 Flash açık ağırlıklı bir model; açık kaynak değil. Depodaki LICENSE dosyası, yani minimax-community lisansı (LICENSE dosyası), ticari olmayan kullanıma serbestçe izin veriyor. Ticari kullanımda görünür biçimde "Built with MiniMax M3.1-Flash" ibaresi yer almalı ve MiniMax'a tek seferlik bildirim yapılmalı. Yıllık geliri $20M üzerindeki kurumlar veya ürünler için önceden yazılı izin gerekiyor; askeri kullanım ise yasak.
Bu şartlar kurum içi araçlar için hafif bir yük olabilir, ancak rozeti gösterme zorunluluğu ve gelir eşiği ticari barındırma senaryolarında engel yaratabilir. Kimi'nin lisansı, 4 Kasım'da ağırlıklar yayımlanana kadar bilinmiyor. Moonshot ayrıca teknik blogunda, siber güvenlikle ilgili eğitim verileri açık ağırlıklardan çıkarıldığı için açık checkpoint'in API modelinden farklı olacağını açıkladı (kimi.com). Bir şey geliştirmeden önce iki modelin de LICENSE dosyasını okuyun.
Hangi senaryoda hangisi mantıklı?
| Senaryonuz | Tercih |
|---|---|
| Bu hafta yerel değerlendirme, fine-tuning tabanı veya air-gapped dağıtım için ağırlığa ihtiyacınız varsa | MiniMax M3.1 Flash — ikisi arasında indirilebilir tek seçenek |
| Değişken yüklü, maliyete duyarlı kodlama ajanları | $0.15/$0.60 ile MiniMax API — ancak sürekli yüksek hacimde self-hosting'e geçin |
| En ileri uzun soluklu kodlama görevleri için bekleyebiliyorsanız | Şimdi Kimi K3.1 Pro API'yi değerlendirin; 4 Kasım'da ağırlıklar, lisans ve gerçek boyut geldiğinde self-hosting kararını verin |
| Ticari barındırılan ürün | Önce hukuk ekibiyle MiniMax'ın atıf ve $20M izin eşiğini netleştirin; lisansı yayımlanana kadar Kimi için karar verilemez |
| Tüketici GPU'su veya tek Mac | Atıf yapılan kaynaklarda doğrulanmış tek cihaz tarifi yok — desteklenmeyen bir kurulumu test etmeye hazır değilseniz API kullanın |
Sık sorulan sorular
Resmi MiniMax M3.1 Flash ağırlık indirmesi nerede?
Resmi depo, Hugging Face üzerindeki MiniMaxAI/MiniMax-M3.1-Flash. ModelScope'ta da bir ayna bulunuyor; indirme komutu ise hf download MiniMaxAI/MiniMax-M3.1-Flash --local-dir MiniMax-M3.1-Flash.
Resmi bir Kimi K3.1 Pro Hugging Face deposu var mı?
Hayır. 24 Ekim 2026 itibarıyla herkese açık bir K3.1 Pro ağırlık deposu yok. Moonshot'ın teknik blogu, tam ağırlıkların 4 Kasım 2026'ya kadar yayımlanacağını taahhüt ediyor.
MiniMax M3.1 Flash'ı ticari olarak kullanabilir miyim?
Evet, belirli şartlarla: "Built with MiniMax M3.1-Flash" ifadesini göstermeli, tek seferlik bildirim göndermeli ve yıllık gelir $20M üzerindeyse önceden yazılı izin almalısınız. Askeri kullanım yasak. Hukuki danışmanınızla birlikte depodaki LICENSE dosyasını teyit edin.
Tüketici GPU'sunda veya Apple Silicon'da çalışır mı?
Atıf yapılan dağıtım rehberlerinde, tek tüketici GPU'su için doğrulanmış bir kurulum bulunmuyor. Tahminler, quantize ağırlıklara ek olarak KV cache için de birkaç adet 80 GB GPU gerektiğini gösteriyor. NVIDIA, DGX Station'ı veya 4x DGX Spark 128 GB kümesini işaret ediyor.
Bugün vLLM veya SGLang ile çalışıyor mu?
İkisi için de ilk gün tarifleri mevcut; ayrıca çoklu çip çalıştırmaları için TokenSpeed ve FlagOS var. Ancak örnek yapılandırmalar bağlamı 256K ile sınırlayabilir, video girdisini kapatabilir veya DSpark'ı devre dışı bırakabilir. Donanımınız için model kartındaki güncel tarifi kontrol edin.
Self-hosted kullanımda tam 1M bağlam kullanılabiliyor mu?
İlan edilen üst sınır 1M token, ancak pratikte erişilebilen uzunluk GPU belleğine ve serving yapılandırmasına bağlı. Uzun bağlam iş yüklerinde KV cache için gereken boşluğu ayrıca bütçeleyin.
İlgili okumalar: MiniMax M3.1 Flash Açık Ağırlıkları: İndirme, Çalıştırma ve Maliyet Rehberi, Kimi K3.1 Pro API Fiyatlandırma Rehberi, Kimi K3 Açık Ağırlıkları