 AIREITER
19 Ağustos 2026'da Liquid AI, LFM2.5-2.6B deposuna mevcut dosyanın yanına aynı boyutta, neredeyse aynı isimde ikinci bir 1,59 GB'lık Q4_0 dosyası ekledi. Ancak bu iki dosya aynı model değil. Quantization-aware distillation'ın kısaltması olan QAD, 4 bit nicemlemenin kaybettirdiği kalitenin büyük bölümünü geri kazandırıyor ve sonuçlar oldukça güçlü. Yanlış dosyayı indirirseniz QAD uygulanmamış sürümü çalıştırırsınız.
QAD modelin çalışma biçimini nasıl değiştiriyor?
QAD, quantization-aware distillation anlamına geliyor. Liquid AI; LFM2.5-230M, LFM2.5-350M, LFM2.5-1.2B-Instruct ve LFM2.5-2.6B olmak üzere dört modeli, Q4_0 yuvarlama hatalarıyla başa çıkacak şekilde eğitti. Eğitim sırasında yüksek hassasiyetli bir öğretmen model, nicemlenmiş öğrenci modele bilgi aktardı. Böylece ağırlıklar, nicemleme hatasının nerede ortaya çıkacağını önceden görüp buna göre uyum sağladı.
Aynı depolarda bulunan eski Q4_0 dosyaları ise eğitim sonrası nicemleme, yani PTQ kullanıyor. Bu yöntemde tamamlanmış BF16 modelinin ağırlıkları sonradan yuvarlanıyor; ortaya çıkan hatayı telafi eden bir eğitim süreci bulunmuyor. Liquid AI'ın duyuru yazısına göre dört QAD checkpoint'inin tamamı; akıl yürütme, talimat takibi, araç kullanımı ve agentic davranışları kapsayan testlerde BF16 ortalamalarının yaklaşık %97'sine ulaşıyor. Bu oran beş çalıştırmanın ortalaması. QAD yeni bir dosya formatı değil, eğitim aşamasında uygulanan bir iyileştirme. Ortaya çıkan dosya hâlâ llama.cpp'nin doğrudan çalıştırabildiği standart GGUF Q4_0 formatında.
Dosya adlandırma tuzağı ve doğru komutlar
LFM2.5-2.6B deposunda hem LFM2.5-2.6B-Q4_0.gguf hem de LFM2.5-2.6B-QAD-Q4_0.gguf dosyası bulunuyor; ikisi de 1,59 GB olarak listelenmiş. Deponun varsayılan komutları ise QAD yerine Q4_K_M dosyasını gösteriyor. Yani komutu kopyalayıp çalıştırdığınızda QAD dosyalarından hiçbirini indirmiş olmuyorsunuz. Dosya adını açıkça belirtmeniz gerekiyor.
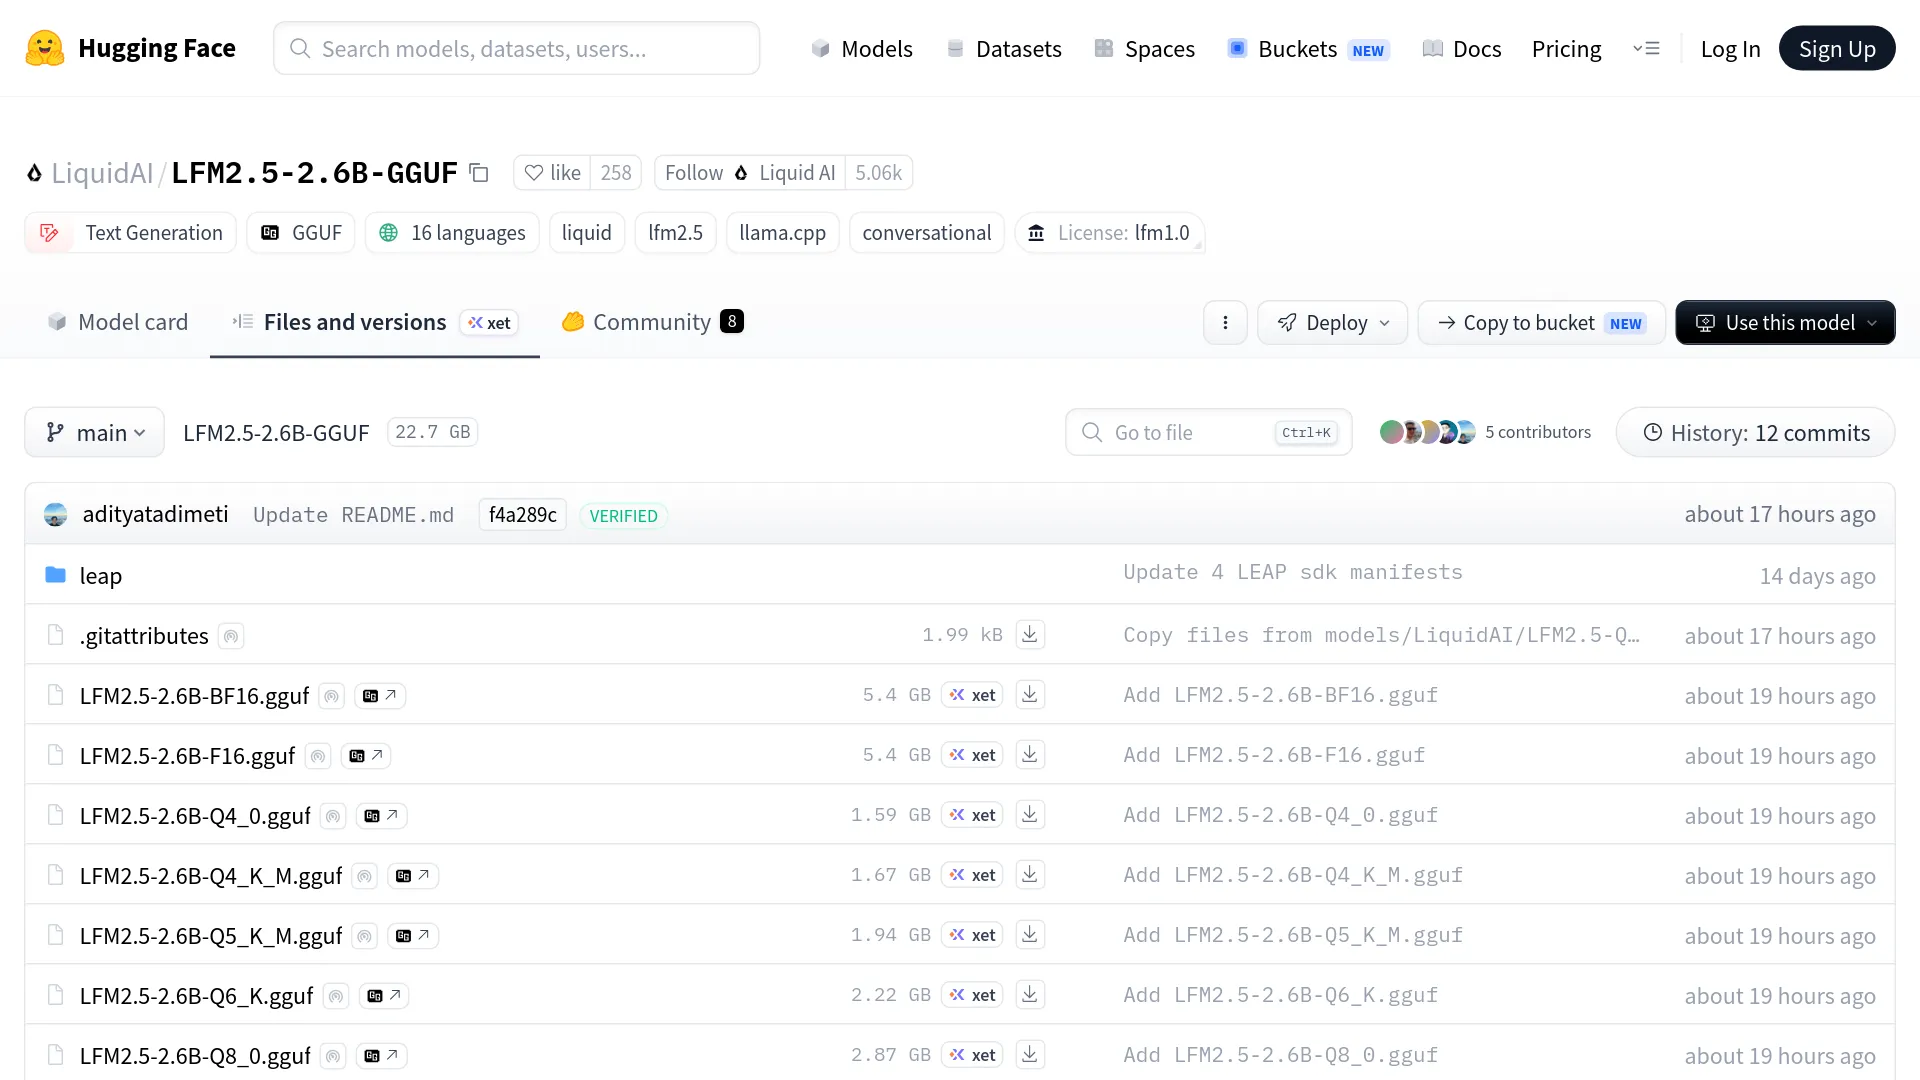
Yayın sonrasında kafa karışıklığı yalnızca birkaç saat içinde ortaya çıktı:
"Nereden indirebilirim? Hugging Face'te görüyorum ama normal sürüm mü yoksa QAD mı olduğundan emin değilim. Yönlendirebilir misiniz?" - X'te @Chitacc72
İlk kullanıcılar arasında yer alan @MarMarLabs, depodaki eski ve yeni Q4_0 derlemelerini karşılaştırdı ve aralarında yaklaşık 4 KB fark olduğunu gördü. Bu fark dosya yöneticisinde ayırt edilemeyecek kadar küçük. Çözüm, --hf-file parametresine QAD dosyasının tam adını vermek:
# Liquid AI'ın duyuru yazısındaki resmi örnek
llama-cli -hf LiquidAI/LFM2.5-350M \
  --hf-file LFM2.5-350M-QAD-Q4_0.gguf \
  -p "What is C. elegans?"

# 2.6B; resmi model kartındaki örnekleme seçenekleriyle
llama-cli -hf LiquidAI/LFM2.5-2.6B-GGUF \
  --hf-file LFM2.5-2.6B-QAD-Q4_0.gguf \
  -c 4096 --temp 0.1 --top-k 50 --repeat-penalty 1.1
Aynı --hf-file yaklaşımı 230M ve 1.2B-Instruct depolarında da geçerli. Sunucu kullanımı için @nicolasembleton, Hugging Face'in oluşturduğu komutların eksik olduğunu fark ettikten sonra çalışan kısa biçimi paylaştı: llama serve -hf LiquidAI/LFM2.5-2.6B-GGUF:QAD-Q4_0. İki nokta üst üste işaretinden sonraki ifade QAD derlemesini seçiyor.
Resmî rakamlar ne söylüyor, neleri söylemiyor?
Liquid AI'ın benchmark tablosuna göre QAD checkpoint'lerinin BF16 tabanına kıyasla koruduğu kalite %96,5 ile %97,4 arasında değişiyor. Test setinde GPQA Diamond, MMLU-Pro, IFEval, IFBench, Multi-IF ve BFCLv4 yer alıyor. Küçük iki model için GSM8K, büyük iki model içinse AIME25 de eklenmiş. Sonuçlar beş çalıştırmanın ortalaması.
| Checkpoint | Korunan BF16 kalitesi | Kalite iddiası | Çözümleme hızı |
|---|---|---|---|
| LFM2.5-230M | %97,1 | varyasyon aralığında Q5_K_M ile aynı | Q5_K_M'e kıyasla +%4–33 |
| LFM2.5-350M | %96,5 | varyasyon aralığında Q5_K_M ile aynı | Q5_K_M'e kıyasla +%4–33 |
| LFM2.5-1.2B-Instruct | %97,4 | Q4_K_M ile aynı | Q4_K_M'e kıyasla +%3–14 |
| LFM2.5-2.6B | %96,6 | Q4_K_M ile aynı | Q4_K_M'e kıyasla +%3–14 |
Hız ölçümleri dört farklı hedefte yapılmış: GPU kullanan MacBook Pro ve NucBox EVO-X2 ile Arm CPU kullanan Samsung Galaxy S26 Ultra ve Raspberry Pi 5. Liquid AI ayrıca 230M ve 1.2B modellerinde QAD Q4_0'ın, duyuru yazısında güçlü bir harici PTQ checkpoint'i olarak tanımlanan Unsloth UD-Q4_K_XL ile aynı sonuçları verdiğini söylüyor.
Ancak duyuru yazısında benchmark bazında puanlar, cihaz başına ham token/s değerleri, dosya boyutları, RAM kullanımı ya da varyasyon aralıkları yok. Elimizde yalnızca yüzde aralıkları ve eşitlik iddiaları var. Topluluk da boyut hesabını hemen yaptı:
"Yani yerel LFM2.5-2.6B modelimi F16'dan QAD Q4_0'a geçirip 5,4 GB'tan 1,6 GB'a, 21'den 64 tok/s'e çıkabileceğimi ve BF16 performansının yaklaşık %97'sini koruyabileceğimi mi söylüyorsunuz?" - @firedUp_Neyu, Liquid'in lansman grafiklerini yorumlarken
Hesabın dosya boyutuyla ilgili kısmı doğrulanıyor: resmî depoda F16 5,4 GB, QAD Q4_0 ise 1,59 GB. Tok/s değerleri ise Liquid AI'ın metin olarak verdiği rakamlar değil; ilgili kullanıcının grafiklerden yaptığı okuma.
Lansman yazısında eksik kalanlar
Bu dosyalara geçiş yapıp yapmayacağınıza karar verirken üç boşluk özellikle önemli.
Desteklenen model sayısı tam olarak dört. Yayın tarihi itibarıyla LFM2.5-VL-450M veya LFM2.5-8B-A1B için QAD derlemesi yok. X'teki duyuru başlığında kullanıcılar Liquid AI'dan 8B sürümü istiyor. Cihazınız bu modellerden birini hedefliyorsa QAD bugün için size bir şey değiştirmiyor.
imatrix konusu hâlâ açık. QAD dosyaları Q4_0 için eğitilmiş olsa da importance matrix kullanılmadan oluşturuldu. Nicemleme topluluğu da bu noktayı hemen gündeme taşıdı:
"QAD Q4_0 GGUF, bir imatrix olmadan oluşturuldu. Oysa imatrix, QAD ile eğitilmiş modellerin kalitesine de katkı sağlayabilirdi." - u/Chromix_, r/LocalLLaMA
3B'nin altındaki bir model hâlâ 3B'nin altındaki bir modeldir. Nicemleme kaynaklı kalite kaybını azaltmak, modelin yetenek sınırını yükseltmiyor. LocalLLaMA başlığındaki örnekler bunu açıkça gösteriyor. Bir NPU kullanıcısı şöyle yazmış:
"Toplantı özetleri için LFM2.5 2.6B'yi NPU'mda çalıştırdım. Boyutuna göre etkileyici olsa da özetler, büyük modellerin ürettiklerinden çok daha kötü." - u/DerDave
Bu sınır nicemleme değil, model kaynaklı. KikoCis nicemleme raporunda, Q8_0 seviyesinde SWE-bench Verified testindeki 6 örneğin hiçbirinin çözülemediği kaydediliyor. 1.2B kullanıcıları da kalitenin çalışma ortamına göre ciddi biçimde değişebildiğini bildiriyor: bir Ollama kurulumunda 10 istemin 9'unda anlamsız çıktı alınırken, başka bir kurulumda tek kartlı bilgisayarda 5 W'ın altında verimli çalışma görülmüş. Belirli bir görevde en üst düzey kalite önemliyse yerel çıktınızı düşük maliyetli bir LLM API üzerinden büyük bir modelle karşılaştırmak, eksiksiz bir test seti için sentlere mal olur.
QAD Q4_0 mü, Q4_K_M mi: hangisini indirmeli?
Bu dört checkpoint'i RAM'i sınırlı llama.cpp kurulumlarında çalıştıracaksanız ilk denemeniz gereken 4 bit seçenek, üreticinin desteklediği QAD Q4_0. Düz Q4_0 ile aynı 1,59 GB boyutunda; 1.2B ve 2.6B modellerinde Q4_K_M, 230M ve 350M modellerinde ise Q5_K_M kalitesini hedefliyor. Çözümleme hızı da sırasıyla %3–14 ve %4–33 daha yüksek. Zaten Q4_K_M kullanıyor ve RAM'iniz yeterliyse mevcut kurulumu değiştirmeyin; çözmeye çalıştığınız sorun 80 MB değil.
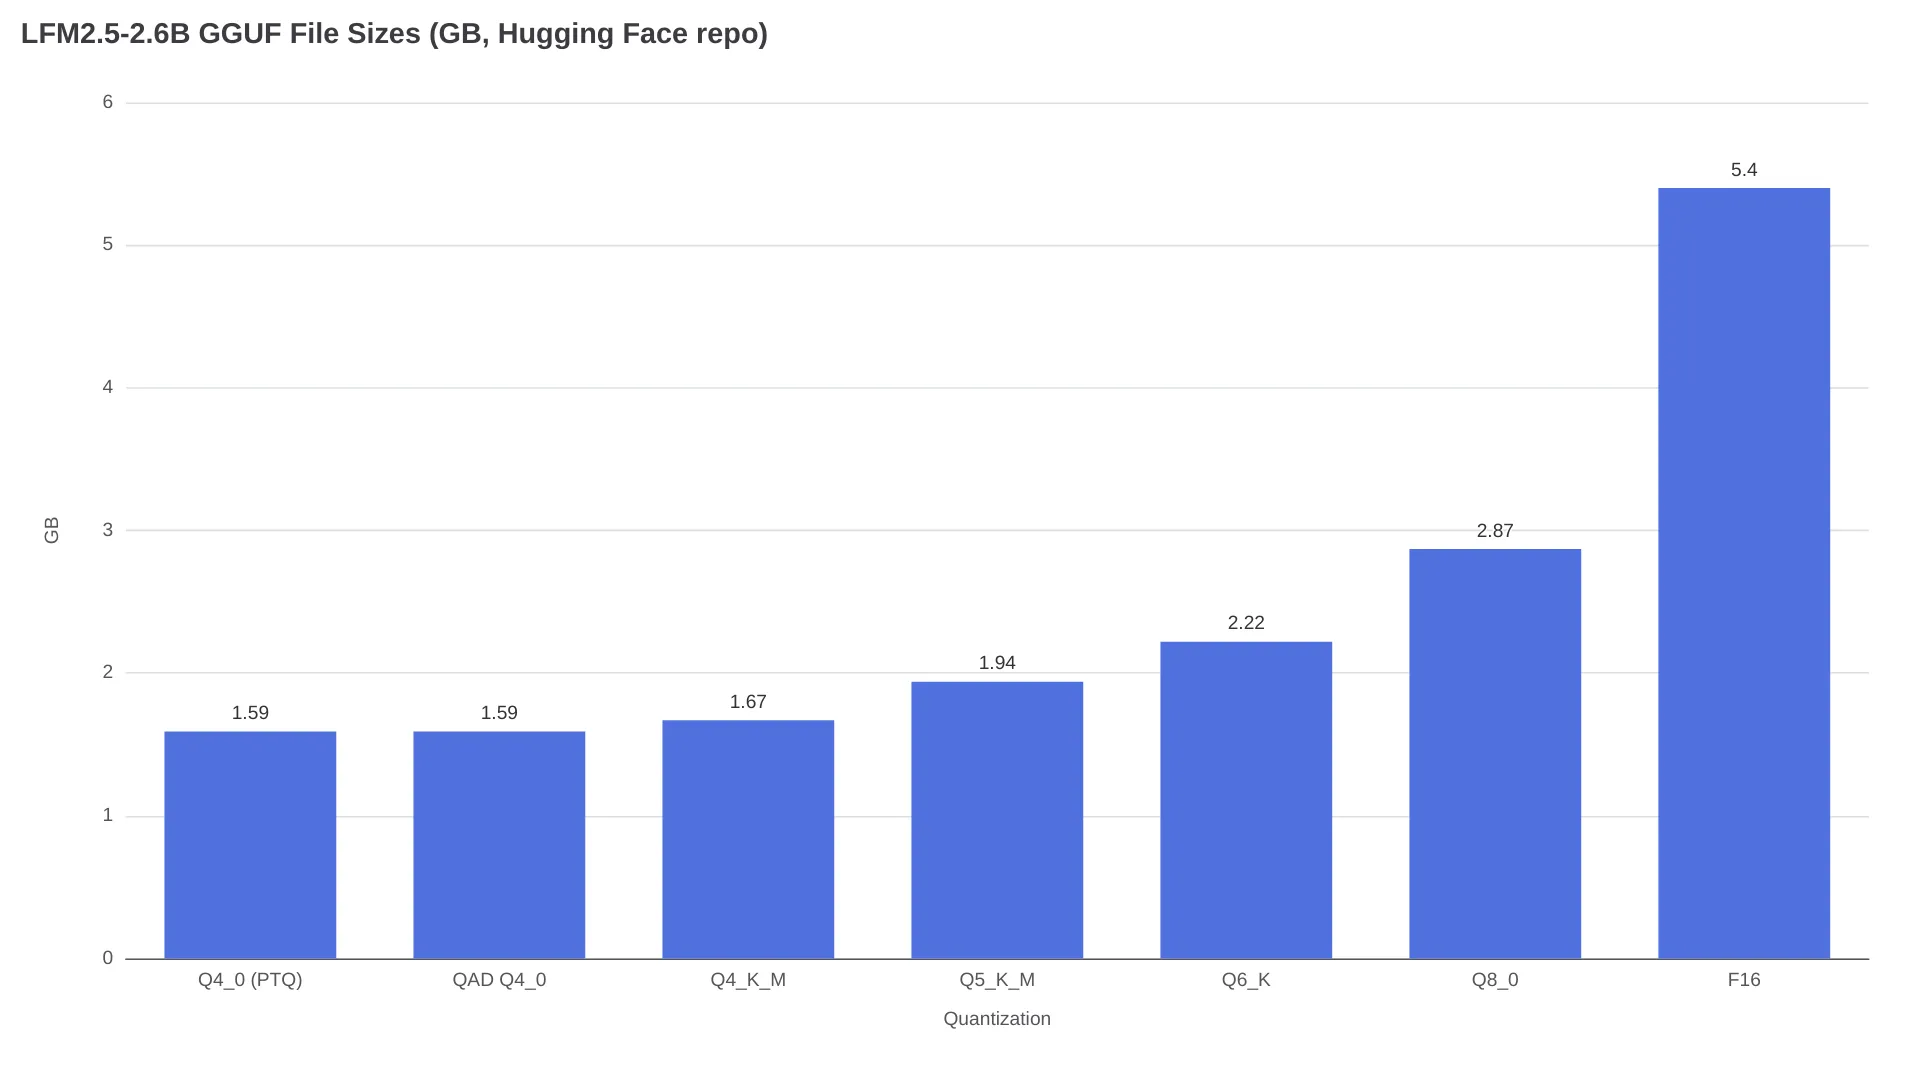
| Dosya (2.6B) | Boyut | Konumlandırma | Şu durumda seçin |
|---|---|---|---|
| Q4_0 (eski PTQ) | 1,59 GB | iyileştirme uygulanmamış temel sürüm | QAD artık mevcut olduğu için tercih etmeyin |
| QAD Q4_0 | 1,59 GB | BF16'nın %96,6'sı, Q4_K_M ile aynı | 3–4 GB RAM bütçesi, CPU çözümleme, telefon veya Pi kullanıyorsanız |
| Q4_K_M | 1,67 GB | Liquid belgelerinin varsayılan tercihi | çalışma ortamınız QAD dosyasını seçemiyorsa |
| Q5_K_M | 1,94 GB | KikoCis'e göre F16 karşısında %91,4 top-1 | 6 GB veya üzeri RAM'iniz varsa |
| Q6_K / Q8_0 | 2,22 / 2,87 GB | kayıpsıza yakın | 8 GB veya üzeri RAM ve kalite önceliğiniz varsa |
Bu eşitlik iddialarını değerlendirirken şu bağlamı akılda tutun: KikoCis'in PTQ karşılaştırmasında bu model için Q4_K_M, F16'ya karşı %84,36 top-1 token uyumu verdi. Q6_K'da oran %95,07, Q8_0'da ise %98,23. Liquid AI'ın iddiası, QAD'ın aynı byte sayısında 4 bitlik doğruluk farkını kapattığı yönünde. Bunlar beş çalıştırmaya dayanan üretici rakamları; henüz bağımsız bir tekrar yok. Lansman günü yapılan tartışmadaki şu yorum durumu iyi özetliyor:
"Mesele 'Q4_0, K-quant'ları geçiyor' değil. Bu dört checkpoint Q4_0 için eğitildi." - @MarMarLabs
Bu avantajı genelleştirmeyin. Diğer modellerin Q4_0 dosyaları hâlâ standart PTQ dosyaları.
RAM tarafında lansman yazısı herhangi bir değer vermiyor. Bu nedenle KikoCis deposundaki hesaplamaları baz alın: 2.6B modelinde KV cache, f16 formatında token başına yaklaşık 16 KB tutuyor. Bu da 32K bağlamda yaklaşık 0,54 GB, yerel 128K pencerede ise 2,15 GB anlamına geliyor. --cache-type-k q8_0 --cache-type-v q8_0 kullanıldığında bu değer yarıya iniyor. 1,59 GB'lık QAD Q4_0 ağırlıklarıyla birlikte 32K pencere, çalışma zamanı ek yükü hariç yaklaşık 2,13 GB ister. 128K bağlam ise 3,7 GB'ın üzerine çıkar. Bu nedenle 4 GB'ı sınırda kabul edin ve hedef çalışma ortamınızdaki bellek tahsisini mutlaka doğrulayın.
Sık sorulan sorular
QAD Q4_0, Q4_K_M'den daha mı iyi?
Bu dört checkpoint için Liquid AI'ın rakamları, QAD Q4_0'ın Q4_K_M kalitesine; en küçük iki modelde ise Q5_K_M kalitesine ulaştığını ve bunu daha küçük dosyada daha yüksek çözümleme hızıyla yaptığını söylüyor. RAM bütçesi açısından bakarsak cevap evet. Ancak sonuçlar üreticinin kendi testleri, beş tekrar ve henüz bağımsız bir doğrulama yok.
Ollama veya LM Studio QAD dosyasını otomatik olarak seçiyor mu?
Hayır. Resmî depo sayfasına göre Ollama'nın belgelenen kullanımı ollama run hf.co/LiquidAI/LFM2.5-2.6B-GGUF:Q4_K_M biçiminde ve Hugging Face'in varsayılan komutları da Q4_K_M'ı hedefliyor. GGUF destekleyen her çalışma ortamı QAD dosyasını yükleyebilir; ancak dosyayı tam adıyla veya :QAD-Q4_0 niteleyicisiyle açıkça seçmeniz gerekir.
LFM2.5-2.6B QAD Q4_0 için ne kadar RAM gerekir?
Ağırlıklar 1,59 GB. KikoCis'in hesaplamalarına göre f16 KV cache, 32K bağlamda yaklaşık 0,54 GB, 128K'da yaklaşık 2,15 GB tutuyor. Ağırlık ve cache toplamı, çalışma zamanı ek yükü hariç 32K'da yaklaşık 2,13 GB, 128K'da ise 3,74 GB seviyesine geliyor. KV cache'i Q8_0 olarak nicemlemek cache maliyetini yarıya indiriyor.
Hangi LFM2.5 modellerinin QAD checkpoint'i var?
19 Ağustos 2026 itibarıyla yalnızca LFM2.5-230M, LFM2.5-350M, LFM2.5-1.2B-Instruct ve LFM2.5-2.6B için QAD checkpoint'i bulunuyor. VL-450M ve 8B-A1B varyantlarında henüz QAD yok; ancak kullanıcılar duyuru başlığında Liquid AI'dan 8B QAD derlemesi istedi.
LFM2.5 QAD checkpoint'lerini ticari olarak kullanabilir miyim?
Depolar LFM Open License v1.0 etiketiyle yayınlanmış. Topluluk depolarındaki özetlere göre yıllık geliri 10 milyon USD'nin altında olan kuruluşlar ticari kullanım yapabiliyor; bu eşik ve üzerinde ise ayrıca Liquid AI ticari lisansı gerekiyor (KikoCis'in özeti). Ürünü yayınlamadan önce doğrudan lisans metnini okuyun.
%97 iddiası bağımsız olarak doğrulandı mı?
Henüz değil. %96,5–97,4 arasındaki koruma oranları, Liquid AI'ın yayınla birlikte paylaştığı beş çalıştırma ortalamaları. Bu yazı hazırlanırken QAD dosyaları için üçüncü taraf bir benchmark yayınlanmamıştı; imatrix konusu da r/LocalLLaMA'da hâlâ açık bir tartışma başlığı.
Bu akşam kendi A/B testinizi yapın
Asıl önemli olan benchmark ortalaması değil, sizin görevinizdeki hata oranı. Gerçek istemlerinizden on tanesini seçin; araç çağrısı JSON'u, kullandığınız çıkarım şeması ve dil gibi senaryoları dahil edin. Ardından iki dosyayı da aynı ayarlarla çalıştırın:
llama-cli -hf LiquidAI/LFM2.5-2.6B-GGUF \
  --hf-file LFM2.5-2.6B-QAD-Q4_0.gguf \
  -c 4096 --temp 0.1 --top-k 50 --repeat-penalty 1.1 \
  -p "<your prompt>"

llama-cli -hf LiquidAI/LFM2.5-2.6B-GGUF \
  --hf-file LFM2.5-2.6B-Q4_K_M.gguf \
  -c 4096 --temp 0.1 --top-k 50 --repeat-penalty 1.1 \
  -p "<your prompt>"
Dosyaları değerlendirirken genel izlenime değil, her birindeki ayrıştırma hatalarına ve yanlış araç seçimlerine bakın. Çözülmemiş ödünleşim gerçek: gigabayt başına kalite ortalamaları kâğıt üzerinde QAD Q4_0 lehine görünüyor. Ancak akıl yürütmenin token bütçesini tüketmesiyle gelen boş yanıtlar veya sıcaklık yükseldiğinde formatın bozulması gibi dağıtım sorunları, kullandığınız çalışma ortamına ve göreve bağlı. Bunun gerçek maliyetini yalnızca kendi on isteminizle ölçebilirsiniz.