 AIREITER
Anthropic, Claude Opus 5.5'i artık ücretli planlarda bilgi işi için varsayılan model olarak konumlandırıyor. Bulgular da bu tercihi büyük ölçüde destekliyor. Ancak gerçek kullanıcı deneyimlerinde öne çıkan ciddi bir sorun var: Pro, Max ve Team planlarında kota beklenenden hızlı tükeniyor.
Claude 5.5 ailesinin ilk modeli olan Opus 5.5, 22 Eylül 2026'da çıktı. Anthropic'e göre çoğu işte Claude Fable 5.1 düzeyinde performans sunarken Opus 5'e kıyasla çalıştırma maliyeti %40 daha düşük (anthropic.com). Anthropic, 12 Kasım 2026 tarihli günlük kullanım rehberinde yaklaşımını açıkça ortaya koydu: araştırma, analiz, yazı, rapor, elektronik tablo ve sunum işleri için Opus 5.5'i Medium eforda kullanarak başlayın; yalnızca gerektiğinde daha yukarı çıkın (claude.com). Bu inceleme, resmi yönlendirmeleri, bağımsız benchmark'ları ve kullanıcı kota raporlarını bir araya getiriyor; birinci taraf laboratuvar testi değil.
Kısa karar: Varsayılanınız Opus kalsın, efor Medium olsun
Opus 5.5'i seçili bırakın. Günlük bilgi işleri için Medium eforu kullanın. Model değiştirmeden önce efor seviyesini artırın; hızın veya yüksek işlem hacminin muhakemeden önemli olduğu durumlarda Sonnet 5.5 ya da Haiku 5.5'e geçin.
Bunun nedeni model sadakati değil, hesap. Anthropic'in kodlama ve bilgi işi değerlendirmelerinde Opus 5.5 Medium, Opus 5 High ile eşleşti veya onu geçti. Anthropic'in günlük kullanım rehberinde aktarılan Factory verisi de Medium'un, %20–25 daha az çıktı token'ıyla Opus 5 High seviyesine ulaştığını söylüyor. Medium, Claude uygulamalarında ve Claude Code'da da varsayılan ayar; dolayısıyla çoğu abone hiçbir ayarı değiştirmeden bu davranışı alıyor.
Ancak asıl sınır API liste fiyatı değil, abonelik kotası. API fiyatı, Opus 5'teki $5/$25 seviyesinden milyon girdi token'ı başına $4 ve milyon çıktı token'ı başına $20'a indi; önbellek okuma fiyatı ise milyon başına $0.20. Buna karşılık, Anthropic'in günlük kullanım rehberine göre daha pahalı modeller abonelik limitlerini daha hızlı tüketiyor. Kullanıcılar da yoğun oturumlarda 5 saatlik pencerelerin 15–30 dakika içinde dolduğunu, haftalık limitlerin ise eylül ayındaki balayı dönemine göre çok daha erken bittiğini bildiriyor.
Kasım ayar değişikliği Pro, Max ve Team kullanıcıları için ne ifade ediyor?
Aboneler açısından kritik konu, yeni varsayılan modelle birlikte kota sisteminin nasıl işlediği. Anthropic, aşağıda ayrıntılandırılan ekim sonu hızlı tüketim şikâyetlerine rağmen lansmanda Pro, Max, Team ve koltuk bazlı Enterprise planlarında beş saatlik kullanım limitlerini artırdığını ve abonelere saklanabilir bir oran limiti sıfırlama hakkı verdiğini duyurdu (anthropic.com). Rehberde ayrıca Pro ile standart Team ve koltuk bazlı Enterprise kullanıcılarının, lansman teklifleri dışında Fable 5.2'yi normal limitleri kapsamında genellikle kullanamadığı belirtiliyor; Fable kullanım kredilerinden düşüyor. Bu nedenle dahil olan ana çalışma modeli olarak Opus'u, ölçülü kullanım gerektiren istisna olarak da Fable'ı planlamak gerekiyor.
Günlük kullanım iddiasının karşılığı: araştırma, analiz ve yazım
Her rakamı denetlenebilen araştırma notları
En zor testlerden biri, kazanç açıklamasına bilerek erişimin güçleştirildiği ve uydurulmuş tek bir rakamın ya da alıntının tüm raporu geçersiz kıldığı kaynaklı şirket performans raporlarıydı. Opus 5.5, farklı efor ayarlarında 18 raporun 16'sını geçti; Anthropic'e göre Fable 5.1 ve Opus 5, hiçbir denemede aynı eşiği aşamadı (claude.com). Anthropic'in lansman yazısında yer verilen Walleye Capital'in harici kontrolü de bu tabloyu destekliyor: Opus 5.5, en düşük efor ayarında test setinin büyük bölümünü çözdü; yüksek eforda ise değerlendiricinin kendi talimatlarındaki bir indeksleme hatasını yakaladı. Walleye'a göre bunu daha önce test edilen hiçbir model fark etmemişti.
Günlük kullanım açısından anlamı net: teslimatı açıkça tanımlanmış, kaynakları eklenmiş açık uçlu araştırma görevlerini modele bırakın; ardından metnin üslubundan çok rakamları denetleyin.
Analiz tarafı: elektronik tablolar, birleşme hesabı ve yoğun grafikler
İki İK yazılımı şirketinin kurgusal birleşmesinde hem Opus 5 hem de Opus 5.5 bir Excel modeli ve yönetici sunumu hazırladı, aynı anlaşma sonucuna ulaştı. Opus 5.5 işi 93 dakika yerine 63 dakikada tamamladı, üretim maliyeti bildirildiğine göre %50 daha düşüktü, daha kapsamlı bir model sundu ve daha az küçük hata yaptı (claude.com). Finans iş akışlarının geneline bakıldığında Hebbia, Opus 5.5 için %86.6 kriter kapsamı raporlarken Opus 5'te bu oran %60.3 oldu. Rogo ise Anthropic'in lansman yazısına göre BigFinance Bench'te Opus 5 High'ı yaklaşık %60 daha az çıktı token'ıyla geçtiğini bildirdi.
Görüntü anlama da aynı hikâyenin parçası. Anthropic, Opus 5.5'i yoğun dokümanlar, grafik değerleri, ekran görüntüleri ve diyagramlar için en güçlü Opus görüş modeli olarak tanımlıyor; en düşük efor ayarındaki Opus 5.5'in yoğun grafikleri, en yüksek ayardaki Opus 5'ten daha doğru okuduğunu belirtiyor (claude.com). Yayınlanan Chartography skoru, en yüksek değerlendirilen ayarda araçsız %64.4 (claude.com); lansman skor kartında araçlarla %89.0. GDPval-AA profesyonel iş Elo puanı ise Fable 5.1'in 1735, Opus 5'in 1708 puanına karşılık 1846 (anthropic.com).
Pratikte doğrudan bitmiş elektronik tabloyu veya sunumu isteyin. Grafik değerlerini yazmak yerine görseli ekleyin ve ilk mesajda işi hangi koşulda tamamlanmış sayacağınızı belirtin.
Yazımda hedef taslak değil, bitmiş doküman ve sunum
Buradaki yazım iddiası yalnızca "daha iyi üslup" değil; talimatlara uyum ve denetlenebilirlik. Anthropic, Opus 5.5'in konudan sapmadığını, sonuçla başladığını, daha az jargon kullandığını, sağlanan stil kurallarına uyduğunu; ne yaptığını, ne bulduğunu ve hâlâ hangi girdiye ihtiyaç duyduğunu açıkladığını söylüyor. Bağımsız değerlendirmeler de aynı yönü işaret ediyor: Hayz Labs, Opus 5.5'e yazımda 100, kodlamada 100 ve araştırmada 94 puan veriyor; ekim kontrolü itibarıyla modeli WebDev ve ajanlar için ilk sıraya, Arena'da yaratıcı yazım için ikinci sıraya koyuyor.
Dürüst sınır şu: kurum içi üslubu kusursuz yakalamak hâlâ birkaç tur deneme gerektiriyor.
Efor ayarı, asıl fiyat etiketi
eesel'in efor dökümüne göre Opus 5.5'te beş efor seviyesi bulunuyor: Low, Medium, High, Very High/Extra High ve Max. Hayz Labs'e göre düşünme özelliği kapatılamıyor. Faturayı token başı fiyattan çok bu ayar belirliyor.
eesel'in Artificial Analysis verileri özetine göre aynı zor görev Low'da yaklaşık $0.55, Medium'da $1.34, Max'te ise $5.98 tutuyor; Intelligence Index skorları sırasıyla yaklaşık 42, 51 ve 58. Bir Max çalıştırması yaklaşık 119,000 çıktı token'ı üretebiliyor; milyon çıktı token'ı başına $20 fiyatla maliyetin nerede oluştuğu da burada ortaya çıkıyor. Hayz Labs'in Pareto görünümü benzer bir sonuca ulaşıyor: 14 gün boyunca ajan görevi başına medyan yaklaşık $1.61, ana tablodaki medyan ise $1.76; High seviyesi yaklaşık $1.82.
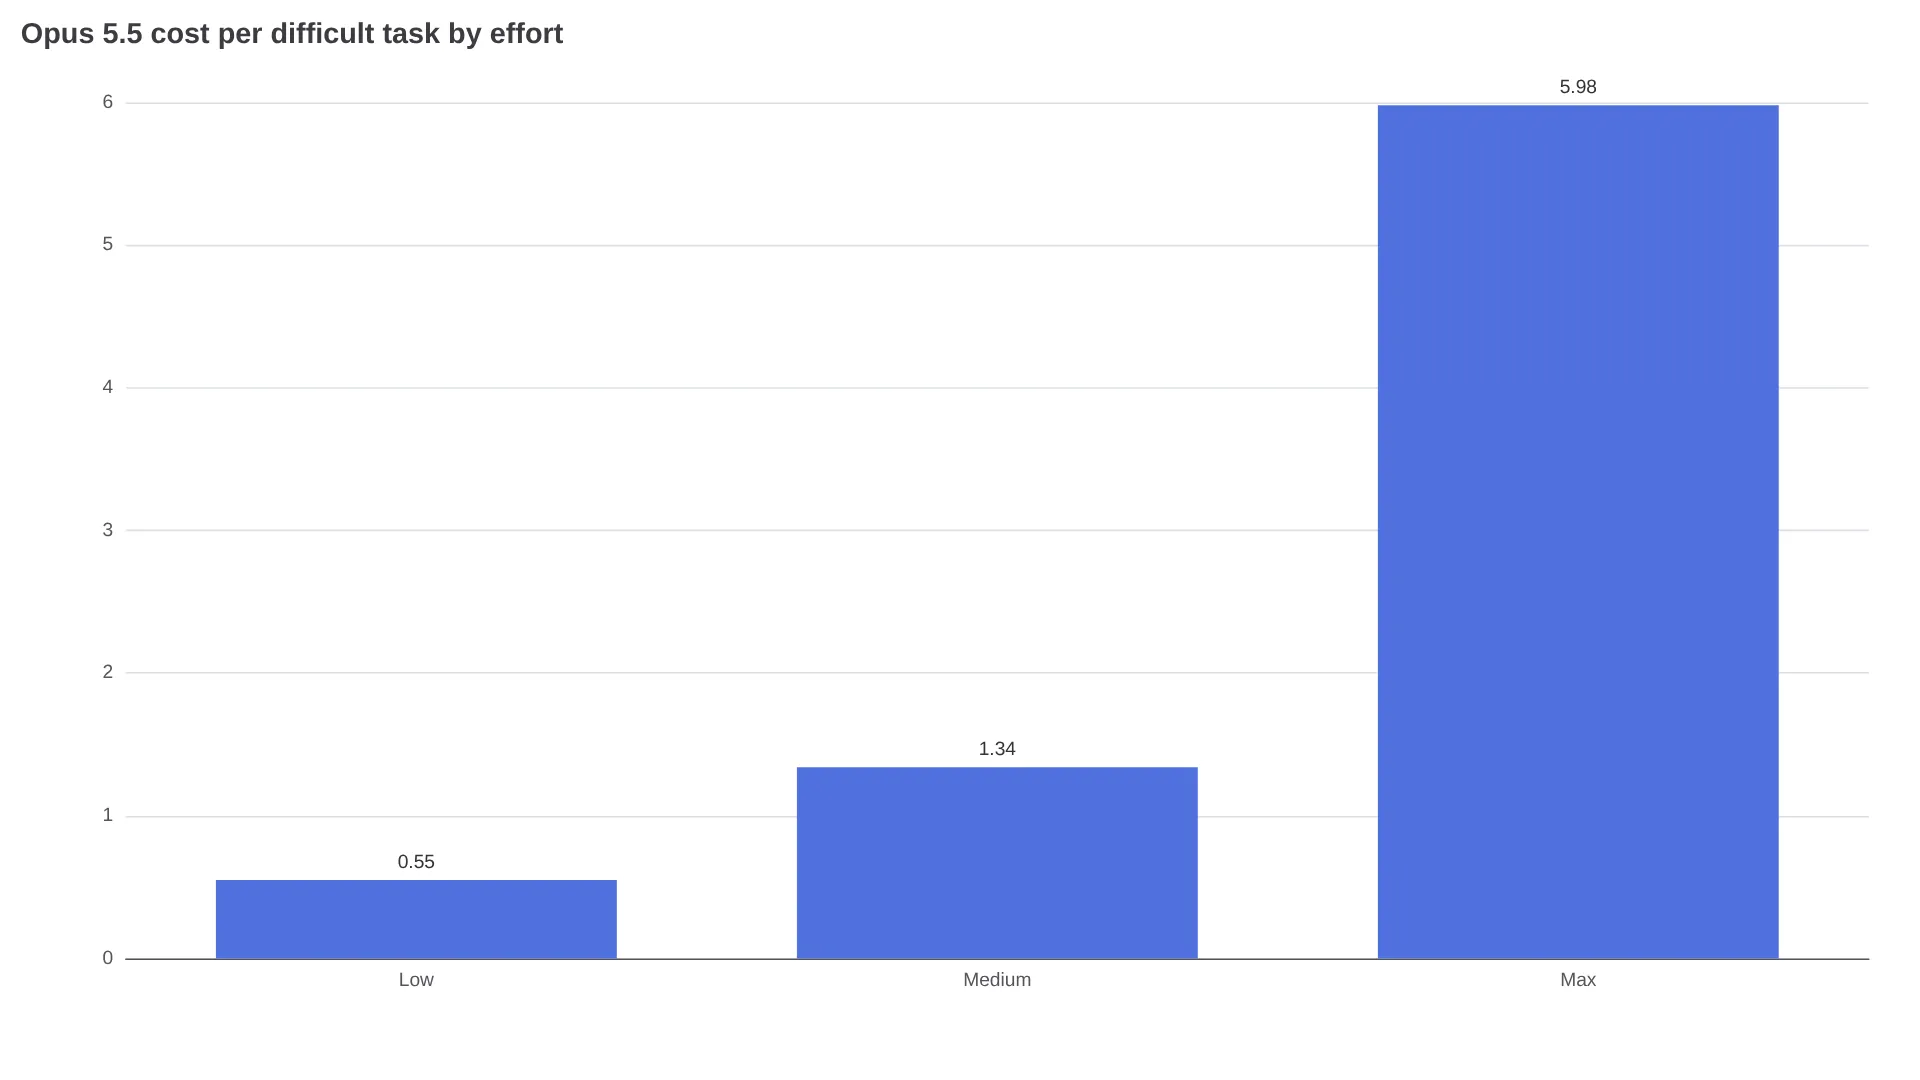
Daha yüksek efor her zaman daha iyi sonuç vermeden süreyi ve maliyeti artırıyor. Anthropic'in önerisi, "think hard" gibi ifadeleri istemden çıkarmak: muhakeme zaten açık, derinliği efor ayarı ve görevin kendisi belirliyor. Medium'un gerçekten tıkandığı görülmeden bir üst seviyeye çıkmayın.
eesel'in teknik özellik sayfasına göre bağlam penceresi 1 milyon token, çıktı sınırı 128,000 token; Batch'te bu sınır 300,000 token. Model yerleşik görüntü anlama da sunuyor. eesel'in fiyat incelemesine göre uzun bağlam için ek ücret yok; bu da uzun doküman denetimi iş akışı açısından önemli.
Dört model arasında görev dağıtımı: Opus 5.5, Sonnet 5.5, Haiku 5.5 ve Fable 5.2
Anthropic'in kasım rehberi ile bağımsız maliyet analizleri tek bir kuralda buluşuyor: önce eforu değiştirin, modeli sonra değiştirin. Aşağıdaki fiyatlar, Anthropic'in günlük kullanım rehberindeki fiyat tablosundan alınmıştır.
| Model | 1 milyon token başına API fiyatı (girdi/çıktı) | Şunun için kullanın | Şu durumda model değiştirin |
|---|---|---|---|
| Haiku 5.5 | 100K token'a kadar $0.10 / $0.50 | Hızlı bilgi bulma, özetleme, sınıflandırma, yüksek hacimli ve dar kapsamlı işler | Analiz uzamaya veya yoğun muhakeme gerektirmeye başladığında |
| Sonnet 5.5 | $2 / $10 | Net ve iyi tanımlanmış görevler, doküman rötuşları, ayrıntılı brief'ten sunum hazırlama | Düzenli olarak Extra High veya Max efora çıkıyorsanız |
| Opus 5.5 | $4 / $20 | Araştırmaların, analizlerin, finans işlerinin ve bitmiş dokümanların çoğu | Medium, High'da gerçek bir yeniden denemeden sonra da tıkanıyorsa |
| Fable 5.2 | $8 / $40 | Uzun süre çalışan alt ajan ekipleriyle açık uçlu teknik işler, bilim, kodlama ve finans | Gündelik bilgi işleri için; çoğu zaman gereğinden fazla |
Akılda tutulacak eşik şu: Sonnet 5.5'i Extra High veya Max'e çıkarmak, görev başına Opus 5.5'e neredeyse aynı maliyete ulaşabilirken muhakeme tarafında hâlâ geride bırakabiliyor. Kodlama planı kullanıcıları abonelik tarafında da aynı dinamiği bildiriyor: Sonnet'i Medium'un üstünde tutmak yerine görevi Low ayarlı Opus 5.5'e taşımak daha mantıklı (örneğin @cupid25157). Bu, resmi "modelden önce efor" yaklaşımı ve görev başı maliyet hesabıyla uyumlu.
Fable rakip değil, tavan seviye. Anthropic'in kasım tarihli Fable 5.2 paylaşımı, Fable ve Mythos'u en iddialı açık uçlu teknik işler için; Opus 5.5'i ise kodlama ve bilgi görevlerinin çoğu için en güçlü günlük model olarak tanımlıyor (@claudeai). Aboneliklerde ayrım daha da belirgin: standart Pro/Team koltuklarında Fable kullanımı çoğu zaman kredilere yazılıyor. Dolayısıyla gündelik Fable kullanımı, "daha iyi model" refleksini kredi faturasına dönüştürebilir.
Kotayı koruma rehberi: 5 saatlik pencere neden eriyor, nasıl önlenir?
Resmi benchmark'ların atladığı, kullanıcı raporlarının ise odağına aldığı bölüm burası. En somut şikâyet yetenek eksikliği değil, kota tüketimi.
"Opus 5.5 limitleri bu gece RESMEN PARÇALANIYOR!! Birden fazla kişi, normal oturumlarda 5 saatlik kotaların YALNIZCA 15-30 dakikada tükendiğini bildiriyor. Haftalık limitler ÇOK daha hızlı eriyor" — @TekonBurns, Claude Code oturumlarındaki tüketimi aktarıyor
Bazı kullanıcılar değişimi ani bir balayı dönemi sonu olarak görüyor. @kgauravnm, tembel davranışlar ve hızlı haftalık kota tüketimi nedeniyle "Claude Opus 5.5 balayı döneminin resmen bittiğini" yazıyor. @ps_ios_dev gibi Team koltuğu kullanıcıları ise ücretsiz haftalık sıfırlamadan sonra dahi Medium efor kullanımının "hızla aktığını" belirtiyor. Yine de önemli bir çekince var: @sonuv_dev tarafından yapılan 67,000 mesajlık Claude Code günlük analizi, araç çağrıları, hata oranları ve şikâyet oranlarının yaklaşık sabit kaldığını, yani "nerf olduğuna dair temelde sıfır kanıt" bulunduğunu ortaya koydu. Bu da sıkıntının en azından bir kısmının gizli bir geriletmeden değil, daha yoğun varsayılan kullanımdan ve pahalılaşan muhakemeden kaynaklanabileceğini düşündürüyor. Tavanda model seçimi de önemli: @mohitsharmadl, Fable 5.2 Medium'un Opus 5.5 High'ın çözemediği hataları temizlediği bir örnek aktarıyor. Yani her şeyi Opus'a vermek, yanlış tavan için kota harcamak olabilir.
Resmi yönlendirmeyi ve kullanıcıların işe yaradığını söylediği yöntemleri bir araya getiren kota kullanım planı:
- Her şeyi varsayılan olarak Opus 5.5 Medium'a alın; High'ı sürekli açık bir kişilik ayarı değil, sorunu teşhis edilmiş bir üst kademe olarak görün.
- İşi alt görevlere bölün: bilgi bulma ve sınıflandırma için Haiku, kapsamı net taslak ve rötuş işleri için Sonnet, muhakeme, denetim ve son onay için Opus kullanın.
- Sonnet'i alışkanlıkla Medium'un üstünde bırakmayın; maliyet eşiğini hesaplayın ve görevi bunun yerine Opus Low/Medium'a taşıyın.
- Aynı bağlamı tekrar tekrar yapıştırmak yerine dosya ekleyin ve depoları bağlayın; yeniden gönderilen uzun bağlam her turda token ekler ve ölçülen kullanımı artırır.
- Oran limiti sıfırlama hakkını denemeler için harcamak yerine gerçek teslim tarihi olan bir hafta için saklayın.
- Fable'ı kazandığı dar görev sınıfına ayırın: uzun ufuklu, çok ajanlı, açık uçlu teknik işler. Önce kullandığınız koltuğun Fable'ı kredilere yazıp yazmadığını doğrulayın.
SSS: Günlük kullanımda gerçekten sorulan sorular
Claude Opus 5.5 günlük kullanım için yeterince iyi mi?
Evet; özellikle muhakemenin ve denetlenebilirliğin önemli olduğu araştırma, analiz ve yazım işlerinde. Hayz Labs, modeli ajanlar ve WebDev için ilk sıraya koyuyor ve yazımda en yüksek puanları veriyor; Anthropic'in aktardığı kurumsal kontroller de aynı sonuca işaret ediyor. Yüksek hacimli işler için yanında daha ucuz bir modeli hazır tutun.
Opus 5.5, günlük işlerde Sonnet 5.5'ten daha mı iyi?
Belirsiz veya sonuçları kritik işler için evet. Kapsamı açık, iyi tanımlanmış ve yüksek hacimli görevlerde ise Low veya Medium ayarlı Sonnet daha hızlı; Anthropic, Sonnet'i Fast, Opus'u Moderate olarak sınıflandırıyor (claude.com) ve token fiyatı yaklaşık yarısı kadar. Hata, Sonnet'i varsayılan olarak Extra High veya Max'te çalıştırmak; bu tasarrufu ortadan kaldırıyor.
Fable 5.2 yerine Opus 5.5'i ne zaman kullanmalıyım?
Bilgi işlerinin ve standart kodlama görevlerinin çoğunda Opus kullanın. Opus High'ın da tıkandığı açık uçlu, uzun süreli veya yoğun ajan kullanan teknik projelerde Fable'a geçin. Standart Pro/Team koltuklarında Fable çoğu zaman kredilere yazıldığı için önce plan faturalandırmasını kontrol edin.
1 milyon token'lık bağlam, uzun dokümanlarda güvenilir çalışıyor mu?
Ekli dosyalarla yürütülen denetim tipi işler için, Anthropic'in sunduğu en güçlü Opus yapılandırması bu; kaynaklı raporlardaki 18'de 16 sonucu da buna dahil. Çok uzun işler yine abonelik kotasını hızla tüketir. Bu yüzden her şeyi en büyük bağlamda çalıştırmak yerine bilgi getirmeyi Haiku'ya, muhakemeyi Opus'a bırakın.
Asıl dikkat edilmesi gereken denge
Opus 5.5, Medium eforda bilgi işleri için doğru varsayılan. Açıkta kalan soru, kullanıcıların bildirdiği ekim sonu kota sıkılığının yeni normal olup olmadığı. Eğer öyleyse haftanın daha büyük bölümü, lansman mesajlarının ima ettiğinden fazla Sonnet üzerinde geçecek.
İlgili okumalar: Claude Opus 5.5 fiyat incelemesi, Claude Opus 5.5 High incelemesi, Claude Opus 5.5 vs GPT-6.1 Sol.