 AIREITER
27 milyar parametreli bir modeli telefonda çalıştırmak birkaç yıl öncesine kadar pek gerçekçi görünmüyordu. PrismML'nin Qwen3.6 27B tabanlı, üçlü kuantize edilmiş Bonsai 27B modeli bunu 3,9 GB'a indiriyor; iPhone 17 Pro'da saniyede yaklaşık 11 token üretebiliyor. Ağırlıklar Apache 2.0 lisansıyla ücretsiz sunuluyor ve üçlü sürüm, tam hassasiyetli modelin benchmark skorunun %95'inden fazlasını koruyor. Ancak bu başarı her alana eşit yansımıyor: matematik ve kodlama neredeyse aynı seviyede kalırken araç çağırma ve görsel yetenekler belirgin biçimde geriliyor. Bu nedenle Bonsai 27B, cihaz üzerinde muhakeme ve kod için güçlü bir seçenek; araç yoğun ajan iş akışları içinse henüz güven veren bir model değil. Bu rehberde sıkıştırmanın nasıl yapıldığına, sayıların ne anlattığına, modeli çalıştırmanın dört yoluna ve kimlerin kullanması gerektiğine bakıyoruz.
27B model telefona nasıl sığdırıldı?
FP16 formatındaki standart bir 27B model yaklaşık 54 GB bellek ister; bu da herhangi bir telefonun sunabileceğinden çok daha fazla. Bonsai 27B, tam hassasiyetli ağırlıkları küçük ve ayrık değerlerle değiştirerek 6 GB'ın altına iniyor.
Üçlü sürümde her ağırlık yalnızca üç değerden birini alıyor: -1, 0 veya +1. Bu, teorik olarak ağırlık başına yaklaşık 1,58 bit bilgi demek. PrismML buna grup bazlı FP16 ölçekleme ekliyor; yani sıkıştırılmış değerlerin doğru büyüklükte kalması için her ağırlık grubu adına tam hassasiyetli bir ölçek katsayısı saklanıyor. Sonuçta gerçek maliyet, ağırlık başına yaklaşık 1,71 efektif bite ulaşıyor. Daha agresif 1-bit ikili sürüm ise sıfırı kaldırıp yalnızca -1 ve +1 değerlerini kullanıyor; bu sürüm yaklaşık 1,125 efektif bit seviyesinde.
Burada iki önemli ayrıntı var. İlk olarak kuantizasyon uçtan uca uygulanıyor: embedding'ler, attention katmanları, MLP blokları ve dil modeli başlığının tamamı kuantize edilmiş durumda; modeli ayakta tutan tam hassasiyetli bileşenler yok. İkinci olarak temel model Qwen3.6 27B; yani 27,8B parametreli, hibrit attention kullanan nedensel bir model. Bonsai de bu altyapıdan 262K token bağlam penceresini ve çok modlu girdi desteğini devralıyor.
Üçlü mü, 1-bit mi: Hangi sürümü indirmelisiniz?
PrismML iki farklı sürüm yayınlıyor. Yanlış seçimi yapmak ya gereksiz bellek tüketimine ya da gereğinden fazla kalite kaybına yol açıyor. Denklem basit: Dosya küçüldükçe doğruluk düşüyor.
| Sürüm | Efektif bit/ağırlık | Boyut | Korunan kalite | En uygun kullanım |
|---|---|---|---|---|
| Üçlü (-1, 0, +1) | ~1.71 | 5.9GB | FP16'nın >%95'i | Masaüstü, kaliteye duyarlı işler |
| 1-bit ikili (-1, +1) | ~1.125 | 3.9GB | FP16'nın >%90'ı | Telefonlar, kısıtlı bellek bütçeleri |
Telefon kullanıyorsanız, iPhone 17 Pro'nun bellek payına sığan seçenek 1-bit sürüm. Dizüstü veya masaüstünde daha fazla alanınız varsa, üçlü sürüm 2 GB ek alan karşılığında birkaç puanlık doğruluğu geri kazandırıyor. Çıktı kalitesinin dosya boyutundan önemli olduğu durumlarda bu fark anlamlı.
Benchmark sonuçları ne söylüyor, kalite nerede düşüyor?
Resmî veriler üçlü sürüme ait ve model, düşünme modundaki 15 benchmark'ta ortalama 80.49 puan alıyor. Öne çıkan sonuçlar şöyle:
| Benchmark | Skor | Ölçtüğü alan |
|---|---|---|
| MATH-500 | 99.20 | Okul düzeyinden yarışma düzeyine matematik |
| AIME 2025 | 90.84 | Zor yarışma matematiği |
| HumanEval+ | 93.90 | Kod üretimi |
| BFCL v3 | 74.41 | Fonksiyon/araç çağırma |
Bu skorlar yan yana konduğunda Bonsai 27B'nin karakteri netleşiyor. Matematik ve kodlama 90'lı puanlarda; araç çağırma ise 70'lerde kalıyor. Modele güvenmeden önce anlaşılması gereken en kritik nokta bu: Kuantizasyon, muhakeme ve kod yeteneğini; ajan tabanlı iş akışlarının ihtiyaç duyduğu yapılandırılmış, çok adımlı davranıştan çok daha iyi koruyor.
Bu rakamlar PrismML'nin kendi sonuçları olduğu için, bağımsız benchmark'lar çoğalana kadar bunları nihai hüküm değil başlangıç noktası olarak görmek gerekiyor. 80.49 ortalamasının gizlediği asıl sinyaller görev bazındaki skorlarda ve kullanıcıların karşılaştığı hata türlerinde. İlk testleri yapan bazı kullanıcılar, üçlü sürümün zaman zaman muhakeme döngülerine takıldığını bildirdi. Ayrıca aşırı kuantizasyon, tek görev skorlarının işaret ettiğinden daha fazla biçimde uzun bağlam kararlılığını zayıflatma eğiliminde. Modele güvenmeden önce kendi prompt'larınızla kısa bir test yapmak iyi fikir.
Hangi donanımda ne kadar hızlı?
Bu kadar agresif sıkıştırma, ancak çıkarım hızı günlük kullanım için yeterliyse anlamlı. Uygun donanımda yeterli hız sağlanıyor. Aşağıdaki değerler PrismML'nin kendi bildirdiği sonuçlar:
| Cihaz | 1-bit | Üçlü |
|---|---|---|
| iPhone 17 Pro | 11 tok/s | — |
| Apple M5 Max | 87 tok/s | 58 tok/s |
| NVIDIA RTX 5090 | 163 tok/s | 134 tok/s |
Telefonda saniyede 11 token, sohbet ve kısa muhakeme görevleri için yeterli; ama çok hızlı sayılmaz. M5 Max üzerinde 87 token/saniye ise ağ gidiş-dönüş gecikmesi de hesaba katıldığında, kısa prompt'larda yerel çıkarımın bulut API çağrısından hızlı olabileceği anlamına geliyor. PrismML'nin başarısını ifade etme yollarından biri de zekâ yoğunluğu, yani gigabayt başına benchmark skoru. Bonsai burada yaklaşık 0.53 değerine ulaşıyor; bu da tam hassasiyetli bir temel modele göre yaklaşık on kat anlamına geliyor.
Bonsai 27B'yi bugün çalıştırmanın dört yolu
Ağırlıklar açık olduğu için tek bir "kurulum" yöntemi yok. Sıfır kurulumdan tam kontrole uzanan, bugün kullanılabilen dört seçenek bulunuyor.
iPhone'da çalıştırmak
Locally AI iOS uygulaması, 1-bit ve 3,9 GB'lık sürümü doğrudan cihazda çalıştırıyor; hesap ya da sunucu gerekmiyor. "Telefonda 27B" iddiasını gerçekten karşılayan yol bu. Ağırlıklar indirildikten sonra tamamen çevrimdışı çalışıyor.
Tarayıcıdan denemek
PrismML, 1-bit modeli hiçbir kurulum olmadan tarayıcı sekmesinde çalıştıran WebGPU çekirdekleri yayınlıyor. Disk alanı ayırmadan önce Bonsai 27B'yi denemenin en hızlı yolu bu; ancak WebGPU destekli bir GPU'ya sahip bir makine gerekiyor.
Kendi bilgisayarınızda çalıştırmak
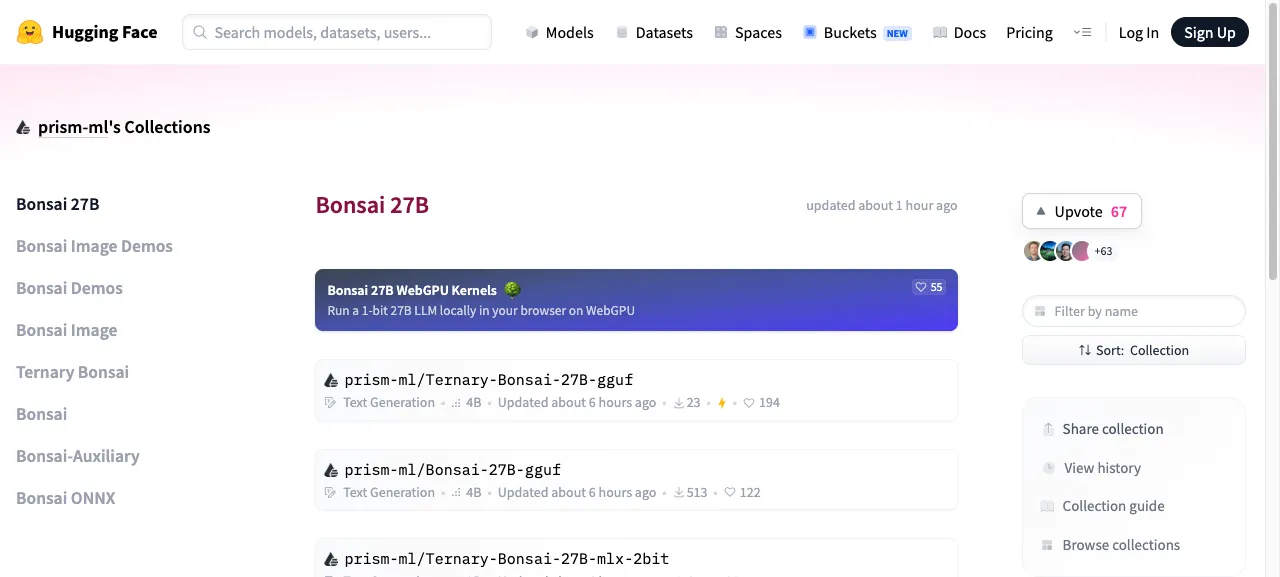
GGUF, MLX ve ONNX ağırlıklarının tamamı Apache 2.0 lisansıyla Hugging Face ve GitHub üzerinde bulunuyor. Ana depolar prism-ml/Bonsai-27B-gguf (1-bit) ile prism-ml/Ternary-Bonsai-27B-gguf (üçlü); bunlara ek olarak MLX 2-bit ve ONNX sürümleri de var. 1-bit sürüm için yaklaşık 4 GB boş depolama ve RAM, üçlü sürüm içinse 6 GB ayırın. Yine de bir uyarı gerekli: Araç ekosistemi modelin yayın hızına henüz yetişmiş değil. Ağırlıklar çeşitli çalışma ortamlarında yüklenebiliyor, fakat LM Studio gibi popüler yerel uygulamalarda tam destek çıkış sırasında henüz yoktu. Bu yüzden bir miktar manuel kurulum bekleyin.
Barındırılan API üzerinden kullanmak
Ağırlıkları kendiniz yönetmek istemiyorsanız, Together.ai üçlü sürümü standart bir API üzerinden sunuyor. Tam 262K bağlam penceresi, görsel girdi ve JSON modu destekleniyor. Lansman kampanyasında girdi fiyatı milyon token başına $0.00 olarak listelenmişti. Kampanya fiyatları değişebildiği için bütçe yapmadan önce güncel fiyatı kontrol edin.
Bonsai 27B ve Gemma 4 12B QAT karşılaştırması
En sık gündeme gelen karşılaştırma, Google'ın quantization-aware-trained modeli Gemma 4 12B QAT ile yapılıyor. Bu model yaklaşık 7 GB boyutunda; Bonsai'nin üçlü sürümünden yalnızca biraz daha büyük.
İki model farklı alanlarda öne çıkıyor. 27B tabanı sayesinde Bonsai 27B, matematik ve kodlama benchmark'larında Gemma'yı açıkça geride bırakıyor. Gemma ise görsel görevlerde ve araç çağırmada daha iyi dayanma eğiliminde; biraz daha büyük ve daha az agresif sıkıştırılmış ağırlıkları, onu telefonda daha dengeli bir genel amaçlı seçenek hâline getiriyor. Cihaz üzerindeki iş yükünüz muhakeme ve kod ağırlıklıysa Bonsai daha güçlü tercih. Görseller veya fonksiyon çağırma öne çıkıyorsa Gemma 4 12B QAT daha güvenli seçenek.
Bonsai 27B kimler için mantıklı?
Çevrimdışı, gizli ve cihaz üzerinde çalışan bir muhakeme ya da kodlama yardımcısı istiyorsanız; ayrıca iPhone 17 Pro sınıfında bir cihazınız veya güçlü bir dizüstünüz varsa Bonsai 27B size göre. Aşırı kuantizasyonla ilgilenenler için de dikkat çekici bir inceleme konusu: 27B modelin bir tarayıcı sekmesinde çalışabilmesi gerçek bir dönüm noktası ve açık Apache 2.0 lisansı denemeyi kolaylaştırıyor. Yerel bir seçeneğe ihtiyaç duyduğunuzda, programlama için çalıştırmaya değer diğer açık ve ücretsiz modellerin yanında doğal bir yere sahip.
Ancak güvenilir araç çağırmaya bağımlı üretim ortamındaki ajan sistemlerinde, görsel kalitenin kritik olduğu işlerde veya muhakeme döngüsüne girmenin maliyetli olacağı senaryolarda şimdilik kullanmayın. Bu kullanım alanlarında daha az sıkıştırılmış bir model ya da API üzerinden tam hassasiyetli bir model daha güvenli tercih olmaya devam ediyor.
Sık sorulan sorular
Bonsai 27B ücretsiz mi?
Ağırlıklar Apache 2.0 lisansıyla ücretsiz; dolayısıyla modeli indirip ücretsiz çalıştırabilirsiniz. Together.ai üzerinden barındırılan erişimin ise kendi API fiyatlandırması var. Lansman sırasında milyon girdi token'ı başına $0.00 olarak listelenmişti; güncel fiyatı doğrulamanız gerekir.
Bonsai 27B gerçekten telefonda çalışıyor mu?
Evet. 1-bit sürüm 3.9GB boyutunda ve Locally AI uygulaması üzerinden iPhone 17 Pro'da saniyede yaklaşık 11 token hızında çalışıyor. İndirildikten sonra tamamen çevrimdışı kullanılabiliyor.
Bonsai 27B, tam Qwen3.6 27B kadar iyi mi?
Yakın, fakat aynı değil. Üçlü sürüm tam hassasiyetli benchmark performansının %95'inden fazlasını, 1-bit sürüm ise %90'ından fazlasını koruyor. Koruma matematik ve kodda en yüksek, araç çağırmada ise en düşük seviyede.
Hangi Bonsai 27B dosyasını indirmeliyim?
Telefon veya belleği kısıtlı bir sistem için 1-bit sürümü tercih edin: prism-ml/Bonsai-27B-gguf, yaklaşık 3.9GB. Alan sorununuz olmayan masaüstü veya GPU sistemlerinde, birkaç puanlık ek doğruluk için üçlü sürümü indirin: prism-ml/Ternary-Bonsai-27B-gguf, yaklaşık 5.9GB. Apple Silicon ve platformlar arası çalışma ortamları için MLX 2-bit ile ONNX çeşitleri de mevcut.
Üçlü kuantizasyon nedir?
Modeldeki her ağırlığı tam hassasiyetli bir sayı yerine üç değerden biri olarak saklama yöntemidir: -1, 0 veya +1. Modelin bu kadar küçülmesinin nedeni de bu. FP16 ölçek katsayıları, sıkıştırılmış ağırlıkların yaklaşık doğru büyüklükte kalmasını sağlar.
Bonsai 27B görsel desteği sunuyor mu?
Evet. Qwen3.6 27B temel modelinden devraldığı çok modlu yetenek sayesinde metnin yanında görsel girdi de kabul ediyor ve metin çıktısı üretiyor. Ancak sıkıştırma altında görsel kalite, matematik ve kodlama performansı kadar iyi korunmuyor.