 AIREITER
Mac mini локально сгенерировал 38,5 секунды аудио за 2,81 секунды — без облака и без счёта за API. Именно так сегодня описывают ZONOS3-Mini от Zyphra: модель синтеза речи с 800 млн параметров, выпущенная 9 ноября 2026 года, при этом на каждом шаге активны лишь около 100 млн параметров благодаря архитектуре mixture-of-experts. Но есть важная оговорка: ранние тесты в основном проводились на английском и мощном железе. Реальный результат будет зависеть от текста, языка и вашей видеокарты.
Что умеет ZONOS3-Mini и где его запускать
ZONOS3-Mini — модель TTS от Zyphra с zero-shot-клонированием голоса: достаточно передать текст и короткий эталонный аудиофрагмент, чтобы получить речь в нужном голосе. Если клонировать голос не требуется, можно выбрать один из 27 готовых вариантов и настроить возраст, акцент и тембр. Веса распространяются по Apache 2.0, а код рантайма — по MIT, поэтому модель можно использовать локально и в коммерческих проектах. Разумеется, клонировать следует только собственный голос или голос, на использование которого у вас есть разрешение.
Внутри — разреженная MoE-архитектура с 64 экспертами и маршрутизацией top-2, а также 11 слоёв в пропорции 3:1 между Gated DeltaNet и глобальным attention. Новая версия аудиокодека Zyphra Audio Codec 1 (ZAC-1) работает на частоте 15 кадров в секунду вместо DAC с его 86 Гц в ZONOS2. По данным Zyphra, это сокращает количество речевых токенов с 774 до 150 в секунду и при сопоставимых данных даёт примерно в 10 раз меньший word error rate, чем DAC.
Основные характеристики: выходное аудио 44,1 кГц, генерация длительностью до 10 минут, эталонные записи для raw-клонирования длиной до 60 секунд и для embedding-клонирования — до 120 секунд. На обучение ушло 2,5 дня работы 112 видеокарт NVIDIA H100.
Запустить модель можно пятью способами:
- в браузерной WebGPU-песочнице без установки
- нативно через C++/ggml на CPU, CUDA, Metal или Vulkan
- через сервер Apple MLX
- на серверах NVIDIA с SGLang или vLLM
- через облачный API Zyphra с моделью
zyphra/zonos3-miniи OpenAI-совместимой конечной точкой/v1/audio/speech
По данным производителя, время до первого аудиосигнала составляет менее 570 мс в браузере на Pixel 9 и менее 150 мс на M3 MacBook Air. Для одного H100 с SGLang заявлены медианные значения 57–80 мс и пиковая производительность до 457 аудиосекунд в секунду. Показатели для телефона и ноутбука стоит воспринимать как лучший сценарий. В собственной публикации о запуске Zyphra приводила более осторожные оценки — менее 800 мс и менее 450 мс для тех же устройств. Перед тем как что-либо обещать пользователям, проверьте результат на своём железе.
В материалах о запуске остаются как минимум два пробела. В технической статье говорится о 800 млн параметров, тогда как на странице модели указано 886 млн. Кроме того, нигде не описаны водяные знаки, механизмы защиты от злоупотреблений и политика хранения загруженных эталонных голосов.
Сначала попробуйте браузерную версию
Браузерная песочница выполняет инференс на собственной видеокарте пользователя через WebGPU — без сервера и установки. Но первый запуск не такой мгновенный, как может показаться: один из первых тестировщиков сообщил, что страница сначала загружает около 920 МБ модели и кодека. После этого данные кэшируются браузером.
Песочница — хороший бесплатный способ начать: проверьте клонирование и управление отдельными фрагментами, а затем измерьте задержку на самом слабом устройстве, которое планируете поддерживать. Поведение WebGPU заметно зависит от браузера, драйвера и GPU.
«Не нужно каждый раз объявлять смерть облачного TTS, когда небольшая модель начинает работать в браузере! Совместимость WebGPU между браузерами и драйверами полна подводных камней. То, что английская демоверсия звучит отлично, ничего не говорит о том, переживёт ли ваш рабочий текст такой же тест!» — @GKev1n, реальный пользователь предостерегает от замены облачного TTS только на основании демо
Если аудитория использует старые телефоны, встроенную графику или браузеры не на Chromium, не переносите показатель Pixel 9 на эти устройства без собственных тестов.
Клонирование без расшифровки и управление каждой фразой
- Zero-shot-клонирование: до 60 секунд эталонного аудио, причём расшифровка не нужна. Raw-режим даёт наиболее естественный результат, а многоразовое embedding-представление голоса можно дополнительно настраивать.
- Дизайн голоса: настройка возраста, переход от мужской к женской манере звучания, американский, британский и австралийский акценты, а также комбинируемые характеристики вроде мягкого, хриплого, яркого и глубокого тембра.
- Управление подачей: темп, эмоции, силу голоса, живость, возбуждённость и шёпот можно задавать вплоть до отдельных слов. Например, прошептать только «Я не говорил», оставив остальную фразу нейтральной.
- Редактирование после генерации: модель в стиле VoiceCraft меняет слова уже в готовой записи, сохраняя голос и настройки. Ошибка в одном имени не требует рендерить весь фрагмент заново.
У Zyphra есть важное уточнение: параметры эмоций и подачи — это целевые значения, а не гарантия результата. Управление темпом может одновременно менять громкость и высоту тона, а настройка живости — высоту тона и длительность.
Опубликованные тесты: скорость, VRAM и две проблемы Windows
| Конфигурация | Результат | Источник |
|---|---|---|
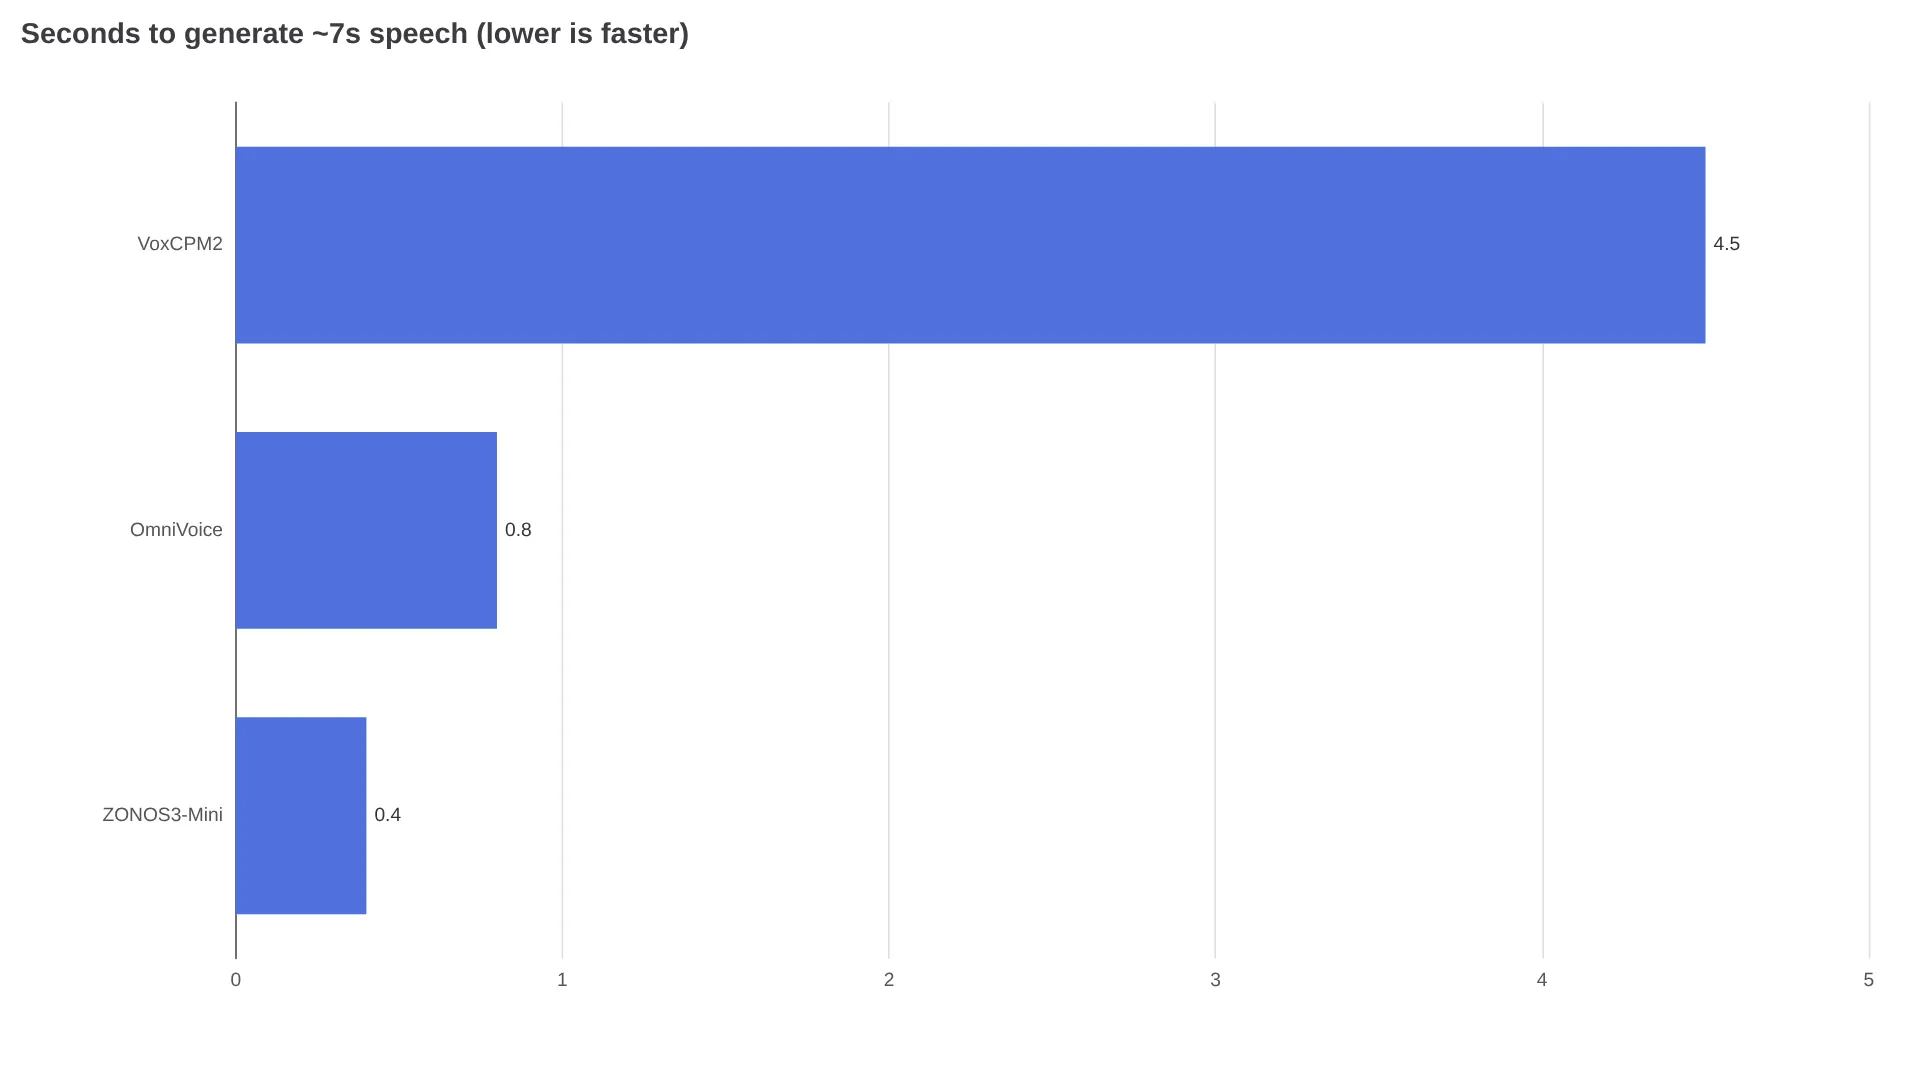
| RTX 5080, квантованная версия ggml (бэкенд 0,66 ГБ + декодер 0,45 ГБ) | Около 7,1 с японской речи за 0,40 с; всего 2,4 ГБ VRAM — коэффициент реального времени 0,056, примерно в 18 раз быстрее реального времени | тест VRAM16 |
| Та же система: фрагмент на 31 с; 7,2-секундный фрагмент только на CPU | 1,50 с при 2,5 ГБ на GPU; CPU потратил 1,45 с на вычисления, а от запуска до завершения прошло 2,38 с | тест VRAM16 |
| Mac mini с M5 Pro и 64 ГБ, сервер MLX | 38,5 с аудио за 2,81 с; 75–100 мс до первого аудио; около 16 ГБ пикового использования при первом клонировании | @pratikg |
На GPU этот тест примерно вдвое быстрее предыдущего результата OmniVoice и с большим отрывом опережает показатель VoxCPM2 — 0,63x от реального времени.
Полная версия декодера увеличила потребление до 4,2 ГБ, однако тестировщик не смог подтвердить на слух, что это дало какой-либо заметный эффект. Расшифровки через Whisper large-v3 совпали с исходным японским и английским текстом. Это подтверждает разборчивость, но не доказывает естественность речи или сходство с эталонным голосом.
Самый быстрый опубликованный локальный результат получил пользователь Apple Silicon на Mac mini с M5 Pro и 64 ГБ памяти, используя сервер MLX:
«ТЕСТИРОВАНИЕ: ... работает до 13,7 раза быстрее реального времени. Это мой Mac mini с M5 Pro и 64 ГБ памяти (полностью локальный запуск через их MLX-сервер): около 75–100 мс до первого аудио (TTFA) со стандартными голосами. Аудиофайл длительностью 38,5 с сгенерирован за 2,81 с. Новый голос был клонирован из аудиофрагмента на 11–13 с, после чего начал говорить примерно через 1,3 с. ... WER составил 0–4%. Использовалось всего несколько гигабайт памяти (около 16 ГБ на пике при первоначальном клонировании голоса)». — @pratikg, реальный пользователь с опубликованным набором данных и заметками
Обратите внимание на важную деталь: при первом клонировании потребление памяти доходило примерно до 16 ГБ, тогда как уже закэшированные голоса работали с той же скоростью, что и стандартные. Если планируете пакетно клонировать много дикторов, ориентируйтесь на пиковое, а не на обычное потребление.
При сборке исходников в Windows тестировщик VRAM16 столкнулся с двумя проблемами и подготовил патчи. Компилятор Microsoft отклонил структуру, в которой член назывался так же, как и head; GCC и Clang такой код приняли. Поэтому с предоставленным патчем переименования следует собирать только zonos3-cli, zonos3-server и spk-encoder-cli. Отдельно японская Windows передаёт текст командной строки в CP932, а не UTF-8, из-за чего получается искажённый звук. Проблема исчезает, если программа повторно считывает командную строку через GetCommandLineW. UTF-8 в JSON-запросах к zonos3-server должен работать, но это не проверялось.
Практические советы по установке: используйте путь без пробелов и не-ASCII-символов, например C:\zonos3; установите Visual Studio 2022 с инструментами C++, а также Git и FFmpeg. Чистая настройка CUDA занимает около пяти минут и требует примерно 1,2 ГБ стандартных весов плюс около 2 ГБ локальных компонентов CUDA (инструкция по установке).
Расчёт стоимости API: что дают $10 за миллион UTF-8-байт
Облачный вариант — OpenAI-совместимая конечная точка синтеза речи https://api.zyphracloud.com/api/v1/audio/speech. Для запроса используется модель zyphra/zonos3-mini и bearer-токен ZYPHRA_API_KEY. Приведённый ниже пример запускает локальный SGLang-Omni-сервер (рецепт SGLang) с той же структурой запроса, что и облачный API. В этом и заключается удобство: прототип можно собрать на localhost, а затем заменить базовый URL на Zyphra Cloud.
sgl-omni serve --model-path Zyphra/ZONOS3-Mini --port 8000

curl -X POST http://localhost:8000/v1/audio/speech \
  -H "Content-Type: application/json" \
  -d '{"input": "Hello from ZONOS3-Mini!"}' \
  --output output.wav
Тарификация идёт по количеству байт, а не символов или минут аудио: $10,00 за 1 млн UTF-8-байт. Ограничения тарифа — 1 одновременный запрос, 100 генераций в день, неограниченная длина входного текста и уже упомянутые лимиты клонирования в 60/120 секунд. Для обычного английского, где на символ приходится примерно один байт, при допущении 800–900 символов на минуту речи $10 хватит примерно на 1 100–1 250 минут — меньше цента за минуту. С текстами CJK математика заметно менее выгодна: один символ занимает около трёх байт, то есть примерно в 3 раза дороже. Для китайского, японского и корейского текста лучше самостоятельно посчитать стоимость минуты.
После покупки железа локальный или браузерный инференс почти не имеет предельной стоимости. Облачный тариф удобен для прототипов и кратковременных нагрузок, но при одном одновременном запросе и 100 генерациях в день он не рассчитан на промышленный масштаб. Командам, которым нужна высокая пропускная способность, стоит считать стоимость собственного развёртывания SGLang или vLLM, а не просто умножать показатель $10.
Сравнение с ElevenLabs, Fish, Qwen и значком «№1»
На страницах Zyphra ZONOS3-Mini сравнивается с Fish Audio, Qwen, Cartesia, ElevenLabs и OmniVoice на трёх сценариях: драматический монолог для трейлера, длинный комедийный текст про «прямиком в тюрьму» для проверки стабильности и разговорный фрагмент в стиле подкаста. Там же есть график Парето с задержкой и пропускной способностью. Эти примеры стоит послушать самостоятельно. На страницах есть проигрыватели, но нет текстового итогового рейтинга, версий конкурирующих моделей, seed-значений или заявления о сопоставимости настроек.
К числовому рейтингу нужно относиться так же осторожно. Тест ZTTS2-Eval от Zyphra охватывает 35 языков в чистых условиях и 20 языков в реальных сценариях — всего 420 сочетаний метрики, набора данных и языка. В Capability Index ZONOS3-Mini занимает первое место среди открытых моделей, опережая Fish S2 Pro и MOSS TTS v1.5. Но это всё равно производитель оценивает собственную работу собственным новым тестом. Методика опубликована, однако на момент подготовки обзора независимого воспроизведения не было, а сравнения с закрытыми моделями основаны только на аудио и не имеют общей числовой оценки.
Поскольку Zyphra не публикует оценки по отдельным языкам и независимые результаты прослушивания, точность тонов в мандаринском, японское pitch accent, омографы с несколькими вариантами чтения и эмоциональная подача в длинных текстах остаются непроверенными. Перед внедрением протестируйте их сами. Честный вывод такой: ZONOS3-Mini выглядит сильным решением по эффективности и гибкости развёртывания, но лидерство по качеству пока не доказано.
Кому уже стоит переходить
| Команда | Вердикт | Почему |
|---|---|---|
| Офлайн-, on-device- и чувствительные к приватности проекты (игры, читалки, киоски) | Тестировать сейчас | Apache 2.0, загрузка по умолчанию 1,2 ГБ, 2,4 ГБ VRAM, работа на CPU, отсутствие поминутной тарификации |
| Проекты аудиокниг или NPC с большим количеством голосов | Запустить пилот | Управление отдельными словами и редактирование после генерации сокращают число повторных рендеров, но сходство нужно проверить для каждого диктора |
| Продакшен на неанглийских языках, особенно на китайском | Ждать собственной оценки | Нет оценок производителя по отдельным языкам; заявления о word error и просодии остаются в основном англоязычными, пока вы не проверите омографы и тоны |
| Высоконагруженный облачный TTS | Разворачивать самостоятельно или оставаться на текущем решении | Облачный тариф ограничен 1 одновременным запросом и 100 генерациями в день; для продакшена нужен SGLang/vLLM |
| Команды, которым нужны водяные знаки или аудит | Пока не переходить | В материалах релиза не описаны водяные знаки и политика хранения эталонных записей |
Проверяйте модель в таком порядке: браузерная песочница, локальная сборка на самом слабом устройстве, затем hosted API. Переходите только если ваше железо проходит порог 2,4 ГБ VRAM и WebGPU, а нужный язык успешно выдерживает слепое прослушивание. В противном случае оставайтесь на текущем закрытом API и вернитесь к вопросу после появления независимых мультиязычных тестов.
FAQ
Сколько VRAM нужно ZONOS3-Mini?
Около 2,4–2,5 ГБ в общей сложности на протестированной RTX 5080 (с полным декодером — 4,2 ГБ; при первоначальном клонировании на Mac — пик около 16 ГБ).
Работает ли модель в браузере или на CPU?
Да. Для WebGPU при первом посещении требуется загрузка примерно 920 МБ, а синтез только на CPU в единственном опубликованном тесте занял около трети реального времени с учётом запуска.
Насколько хорошо работает клонирование голоса?
Zero-shot-клонирование выполняется по записи длиной до 60 секунд без расшифровки. Один независимый тест показал word error 0–4%, но сходство с голосом конкретного диктора нужно проверять самостоятельно.
Можно ли использовать модель в коммерческих проектах?
Веса распространяются по Apache 2.0, а код — по MIT, но для клонирования любого голоса необходимы права или согласие владельца.
Как выглядит API и сколько он стоит?
OpenAI-совместимый запрос POST https://api.zyphracloud.com/api/v1/audio/speech с моделью zyphra/zonos3-mini стоит $10 за миллион UTF-8-байт (1 одновременный запрос, 100 в день).
Читайте также: Лучший API для синтеза речи, Лучший API для клонирования голоса в 2026 году, Kokoro 82M TTS: локальное руководство