 AIREITER
Название Unlimited OCR звучит так, будто модель способна переварить документ любой длины. На практике ориентироваться стоит на другое число: в поставляемом Baidu конфиге max_position_embeddings ограничен 32 768. Модель действительно заменяет постраничный OCR-цикл одним прямым проходом, но лишь пока документ укладывается в бюджет 32K токенов и сканы остаются достаточно чистыми.
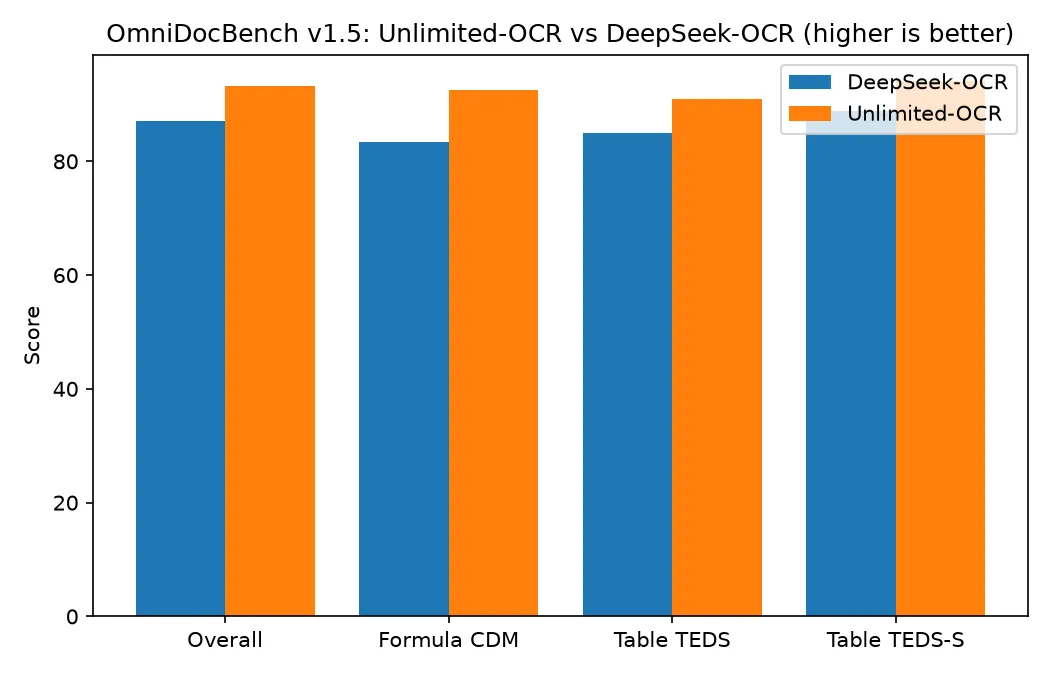
Впрочем, релиз заметно интереснее этой оговорки. Веса распространяются по лицензии MIT, метаданные safetensors указывают 3 336 106 240 параметров в BF16, а на OmniDocBench v1.5 модель получает 93,23 балла против 87,01 у DeepSeek-OCR — базовой модели, на которой она построена. По состоянию на 2026-07-29 за предыдущие 30 дней у неё было 2 694 935 скачивания на Hugging Face и 3 389 лайков.
Почему Unlimited OCR не безлимитна
В режиме многостраничного документа каждая страница кодируется в разрешении 1024×1024 и сжимается в 16 раз — примерно до 256 визуальных токенов. Поэтому лимит страниц можно прикинуть ещё до написания кода.
| Страниц за один проход | Визуальные токены (prefill) | Остаётся на вывод | Бюджет на страницу |
|---|---|---|---|
| 10 | ~2 560 | ~30 200 | ~3 020 |
| 20 | ~5 120 | ~27 600 | ~1 380 |
| 40 | ~10 240 | ~22 500 | ~560 |
Презентация или договор с небольшим количеством текста спокойно помещаются в 40 страниц. Но плотная газетная полоса в две колонки сама по себе может занять больше 560 markdown-токенов, и для таких документов практический предел будет существенно ниже 40 страниц. В статье это сказано прямо: при конечной длине контекста парсинг не может быть по-настоящему безлимитным, поскольку prefill всё равно растёт с числом страниц. В roadmap Baidu заявлены версия с контекстом 128K и «prefill pool», подгружающий фрагменты страниц по запросу. Unlimited здесь означает неограниченную длину декодирования относительно размера кеша, а не неограниченное количество страниц.
Что даёт R-SWA — и чего она не исправляет
По сравнению с DeepSeek-OCR изменились две вещи. Визуальный стек DeepEncoder — каскад SAM-ViT-B и CLIP-L — сохранён и во время обучения оставался замороженным. Во всех слоях внимания декодера обычный механизм заменили на Reference Sliding Window Attention: каждый генерируемый токен видит все reference-токены, то есть визуальные токены и промпт, но среди уже сгенерированного текста учитывает только последние 128 токенов. Это подтверждает config.json: sliding_window_size: 128, 12 слоёв декодера, 64 маршрутизируемых эксперта, из которых на токен активны 6.
Улучшения не точечные: они заметны именно в элементах страницы, которые страдают при длинной генерации. На OmniDocBench v1.5 показатель CDM для формул вырос с 83,37 до 92,61, table TEDS — с 84,97 до 90,93, а edit distance порядка чтения сократился вдвое: с 0,086 до 0,045. Поскольку энкодер не переобучали, эта разница связана с декодером, а не с более сильным визуальным стеком.
Но слабости энкодера никуда не исчезли. Более длинная генерация не улучшит распознавание символов на выцветшем факсе.
Ускорение заметно только на длинном выводе
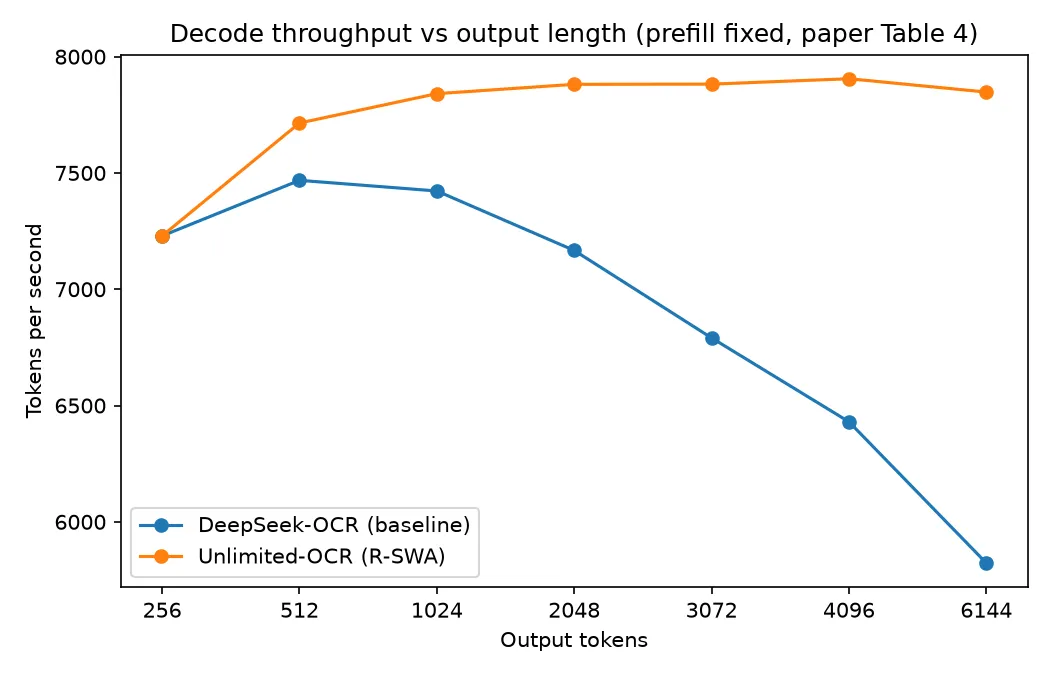
При 256 выходных токенах модели практически одинаковы: 7 229,52 против 7 229,32 токена в секунду. Разрыв появляется по мере генерации: на 6 144 выходных токенах базовая модель замедляется до 5 822,87, тогда как Unlimited OCR удерживает 7 847,71 — примерно на 35% быстрее.
В полном прогоне OmniDocBench в base-режиме при concurrency 512 преимущество сокращается до 12,7%: 5 580 против 4 951 токена в секунду. При батчинге уже скрыта значительная часть стоимости внимания на каждом шаге. Поэтому обработка одностраничных счетов при высокой concurrency почти ничего не выигрывает от R-SWA.
До 40 страниц точность держится, затем кривая идёт вверх
В статье приведена зависимость edit distance от числа страниц в одном проходе — и она далека от горизонтальной линии.
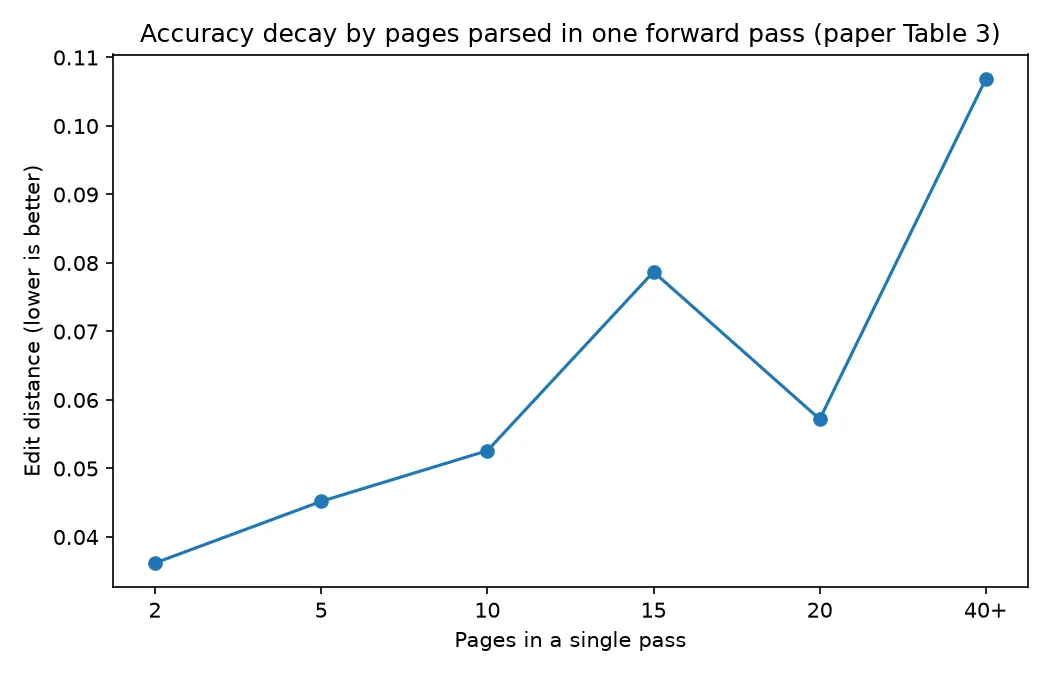
На двух страницах показатель составляет 0,0362, на десяти — 0,0526. При 40 и более страницах он достигает 0,1069, а Distinct-35 падает примерно с 99,9% до 96,90%: в выводе начинают повторяться n-граммы. Замер на 15 страницах — 0,0787 — хуже результата на 20 страницах, равного 0,0572, поэтому график стоит воспринимать как тенденцию, а не как гарантию для каждого числа страниц. Baidu связывает повторения в первую очередь с мелким текстом при базовом разрешении 1024×1024, а не с дрейфом внимания. Это согласуется с компромиссом модели: многостраничные документы и PDF не могут использовать режим кропов с повышенной детализацией, доступный одиночным изображениям.
Откуда берётся требование к VRAM, если «8 ГБ достаточно»
В рецепте для vLLM говорится, что для инференса BF16 достаточно одной GPU с 8 ГБ памяти или больше. Отчёты сообщества с этим не сходятся — и собственный конфиг модели объясняет почему.
Единственный файл safetensors занимает 6,673 ГБ. Размер кеша определяется четырьмя полями в config.json: num_hidden_layers: 12, num_attention_heads: 10, num_key_value_heads: 10, v_head_dim: 128, а также use_mla: false. Число query- и key/value-heads одинаково, то есть используется обычный MHA без разделения GQA или MQA, которое могло бы уменьшить расход. Получаем кеш на токен: 2 (K и V) × 12 слоёв × 10 heads × 128 измерений × 2 байта = 61 440 байт, или 60 KiB. Отсюда следуют три цифры:
- Полный prefill на 32K: 32 768 × 60 KiB = 1,875 GiB кеша
- Сторона декодирования R-SWA, ограниченная
sliding_window_size: 128: постоянные 7,5 MiB - Тот же декодер без R-SWA при 6 144 выходных токенах: 360 MiB, с линейным ростом
Это расчётные размеры кеша, а не пиковое выделение памяти: сверху добавляются активации визуального энкодера, фрагментация аллокатора и заранее зарезервированные блоки кеша движка. Поэтому веса вместе с длинным prefill быстро заполняют карту на 8 ГБ. В одном локальном запуске SGLang на RTX 4070 Ti Super с 16 ГБ сообщалось о потреблении около 12 ГБ. Это согласуется с расчётом, но не доказывает его. Цифру 8 ГБ стоит считать минимальным порогом для короткой одиночной страницы, а не спецификацией для сценария с 40 страницами.
Эти же числа задают реалистичные ожидания от R-SWA: на модели такого размера ограничение кеша декодирования экономит сотни мегабайт, а не гигабайты. Практический выигрыш в том, что стоимость внимания на каждом шаге перестаёт расти — именно это и показывает график производительности.
Официального API нет: как модель запускают на практике
На странице Hugging Face указано: «This model isn't deployed by any Inference Provider.» У модели нет собственного endpoint и страницы с ценами от Baidu. Для самостоятельного запуска есть три пути: Transformers с trust_remote_code, SGLang или рецепт vLLM. Последнему нужен vLLM 0.25.0 или новее из отдельного контейнера vllm/vllm-openai:unlimited-ocr, поскольку архитектура пока не входит в стабильный pip wheel.
Четыре настройки определяют, получите ли вы вообще какой-либо вывод:
- Зарегистрировать n-gram logits processor (
NGramPerReqLogitsProcessor). Без него длинные документы зацикливаются на токенах координат<|det|>. - Указать
ngram_size: 35иwindow_size: 128для одиночных изображений, а для многостраничного ввода или PDF —1024. - Текстовая часть должна начинаться с буквального токена
<image>, например:<image>Multi page parsing.Готового chat template у модели нет. - Передать
skip_special_tokens: False. При значении по умолчанию вы получите пустые строки.
Сырые генерации содержат разметку grounding. Чтобы получить чистый markdown, сохраняйте текст внутри <|ref|> и удаляйте bounding boxes <|det|>. Границы страниц модель тоже нативно не выводит, поэтому, если они нужны для аудита, попросите добавлять метки страниц в промпте.
Вот сервер и запрос из рецепта, для которых работа модели подтверждена:
docker run --rm --gpus all --network host --ipc host \
  vllm/vllm-openai:unlimited-ocr baidu/Unlimited-OCR \
  --trust-remote-code \
  --logits_processors vllm.model_executor.models.unlimited_ocr:NGramPerReqLogitsProcessor \
  --no-enable-prefix-caching --mm-processor-cache-gb 0
client.chat.completions.create(
model="baidu/Unlimited-OCR",
messages=[{"role": "user", "content": [
{"type": "text", "text": "<image>Multi page parsing."},
{"type": "image_url", "image_url": {"url": page_data_url}},
]}],
max_tokens=8192, temperature=0.0,
extra_body={"skip_special_tokens": False,
"vllm_xargs": {"ngram_size": 35, "window_size": 1024}},
)На картах Hopper используйте тег образа unlimited-ocr-cu129. Учтите также, что несколько изображений в одном запросе переключают модель в базовый режим без кропов — для этого случая нужен window_size: 1024.
Стоимость 1 000 страниц: свой сервер против managed API
Открытые веса бесплатны, но их запуск — нет. Один из немногих опубликованных практических замеров привёл разработчик в ветке Hacker News: через Transformers на RTX 4090 он обработал примерно 200 страниц японского учебника грамматики в час. Сопоставим это с арендой той же 4090 по Community-тарифу RunPod: $0,34 в час.
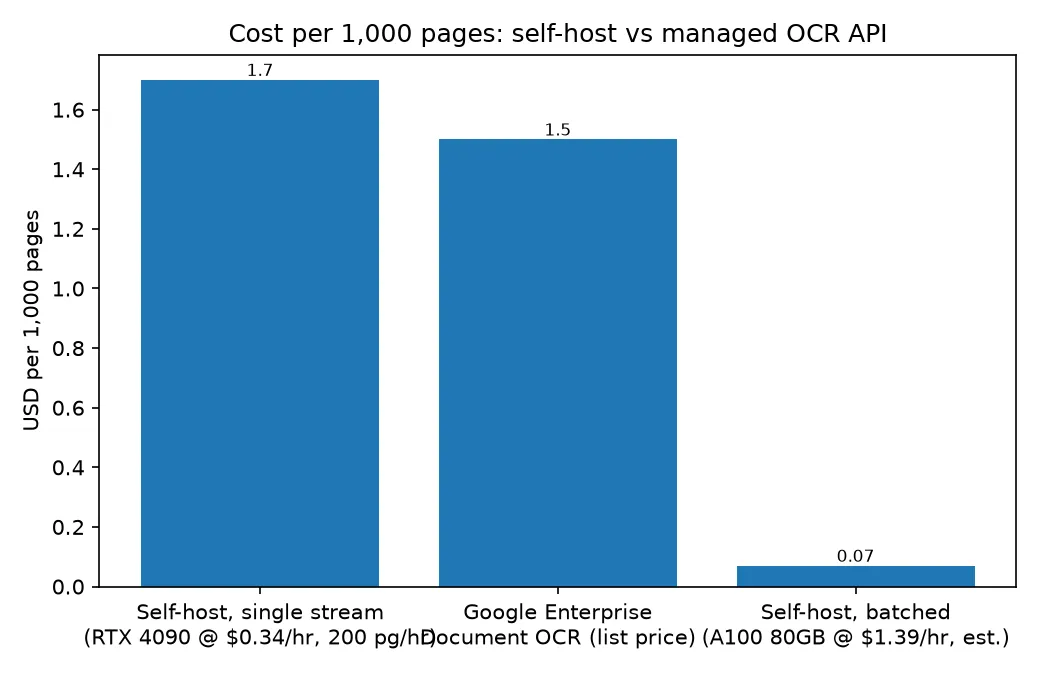
| Вариант | Стоимость 1 000 страниц |
|---|---|
| Собственный хостинг, один поток (4090 по $0,34/ч, 200 страниц/ч) | ~$1,70 |
| Google Enterprise Document OCR, от 1K до 5 млн страниц/месяц | $1,50 (прайс) |
| Google Layout Parser, тот же объём | $10,00 (прайс) |
| Собственный хостинг, нижняя граница при насыщенном батчинге (A100 80GB по $1,39/ч, модельный расчёт) | ~$0,07 |
Прайс-листы актуальны на 2026-07-29. Первые 1 000 страниц в месяц у Google бесплатны, а после 5 миллионов страниц ставка снижается до $0,60. Последняя строка — не замер, а расчётная нижняя граница, и она зависит от длины вывода. При заявленных в статье 5 580 токенах в секунду и concurrency 512, если на страницу приходится 700 выходных токенов, получается около 28 700 страниц в час ($0,05 за 1 000); при 1 000 токенов — примерно 20 000 ($0,07); для плотной страницы на 2 000 токенов — около 10 000 ($0,14). Эту скорость Baidu измеряла на собственном evaluation-кластере, а не на арендованной A100, поэтому в строке сопоставлены бенчмарк и цена аренды. В реальном развёртывании все три оценки вырастут после учёта простаивающих мощностей, повторных попыток для неудачных страниц, препроцессинга и хранения.
Одиночный поток на потребительской видеокарте обходится примерно в ту же цену, что и managed OCR от Google. Поэтому самостоятельный запуск выигрывает за счёт concurrency и хранения данных у себя, а не благодаря лицензии. И OCR — только половина задачи: чтобы превратить markdown в поля, нужен вызов текстовой модели с длинным контекстом. Там расчёт снова идёт по токенам, а не по страницам — независимо от того, запускаете ли вы её сами или используете что-то вроде GPT-5.6 API.
На каких документах модель ломается
Сообщаемые проблемы хорошо предсказывает замороженный энкодер. В том же запуске на 4070 Ti Super на чеках, рукописном тексте и сложных сканах появлялся искажённый вывод, пропущенные области и дрейф структуры, тогда как чистые печатные страницы распознавались нормально. Участники ветки Hacker News описывают типичные для VLM-OCR ошибки, особенно критичные для задач комплаенса: иностранные слова молча переводятся на английский, а рукописное имя «исправляется» на более вероятное написание. Это лишь два единичных наблюдения, а не измеренные показатели — их стоит включить в собственное тестирование.
Важно и правильно позиционировать модель. Unlimited OCR не возглавляет таблицы точности. В сводных листингах OmniDocBench PaddleOCR-VL-1.6 набирает 96,33 балла против 93,92 на v1.6 у модели Baidu; результат PaddleOCR заявлен самим вендором. В olmOCR-Bench модель вообще пока не представлена. То есть она конкурирует не по точности на отдельной странице.
Стоит ли запускать Unlimited OCR
Модель хорошо подойдёт, если ваш пайплайн сейчас обрабатывает страницы по одной, а затем склеивает текст; если документы изначально цифровые либо качественно отсканированы; если текущий OCR теряет межстраничную структуру — например, таблицы, разорванные переносом страницы.
Это плохой выбор, если вы ежедневно обрабатываете тысячи одностраничных счетов: постраничные пайплайны лучше батчатся и дешевле. Также модель не стоит брать, если заметную долю входящих данных составляют рукописный текст и сфотографированные чеки либо вам уже сейчас нужны SLA и audit trail, а не GPU и тег контейнера.
В любом случае сначала проведите тест. Достаточный минимум: 50 документов из собственного корпуса, разбитых по длине — 1–5 страниц, 6–20, 20 и более — и по качеству входных данных: изначально цифровые, чистые сканы, фотографии. Для 10 документов вручную подготовьте ground truth. Затем отдельно оцените character error rate, reading-order edit distance и table TEDS, не усредняя их, а также запишите wall-clock секунды на страницу на GPU, которую планируете арендовать. Сравните результаты с текущим решением на тех же 50 файлах и задайте порог там, где реально ломается следующий шаг пайплайна. Для извлечения полей это обычно структура таблиц, а не сырой CER. Для ориентира, насколько сильно оптимизация способна изменить показатель: одна команда, обрабатывающая PDF в enterprise-масштабе, сообщила о 0,94% character error rate после переписывания инференсного слоя на Rust.
FAQ
Unlimited OCR бесплатна?
Веса распространяются по лицензии MIT и бесплатно скачиваются с Hugging Face или GitHub, в том числе для коммерческого использования. Инференс не бесплатен: закладывайте примерно от $0,07 до $1,70 на 1 000 страниц в зависимости от эффективности батчинга, плюс время на инженерную работу.
Есть ли у Unlimited OCR официальный API?
Нет. На странице модели нет развёртывания через Inference Provider, поэтому любой найденный endpoint — это сторонний сервис, обслуживающий открытые веса. Цены и лимиты в таком случае устанавливает этот поставщик, а не Baidu.
Unlimited OCR — лучшая OCR-модель на сегодня?
Не по таблицам точности: PaddleOCR-VL-1.6 заявляет 96,33 на OmniDocBench против 93,92 у Baidu на v1.6, а у модели пока нет записи в olmOCR-Bench, поэтому её стабильность между бенчмарками не подтверждена. Её измеренное преимущество — обработка 40 страниц за один проход при edit distance 0,1069.
Можно ли запустить Unlimited OCR в Ollama?
Официальная карточка описывает только Transformers, vLLM и SGLang, а пользовательской архитектуре нужен trust_remote_code. На Hugging Face есть community-квантизации, но любую сборку для Ollama стоит считать непроверенной, пока вы не сравните её вывод с эталонным путём на собственных файлах.