 AIREITER
Для типовых очередей в Devin SWE-2 Flash выглядит очевидным вариантом по умолчанию: 200 токенов в секунду и стоимость в одну пятую от SWE-2. Но на задачах уровня Terminal-Bench 4.0 модель заметно отстаёт: 20,0% против 27,3% у SWE-2 и более 40% у лидеров.
Вердикт: Flash — для потока задач, SWE-2 — для сложных 10%
SWE-2 Flash лучше всего подходит на роль основной модели для большого объёма понятных инженерных задач внутри Devin. В обмен на отставание в отдельных бенчмарках она предлагает в 3 раза более высокую скорость генерации и существенно меньшие затраты на одну задачу.
| Тип задачи | Куда направлять | Почему |
|---|---|---|
| Автоматизация, ревью кода, небольшие функции, обновление документации | SWE-2 Flash | Cognition позиционирует SWE-2 Flash для повседневной работы; здесь скорость важнее глубокого планирования |
| Крупный рефакторинг, незнакомые репозитории, терминальная работа уровня Terminal-Bench-4.0 | SWE-2 | SWE-2 опережает SWE-2 Flash со счётом 27,3% против 20,0% в Terminal-Bench 4.0 и 73,0% против 60,1% в DeepSWE 1.1 |
| Задачи с повышенными требованиями к безопасности или on-premise-развёртыванию | Подождать | Веса SWE-2 Flash не опубликованы; обещана лишь будущая программа защищённой передачи партнёрам |
До 30 ноября 2026 года доступ в Devin Desktop и CLI предоставляется бесплатно, так что тестирование почти ничего не стоит. Начните с SWE-2 Flash на новых типовых очередях и оцените объём доработок, прежде чем переводить их на постоянную основу.
Что такое SWE-2 Flash: Inkling-Small и дополнительное обучение
SWE-2 Flash — быстрая модель для программирования от Cognition, построенная на базе Inkling-Small от Thinking Machines. В основе лежит смесь экспертов с 276B общих и 12B активных параметров, после чего Cognition провела отдельный этап дополнительного обучения перед reinforcement learning.
На этапе дополнительного обучения Cognition подбирала составы данных с помощью графиков эффективности использования токенов, а затем обучала модель на нескольких триллионах токенов в три фазы, оставив самые редкие данные напоследок. Потери на отложенной выборке снижались по стабильной лог-линейной кривой. Последующее reinforcement learning на проверенных задачах подняло результат в Terminal-Bench 4.0 с 0,9% до 20,0%, а в FrontierCode 2.0 — с 3,2% до 24,0%, сообщает Cognition в публикации от 4 ноября 2026 года. Также Cognition заявляет для SWE-2 Flash скорость 200 токенов в секунду против 60 токенов в секунду у SWE-2.
«Cognition выпустила SWE-2 Flash! Flash-модель на 276B общих и 12B активных параметров. Не думал, что мы увидим Flash-модель для SWE-2, так что удивлён, но впечатлён. На бенчмарках выглядит отлично — она не так уж далеко ушла от 2.8T-модели SWE-2». — @ItsmeAjayKV, первая реакция реального пользователя
Бенчмарки дают разную картину — смотрите на конкретный набор тестов
Результаты SWE-2 Flash заметно расходятся от одного набора тестов к другому. На структурированных задачах разработки модель выглядит уверенно, а на открытых терминальных сценариях ощутимо слабее. Поэтому усреднённый показатель здесь может вводить в заблуждение.
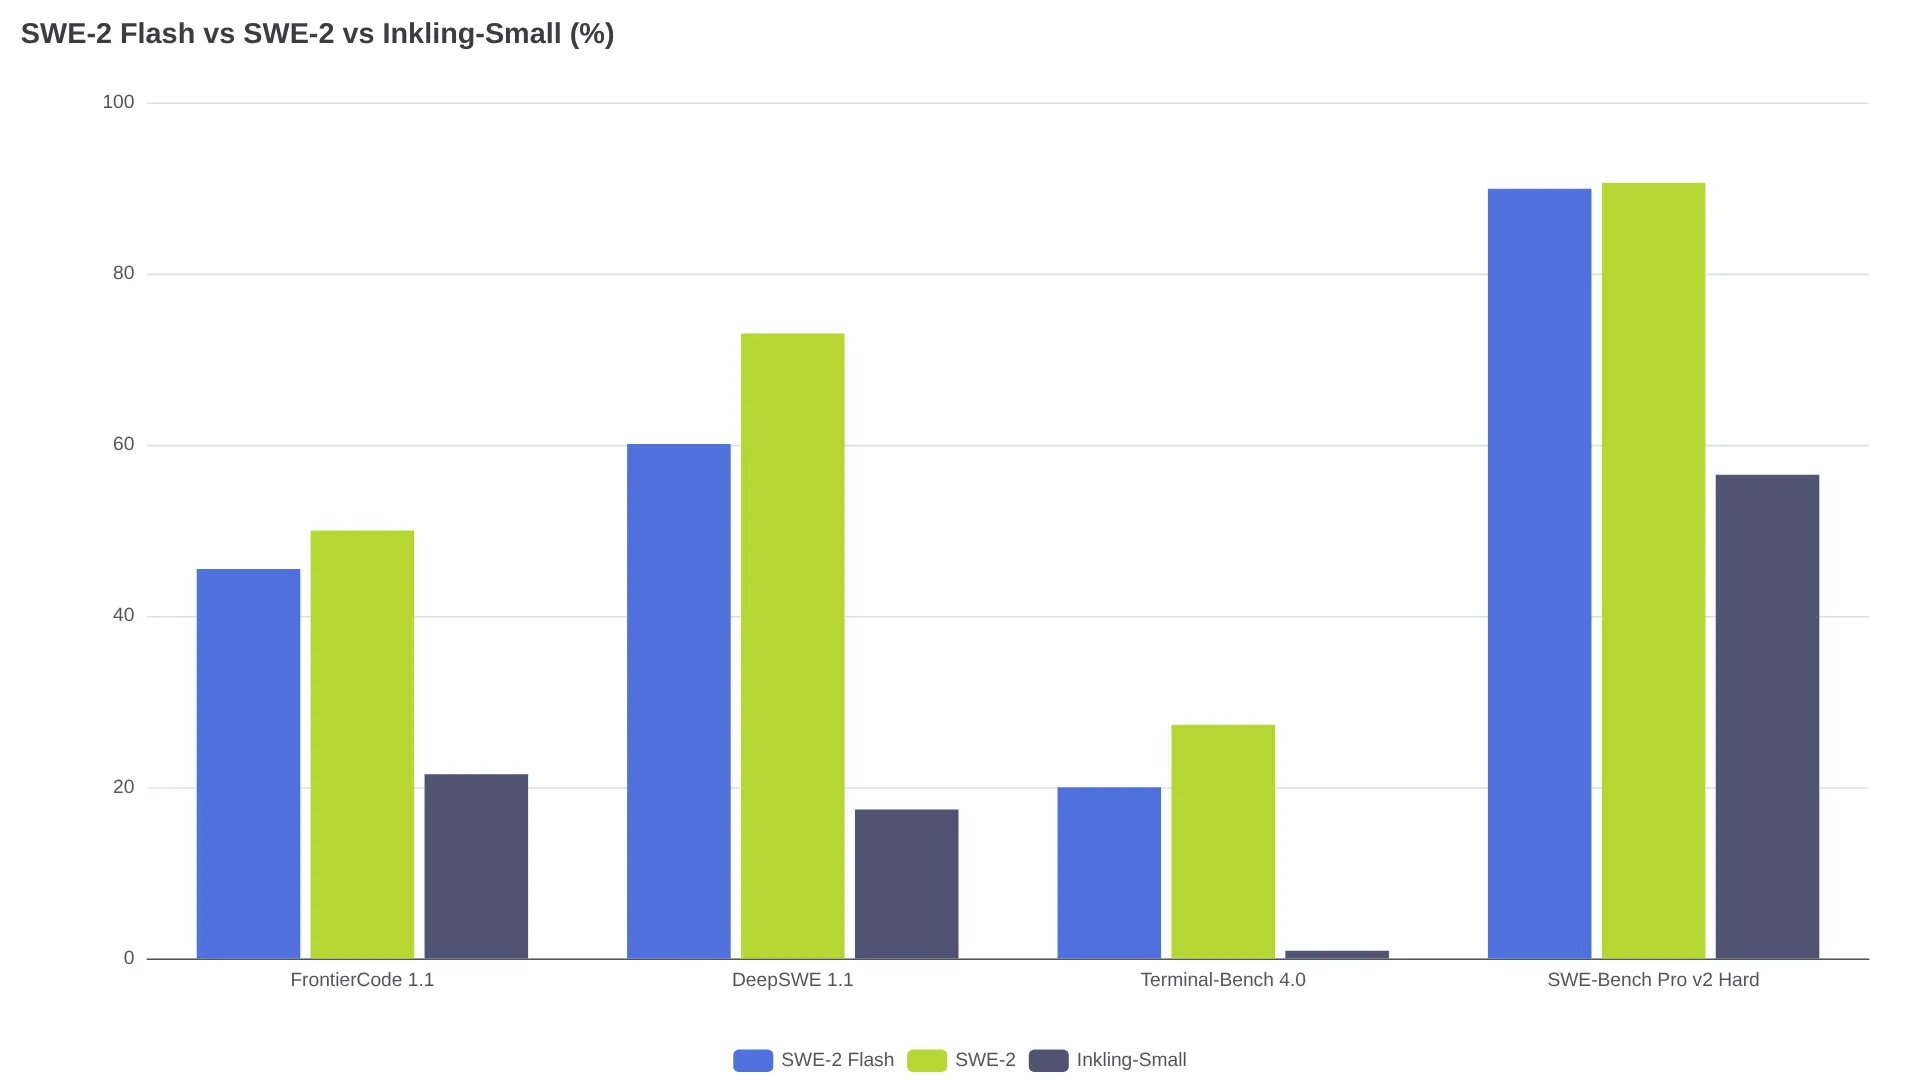
| Бенчмарк | SWE-2 Flash | SWE-2 (2.8T-A104B) | Inkling-Small | Лучший результат в таблице Cognition |
|---|---|---|---|---|
| FrontierCode 1.1 Main | 45,5% | 50,0% | 21,5% | 50,0% SWE-2 |
| FrontierCode 2.0 | 24,0% | 23,8% | 3,2% | 27,7% Claude Haiku 5.5 |
| DeepSWE 1.1 | 60,1% | 73,0% | 17,4% | 77,0% DeepSeek V4.1 Flash |
| Terminal-Bench 2.1 | 89,2% | 92,8% | 64,7% | 94,4% Claude Haiku 5.5 |
| Terminal-Bench 4.0 | 20,0% | 27,3% | 0,9% | 42,3% DeepSeek V4.1 Flash |
| SWE-Bench Pro v2 Hard | 89,9% | 90,6% | 56,5% | 90,6% SWE-2 |
| SWE-Atlas QA | 50,0% | 56,3% | 27,4% | 71,0% DeepSeek V4.1 Flash |
| ExploitBench | 34,8% | 36,1% | 11,3% | 44,7% GPT-6 Luna |
Прирост заметный, но не безграничный. На FrontierCode 1.1 Main SWE-2 Flash более чем вдвое опережает Inkling-Small (45,5% против 21,5%), а в SWE-Bench Pro v2 Hard поднимается с 56,5% до 89,9%, практически догоняя SWE-2 с результатом 90,6%.
Слабые места SWE-2 никуда не делись. Успех в SWE-Bench Pro не означает, что модель так же хорошо справляется с длинными терминальными сессиями: в той же таблице GLM 5.3 Flash набирает 41,8% в Terminal-Bench 4.0.
Заявление о превосходстве над open-weight-моделями требует оговорок. SWE-2 Flash опережает Muse Spark Open в большинстве строк: 60,1% против 60,0% в DeepSWE 1.1 и 24,0% против 6,2% в FrontierCode 2.0. Однако в Terminal-Bench 4.0, SWE-Atlas QA и DeepSWE 1.1 SWE-2 Flash уступает DeepSeek V4.1 Flash и GLM 5.3 Flash. Все цифры предоставлены разработчиками моделей; для каждой использовались лучшие настройки, а тестовые инструменты у разных поставщиков отличаются.
Что означает цена в одну пятую, если прайс-листа нет
Тарифа за токены не существует, потому что отдельного API-эндпоинта нет. Единственный ориентир — заявленное Cognition соотношение затрат на задачу: один роллаут SWE-2 Flash обходится в одну пятую стоимости роллаута SWE-2 с учётом модели, тестового окружения и инфраструктуры сервинга.
Но этой цифры недостаточно для расчёта бюджета. Cognition также не публиковала стоимость одной задачи для SWE-2; в разборе SWE-2 от OrcaRouter в качестве ориентиров приводятся лишь $3.28 за задачу FrontierCode для Fable 5.1 при среднем уровне усилий и $12.83 при максимальном. Указанные там тарифы Devin — Free $0, Pro $20 в месяц, Max $200 в месяц и Teams $80 плюс $40 за место — относятся к подписке, а не к оплате токенов. Поэтому пятикратно меньшая стоимость задачи не обязательно означает такой же размер счёта Devin.
На практике бесплатный период до 30 ноября 2026 года в Devin Desktop и CLI для пользователей Pro, Max и Teams — самый дешёвый способ измерить реальное потребление. Считайте завершённые задачи за неделю и долю доработок, а не токены. Если SWE-2 Flash закрывает типовые тикеты за один проход на скорости 200 токенов в секунду, реальная экономия может оказаться выше заявленной; если задачи приходится передавать SWE-2, преимущество по цене исчезает.
Кому доступна модель: только Devin и программа передачи весов, которая не делает её open weights
Сейчас доступ к SWE-2 Flash ограничен. Cognition указывает в качестве доступных платформ Devin Desktop и Devin CLI.
Публичного идентификатора API, весов на Hugging Face и возможности самостоятельного развёртывания нет. Cognition объясняет ограничения рисками кибербезопасности: при обучении SWE-2 Flash целенаправленно использовались задачи по безопасности, благодаря чему результат в ExploitBench вырос с 11,3% до 34,8%, однако те же возможности могут оказаться полезными злоумышленникам. В качестве решения компания обещает программу безопасной передачи весов проверенным отраслевым партнёрам и исследовательским лабораториям; подробности должны появиться через несколько недель. Это план контролируемого доступа, а не обещание открыть веса для всех.
За пределами Devin напрямую протестировать SWE-2 Flash сегодня нельзя: публичного эндпоинта и возможности самостоятельного развёртывания нет.
SWE-2 Flash или SWE-2: правило выбора на уровне задачи
Большой поток задач — SWE-2 Flash, высокая неопределённость — SWE-2.
Начинайте с SWE-2 Flash, если речь идёт об автоматизации, обновлении зависимостей, добавлении тестов, ответах на замечания в ревью, небольших функциях с чёткими критериями готовности или обновлении документации. Такие сценарии соответствуют наборам тестов, где SWE-2 Flash отстаёт от SWE-2 всего на несколько пунктов: FrontierCode 2.0 — 24,0% против 23,8%, а SWE-Bench Pro v2 Hard — 89,9% против 90,6%.
Переходите на SWE-2, когда требуется планирование изменений в нескольких файлах, длинные последовательности команд в терминале или рассуждения, связанные с эксплуатацией уязвимостей. Разрыв здесь уже существенный: 12,9 пункта в DeepSWE 1.1, 6,3 пункта в SWE-Atlas QA и 7,3 пункта в Terminal-Bench 4.0. В обзоре SWE-2 от HamiRev модель описывается как оптимизированная под меньшее число шагов и более раннее внесение изменений по сравнению с SWE-1.7 — это склонность к коротким задачам, которую SWE-2 Flash развивает ещё сильнее.
Запускайте каждый тикет на SWE-2 Flash и ограничивайте попытку двумя циклами, после чего передавайте застрявшие задачи SWE-2. Вернитесь к этому решению после бесплатного периода в ноябре, когда реальные расходы в Devin заменят соотношение 1/5. Главный нерешённый вопрос — прозрачность: программа безопасной передачи весов может открыть путь к приватному развёртыванию, но регулируемые отрасли не смогут планировать работу с SWE-2 Flash, пока не появятся её условия.
Часто задаваемые вопросы о SWE-2 Flash
Доступна ли SWE-2 Flash через API?
Отдельного API для SWE-2 Flash нет. Доступ предоставляется через Devin Desktop и Devin CLI и остаётся бесплатным для пользователей Pro, Max и Teams до 30 ноября 2026 года.
Является ли SWE-2 Flash моделью с открытыми весами?
Нет. Cognition ссылается на риски кибербезопасности и обещает лишь будущую программу безопасной передачи весов отдельным партнёрам и исследовательским лабораториям.
Как SWE-2 Flash сравнивается с SWE-2?
SWE-2 Flash работает со скоростью 200 токенов в секунду против 60 токенов в секунду у SWE-2 и, согласно расчётам Cognition, стоит одну пятую от его стоимости на задачу. При этом SWE-2 сохраняет лидерство в DeepSWE 1.1 (73,0% против 60,1%) и Terminal-Bench 4.0 (27,3% против 20,0%).
Каково контекстное окно SWE-2 Flash?
Cognition не опубликовала характеристики контекстного окна, максимального объёма вывода или поддерживаемых модальностей SWE-2 Flash. Не стоит считать, что модель автоматически наследует ограничения Inkling-Small.
Что произойдёт после бесплатного периода 30 ноября?
Cognition не сообщила, как будет тарифицироваться SWE-2 Flash после окончания промоакции. Ожидайте списания в рамках подписки Devin, а не отдельной цены за токены.