 AIREITER
25 августа 2026 года ModelScope от Alibaba запустил обратный отсчёт до релиза Qwen3.8-Flash-Next — модели, которая приносит новую архитектуру раньше, чем появляется само семейство продуктов, для которого она предназначена. На момент подготовки материала публикация весов ожидалась 26 августа в 23:00 по UTC+8. Задача релиза — дать open-source-экосистеме инференса время подготовить ядра, квантизации и поддержку серверов до выхода Qwen4.
Что такое Qwen3.8-Flash-Next — и чем эта модель не является
Qwen3.8-Flash-Next — это мультимодальная модель Mixture-of-Experts (MoE), построенная на архитектуре будущего семейства Qwen4. Но самой Qwen4 она не является. Скорее, это технологический демонстратор: рабочая модель, на которой можно изучить новые механизмы внимания, структуру слоёв и схемы разреженности, чтобы фреймворки инференса успели добавить поддержку до полноценного запуска Qwen4.
На странице команды Qwen в Hugging Face модель обозначена как "Upcoming release" и "A Preview of the Qwen4 Architecture". На странице обратного отсчёта ModelScope использовался слоган "Onward to the Next-Gen — Lightning-Fast." Оба источника официальные, поэтому сам релиз подтверждён — просто на момент написания статьи он ещё не был завершён.
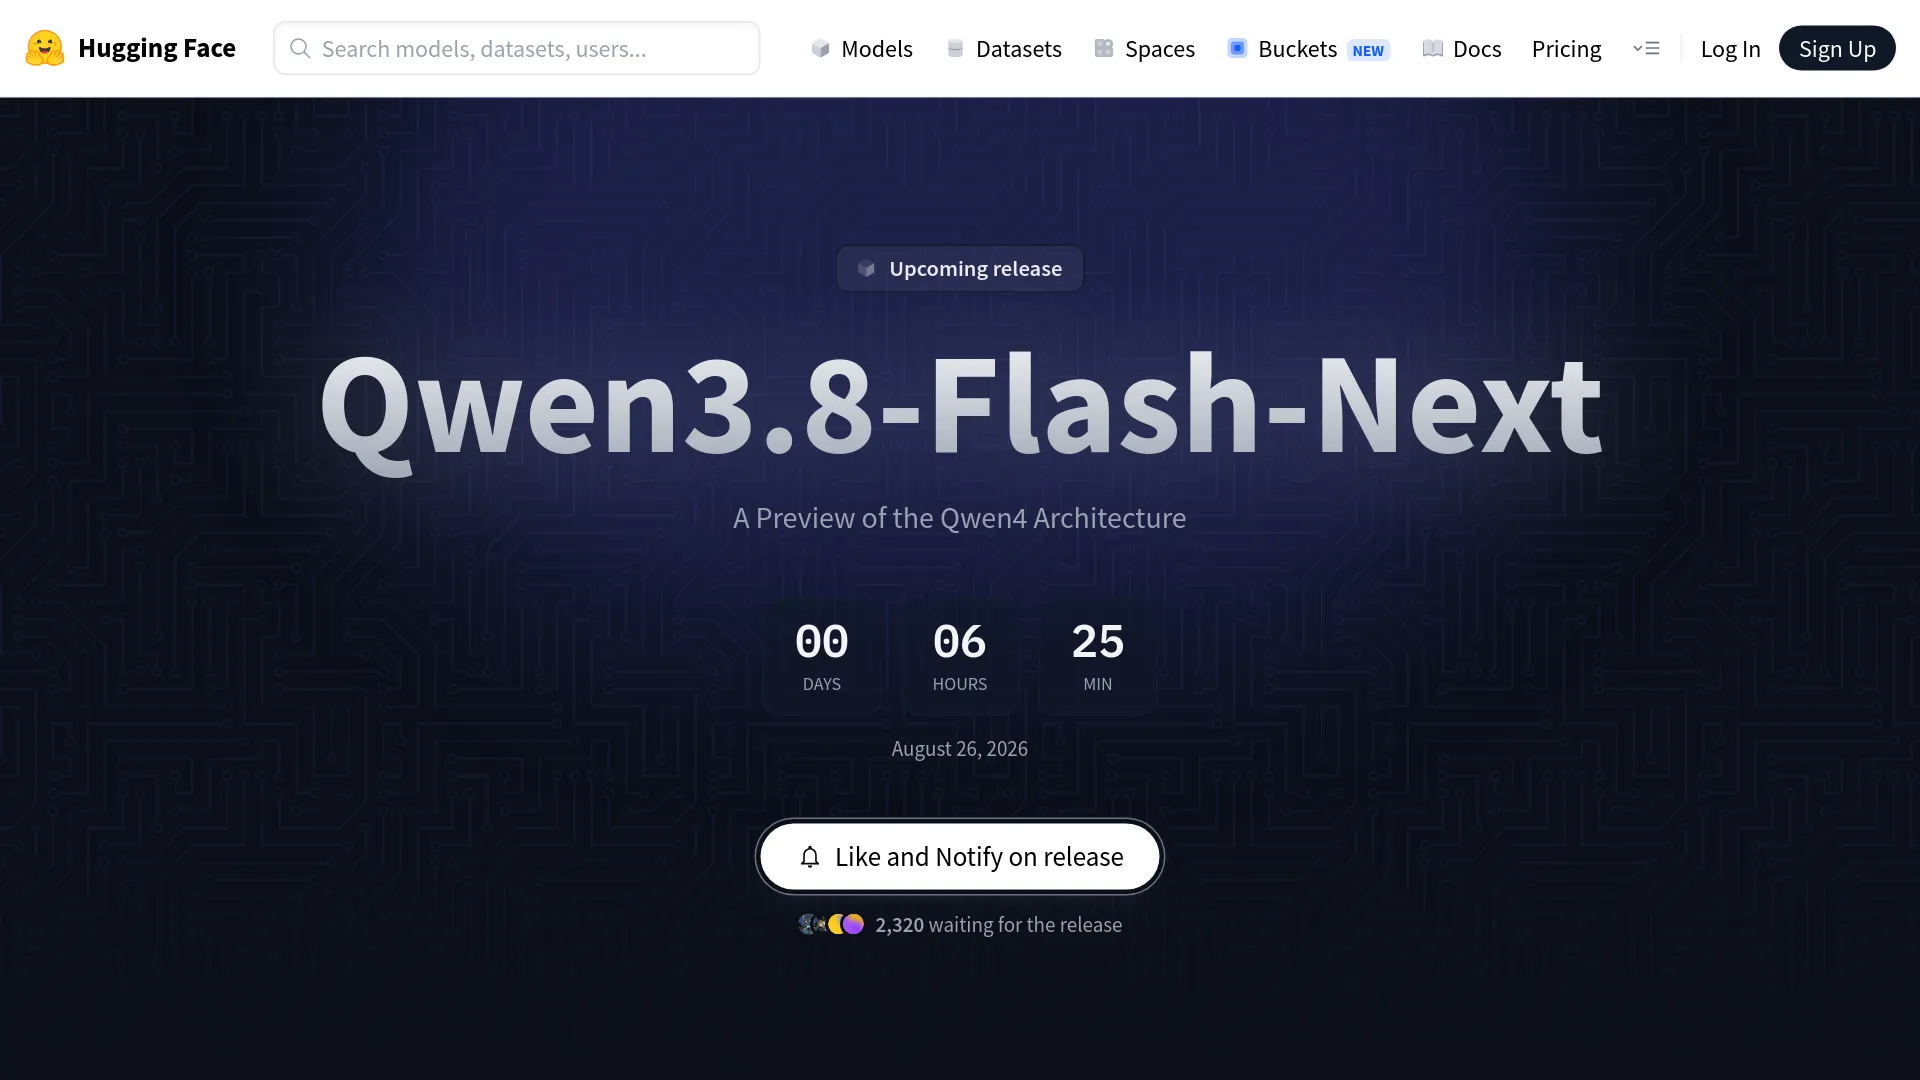
Вот что подтверждено официальными каналами, а что пока остаётся на уровне предположений сообщества:
| Подтверждено официальными каналами | Пока не подтверждено |
|---|---|
| Релиз с открытыми весами на ModelScope и Hugging Face | Итоговое число параметров (125B/6B/51B) |
| Мультимодальность (изображения + текст) | Лицензия (вероятно, Apache 2.0 по аналогии с предыдущими релизами) |
| Гибридная архитектура GDN и Qwen Sparse Attention | Результаты любых бенчмарков |
Вариант FP8 (Qwen/Qwen3.8-Flash-Next-FP8) | Стоимость и доступность API |
| Архитектурное превью Qwen4 | Размер контекста (по слухам, 256K нативно и до 1M с растяжением) |
Цифры, которые сейчас цитируют чаще всего — 125B параметров всего, 6B активных на токен и 51B параметров в n-gram embeddings — успели попасть на карточку ModelScope, но затем команда Qwen сократила опубликованную информацию. Они выглядят правдоподобно и совпадают в сообщениях нескольких независимых наблюдателей, однако официальной и устойчивой документацией не являются. Как отметил основатель SaaSCity ghosty:
"Anyone posting a benchmark chart for this model today made it up."
Архитектура, из-за которой инференсу придётся меняться
Qwen3.8-Flash-Next заметно отличается от нынешней линейки Qwen сразу по трём архитектурным направлениям. Для каждого из них фреймворкам инференса понадобится новый код ядер — одной настройки конфигурации будет недостаточно.
Слои GDN: состояние фиксированного размера и меньшие затраты на длинный контекст
Gated Delta Network (GDN) заменяет стандартное внимание в большинстве слоёв. В обычном трансформерном attention KV-кэш растёт вместе с длиной последовательности, тогда как GDN использует рекуррентное состояние фиксированного размера. В слоях GDN объём памяти не зависит от длины контекста, а вычисления масштабируются линейно, а не квадратично. Полноценные attention-слои гибридной архитектуры по-прежнему используют KV-кэш для точного поиска информации.
На практике это означает гораздо более дешёвую обработку длинного контекста. Диалогу на 100K токенов не потребуется KV-кэш объёмом ещё в 100K токенов. По данным анализа кратковременно доступной карточки ModelScope, в архитектуре Qwen3.8 используется 69 слоёв GDN и 23 слоя full attention — примерно в соотношении 3:1. Слои полного внимания сохраняют качество глобального поиска, а GDN берёт на себя основную обработку последовательности.
Для Qwen это не полностью новая идея. В Qwen3-Next (сентябрь 2025 года) уже появилась Gated DeltaNet при 80B параметров всего и 3B активных, а семейства Qwen3.5/3.6/3.7, по сообщениям, сохранили похожую гибридную схему. Новизна Flash-Next — в масштабе: 125B параметров при такой архитектуре, а также в добавлении двух следующих компонентов.
QSA: разреженное внимание, устройство которого пока неизвестно
Qwen Sparse Attention (QSA) упоминается на карточке, но пока не объясняется. Общее мнение сообщества сводится к тому, что он заменяет плотное внимание разреженной схемой: каждый токен обращается лишь к части других токенов, а не ко всей последовательности. Неясно, используется ли обучаемая разреженность, блочная схема, скользящие окна или их комбинация. Технический отчёт покажет, окажется ли QSA постепенным улучшением или действительно новым примитивом внимания.
Таблица n-грамм на 51B: спекулятивное декодирование без отдельной draft-модели
Самая необычная особенность — таблица n-граммовых эмбеддингов на 51B параметров. Рабочая гипотеза сообщества состоит в том, что она служит быстрым механизмом поиска токенов — по сути, встроенной draft-моделью для спекулятивного декодирования. Вместо запуска отдельной маленькой модели, которая предсказывает несколько следующих токенов с последующей проверкой основной моделью, таблица n-грамм напрямую предлагает дешёвые кандидаты следующих токенов.
Открытых вопросов здесь немало: должна ли таблица целиком находиться в VRAM или её можно отображать в память? Как она ведёт себя после квантизации? Входит ли она в заявленные 125B или считается отдельно? Пока технический отчёт и первые бенчмарки сообщества не дадут ответы, цифру 51B лучше рассматривать как переменную при планировании развёртывания, а не как гарантированную стоимость.
Место Flash-Next в семействе Qwen
Flash-Next — это скорее параллельная ветка развития, чем очередной линейный шаг:
| Модель | Релиз | Параметров всего | Активных параметров | Роль |
|---|---|---|---|---|
| Qwen3-Next | Sep 2025 | 80B | 3B | Первый тест архитектуры GDN |
| Qwen3.8-27B | Aug 2026 | 27B (dense) | 27B | Универсальная плотная модель среднего класса |
| Qwen3.8-Max | Aug 2026 | ~2.4T | ~95B | Флагманская модель с открытыми весами |
| Qwen3.8-Flash-Next | Aug 26, 2026 | ~125B | ~6B | Архитектурное превью Qwen4 |
| Qwen4 | TBD (months) | Неизвестно | Неизвестно | Полноценное следующее поколение |
Сообщество использует такую эвристику: sqrt(125B x 6B) = 27B. Если она сработает, Flash-Next может обеспечить качество примерно на уровне плотной модели 27B, потребляя при инференсе вычислительные ресурсы, скорее, как модель на 6B параметров. Как отметил Lucas Souza из Beer And Code, это эмпирическое правило, а не теорема: качество маршрутизации, данных и вклад таблицы n-грамм пока не измерены.
Стратегию, которую в нескольких анализах сообщества описывают как "platform play, not a benchmark play", можно свести к следующему: дать фреймворкам инференса вроде llama.cpp, vLLM и SGLang возможность добавить поддержку ядер до выхода Qwen4. Unsloth уже объявила, что работает над поддержкой с первого дня.
Запустится ли она вообще? Проверяем требования к железу
| Формат | Примерный объём памяти под веса |
|---|---|
| BF16 / FP16 | ~250 GB |
| FP8 | ~125 GB |
| Q4 / 4-bit | ~65–70 GB |
Речь идёт только о весах — без учёта контекста, KV-кэша и накладных расходов рантайма. Квантизированной в Q4 модели потребуется примерно 65–70 GB для основных весов, а сверху добавится объём, необходимый таблице n-грамм на 51B. Если таблица должна находиться в VRAM, общий объём превысит возможности большинства одиночных систем. Если же её можно будет отображать в оперативную память, потенциально подойдёт система со 128GB+ унифицированной памяти — Mac Studio (M2 Ultra / M3 Ultra maxed), AMD Strix Halo или NVIDIA DGX Spark. Одной RTX 4090 или 5090 будет недостаточно.
На Reddit пользователь u/KURD_1_STAN возразил против определения модели как "local-friendly": "Ram prices this high, how can u call this local friendly?" Разрыв между маркетинговыми "6B активных параметров" и требованиями в 250GB памяти вполне реален. На X @Dicklong1999 отметил, что разреженная схема активации может обеспечить приемлемую скорость генерации у тех, кто располагает подходящим железом, но "125B, ordinary people can basically forget about running it locally."
Чего ждать от API: доступность и цены
На момент публикации цены и доступность Qwen3.8-Flash-Next через API объявлены не были. Qwen3.8-Max стоит $2.00/M за входные токены и $6.00/M за выходные (согласно официальной странице цен Qwen); при 6B активных параметров Flash-Next должна быть заметно дешевле. Вариант FP8 вдвое сокращает объём памяти под веса по сравнению с BF16, поэтому выглядит естественным форматом для API-серверов. Доступность будет зависеть от поддержки со стороны фреймворков инференса — после публикации весов стоит проверить каталоги провайдеров.
Что сделать до публикации весов
Если вы разработчик или исследователь и хотите понять, насколько Qwen3.8-Flash-Next подходит вашему стеку, держите под рукой такой чек-лист:
1. Проверьте железо. Для локального запуска понадобится 128GB+ унифицированной памяти или конфигурация с несколькими GPU. Если этого нет, рассчитывайте на доступ через API.
2. Следите за репозиторием Hugging Face. Карточка модели станет первым источником точной информации о характеристиках, лицензии и длине контекста. Добавьте в закладки huggingface.co/Qwen/Qwen3.8-Flash-Next.
3. Подготовьте пайплайн оценки. Заранее соберите свои промпты для бенчмарков и скрипты оценки. Первые 24 часа независимых тестов сообщества расскажут больше любых официальных цифр.
4. Не переводите на неё продакшен. Независимых бенчмарков пока нет. Архитектура новая, поддержка рантаймов сырая, а лицензия не подтверждена. Используйте модель для оценки, но не для задач, сбой которых может стоить денег.
5. Если вы поддерживаете инструменты инференса, начинайте уже сейчас. Связка GDN + QSA потребует работы над ядрами, а не изменения конфигурации. Чем раньше вы разберётесь в архитектуре, тем быстрее сможете выпустить поддержку.
FAQ
Когда станут доступны веса?
Обратный отсчёт ModelScope указывал на 26 августа 2026 года, примерно 23:00 по UTC+8. Зеркала на Hugging Face обычно появляются в течение нескольких часов после релиза на ModelScope. Команда Qwen подтвердила сроки через официальные каналы: @Alibaba_Qwen намекнула на "what surprise we're dropping tonight", а @QwenDevs напрямую назвала модель.
Это Qwen4?
Нет. Это превью архитектуры Qwen4, выпущенное под названием Qwen3.8. Саму Qwen4 ожидают через месяцы, а не недели. Flash-Next нужна для того, чтобы экосистема успела подготовить поддержку рантаймов до выхода всего семейства.
Какая у модели лицензия?
Пока неизвестно. В последних релизах Qwen с открытыми весами — Qwen3.8-27B и Qwen3.8-Max — использовалась Apache 2.0, поэтому это наиболее вероятный вариант. Точную информацию нужно будет проверить в карточке модели после публикации весов.
Запустится ли она на RTX 4090?
Нет. Даже в квантизации Q4 только основные веса требуют примерно 65–70 GB. У одной RTX 4090 — 24 GB. Понадобится система со 128GB+ унифицированной памяти (Mac Studio, Strix Halo) или несколько GPU с большим объёмом VRAM.
Превзойдёт ли она Qwen3.8-27B?
Неизвестно. Бенчмарков пока нет. Эвристика sqrt(125B x 6B) = 27B предполагает качество, сопоставимое с плотной моделью 27B, но это оценка, а не измерение. Дождитесь независимых тестов именно на своих задачах.
Насколько быстрой она будет?
6B активных параметров на токен указывают на скорость генерации, скорее характерную для небольшой модели, а не для гиганта на 125B. Но характер обращений к памяти таблицы n-грамм и эффективность ядер GDN пока неизвестны. Ответ дадут первые бенчмарки сообщества.
Появится ли модель на API-платформах?
Почти наверняка. Вариант FP8 явно рассчитан на работу через API. AIReiter и другие платформы обычно добавляют модели Qwen в течение нескольких дней после публикации весов. Узким местом станет поддержка новых механизмов внимания во фреймворках.
Что случилось с прошлогодней Qwen3-Next?
Qwen3-Next вышла в сентябре 2025 года с 80B параметров всего и 3B активных, представив Gated DeltaNet. Это был архитектурный тест меньшего масштаба, подтвердивший работоспособность гибридного подхода GDN. Flash-Next — его более крупное продолжение. Один из пользователей X, @LufzzLiz, отметил, что прошлогодняя серия Next "was a letdown" — и именно поэтому на этот раз стоит дождаться бенчмарков.