 AIREITER
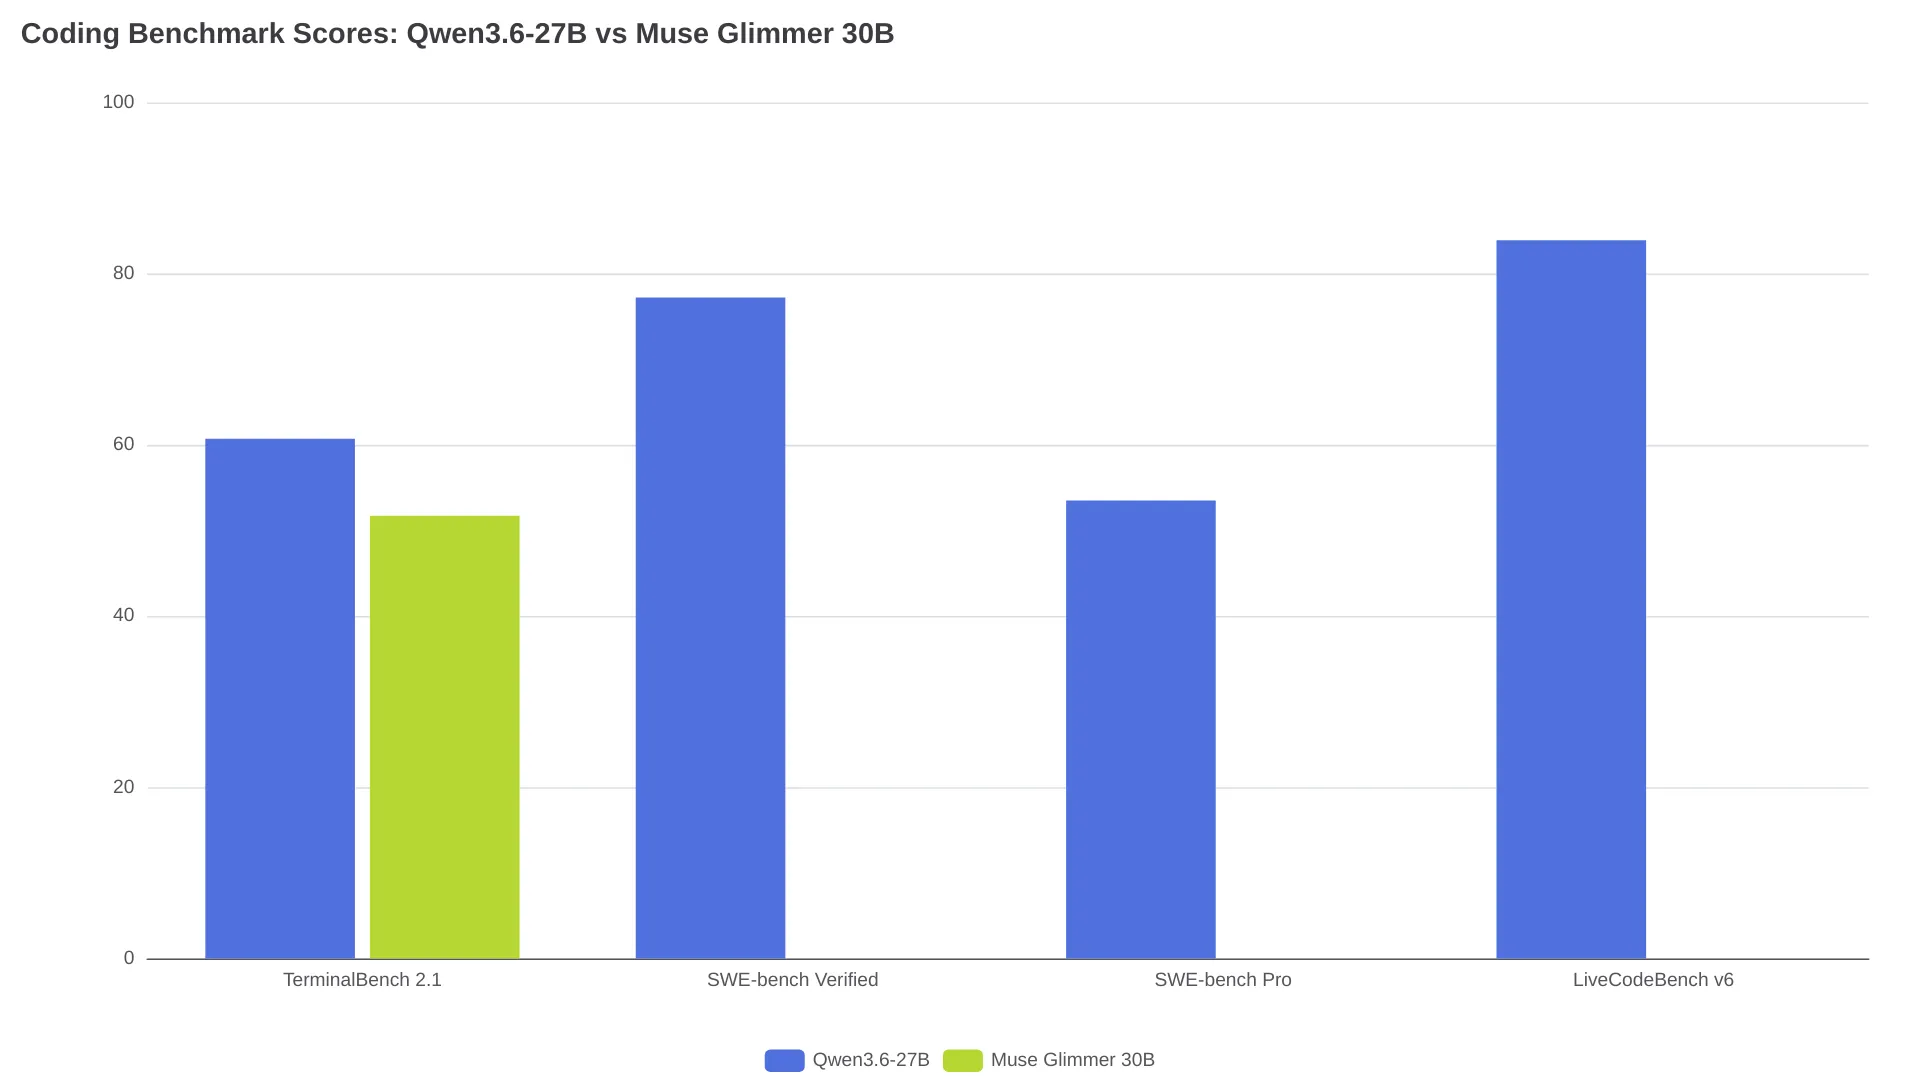
Если нужна максимальная подтверждённая точность в задачах по программированию, выбор сейчас склоняется к Qwen3.6-27B. В TerminalBench 2.1 он набрал 60,7 балла против 51,7 у Muse Glimmer, а официальный результат Qwen в SWE-bench Verified составляет 77,2. Но для локального запуска всё не так однозначно: Muse Glimmer 30B позволяет получить контекст 262K на одной видеокарте RTX 3090 — преимущество, которое для работы с крупными репозиториями может оказаться важнее разницы в бенчмарках. Qwen3.6-27B вышел в апреле 2026 года с полной таблицей тестов в своей карточке модели на Hugging Face, а Meta выпустила открытые веса Muse Glimmer 30B в августе 2026 года. Уже через несколько дней сообщество локальных LLM начало напрямую сравнивать модели.
TerminalBench 2.1: Qwen заметно впереди
TerminalBench проверяет, насколько надёжно модель действует как агент в терминале: умеет ли пользоваться инструментами, держать контекст и последовательно проходить многошаговые задачи в длинных сессиях. В связанных обсуждениях именно TerminalBench 2.1 чаще всего фигурирует как доступное прямое сравнение кодинговых агентов.
Результаты TerminalBench 2.1, которыми делились участники сообщества в обсуждениях r/LocalLLaMA 10–11 августа 2026 года:
| Модель | TerminalBench 2.1 | Тип источника |
|---|---|---|
| Qwen3.6-27B | 60,7 | Данные сообщества |
| Muse Glimmer 30B | 51,7 | Данные сообщества |
| Gemma 4 31B | 43,4 | Данные сообщества |
Здесь важно учитывать методику: TerminalBench оценивает не только базовую модель, но и связку модели с агентским harness. В официальной карточке Qwen3.6-27B указаны harness Harbor/Terminus-2, тайм-аут 3 часа, 32 CPU, 48 GB RAM, максимум 80K выходных токенов, контекст 256K и усреднение по пяти запускам. Для Glimmer могли использоваться другие или менее оптимизированные параметры, поэтому разрыв в 9 баллов в конкретной агентской конфигурации способен как сократиться, так и увеличиться.
Публичные результаты по кодингу: у Qwen они есть, у Glimmer — пока нет
Официальные результаты Qwen3.6-27B опубликованы в карточке модели. В источниках, изученных для этого сравнения, по состоянию на август 2026 года не нашлось официальных показателей Muse Glimmer в SWE-bench, LiveCodeBench или сопоставимых агентских бенчмарках для программирования. Поэтому доказательная база по Qwen сильнее, однако официального сравнения двух моделей в одинаковых условиях пока нет.
Официальные результаты Qwen в кодинговых бенчмарках:
| Бенчмарк | Qwen3.6-27B (официальный результат) |
|---|---|
| SWE-bench Verified | 77,2 |
| SWE-bench Pro | 53,5 |
| SWE-bench Multilingual | 71,3 |
| Terminal-Bench 2.0 | 59,3 |
| LiveCodeBench v6 | 83,9 |
Это результаты, опубликованные разработчиком модели. В карточке указано, что для SWE-bench Qwen использовал собственный scaffold для bash и редактирования файлов, temperature 1.0, top-p 0.95 и окно контекста 200K. Результаты SWE-bench Pro рассчитаны на доработанном наборе задач, где Qwen исправил проблемные пункты; поэтому напрямую сопоставлять их с публичной таблицей лидеров некорректно. Сторонний разбор от morphllm также отмечает, что результаты зависят от собственного агентского scaffold Qwen и имеют ограниченную независимую воспроизводимость.
Локальные тесты: что заметили пользователи
Тест OpenCode на M5 Pro
Один разработчик запустил Muse Glimmer в квантизации Q4, сборка Unsloth, на M5 Pro с 48 GB RAM через OpenCode. Модель занимала примерно 20 GB памяти и генерировала 17 токенов в секунду. Его вывод был таким:
"В целом уступает Qwen3.6 27B" — u/curiousily_
По оценке автора, в задачах фронтенда и бэкенда результат был слабее, чем у Qwen. При этом Muse Glimmer не провалил ни одного вызова инструментов. В тесте не настраивались reasoning loops или расширенное размышление, что могло ограничить производительность Glimmer.
Ловушка с max_tokens
Другой тестировщик на r/LocalLLM выяснил, что Muse Glimmer может выглядеть значительно слабее реального уровня, если слишком ограничить бюджет выходных токенов. Модель тратит этот бюджет на рассуждения ещё до появления видимого ответа, из-за чего ответы оказываются пустыми или обрезанными. После увеличения max_tokens в его тестовом harness число пройденных задач выросло с 6/13 до 11/13 — почти вдвое без какой-либо смены модели. Если проверять Glimmer со стандартными лимитами вывода, есть риск измерить качество конфигурации, а не модели.
Зацикливание терминальных команд в Hermes
Ещё один пользователь сообщил, что Muse Glimmer застревает в чрезмерном количестве терминальных команд при работе с агентским фреймворком Hermes. С Qwen3.6-27B в той же конфигурации он такого поведения не наблюдал. Этот единичный случай в целом согласуется с доступной разницей в TerminalBench, но не позволяет отделить влияние модели от конфигурации Hermes.
Расход токенов: качественное преимущество Glimmer
Автор публикации с галереей бенчмарков, u/NoFaithlessness951, обратил внимание на эффективность:
"Чуть менее умная, чем Qwen, зато тратит намного меньше токенов на задачу." — u/NoFaithlessness951
Это качественное наблюдение сообщества, а не контролируемое измерение числа токенов на успешно выполненную задачу. Прямого исследования, которое сопоставляло бы преимущество Glimmer по расходу токенов с Qwen на одинаковых задачах, при равных показателях успеха и задержки, пока нет. Такой аргумент стоит считать перспективным сигналом, а не установленным фактом.
VRAM и контекст: ключевое преимущество Glimmer
Именно здесь Muse Glimmer уверенно выходит вперёд. Тестировщик на r/LocalLLaMA показал, что Muse Glimmer 30B в Q4_K_XL с DFlash speculative decoding, мультимодальным projector и полным F16 KV cache укладывается примерно в 22–23 GB на одной RTX 3090. При этом был настроен контекст 262 144 токена.
Одна и та же RTX 3090, одинаковая квантизация Q4_K_XL:
| Модель | Контекст с F16 KV | Контекст с Q8 KV | Занято VRAM |
|---|---|---|---|
| Muse Glimmer 30B | 262 144 | N/A | ~22–23 GB |
| Qwen3.6-27B | 70 000 | 125 000 | Укладывается в 24 GB |
| Gemma 4 31B | 52 000 | 81 000 | Укладывается в 24 GB |
Автор теста назвал контекст Qwen в 70K при F16 «погранично непригодным» для сценариев, где в prompt загружается контекст большого репозитория.
Заявленная производительность Muse Glimmer на этой конфигурации RTX 3090:
- Генерация: 64–124 токена в секунду, в зависимости от кода или обычного текста
- Обработка prompt: ~1 400 токенов в секунду
- Извлечение из длинного контекста: с первой попытки пройден тест «две иголки в стоге сена» при ~150K токенов
На том же железе для Qwen3.6-27B требуется либо сжатие KV cache до Q8, жертвуя точностью вывода ради длины контекста, либо перенос работы на более мощную машину. Когда нужен был полный контекст, тестировщик запускал Qwen на своём DGX Spark — устройстве существенно более дорогом.
На более производительном железе сборка Qwen3.6-27B в NVFP4 на DGX Spark достигла 28–33 токенов в секунду в одной сессии при контексте вплоть до 128K, согласно анализу бенчмарков kie.ai. Сборка Unsloth Muse Glimmer в Q5_K_M на RTX 5090, по сообщениям, выдавала 220–253 токена в секунду при генерации патчей кода через доработанный путь DFlash в llama.cpp.
Какую модель выбрать
| Сценарий | Выбор | Причина |
|---|---|---|
| Только кодинг и одноразовая генерация | Qwen3.6-27B | Более убедительные опубликованные результаты в кодинговых бенчмарках и лидерство в доступном сравнении TerminalBench 2.1 |
| Агентский кодинг с большим контекстом на одной GPU с 24 GB | Muse Glimmer 30B | Контекст 262K с F16 против 70K у Qwen на том же железе в конфигурации Q4_K_XL/DFlash |
| Длинные терминальные задачи | Qwen3.6-27B | 60,7 против 51,7 в TerminalBench 2.1; есть сообщение сообщества о зацикливании Glimmer в агентском фреймворке |
| Большой поток задач при чувствительности к стоимости | Muse Glimmer 30B (возможно) | Один отчёт сообщества указывает на меньшее число токенов на задачу; сопоставимого сравнения стоимости успешного выполнения нет |
| Кодинг на уровне репозитория с большим контекстом | Muse Glimmer 30B (при ограниченной VRAM) | Для большого контекста на 24 GB Qwen нужны Q8 KV compression или несколько GPU |
| Максимальная точность в кодинге без ограничений по железу | Qwen3.6-27B | Более сильные опубликованные бенчмарки и официальные результаты |
FAQ
Есть ли у Muse Glimmer официальный результат в SWE-bench?
Нет. В источниках, рассмотренных для этого сравнения, по состоянию на август 2026 года не обнаружено официальных результатов Muse Glimmer 30B в SWE-bench, LiveCodeBench или TerminalBench. Оценка 51,7 в TerminalBench 2.1 получена из тестов сообщества в ветках Reddit, а не из официальной оценки Meta.
Можно ли запустить обе модели на одной RTX 3090?
Да. Muse Glimmer 30B в Q4_K_XL помещается примерно в 22–23 GB вместе с контекстом 262K и полным F16 KV cache. Qwen3.6-27B в Q4_K_XL также запускается, но на той же GPU ограничен контекстом 70K с F16 либо 125K при сжатии Q8 KV cache.
Цензурирует ли Muse Glimmer задачи по программированию?
Один пользователь сообщил, что Muse Glimmer отказался помогать с отладкой Python-кода для управления мышью, посчитав это потенциальной угрозой безопасности. Это единичное наблюдение без указания системного prompt и конфигурации. Его недостаточно, чтобы установить, связано ли такое поведение с самой моделью или с настройками инференса.
Какая модель лучше для агентских сценариев кодинга?
Для долгих терминальных задач Qwen3.6-27B выглядит надёжнее по результатам TerminalBench и сообщениям сообщества. Muse Glimmer 30B практичнее на ограниченном железе благодаря эффективному использованию VRAM и, возможно, требует меньше токенов на задачу. Это могло бы снизить стоимость и задержки в агентских циклах с большим числом задач, но контролируемое сравнение пока не подтвердило этот эффект.
Какое значение max_tokens выбрать для кодинга с Muse Glimmer?
Задайте щедрый бюджет выходных токенов. Один тестировщик заметил, что при жёстком ограничении max_tokens Glimmer расходует бюджет на рассуждения до появления видимого ответа. В итоге получаются пустые или обрезанные ответы, которые выглядят как ошибки. После увеличения лимита в его тестовом harness число пройденных задач выросло с 6/13 до 11/13. В карточке Qwen3.6-27B рекомендованы 32 768 токенов для обычных запросов и 81 920 для сложных бенчмарковых задач; пока Meta не выпустит собственные рекомендации, такой же бюджет можно считать разумной отправной точкой для Glimmer.