 AIREITER
Мультивекторные модели эмбеддингов наконец стали полноправной частью Sentence Transformers: 18 августа 2026 года вышла версия 6.0 с классом MultiVectorEncoder, дополнившим dense-, sparse-модели и реранкеры. Однако собственные бенчмарки Hugging Face выглядят заметно спокойнее рекламного шума. Late interaction обошёл идентичную dense-модель на 9 из 13 наборов NanoBEIR, но средняя разница составила около одного пункта NDCG@10. Зато сырой индекс в их примере оказался в 42 раза больше, чем у 384-мерного MiniLM, и всё ещё в 21 раз больше dense-модели того же класса. Оправданность такого обмена почти целиком определяется тем, какие именно запросы приходят в вашу систему.
Как устроены мультивекторные эмбеддинги и late interaction
Мультивекторная модель не сворачивает документ в один усреднённый вектор, а сохраняет вектор для каждого токена. В поддерживаемых Hugging Face моделях токеновые векторы обычно имеют размерность 128, тогда как типичный dense-эмбеддинг документа занимает 384, 768 или 1 024 измерения. При подсчёте релевантности оператор MaxSim для каждого токена запроса находит максимальное скалярное произведение с любым токеном документа, после чего складывает эти максимумы: MaxSim(Q,D) = Σᵢ maxⱼ(qᵢ · dⱼ). Поскольку модели L2-нормализованы, каждый компонент лежит в диапазоне [-1, 1], а итоговый балл зависит от длины запроса.
По сути, late interaction занимает промежуточное место между двумя знакомыми архитектурами:
| Архитектура | Представление документа | Подсчёт релевантности | Профиль затрат |
|---|---|---|---|
| Dense bi-encoder | Один заранее рассчитанный pooled-вектор | Одно скалярное произведение | Самый быстрый поиск, но при pooling теряются токеновые детали |
| Late interaction | Заранее рассчитанный вектор на каждый токен | MaxSim по парам токенов | Более богатое сопоставление, но индекс растёт вместе с длиной документа |
| Cross-encoder | Ничего не предвычисляется | Полный forward pass для каждой пары запрос—документ | В анонсе Hugging Face назван самым точным вариантом для отдельной пары, но слишком дорог для первого этапа поиска |
Такой подход — «контекстуализированное позднее взаимодействие» — формализовала исходная статья ColBERT.
Преимущество проявляется на уровне отдельных токенов. В примере Hugging Face с lightonai/mLateOn токен запроса «live» сопоставился с токеном документа «inhabit» с похожестью 0.94: семантическая связь нашлась при полном отсутствии лексического совпадения.
В каких задачах мультивекторный поиск сильнее
Бенчмарки на коротких пассажах не вполне отражают задачи, в которых эти модели действительно окупаются. В пяти источниках, сопоставленных для этой статьи, — анонсе Hugging Face, материале TopK, инженерном разборе Qdrant, production-гайде Data AI Hub и сравнении поиска в продакшене от Suhas Bhairav — повторяются одни и те же сценарии:
- Точные идентификаторы в семантическом поиске. Коды товаров, имена функций, фамилии, строки ошибок, номера пунктов договора. Один pooled-вектор размывает такие детали, а токеновые векторы сохраняют возможность найти их напрямую.
- Составные запросы. В запросе «X с Y и Z» каждый токен может независимо найти подтверждающий токен в документе. Ни одно из условий не усредняется и не исчезает.
- Длинные документы, где ответ спрятан в небольшом фрагменте. На мультиязычном бенчмарке длинных документов MLDR мультивекторная
mLateOnнабрала 77.92 против 51.59 уmDenseOn. Это разрыв на порядок больше средних различий на коротких пассажах. - PDF, таблицы и сканы страниц. Модели семейства ColPali индексируют изображения страниц напрямую по текстовому запросу, без OCR. В анонсе Hugging Face визуальный поиск по документам назван областью, где late interaction задаёт современный уровень качества. А в анализе TopK компактный мультивекторный ретривер превзошёл одновекторную модель в 80 раз крупнее на +34% recall в ViDoRe v3; recall для промышленных документов вырос примерно с 42% до 76%.
- Лексика вне обучающего домена. Анонс Hugging Face сообщает об улучшениях на out-of-domain данных, где обученное dense-сжатие может выбросить детали, нужные реальным запросам.
Цифры Hugging Face хорошо объясняют, почему подход особенно подходит визуальным документам: отрисованная страница для colqwen2.5-v0.2 даёт около 755 токеновых векторов против примерно 125 у среднего текстового пассажа. Чем богаче страница — графики, вёрстка, таблицы, — тем больше информации пришлось бы отбросить одному pooled-вектору.
Прирост качества есть, но он скромнее хайпа
Самое чистое сравнение даёт пара LightOn: LateOn и DenseOn используют один и тот же 149M-параметрический backbone ModernBERT и одинаковые тренировочные данные. Различается только голова: токеновые векторы размерности 128 против одного 768-мерного вектора документа.
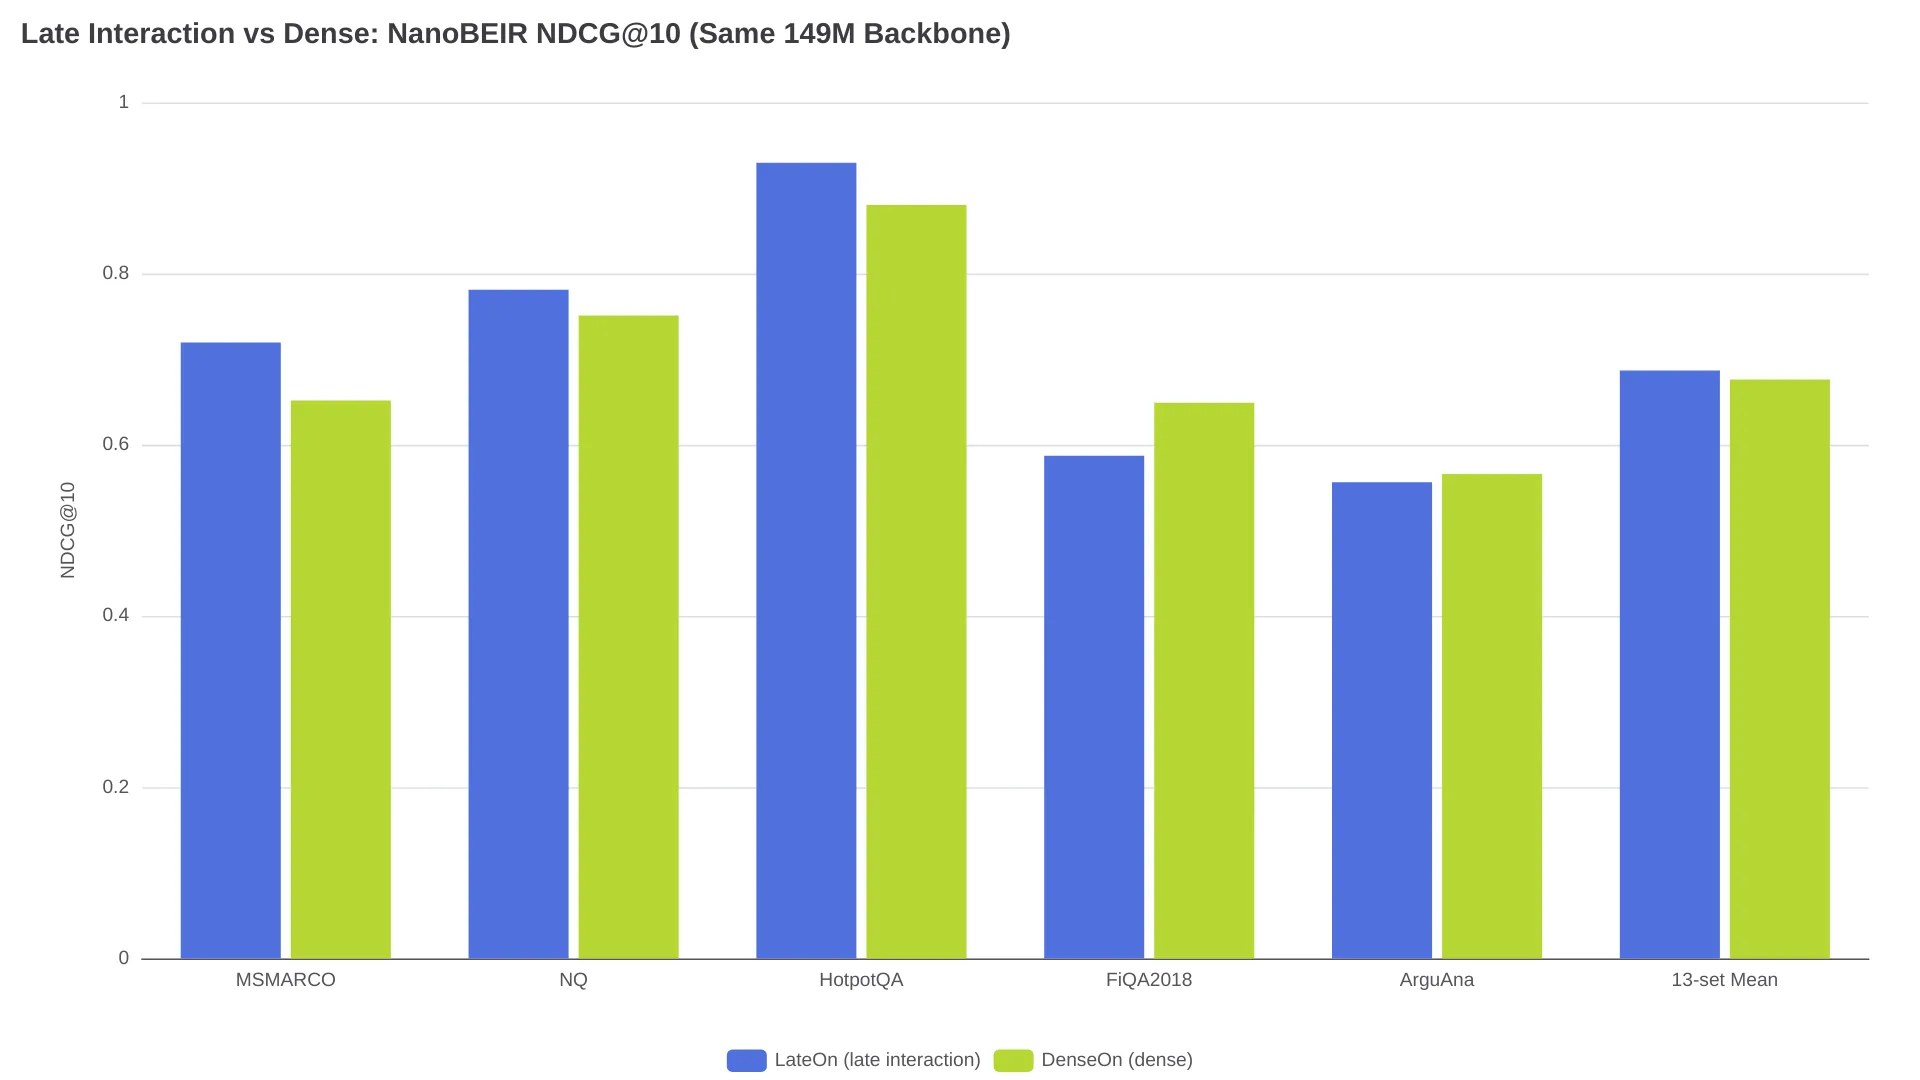
LateOn выигрывает на 9 из 13 датасетов NanoBEIR и по среднему значению: 0.6868 против 0.6764 NDCG@10. На полном BEIR из 15 датасетов результат составляет 57.22 против 56.20. При этом DenseOn уверенно побеждает на ArguAna, FiQA2018, SCIDOCS и SciFact. Это и есть честная картина: заметный средний выигрыш при равном размере моделей, а не качественный скачок целой категории.
После того как мейнтейнер Tom Aarsen анонсировал v6.0, разработчик @saen_dev задал вопрос, который постоянно повторяют практики: «Как это выглядит в бенчмарках против bi-encoder на предметных корпусах?» (обсуждение). Честный ответ: в среднем около одного пункта, а крупные выигрыши сосредоточены на длинных документах. Сам Hugging Face в анонсе рекомендует оценивать модели на собственной задаче поиска, поскольку эффект зависит от конкретного датасета.
Цена хранения: 42 раза больше до сжатия
В примере Hugging Face оценивается индекс для 4 874 пассажей Natural Questions. lightonai/LateOn генерирует для них 608 414 токеновых векторов — в среднем 124.8 вектора на пассаж.
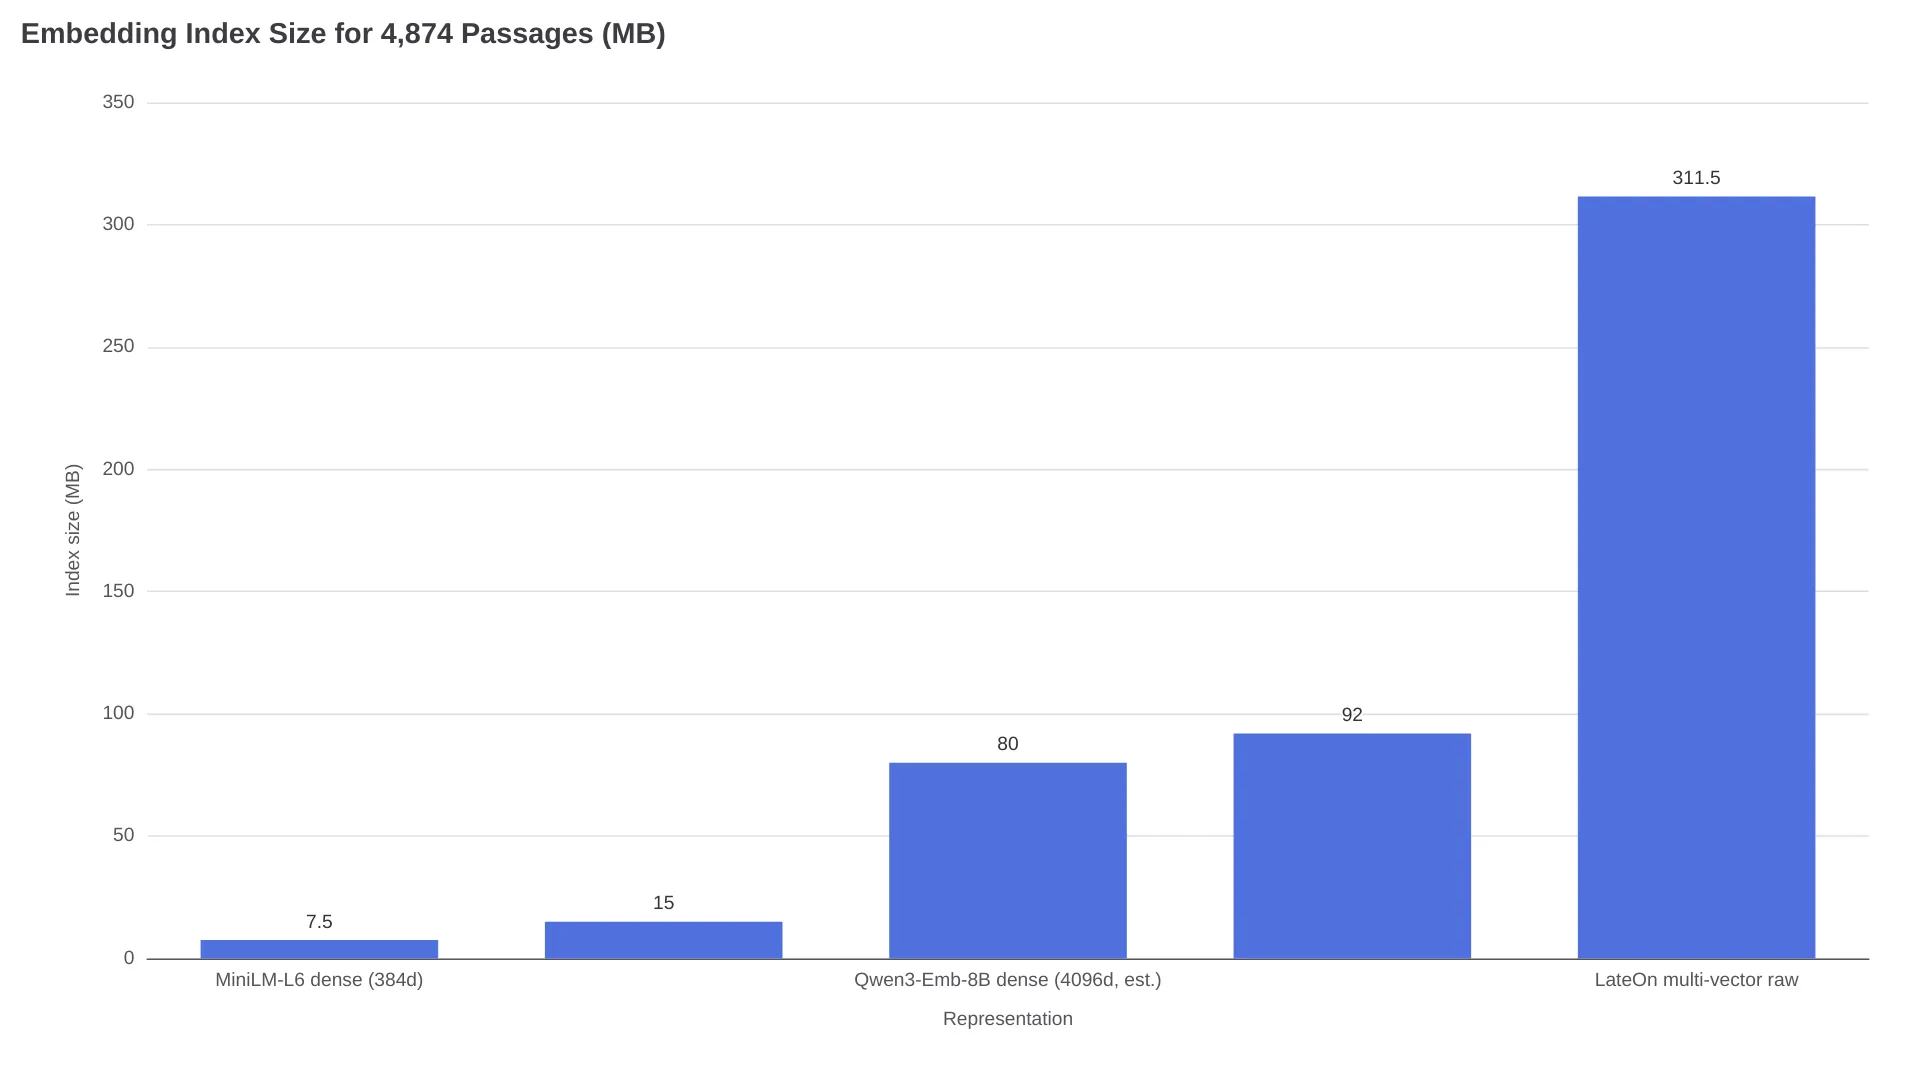
Сырой мультивекторный индекс в float32 занимает 311.5 MB. Для тех же пассажей dense-модель all-MiniLM-L6-v2 требует 7.5 MB — разница в 42 раза, или 62 KiB на пассаж. Если сравнивать с gte-modernbert-base, 768-мерной dense-моделью того же класса, разрыв составляет 21 раз: 15 MB. TopK приводит диапазон 10–100x в зависимости от длины документа и точности представления, а вычислительную работу на запрос оценивает в тысячи раз выше, чем для сравнения одиночных векторов.
В день релиза один разработчик сформулировал production-проблему предельно прямо:
Пулинг токенов — это то, что решает, попадёт ли решение в прод. Late interaction обычно погибает не из-за качества, а из-за размера индекса и памяти. — @JudeJobs в X
Для масштаба: dense-индекс Qwen3-Embedding-8B с размерностью 4 096 на том же корпусе занимает около 80 MB — почти столько же, сколько 92 MB у сжатого late-interaction индекса ниже.
Три способа уменьшить индекс
1. Пулинг токенов. В Sentence Transformers v6.0 появился HierarchicalTokenPooling. Он кластеризует токеновые векторы документа по Ward linkage на косинусной дистанции и заменяет каждый кластер его средним вектором. По умолчанию pooling применяется только к документам: запросы короткие и особенно чувствительны к искажениям. Для корпуса из 608 414 векторов результаты такие:
| Коэффициент пулинга | Токеновые векторы | Индекс float32 | Заявленное сохранение качества поиска |
|---|---|---|---|
| 1 (без пулинга) | 608,414 | 311.5 MB | 100% |
| 2 | 305,438 | 156.4 MB | 100.6% |
| 3 | 204,407 | 104.7 MB | 99.0% |
| 4 | 153,936 | 78.8 MB | тренд около 98% |
Пулинг всего корпуса занял около 6 секунд. Регуляризованный вариант LightOn, согласно публикации Hugging Face, сохраняет 99.4% качества при сжатии в 5 раз. Однако Hugging Face отмечает, что на момент релиза v6.0 обучение с этим регуляризатором ещё не интегрировано в библиотеку.
2. Сжатые индексы. Индекс fast-plaid (Rust PLAID) для тех же векторов занимает 92 MB, строится за 5 секунд и отвечает за 11 ms на RTX 3090 + i7-13700K. Это приближённый поиск: в тесте Hugging Face верхние оценки изменились с 11.92 до 11.88, но порядок документов сохранился. MUVERA в Weaviate ускорила ingestion в 3 раза, а запросы — в 1.8 раза, хотя на их тестовом корпусе один правильный результат выпал из топ-50.
3. Квантование и настройка инференса. В экспериментах Qdrant скалярное uint8-квантование токеновых эмбеддингов сократило потребление памяти в 4 раза, а SciFact NDCG@10 изменился с 0.70724 до 0.70297 — практически незаметно. По данным Hugging Face, fp16 вместе с Flash Attention даёт в 2.44 раза большую пропускную способность кодирования по сравнению с fp32 без измеримой потери качества; int8 на CPU снижает точность примерно на 0.4%.
Если совместить pooling с коэффициентом 2–3 и сжатый индекс, эффективный разрыв с dense-решением сокращается с 42x до однозначных значений. Но настраивать придётся уже двумя параметрами больше.
Базовая архитектура — сначала ретривер, потом реранкер
Полный MaxSim по всем 4 874 документам занял 98 ms, или 122.7 ms end-to-end, на одной RTX 3090. Для нескольких тысяч документов это вполне приемлемо, но при миллионах линейная стоимость становится катастрофой. Все три сравниваемых deployment-гайда сходятся на одной схеме: дешёвый dense- или sparse-этап отбирает кандидатов, а late interaction их переранжирует.
- Пример Hugging Face. Сначала берёт dense-топ-50, затем применяет MaxSim. Документы кодируются один раз батчем, а оценка выполняется матричным умножением — значительно дешевле, чем отдельный forward pass cross-encoder для каждой пары.
- Qdrant. База поддерживает нативные мультивекторы с v1.10 и рекомендует late interaction прежде всего для реранжирования нескольких сотен кандидатов, а не для полного сканирования.
- Гайд Data AI Hub. Рекомендует гибридный поиск по топ-150, late-interaction реранжирование до 20, а затем при необходимости cross-encoder для финальных 5, отправляемых LLM.
У схемы «только реранкер» есть жёсткий потолок: она не вернёт документы, которые первый этап вообще не нашёл. Да и вся обвязка пайплайна далека от окончательно решённой:
едва ли существует универсально хорошая стратегия чанкинга, поиска и реранжирования. — u/gamerx88, r/MachineLearning
Какие базы данных поддерживают мультивекторы
В анонсе Hugging Face крупные движки тестируются на одном корпусе из 4 874 пассажей. Числа ниже — результаты их теста, а не маркетинговые заявления поставщиков:
| Движок | Нативная поддержка мультивекторов с версии | Загрузка / запрос в их тесте | Ограничения |
|---|---|---|---|
| Qdrant | v1.10 | 26.3 s / 18 ms | Точный MAX_SIM; рекомендуется серверный режим |
| Weaviate | v1.29 | 41 s / 17 ms | MUVERA быстрее, но потерял один правильный результат; на Windows нет embedded-режима |
| Vespa | «уже много лет» | ~80 s / 75 ms после прогрева | MaxSim задаётся как tensor expression; второй этап по умолчанию переранжирует лишь 100 кандидатов и пропустил 2 из правильного топ-3 |
fast-plaid | - | 5 s / 11 ms | Нет сервера; оценки приближённые, но ранжирование сохранилось |
| LanceDB | v0.15.0 | не тестировался | Нативный MaxSim |
| Milvus | v2.6.4 | не тестировался | Хранение в формате array-of-structs |
| VectorChord | - | не тестировался | Оператор MaxSim для PostgreSQL |
| Elasticsearch / OpenSearch | - | - | Только rescore; функция ES имеет статус technical preview в Enterprise tier |
В сравнительной таблице Hugging Face late-interaction индексирование turbopuffer было отмечено как private beta.
Что меняет Sentence Transformers v6.0
До 18 августа 2026 года для запуска моделей семейства ColBERT требовались отдельные фреймворки: PyLate, репозиторий Stanford ColBERT или colpali-engine. Версия 6.0 превращает MultiVectorEncoder в четвёртый полноправный тип модели библиотеки, со встроенными обучением, инференсом и интерпретируемостью. Он загружает чекпойнты Sentence Transformers, PyLate, Stanford ColBERT и ColPali; можно загрузить и базовый transformer, но в нём будет случайная проекция, требующая обучения. Требования: transformers v5.x, torch 2.2+ и huggingface-hub v1.x.
Три подводных камня из документации к релизу:
- Запросы и документы обрабатываются несимметрично.
encode_query()иencode_document()используют разные промпты, ограничения длины и маски скоринга. Вызвать универсальныйencode()для обоих типов данных — самый быстрый способ незаметно ухудшить результаты. - Обрезание происходит без предупреждения. Пассаж из 662 токенов, поданный в лимит LateOn для документа в 300 токенов, дал 273 вектора: всё остальное было отброшено. Лимит можно повысить до 512, но это уводит модель от распределения, на котором её обучали, и увеличивает индекс.
- У Flash Attention есть исключения. Моделям с non-attend query expansion, включая
colbert-ir/colbertv2.0иanswerai-colbert-small-v1, вместо этого нужен"sdpa".
По опубликованным Hugging Face оценкам линейка поддерживаемых моделей охватывает два порядка масштаба:
| Класс | Пример модели (параметры) | Оценка (средний NDCG@10) |
|---|---|---|
| Текст для edge-устройств | mxbai-edge-colbert-v0-17m (17M) | 0.6407 NanoBEIR |
| Небольшая текстовая модель | answerai-colbert-small-v1 (33M) | 0.6550 NanoBEIR |
| Лидер для текста | Семейство LateOn (149M) | 0.6868–0.6897 NanoBEIR |
| Визуальные документы | colqwen2.5-v0.2 (3.8B) / webAI-ColVec1.1-8b (8.4B) | 0.5402 / 0.6580 NanoViDoRe |
Когда обычные dense-векторы всё ещё лучше
Главная ошибка — внедрять мультивекторный подход в задачи, которым он не нужен. Откажитесь от него, если запросы широкие и тематические («статьи о цепочках поставок»), тексты короткие — заголовки, пары FAQ, твиты, — либо задача связана с кластеризацией, дедупликацией или рекомендациями, то есть требует оценки сходства объектов целиком. Не стоит усложнять стек и тогда, когда dense-поиск с реранкером уже выполняет ваши SLO по recall, а ключевое ограничение — стоимость. Гайд Data AI Hub добавляет ещё два случая: англоцентричные чекпойнты ColBERT могут уступать мультиязычному стеку bi-encoder плюс реранкер на многоязычных корпусах, а токеновые индексы плохо подходят для write-heavy и работающих в реальном времени корпусов.
Частые вопросы — с конкретными цифрами
Можно ли превратить обычную dense-модель в мультивекторную?
Иногда — и на удивление успешно. В экспериментах Qdrant выходные токеновые эмбеддинги BAAI/bge-small-en, dense-модели на 33M параметров, оценивали через MaxSim. На SciFact это дало 0.73696 NDCG@10: выше, чем у colbert-ir/colbertv2.0 с 0.69579 и у собственного pooled-вектора bge-small с 0.68213. На ArguAna порядок оказался обратным, и pooled dense победил. Это рабочий приём для добавления этапа реранжирования без новой модели, но не гарантия результата.
Насколько быстрее сжатый мультивекторный индекс?
На корпусе из 4 874 пассажей: полный MaxSim занял 98 ms, а fast-plaid — 11 ms; размер составил 92 MB вместо 311.5 MB.
Заменяют ли мультивекторные модели cross-encoder реранкеры?
С точки зрения затрат — да: представления документов рассчитываются заранее, а скоринг выполняется матричным умножением вместо forward pass для каждой пары запрос—документ. Но в анонсе Hugging Face cross-encoder по-прежнему назван самым точным вариантом для отдельной пары. Поэтому требовательные пайплайны сохраняют его для финального топ-5–20.
Оправдан ли late interaction для RAG?
Как этап реранжирования кандидатов от гибридного или dense-поиска — да, именно такую схему рекомендуют все три упомянутых deployment-гайда. В качестве ретривера первого этапа — только если измеренный recall первого этапа действительно является вашей проблемой, а индекс токеновых векторов укладывается в бюджет.
Как выбрать подход: краткая таблица
| Ваша задача | Рекомендация |
|---|---|
| Запросы с идентификаторами или несколькими условиями, длинные документы, юридические и технические тексты | Мультивекторный поиск или реранжирование — это территория +26 пунктов на MLDR |
| PDF, сканированные страницы, таблицы и графики в виде изображений страниц | Мультивекторные модели семейства ColPali; OCR-пайплайн не нужен |
| Широкий тематический поиск, короткие тексты, кластеризация, дедупликация, рекомендательные системы | Одиночные dense-векторы; потери от pooling здесь несущественны |
| До нужного качества почти дотягивает, но бюджет ограничен | Оставить dense первый этап и добавить MaxSim-реранжирование топ-50–150 |
| Миллионы документов и жёсткое ограничение по стоимости | Dense + cross-encoder реранкер либо сжатый late interaction (pooling 2–3 + fast-plaid) после измерений |
Остаётся нерешённый компромисс, на который указал @JudeJobs: сохранение качества после сжатия измеряют на бенчмарках, а не на беспорядочных production-корпусах. Начните с pooling в 2 раза, затем измерьте recall на собственных данных — он и покажет, насколько далеко можно зайти по кривой сжатия.