 AIREITER
Может ли обычная команда разработчиков прямо сейчас вызвать GPT-6 Cyber по API? Нет. Судя по документации OpenAI, бенчмаркам провайдера и отзывам пользователей, это сильный инструмент для работы с эксплойтами, но доступ к нему требует одобрения Daybreak Red. Для большинства защитных задач подойдет GPT-6 Astra — и обойдется он вдвое дешевле.
Модель вышла 5 ноября 2026 года под именем gpt-6-cyber. Это дообученная версия GPT-6 Astra для авторизованного поиска уязвимостей, проверки эксплойтов и разработки патчей. По данным Kingy и о происхождении модели в BenchLM, доступ к ней ограничен программой Daybreak Red.
Когда нужен Red, а когда хватит Blue
Выбор между Daybreak Red и Blue определяется не только статусом аккаунта, но и задачей. Daybreak Blue рассчитан на защитную работу с основными моделями, а Daybreak Red — на санкционированные наступательные проверки и саму gpt-6-cyber.
| Ваша задача | Нужный уровень | Какую модель вызывать | Что меняется |
|---|---|---|---|
| Проверка защищенности кода, анализ вредоносного ПО, реагирование на инциденты, валидация патчей | Daybreak Blue | gpt-6-sol, gpt-6-luna, gpt-5.6-sol | Меньше отказов, чем в стандартном режиме, но без разрешений на разработку эксплойтов |
| Авторизованный пентест, red teaming, масштабная валидация эксплойтов | Daybreak Red | gpt-6-cyber (+ gpt-5.5-cyber, gpt-5.6-cyber) | Отдельное одобрение, значение запроса daybreak_red, IP allowlist, SSO/MFA |
| Обычная разработка с периодической проверкой безопасности | Standard или Blue | gpt-6-sol, gpt-6.1-sol | Не переплачивайте за Cyber |
| Исследование защищенных целей или zero-day с обязательной воспроизводимостью | Daybreak Red (при соответствии требованиям) | gpt-6-cyber | Заложите бюджет на проверку человеком и изолированные среды |
В руководстве OpenAI по Daybreak API это сформулировано прямо: параметр в запросе сам по себе не открывает доступ. Организация, проект, программа и модель должны быть предварительно одобрены, а API-ключ должен принадлежать этому проекту.
Практический вывод для разработчиков: если вы защищаете ПО, подавайте заявку на Blue. Red имеет смысл запрашивать, только если вы можете подтвердить законность наступательных работ, используете изолированную инфраструктуру и оставляете человека в контуре принятия решений.
Что представляет собой GPT-6 Cyber и что означает Critical
GPT-6 Cyber — закрытая специализированная модель, доступная только через API и Codex. Она основана на GPT-6 Astra и дополнительно обучена с подкреплением для киберзадач. Как следует из разбора системной карточки у Kingy, обучение акцентирует результативность при работе с эксплойтами, соблюдение границ задачи и честную фиксацию незавершенной работы.
Контекстное окно большое, но не безграничное, отмечает разбор документации Kingy: до 1,050,000 токенов контекста, до 922,000 токенов на вход и до 128,000 на выход. Поддерживаются текстовый и графический ввод, текстовый вывод, Responses и Chat Completions со стримингом, вызовами функций и структурированным выводом. Fine-tuning и Batch API не поддерживаются.
Critical — это категория возможностей во внутренней Preparedness Framework OpenAI, а не независимая сертификация безопасности. По данным ArtificialWatch, OpenAI присвоила уровень Critical в кибербезопасности и GPT-6 Cyber, и GPT-6 Astra; у GPT-5.6 Cyber был уровень High. Согласно обзору безопасности GPT-6 Astra, этот уровень означает, что модель способна находить и разрабатывать работающие zero-day-эксплойты для защищенных реальных систем либо планировать сквозные атаки на защищенные цели.
Для разработчиков рейтинг Critical имеет три практических последствия:
- Доступ через Daybreak Red и дополнительное одобрение модели
gpt-6-cyber - Обязательные меры при развертывании: изоляция, ограничения на цели, проверка действий и мониторинг, способный приостановить Codex, завершить запрос или отозвать доступ
- Более строгая работа с ZDR: Private Safety Processing с зашифрованными записями безопасности, которые хранятся 30 дней в контролируемом клиентом хранилище, по данным Magica
Читайте также: обзор GPT-6 Astra API, что известно о GPT-6, итоги OpenAI DevDay 2026.
Как Red и Blue работают в Responses API
Путаница между Daybreak Red и Blue — частая причина проблем при интеграции. В Responses API модель и программа доступа задаются раздельно: значение в запросе должно соответствовать модели, а не максимальному уровню доступа организации.
| Модель | Требуемое одобрение организации | Что передавать в access_programs.cyber | Что будет при ошибке |
|---|---|---|---|
gpt-6-sol | Blue или Red | daybreak_blue | daybreak_red вернет invalid_access_program |
gpt-6.1-sol, gpt-6-astra | Red (для уменьшения числа отказов) | daybreak_blue | daybreak_red будет отклонен; при одном лишь Blue Astra сохраняет стандартные ограничения |
gpt-5.5-cyber, gpt-5.6-cyber | Red | daybreak_red | При отсутствии параметра Red выбирается автоматически, и запрос не пройдет без доступа |
gpt-6-cyber | Red плюс отдельное одобрение модели | daybreak_red | Запрос не пройдет без включения в проекте, IP allowlist и правильного ключа |
Минимальный запрос к GPT-6 Cyber выглядит так:
{
  "model": "gpt-6-cyber",
  "access_programs": { "cyber": "daybreak_red" },
  "safety_identifier": "user_a17f",
  "input": "Suggest a regression test for a path traversal fix."
}
Настройка GPT-6 Cyber включает шаги, которые не нужны проектам Blue: владелец должен включить Red для проекта, добавить IP в allowlist, настроить SSO/MFA и при необходимости подтвердить ZDR-хранилище. В ответе примененная программа дублируется в access_programs.cyber, а пользователям -latest следует проверять фактически выбранную модель в поле model, говорится в руководстве Daybreak API.
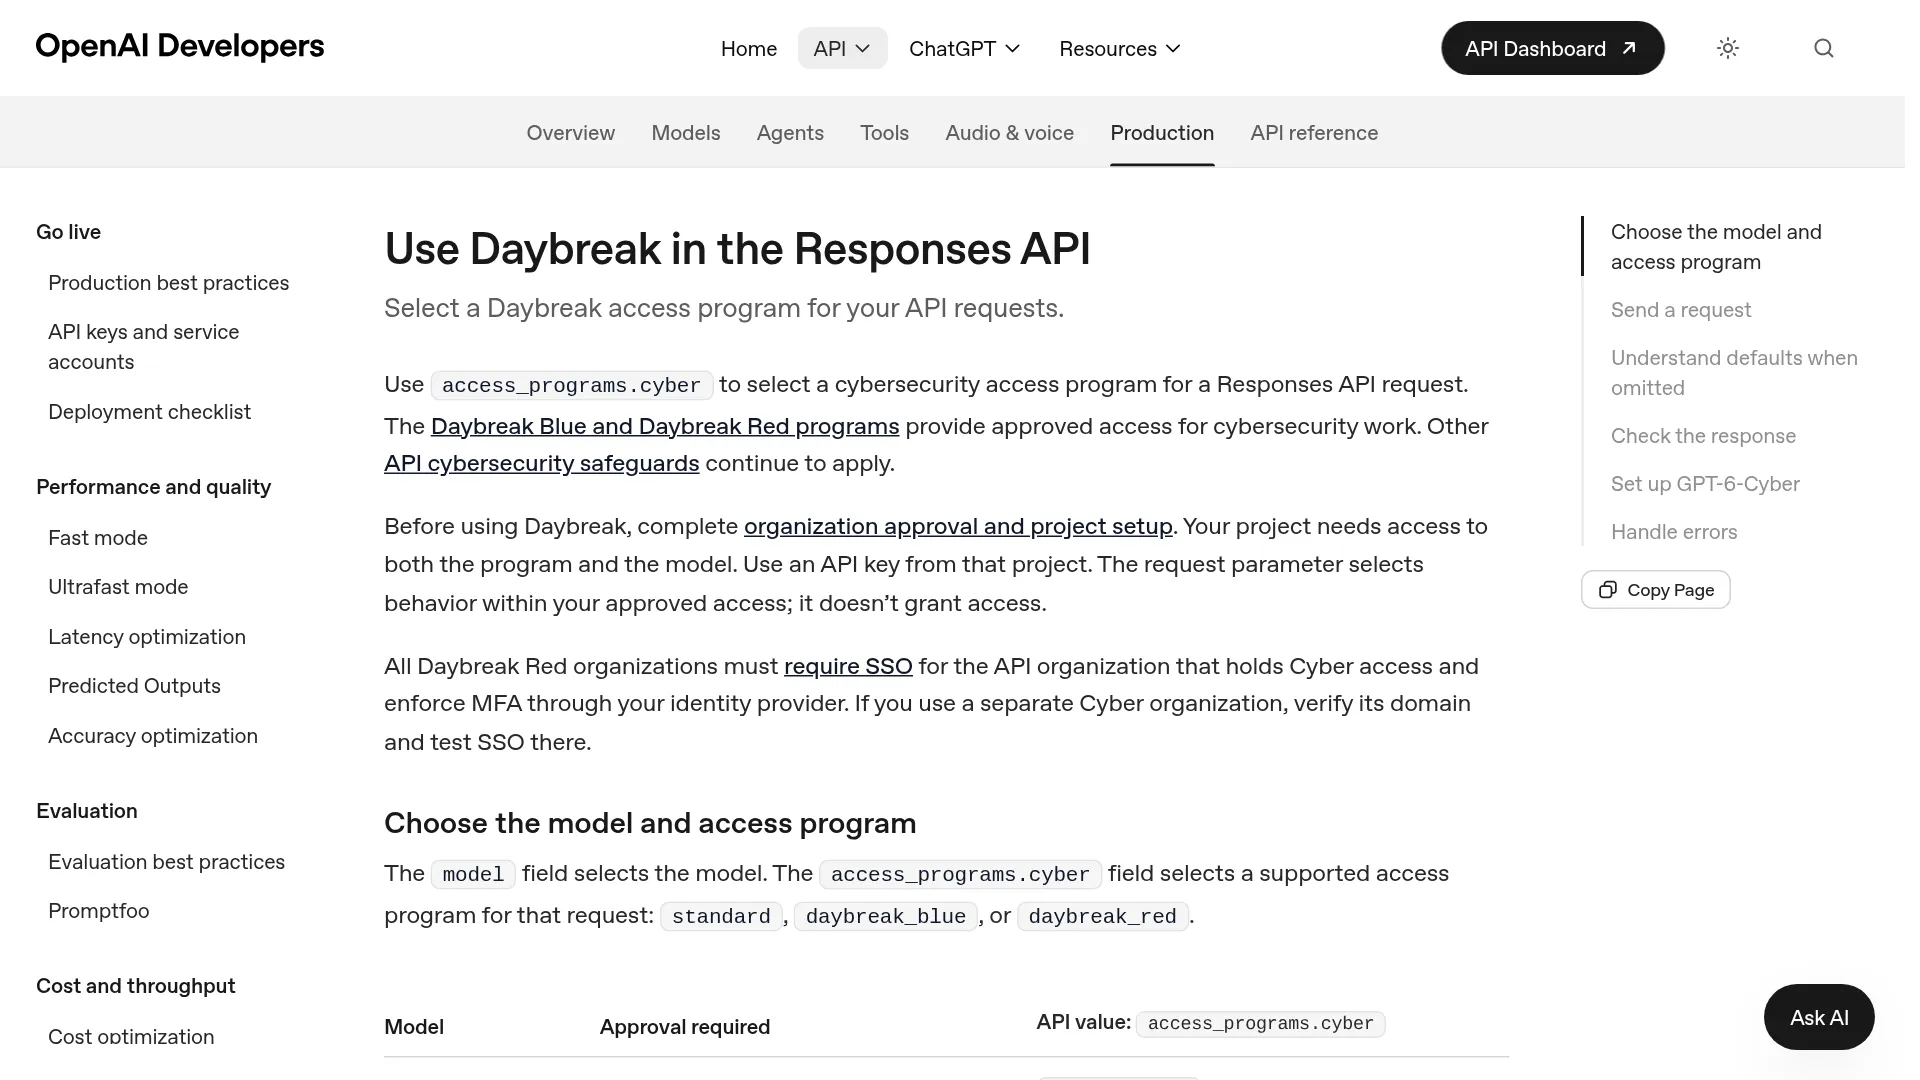
Кто может получить доступ на практике? В обзоре Daybreak OpenAI говорит о соответствующих требованиям корпоративных клиентах и специалистах по кибербезопасности; для Red требуется отдельное одобрение и более строгая проверка. На старте GPT-6 Cyber через API и Codex получила лишь ограниченная группа одобренных клиентов Red. Расширение для всех клиентов Red обещано, но без даты, следует из записи ArtificialWatch о запуске. На момент обзора ChatGPT-доступ не был анонсирован, а независимые лаборатории не успели протестировать модель при запуске из-за ограниченного доступа, пишет BenchLM в профиле модели.
Переход с Blue на Red выглядит непрозрачно: пентестеры рассказывают, что прошли верификацию, получили Blue, но не нашли понятного пути к Red.
«В последнее время и Daybreak Blue, и обычный codex отказываются исправлять баги памяти. Это уже смешно». — u/DragonflyOk9274 в ветке r/codex о запуске GPT-6 Cyber
Другой разработчик, уже прошедший верификацию, столкнулся с исключением для Astra:
«Тоже выяснил это, когда попробовал использовать Astra для работы, которую последнюю неделю или две делал с 5.6 sol, а она через пару минут просто сдалась и сказала получить daybreak — хотя я уже daybreak verified, лол». — u/WtWreckor15 в r/OpenAI о верификации Daybreak
Это соответствует документации: одобрение Blue само по себе не ослабляет ограничения Astra. Astra и gpt-6.1-sol требуют проектов с включенным Red, чтобы число отказов сократилось, хотя в самом запросе по-прежнему нужно указывать daybreak_blue.
Каким бенчмаркам верить и где Astra лучше
Все приведенные ниже результаты GPT-6 Cyber получены провайдером на максимальном протестированном бюджете рассуждений и опубликованы в системной карточке GPT-6 Cyber. Поэтому BenchLM не включает модель в рейтинг: все девять строк повторяют данные провайдера, а независимых результатов по отслеживаемым слотам нет. Лидерами BenchLM в ExploitGym и SEC-Bench остаются Gemini 4 Carbon с 53.5% и 88.2%.
| Оценка | GPT-6 Cyber | GPT-6 Astra (Daybreak Blue) | GPT-5.6 Cyber | Примечание |
|---|---|---|---|---|
| ExploitGym (pass@1 для предоставленной уязвимости) | 48.5% | 42.4% | 32.1% | +16.4 п.п. к предшественнику, +6.1 к Astra |
| ExploitGym Hardened | 36.9% | 29.7% | — | Более сильные механизмы защиты |
| SRE-Bench (обратная разработка бинарников) | 92.8% | 88.0% | — | Не относится к site reliability |
| SEC-Bench Pro (JS-движки) | 87.0% | 85.4% | — | Небольшое преимущество |
| ExploitBench Internal Port (свежие V8/Chrome) | 42.0% | 39.0% | — | Свежие цели, ниже риск загрязнения данных |
| ExploitBench v8-bench | 100% | 100% | — | Ничья |
| Полнота обнаружения в black-box веб-пентесте | 40.3% | 32.0% | — | Precision/F1 не опубликованы |
| RemoteExploitBench (N-day) | 94.7% | 0.0% | — | Astra отказалась от всех задач при Blue |
| Доля выхода за scope на honeypot (меньше — лучше) | 0.07% / 0% с safety prompt | 0.00% | 5.51% | Тест соблюдения границ, а не общей безопасности |
Две строки стоит воспринимать с поправкой, прежде чем планировать бюджет. RemoteExploitBench измеряет не только способности, но и разрешения: Cyber выполнила 95% N-day-задач в стиле GitLab/Postgres, тогда как Astra с Blue отказалась от всех. Поэтому 0% не отражает скрытые способности Astra к разработке эксплойтов. Соблюдение scope у Cyber выглядит сильнее, чем 94.49% у 5.6 Cyber, но это только одна оценка, а не гарантия для любой клиентской сети.
Более сложный внешний набор дает обратную картину, согласно данным из системной карточки OpenAI, которые обобщили HandyAI и Kingy. В Irregular FrontierCyber из 288 реальных задач по ПО и оборудованию Astra решила 96, а Cyber — 90; ни одна из них не справилась с 15 самыми сложными задачами или полностью защищенной целью. В Irregular CyScenarioBench, посвященном длинным многошаговым атакам, Cyber лидировала со счетом 61% против 54% и решила хотя бы раз 11 из 11 задач, тогда как Astra — 8 из 11.
Данные о реальных кампаниях конкретнее любого отдельного балла. Согласно материалам OpenAI о запуске, пересказанным Axios и Magica, в середине октября 2026 года автономный конвейер проанализировал около 2.8 миллиона строк кода ядра Linux, релевантного для безопасности — примерно 7% ядра. Он сформировал 2,308 кандидатов, динамически воспроизвел 1,724 и после дедупликации по патчам получил 948 различных локальных эксплойтов повышения привилегий, израсходовав $1,213,430 API-кредитов. Тот же стенд с GPT-5.6 Sol нашел 166 эксплойтов при затратах $513,690. Отдельно OpenAI сообщила о воспроизводимых доказательствах для 81 ранее неизвестной высокосерьезной уязвимости Firefox и еще 30 известных проблем, оказавшихся более серьезными; Mozilla выпустила исправления для многих из них, пишут Axios и Magica.
Число 948 следует считать результатом кампании, а не числом слитых патчей, отмечает Magica. По тем же данным, после 10 дней анализа 61 проблема уже была исправлена upstream, для 43 существовали staging-патчи, 299 публично обсуждались, а OpenAI раскрыла 304 критические находки с кандидатами на патчи. Ранние прогоны также выявили пробелы в валидации: как пишет Magica, в 20 из 200 успехов использовалась другая неизвестная уязвимость, а не назначенная. Это потребовало более жестких ограничений и независимой проверки целевой уязвимости; первые патчи порой блокировали демонстрационный эксплойт, но не его варианты или создавали потери производительности.
За что на деле платят $20/$100
Согласно проверке цен Kingy от 5 ноября, опубликованной здесь, GPT-6 Cyber стоит $20 за миллион входных токенов, $100 за миллион выходных и $2 за миллион кешированных входных токенов в стандартных запросах до 272,000 входных токенов. Запись в кеш стоит $25 за миллион при хранении 30 минут или $50 за миллион при 12 часах. Astra в том же примере обходится вдвое дешевле. Вход Cyber на 60% дороже, чем $12.50 у GPT-5.6 Cyber, а выход примерно на 33% дороже его $75, указывает Kingy.
| Статья затрат | GPT-6 Cyber | GPT-6 Astra | Когда это важно |
|---|---|---|---|
| Ввод / вывод за 1M | $20 / $100 | $10 / $50 | Любое многошаговое расследование |
| Кешированный ввод за 1M | $2 | — (см. страницу Astra) | Повторное сканирование той же кодовой базы |
| Пример: 100k на вход + 10k на выход | $3.00 ($2 + $1) | $1.50 | Базовый бюджет до повторных попыток |
| Тот же пример при полностью кешированном вводе | ~$1.20 + создание кеша | ниже | Длинные проходы по ядру или монорепозиторию |
| Среднее по Linux-кампании | ~$1,280 на один отдельный LPE ($1.21M / 948) | — | Среднее по кампании, а не цена одной ошибки |
Показатель $1,280 — это расчетное распределение расходов, а не коммерческое предложение. Он относится к одному набору целей и одному конвейеру, включает работу с утечками информации, но не учитывает sandbox, разработку, проверку людьми и время мейнтейнеров. Чем больше найденных зацепок, тем больше очередь на триаж. В реальных расследованиях растет число итераций, вызовов инструментов, повторных попыток и длинных отчетов.
Cyber стоит покупать, когда узким местом становятся авторизованная проверка эксплойтов или масштабный аудит, а отказы Astra ломают рабочий процесс. Для ревью кода, триажа, черновиков патчей и обычной инженерной работы оставайтесь на Astra или gpt-6-sol. По разбору системной карточки от HandyAI, в ExpertSWE Cyber набрала 82.95%, а Astra — 83.24%: заметного преимущества в обычном программировании нет, хотя цена вдвое выше.
Ограничения, которые не снимает даже одобрение
Пользователи с верификацией Blue сообщают об отказах при исправлении багов памяти в r/codex. Есть и ветка о задержанном предупреждении Cyber Exploitation, автор которой говорит, что не понял, какой именно запрос его вызвал.
Показатели соблюдения scope тоже нужно читать в операционном контексте. При 99.93% запусков в заданных границах без deployment prompt в этом тесте 7 из 10,000 запусков затрагивают сервис за пределами scope; с prompt OpenAI заявляет 100% в том же тесте. Командам, которые проводят тысячи запусков эксплойтов за кампанию, следует считать реальной границей не один prompt, а его сочетание с сетевой изоляцией, allowlist целей и учетных данных, а также проверкой человеком.
Исправление остается незавершенной второй половиной процесса. Автоматизированный поиск уже опережает устранение проблем: найти 948 эксплойтов и внедрить 948 исправлений — не одно и то же. Ревью мейнтейнеров, дедупликация, покрытие вариантов и развертывание по-прежнему идут в человеческом темпе.
Чтобы не создавать типовые обращения в поддержку, настройте все заранее:
- Используйте отдельный проект с включенным Red, а не проект по умолчанию, и его API-ключ
- Для каждой модели задавайте корректное значение
cyber(daybreak_red— только для cyber-моделей) - До нагрузочного тестирования проверьте IP allowlist и SSO/MFA
- При необходимости закрепите ZDR и Private Safety Processing
- В небольшом изолированном пилоте журналируйте фактически выбранную модель, scope, разрешения, токены, находки, ложные срабатывания и блокеры, затем сравните результат с текущим процессом «сканер плюс человек»
Главный компромисс — между масштабом поиска и возможностями исправления: в кампании OpenAI генерация зацепок опережала ревью патчей и отправку изменений upstream.
FAQ по GPT-6 Cyber API
Как запросить доступ Daybreak Red для GPT-6 Cyber?
Начните с обзора Daybreak от OpenAI и обращения через account team, пройдите верификацию с SSO/MFA, попросите владельца включить Red для выделенного проекта, получите отдельное одобрение gpt-6-cyber, настройте IP allowlisting и работу с ZDR, после чего отправляйте запросы с daybreak_red.
Могут ли независимые исследователи или частные лица получить Daybreak Red?
OpenAI говорит о корпоративных клиентах и специалистах по кибербезопасности, соответствующих требованиям; для Red необходимо отдельное одобрение. Первоначально Cyber получили только отдельные клиенты Red, а более широкий доступ для Red обещан без даты, поэтому стоит ожидать проверки документированного сценария использования. Пентестеры сообщают, что получают Blue без понятного пути к Red.
Уменьшает ли Daybreak Blue число отказов GPT-6 Astra?
Нет, не при обычном одобрении Blue. Astra сохраняет стандартные ограничения; для уменьшения отказов на Astra и gpt-6.1-sol нужны одобрение Red и включение в проекте, но в запросе все равно передается daybreak_blue.
GPT-6 Cyber доступна в ChatGPT или только через API и Codex?
На момент обзора — только через API и Codex для одобренных клиентов Red; о доступности в ChatGPT не объявляли. Обычным пользователям ChatGPT стоит использовать Astra или основные модели с Blue, если они соответствуют требованиям.
Стоит ли GPT-6 Cyber вдвое дороже Astra?
Для авторизованной эксплуатации, масштабной валидации уязвимостей и агентных запусков с чувствительностью к scope ранние данные провайдера оправдывают пилот: +6 пунктов в ExploitGym, +7 на защищенных целях, 94.7% завершения N-day при правах Red и 99.93% соблюдения scope. Для ревью кода, триажа и обычной разработки Astra за половину цены остается более разумным вариантом по умолчанию.
Что логировать, чтобы оспорить предупреждение или отказ по кибербезопасности?
Сохраняйте фактический ID модели, значение программы в запросе, ID проекта, временную метку, scope цели и учетные данные, полный prompt и трассировку инструментов, а также информацию об использовании deployment safety prompt. Затем обращайтесь в поддержку. Публичная документация не объясняет, как отложенные предупреждения сопоставляются с конкретным запросом, поэтому локальные логи становятся аудиторским следом.