 AIREITER
В r/codex регулярно задают один и тот же вопрос: «Я работал с GPT-5.5 на extra-high — что теперь брать, Sol или Terra?» Если коротко: у GPT-5.6 Sol ровно те же базовые API-тарифы, что и у GPT-5.5, а в агентных бенчмарках она сильнее. Для долгих агентных сценариев и веб-поиска переход может оказаться почти бесплатным.
Вот только одинаковый прайс-лист не означает одинаковый итоговый счёт. Sol берёт плату за запись в кэш, которой не было у GPT-5.5, и дольше рассуждает перед ответом. Поэтому расходы на отдельную задачу могут вырасти в разы, даже если тарифы формально не изменились.
Тарифы одинаковые, расходы — нет
Стандартные API-цены GPT-5.6 Sol и GPT-5.5 совпадают: $5.00 за миллион входных токенов, $30.00 за миллион выходных и $0.50 за кэшированный вход. Обе строки я сверил на странице цен OpenAI 29 июля 2026 года:
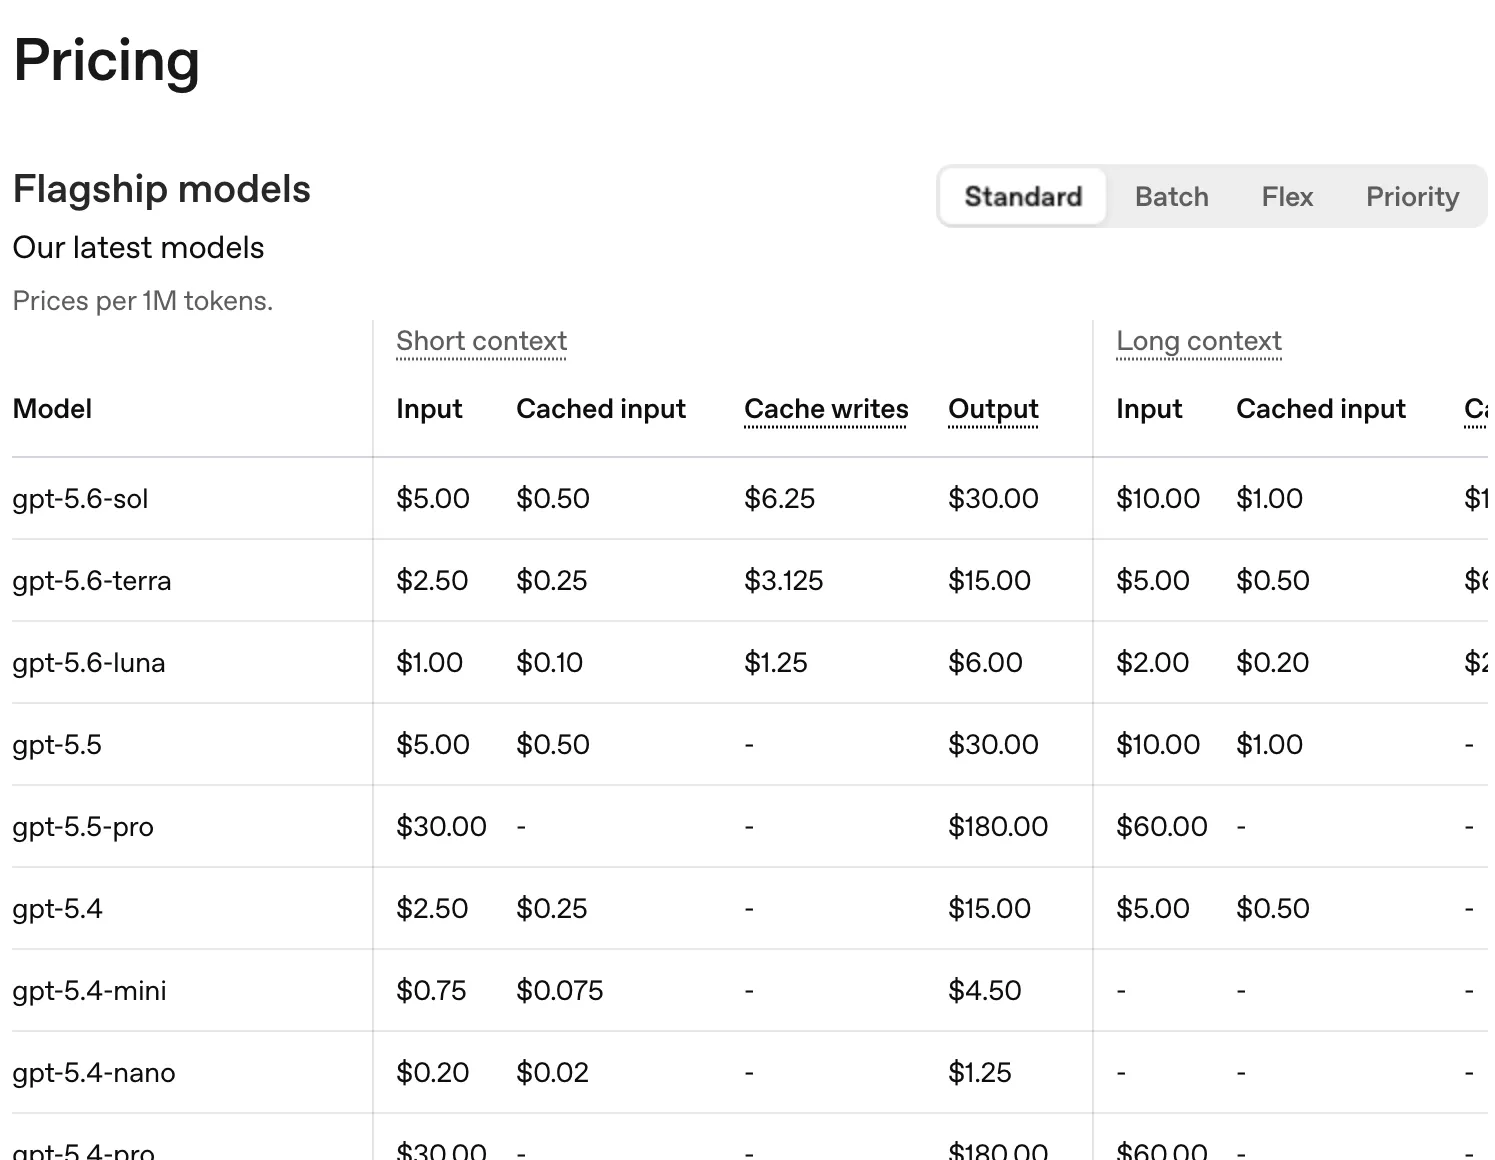
Разницу между моделями в этой таблице создают три строки:
| Статья тарифа | GPT-5.6 Sol | GPT-5.5 |
|---|---|---|
| Вход / выход (за 1 млн токенов) | $5.00 / $30.00 | $5.00 / $30.00 |
| Кэшированный вход | $0.50 | $0.50 |
| Запись в кэш | $6.25 | не тарифицируется |
| Длинный контекст (>272K): вход / выход | $10.00 / $45.00 | $10.00 / $45.00 |
При миграции чаще всего неожиданностью становится именно плата за запись в кэш. В GPT-5.6 появились явные cache breakpoints с минимальным сроком жизни 30 минут — механику подробно разбирает Vellum. Запись обходится в 1.25x от цены некэшированного входа, тогда как чтение получает скидку 90%. Простая арифметика по таблице выше: кэшированный сегмент стоит $6.25 при записи и $0.50 за каждое чтение, а повторная отправка без кэша — $5.00. Значит, кэш окупается со второго повторного использования. Но если пайплайн чаще пишет, чем читает, появляется расход, которого в GPT-5.5 вообще не было.
Вторая составляющая расходов связана со временем рассуждения. Sol дольше думает перед ответом, а reasoning tokens тарифицируются как выходные. Пользователи Codex, перешедшие на новую модель, описывают это напрямую:
«5.6 sol médium в три раза дороже 5.5-xhigh, хотя качество кода такое же — по крайней мере на старте 5.5». — r/codex, «GPT 5.5 and 5.6 conversion table»
То есть прайс-лист тот же, а одна задача обходится втрое дороже, потому что модель тратит втрое больше токенов. При этом в анонсе GPT-5.6 от OpenAI заявлены на 22% меньше входных и на 23% меньше выходных токенов по сравнению с GPT-5.5 во внутренних сопоставлениях. Эти утверждения не противоречат друг другу: эффективность одного шага рассуждения выросла, но на высоких уровнях effort модель может думать значительно дольше. Итог зависит от выбранного уровня effort.
Что действительно улучшилось по метрикам
В независимых оценках общего интеллекта GPT-5.6 Sol и GPT-5.5 почти не расходятся. По данным Artificial Analysis, Sol на уровне medium получает 54 балла в Intelligence Index v4.1, а GPT-5.5 на high — 53; смешанная стоимость в обоих случаях составляет $4.35 за миллион токенов. Главные изменения лежат в других областях:
- Задержка до первого токена: у Sol 4.13 секунды против 16.67 секунды у GPT-5.5 на high — разница в 4 раза. В интерактивных инструментах и агентных циклах с десятками последовательных вызовов это заметнее всего.
- Агентные бенчмарки: Sol набирает 88.8% в Terminal-Bench 2.1 и 92.2% в BrowseComp. Самый большой прирост этого релиза приходится на длительную работу с инструментами.
- Контекст: 1M токенов у Sol против 922K у GPT-5.5, а также сохранение рассуждений между ходами диалога — это задокументировано в упомянутом выше разборе Vellum.
- Скорость генерации: здесь, наоборот, есть регресс. Sol выдаёт 65 токенов в секунду против 77.3 у GPT-5.5. Массовая генерация станет медленнее, а не быстрее.
В наборе долгих задач по программированию от CodeRabbit — более 100 задач на пяти языках — Sol показала 63.7% успешных решений. В бенчмарке код-ревью она добавила 7.4 процентного пункта к базовой интеграции. Но есть важная оговорка: точность ревью у Sol составила 31.6%. Модель находит больше реальных проблем, однако вместе с ними приносит больше шума. Те же тестировщики зафиксировали случай, когда Sol потратила 8 раундов на простое изменение, выбрав неверное направление. Сильнее в марафонских задачах — не значит защищена от тупиковых веток.
Три одинаковых промпта: Sol против GPT-5.5
Бенчмарки поощряют длительные сценарии, но большинство API-вызовов короткие. Поэтому 29 июля 2026 года я отправил три одинаковых промпта в gpt-5.6-sol и gpt-5.5: исправление бага с обработкой дат в Python, логическую задачу с ограничениями и ровно двумя допустимыми ответами, а также извлечение данных в строгий JSON с ловушкой. В последнем случае дата была указана без года, а правила требовали вернуть null, а не угадывать. На каждую задачу пришёлся один API-вызов с уровнем reasoning effort по умолчанию, без инструментов и повторных попыток. Это небольшая выборка, а не бенчмарк.
Обе модели справились со всеми тремя заданиями. GPT-5.5 исправила декабрьский сбой через calendar.monthrange, а Sol вручную составила корректную таблицу високосных лет. Обе нашли ровно два допустимых порядка развёртывания, вернули побайтно идентичный JSON при извлечении данных и не стали придумывать год для «14 июля».
По токенам и скорости картина оказалась смешанной:
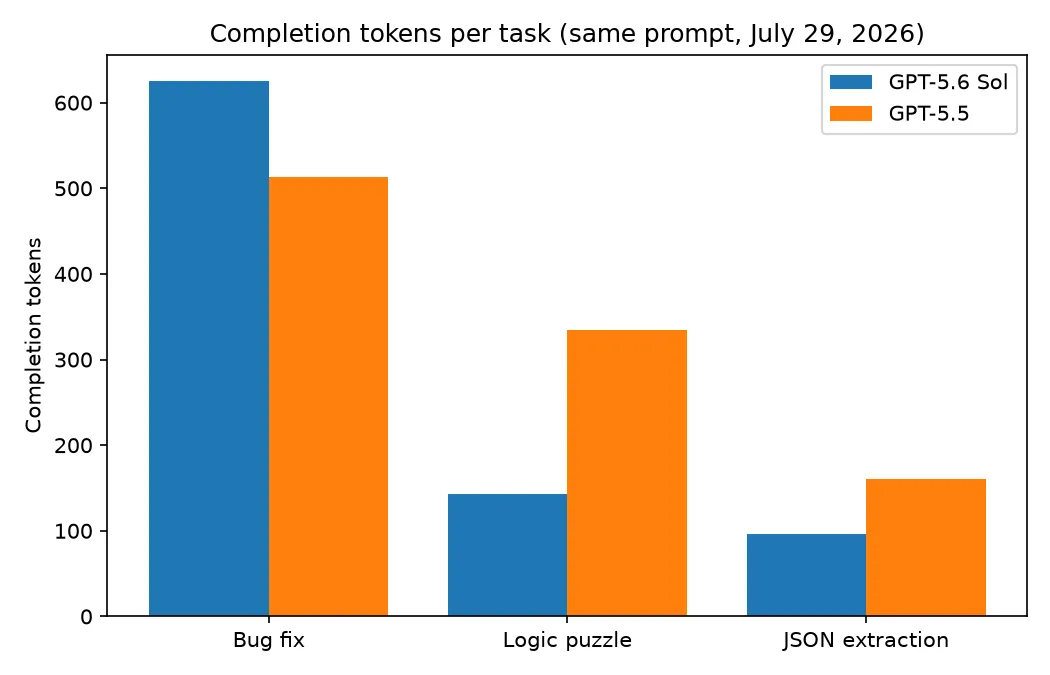
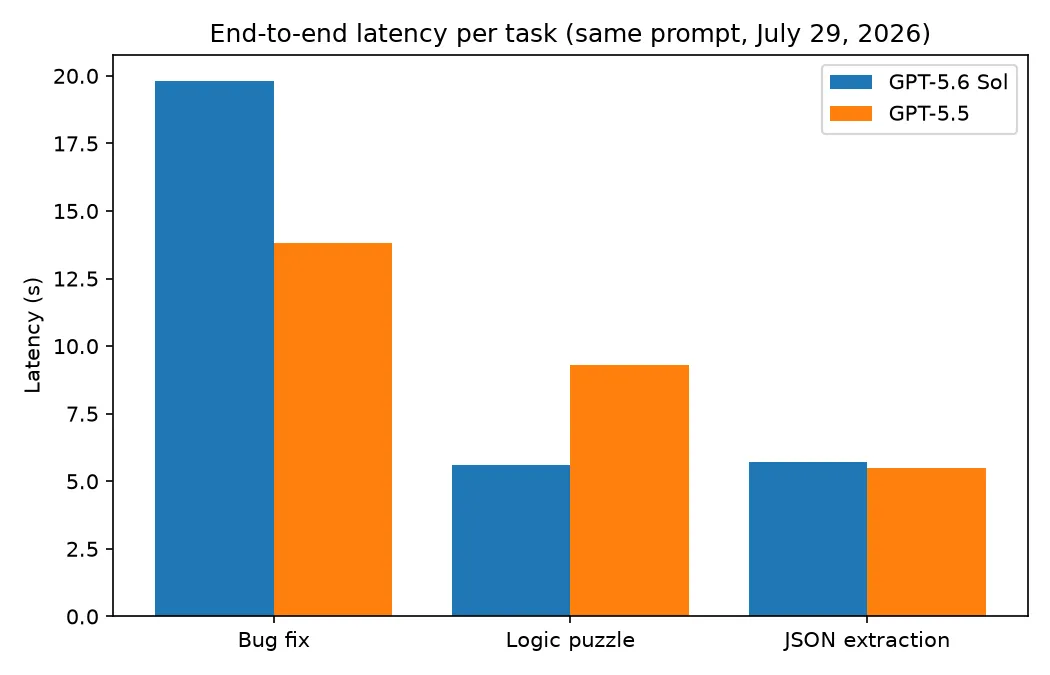
В сумме Sol потратила меньше токенов на завершение — 864 против 1,007, — но на задаче с кодом была и медленнее, и многословнее: 19.8 секунды и 625 токенов против 13.8 секунды и 513. На логической задаче всё поменялось: Sol ответила за 5.6 секунды, уложившись в 143 токена, тогда как GPT-5.5 понадобилось 9.3 секунды и 334 токена. Мой вывод после этого сравнения: на коротких и чётко поставленных задачах модели взаимозаменяемы, и сам по себе этот тест не даёт причины для миграции. Аргумент в пользу обновления целиком строится на агентных задачах и длинном контексте из бенчмарков выше.
Как сопоставить уровни effort в GPT-5.5 и 5.6
Согласно упомянутому разбору Vellum, ID модели без суффикса — gpt-5.6 — по умолчанию направляет запросы в gpt-5.6-sol. Тот, кто просто заменит алиас при обновлении, получит флагманский уровень вместе с его счётом, даже не выбирая его явно. Для осознанной миграции полезны три ориентира:
- GPT-5.5 xhigh → Sol medium — рабочее соответствие, которое использует сообщество. В процитированном выше обсуждении r/codex сообщалось о сопоставимом качестве с 5.5 и примерно втрое большей стоимости задачи около времени запуска. Считайте это гипотезой, которую нужно проверить на собственных промптах, а не гарантией. Если для нагрузки на GPT-5.5 high важен бюджет, экономически ближе будет GPT-5.6 Terra с тарифом $2.50/$15 — вдвое ниже, чем у Sol.
- На верхних уровнях время рассуждения резко растёт. Пользователи ChatGPT Pro сообщают, что GPT-5.6 тратит на задачи 20–50 минут, тогда как 5.5 Pro укладывалась в 5–10. Это наблюдение относится к ChatGPT, но тот же стек рассуждений в API тарифицируется как выходные токены. Настройка
reasoning.mode: "pro"доступна во всех трёх уровнях 5.6, поэтому максимальная глубина рассуждения включается только по желанию. - Старые промпты способны навредить новой модели. Команда Every.to обнаружила, что ответы Sol заметно улучшились лишь после удаления защитных инструкций, написанных для старых моделей. Правила вроде «всегда дважды проверяй X» заставляли Sol излишне перепроверять и усложнять решение. После миграции модели стоит заново проверить системный промпт: осторожные подпорки, необходимые GPT-5.5, теперь превращаются в дополнительный расход.
Кому переходить на Sol, а кому пока остаться на GPT-5.5
Выбирайте GPT-5.6 Sol, если ваша нагрузка агентная: многошаговая работа с инструментами, исследование через браузер или сессии кодинга в масштабе репозитория. Именно в таких сценариях проявляются 88.8% в Terminal-Bench и 92.2% в BrowseComp, а четырёхкратное снижение задержки до первого токена накапливается на каждой итерации цикла. При тех же тарифах $5/$30 прирост возможностей не требует доплаты — если разницу не съедят дополнительные reasoning tokens и запись в кэш. Контекст 1M и сохранение рассуждений между ходами также убирают два обходных решения, которые приходилось строить в пайплайнах на 5.5.
Оставайтесь на GPT-5.5 — пока — если у вас короткие, строго определённые запросы: извлечение данных, классификация, одноразовые исправления кода, массовая генерация. В моём тесте из трёх промптов модели оказались равны именно на таком типе задач, а более медленный стриминг Sol — 65 против 77.3 токена в секунду — делает пакетные задания однозначно хуже. Пайплайнам с интенсивной записью промптов в кэш перед переходом нужно посчитать строку $6.25. А если обновление должно дать похожее качество при меньшем счёте, выбирать нужно Terra, а не Sol.
Прямое сравнение я проводил через AIReiter: там доступны gpt-5.6-sol и gpt-5.5 за одним API-ключом. Для A/B-теста достаточно поменять строку модели и сравнить на собственном трафике долю успешных задач, полную задержку и число токенов завершения на задачу.
FAQ
GPT-5.6 Sol лучше GPT-5.5?
В агентных задачах — однозначно: 88.8% в Terminal-Bench 2.1, 92.2% в BrowseComp и в 4 раза меньшая задержка до первого токена. В коротких одноразовых задачах независимая оценка разделяет модели всего на один балл — 54 против 53 по Artificial Analysis, — а мои тесты с одинаковыми промптами не выявили разницы в корректности.
GPT-5.6 Sol дороже GPT-5.5?
Базовые тарифы идентичны: $5 за входные и $30 за выходные токены на миллион. Но Sol добавляет плату $6.25 за запись в кэш, которой у GPT-5.5 не было, а на высоких уровнях effort тратит больше reasoning tokens на задачу. Пользователи r/codex намерили примерно трёхкратную стоимость задачи при качестве на уровне 5.5 xhigh.
Какой режим GPT-5.6 соответствует GPT-5.5 xhigh?
Sol на уровне medium даёт сопоставимое качество кода примерно при втрое большей стоимости задачи. Если важнее сохранить сопоставимый бюджет, чем получить максимальный потолок возможностей, ближе по экономике будет Terra.
Можно ли продолжать использовать GPT-5.5 после обновления?
Да. GPT-5.5 по-прежнему указана на странице цен OpenAI с неизменными тарифами — это проверено 29 июля 2026 года, смотрите скриншот выше. Пока ничто не вынуждает мигрировать.
Выбор в одной таблице
| Ваша нагрузка | Выбор | Решающий факт |
|---|---|---|
| Многошаговые агенты, веб-поиск, кодинг в масштабе репозитория | GPT-5.6 Sol | 88.8% в Terminal-Bench, в 4 раза ниже задержка до первого токена, те же тарифы |
| Короткое извлечение / классификация / одноразовые исправления | GPT-5.5 (пока) | Паритет в тестах с одинаковыми промптами; 5.5 стримит на 19% быстрее |
| Интенсивная запись в кэш промптов | GPT-5.5 или сначала перестроить архитектуру | У Sol появилась новая плата $6.25/1M за запись в кэш |
| Сопоставимое качество, меньший счёт | GPT-5.6 Terra | $2.50/$15, вдвое дешевле Sol; смотрите сравнение Terra и 5.5 выше |
| Максимальная глубина рассуждения | Sol с reasoning.mode: "pro" | 20–50 минут размышлений там, где 5.5 тратила 5–10 |