 AIREITER
В 1 715 сессиях Codex GPT-5.6 Sol в среднем расходовал 16,45 млн токенов на сессию — это в 2,25 раза больше, чем 7,30 млн токенов у GPT-5.5 за сопоставимый период из 1 667 сессий. Тариф за токен одинаковый, а расход — более чем вдвое выше. Вдобавок у Sol, судя по всему, есть задокументированная ошибка в Responses API, из-за которой оплачиваемый показатель output_tokens может завышаться в 6 раз и более. Если счёт за GPT-5.6 кажется вам неверным, скорее всего, так и есть.
Сколько токенов в действительности тратит GPT-5.6 Sol
Разработчик Vincent Schmalbach отследил расход токенов в двух 14-дневных периодах использования Codex. Он сравнил GPT-5.5 xhigh и GPT-5.6 Sol xhigh при почти одинаковом числе сессий:
| Показатель | GPT-5.5 xhigh | GPT-5.6 Sol xhigh |
|---|---|---|
| Сессии | 1,667 | 1,715 |
| Всего токенов | 12.17B | 28.22B |
| Токенов на сессию | 7.30M | 16.45M |
Число сессий выросло на 2,9%, а токенов на сессию — на 125%. При примерно том же объёме работы суммарный расход увеличился с 12,17 млрд до 28,22 млрд токенов, то есть в 2,32 раза.
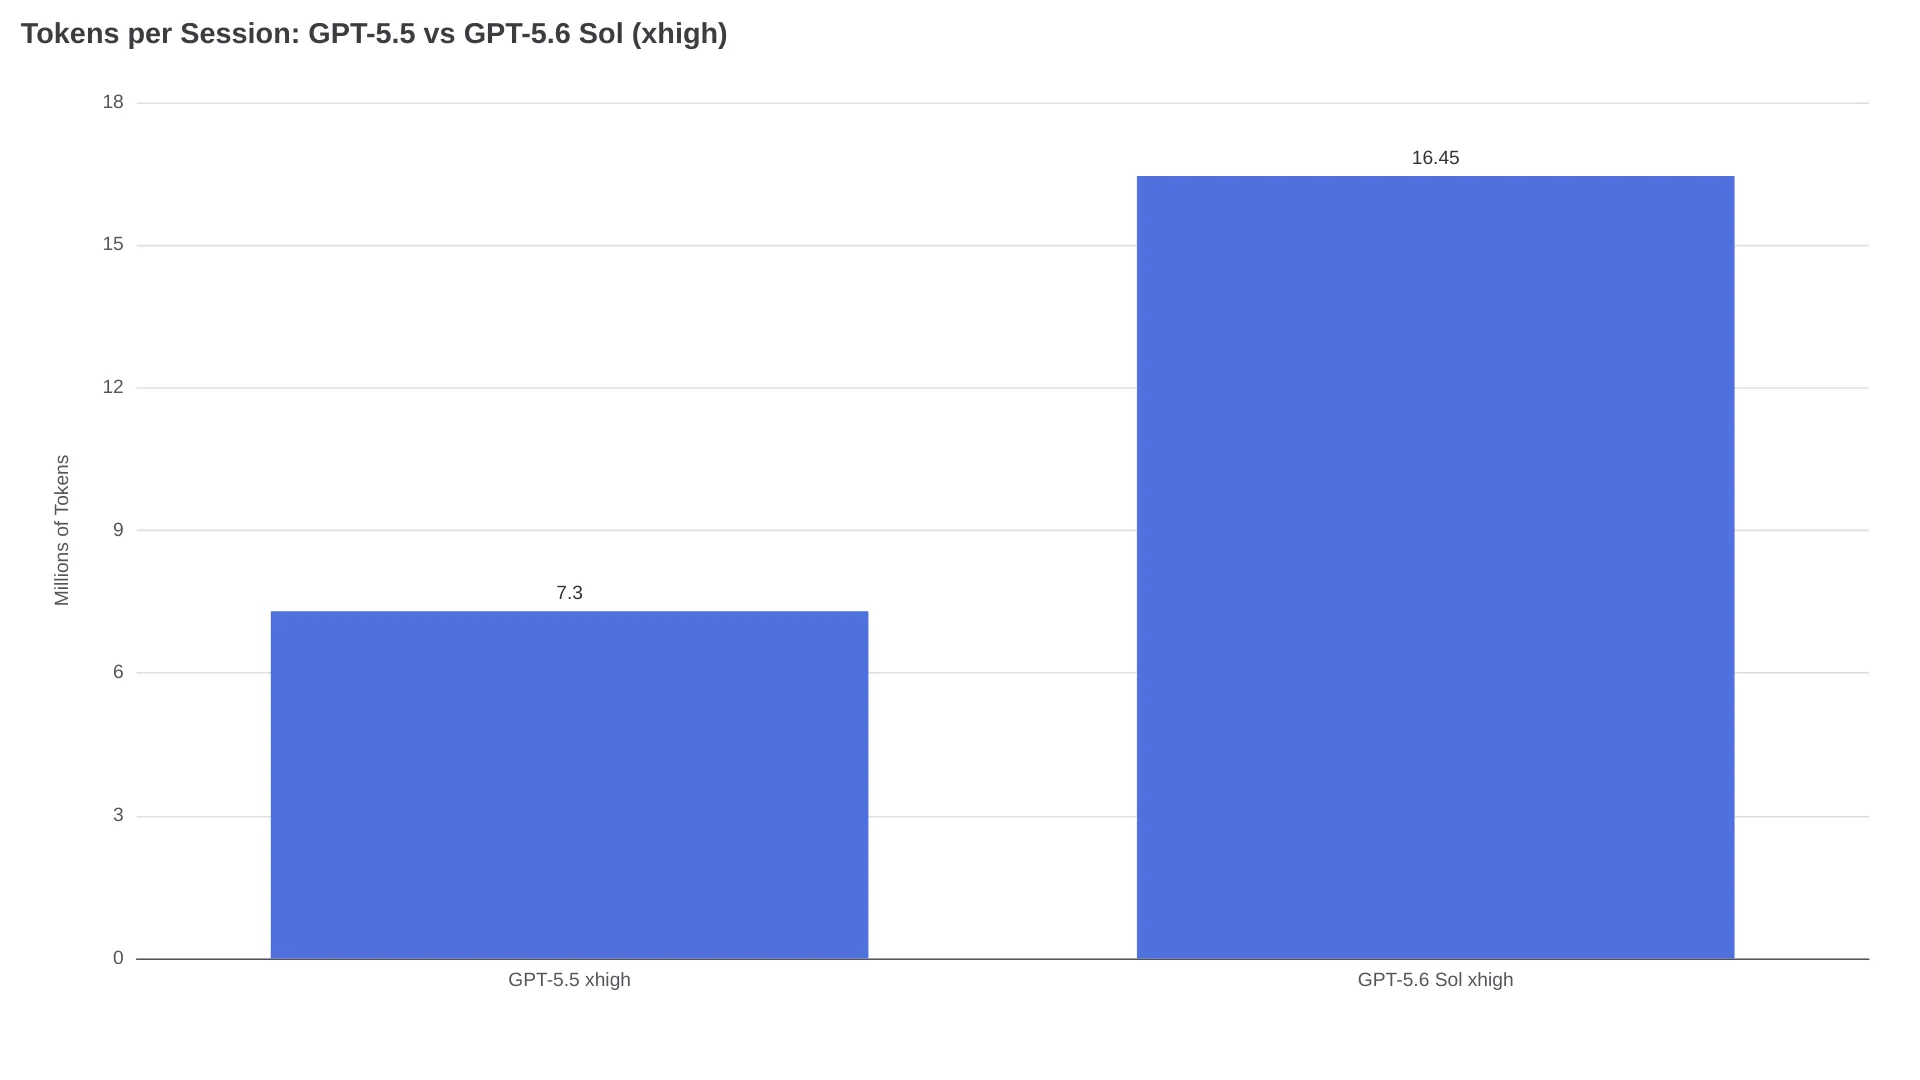
На странице тарифов OpenAI для GPT-5.6 Sol указаны $5 за 1 млн входных и $30 за 1 млн выходных токенов — ровно столько же, сколько для GPT-5.5. При одинаковой ставке расход в 2,25 раза выше означает примерно в 2,25 раза большую стоимость задачи. Кроме того, в GPT-5.6 Sol появилась доплата за запись в кэш: 1,25 от ставки за входные токены. У GPT-5.5 такой комиссии не было.
«GPT 5.6 Sol — настоящая печь для сжигания токенов. Даже Sol на medium или high словно пожирает их. 5.6 стоит использовать только для сложного планирования или каверзных багов». — пользователь r/codex
Три подписки Schmalbach, которых раньше хватало на неделю интенсивной работы, теперь заканчиваются примерно за один день работы со средней нагрузкой.
Откуда у Sol такой расход
По эффективности на единицу результата бенчмарков Sol превосходит конкурентов. В Artificial Analysis Coding Agent Index ему нужно меньше выходных токенов, чем Claude Fable 5, чтобы набрать сопоставимый балл. Но в реальных сессиях Sol рассуждает активнее: строит планы, возвращается назад, проверяет себя и перебирает альтернативы. Цена этого подхода — больше токенов на задачу, хотя каждый из них выполняет больше полезной работы.
Заявленная ошибка биллинга, завышающая выходные токены
Помимо повышенного фактического расхода, есть задокументированная ошибка учёта в Responses API. Вероятно, она завышает поле output_tokens, именно по которому рассчитывается оплата. OpenAI расследует проблему, но публично не подтверждала её первопричину.
Один разработчик описал проблему на 710 вызовах GPT-5.6 и 22 922 вызовах reasoning в сумме. GPT-5.6 — первое семейство моделей, которое выдаёт несколько элементов reasoning в одном ответе: медиана k=9 для Sol и k=4 для Terra. Во время генерации накопитель API добавляет текущую сумму reasoning для каждого такого элемента, а затем к ней прибавляется и корректный итоговый счётчик.
Формула выглядит так:
output_tokens ≈ R × (k + 3) / 2Здесь R — фактическое число токенов reasoning, а k — число элементов reasoning. Для Sol с медианой k=9 оплачиваемый счётчик завышается примерно в 6 раз. Для Terra при k=4 — примерно в 3,6 раза.
Как это выглядит в счёте
Самый показательный задокументированный случай: один вызов GPT-5.6 Terra вернул ответ из четырёх символов — d1d4, — но в счёт попали 466 818 выходных токенов при всего 21 064 фактических токенах reasoning.
| Что сообщило API | Значение |
|---|---|
output_tokens (выставлено к оплате) | 466,818 |
reasoning_tokens (фактически) | 21,064 |
| Видимый ответ | d1d4 (4 символа) |
| Элементы reasoning (k) | 41 |
При k=41 формула даёт R × (41+3)/2 = 21,064 × 22 = 463,408 — расхождение с выставленной суммой составляет менее 0,7%. Автор сообщения сверил это с панелью биллинга: сумма output_tokens из API, умноженная на опубликованные тарифы, воспроизводила списания в панели с точностью до одной десятой цента. По всем его вызовам GPT-5.6 из примерно $320 начислений около $284 были переплатой.
Ошибка появилась ещё до GPT-5.6
При k=1 — один элемент reasoning, который выдают модели до 5.6, — формула сводится к R × 4/2 = 2R. То есть получается постоянная переплата в 2 раза. Автор отчёта подтвердил это по собственному экспорту использования OpenAI за май 2026 года:
| Модель | Оплаченные выходные токены | Фактическое число | Соотношение |
|---|---|---|---|
| o3-mini | 25,408,973 | 12,376,132 | 2.02x |
| gpt-5.4-nano | 11,718,610 | 5,844,140 | 2.00x |
| o1 | 778,989 | 335,944 | 2.01x |
| o4-mini (контроль) | 12,054,680 | 9,160,567 | 1.01x |
GPT-5.6 не создал эту ошибку — он первым начал дробить reasoning на множество элементов, из-за чего незаметный множитель 2x превратился в гораздо более серьёзный. Причина в том, что reasoning передаётся блоками примерно по 512 токенов, поэтому k ≈ ceil(R/512). Подстановка в формулу даёт output_tokens ≈ R²/1024 + 3R/2. Иными словами, переплата растёт квадратично относительно длины рассуждения: вдвое больше размышлений — примерно вчетверо больше счёт.
На момент публикации этого материала, в августе 2026 года, сотрудники OpenAI ответили на сообщение об ошибке и запросили дополнительные данные. Однако ни исправление, ни корректировка счетов публично пока не подтверждены.
Тарифы GPT-5.6 после снижения цен 30 июля
30 июля 2026 года OpenAI снизила цену Luna на 80%, а Terra — на 20%. Тарифы Sol не изменились. Актуальные цены со страницы тарифов OpenAI:
| Модель | Вход (короткий) | Кэшированный вход | Запись в кэш | Выход (короткий) | Выход (длинный) |
|---|---|---|---|---|---|
| GPT-5.6 Sol | $5.00 | $0.50 | $6.25 | $30.00 | $45.00 |
| GPT-5.6 Terra | $2.00 | $0.20 | $2.50 | $12.00 | $18.00 |
| GPT-5.6 Luna | $0.20 | $0.02 | $0.25 | $1.20 | $1.80 |
| GPT-5.5 | $5.00 | $0.50 | — | $30.00 | $45.00 |
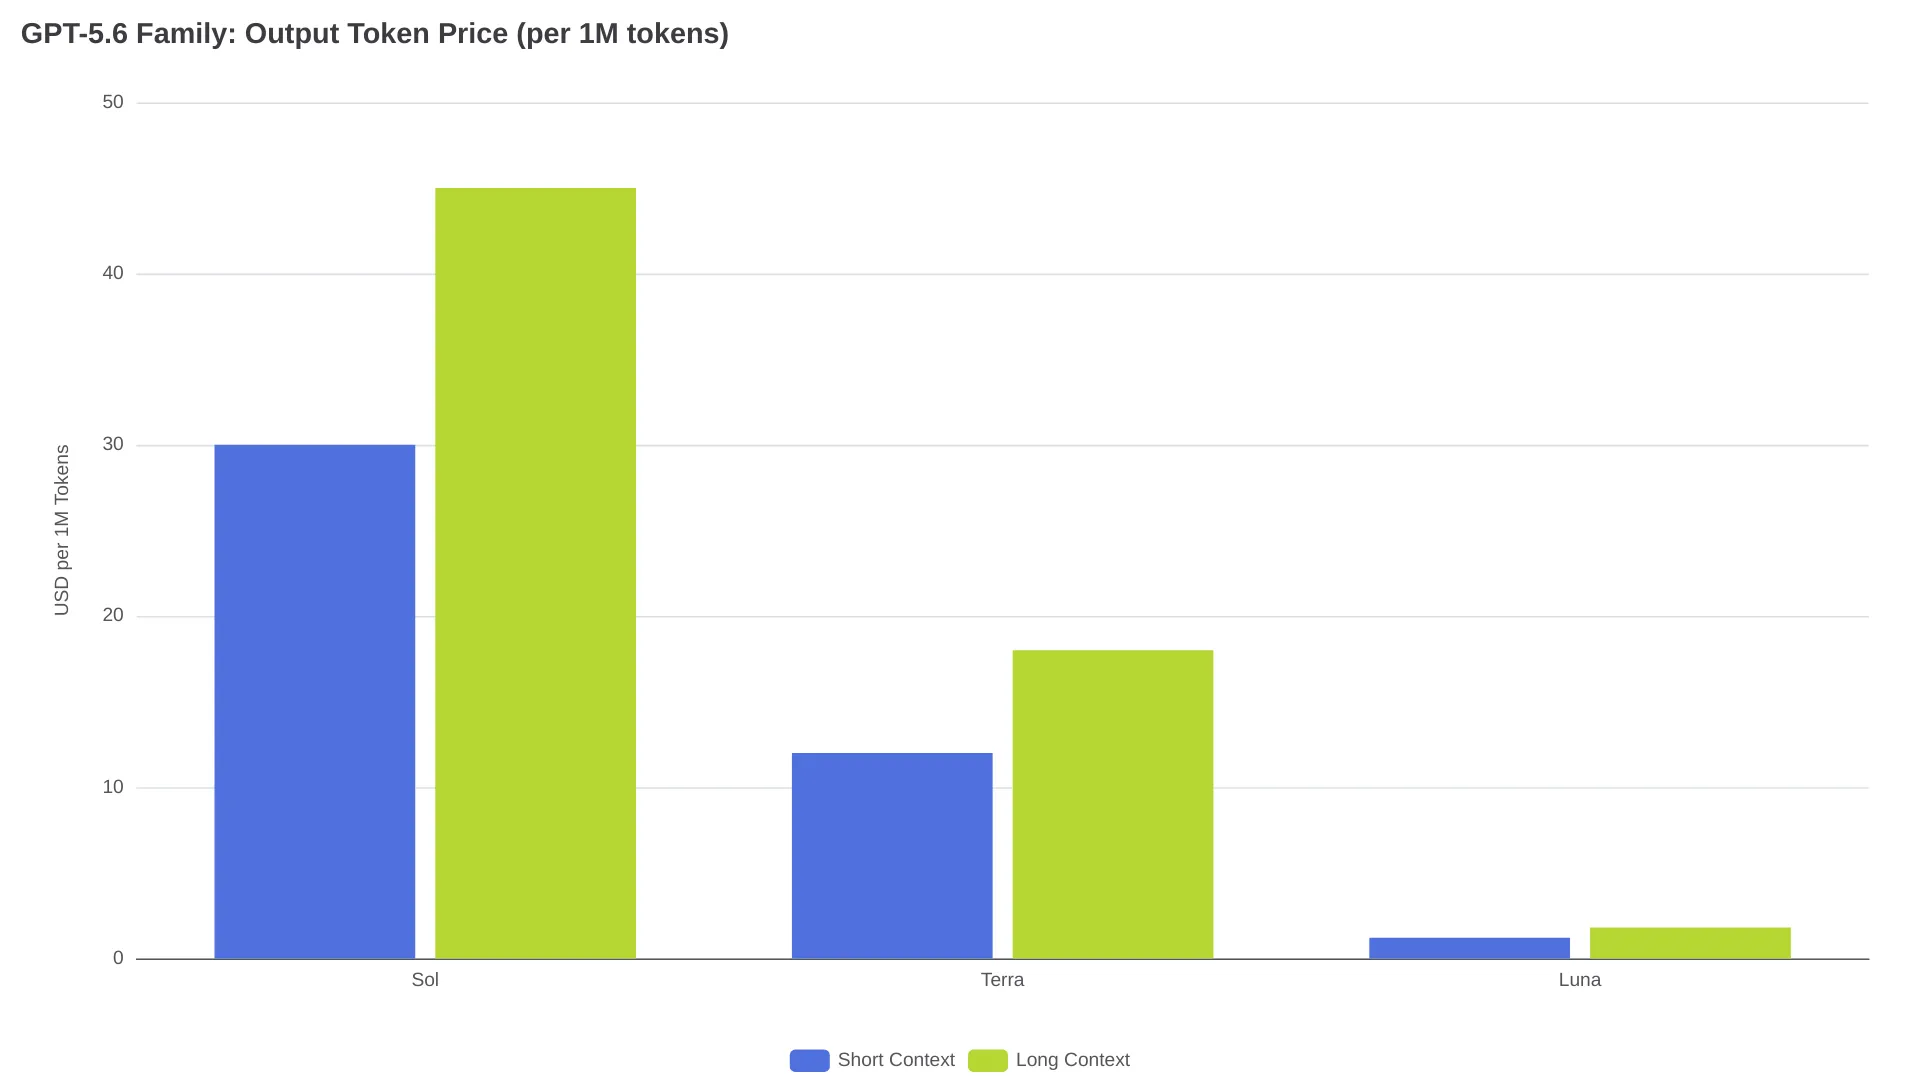
Sol стоит столько же за токен, сколько GPT-5.5, но расходует в 2,25 раза больше токенов на задачу. Поэтому фактическая цена задачи примерно удваивается.
Запись в кэш стала отдельной статьёй расходов. GPT-5.6 берёт за неё 1,25 от ставки входных токенов: $6.25 за 1 млн для Sol. У GPT-5.5 такой платы не было. Если в вашей нагрузке мало попаданий в кэш, к входным расходам добавится наценка 25%, которой раньше не существовало.
Luna теперь дешевле GPT-5.4 nano. При $0.20/$1.20 против $0.20/$1.25 у nano Luna после снижения цены стала самой дешёвой моделью в линейке OpenAI.
Три способа сократить расходы на токены GPT-5.6
Для типовых задач перейти на Terra
Выходные токены Terra стоят $12 за 1 млн — на 60% дешевле, чем $30 за 1 млн у Sol. В Artificial Analysis Coding Agent Index Terra набирает чуть больше баллов, чем Claude Fable 5. После июльского снижения цены на 20% тариф Terra в $2.00/$12.00 стал ниже прежнего тарифа GPT-5.5.
Когда Sol всё ещё оправдан? В многошаговой отладке, планировании архитектуры для крупных кодовых баз и анализе безопасности. Такие задачи выигрывают от длинных цепочек рассуждений. Для обычного программирования, анализа и генерации контента Terra даёт сопоставимый результат при заметно меньшем расходе токенов.
Снизить уровень effort
Параметр reasoning.effort задаёт, сколько токенов reasoning генерирует модель, а описанная ошибка биллинга напрямую масштабируется с числом элементов reasoning (k). На уровне medium Sol выдаёт меньше таких элементов, чем на xhigh, поэтому и завышение счёта пропорционально снижается.
«Я использую Terra Ultra, и расход токенов действительно кажется намного эффективнее, чем у GPT 5.5». — пользователь r/codex
Поведение «печи для токенов» характерно прежде всего для Sol на высоких уровнях effort. Переключение reasoning.effort с xhigh или max на medium либо high — самое эффективное изменение, которое можно внести.
Добиваться максимума попаданий в кэш
В GPT-5.6 появились явные точки разрыва кэша и минимальное время жизни кэша в 30 минут. Чтение из кэша даёт скидку 90%: стоимость входных токенов Sol падает с $5.00 до $0.50 за 1 млн. Но запись в кэш стоит 1,25 от входного тарифа — $6.25 за 1 млн у Sol.
Стройте промпты так, чтобы системное сообщение и статичный контекст находились перед точкой разрыва кэша. Точка окупаемости зависит от конкретной нагрузки: надбавка за запись в кэш составляет 25% от входного тарифа, а экономия на чтении — 90%. Поэтому доля попаданий должна быть такой, чтобы экономия на чтениях превысила надбавку за запись. Если большинство запросов использует общий длинный системный промпт, баланс быстро складывается в вашу пользу.
FAQ
OpenAI признала ошибку биллинга?
Сотрудник OpenAI Mark G. ответил на сообщение на форуме сообщества 12 июля 2026 года и запросил ID запросов и временные метки для расследования. На август 2026 года публичного подтверждения исправления или ретроактивной корректировки счетов нет.
Как проверить, затрагивает ли ошибка мой аккаунт?
Для любого ответа с несколькими элементами reasoning сложите usage.output_tokens_details.reasoning_tokens и токены видимой части ответа. Если usage.output_tokens превышает эту сумму более чем на несколько процентов, на ваш счёт, вероятно, влияет описанное в отчёте на форуме повторное накопительное суммирование. Скачайте CSV с данными об использовании из панели OpenAI и проверьте показатели по моделям.
Стоит ли переходить с Sol на Terra?
Для большинства API-нагрузок Terra обходится дешевле и показывает конкурентные результаты в бенчмарках программирования. Преимущество Sol проявляется на самых трудных задачах: собственные бенчмарки OpenAI показывают, что Sol сильнее Terra прежде всего в многошаговых рассуждениях и исследованиях безопасности, где дополнительное время на размышления даёт наибольшую отдачу.