 AIREITER
В наших трёх одинаковых API-тестах GPT-5.6 Luna и DeepSeek V4 Pro справились без ошибок: 3 из 3 у каждой. Поэтому решающим фактором здесь, скорее всего, станет не качество ответов, а задержки и модель ценообразования. Тем более что на странице тарифов DeepSeek уже есть официальное предупреждение о существенном повышении цен. Ниже — результаты замеров от 10 августа 2026 года и практический выбор под разные сценарии.
Три одинаковых задачи: результаты API-теста
10 августа 2026 года мы отправили в GPT-5.6 Luna и DeepSeek V4 Pro три идентичные задачи через один API-пайплайн. Обе модели работали с настройками по умолчанию. Проверили исправление ошибки в Python с намеренно кратким требованием ("reply with the corrected function only"), задачу на расписание грузовиков у трёх доков с единственным верным ответом (10:10) и извлечение данных в строгий JSON с nullable-полем. Все три задания обе модели решили правильно.
| Задача | GPT-5.6 Luna | DeepSeek V4 Pro |
|---|---|---|
Исправление ошибки в Python merge_intervals | Верно (исправление через max()), 10.7s | Верно (исправление через max()), 16.1s |
| Рассуждение о расписании доков | Верно (10:10), 8.0s | Верно (10:10), 27.2s |
| Извлечение в строгий JSON | Валидный JSON, точное соответствие схеме, 3.0s | Валидный JSON, точное соответствие схеме, 7.6s |
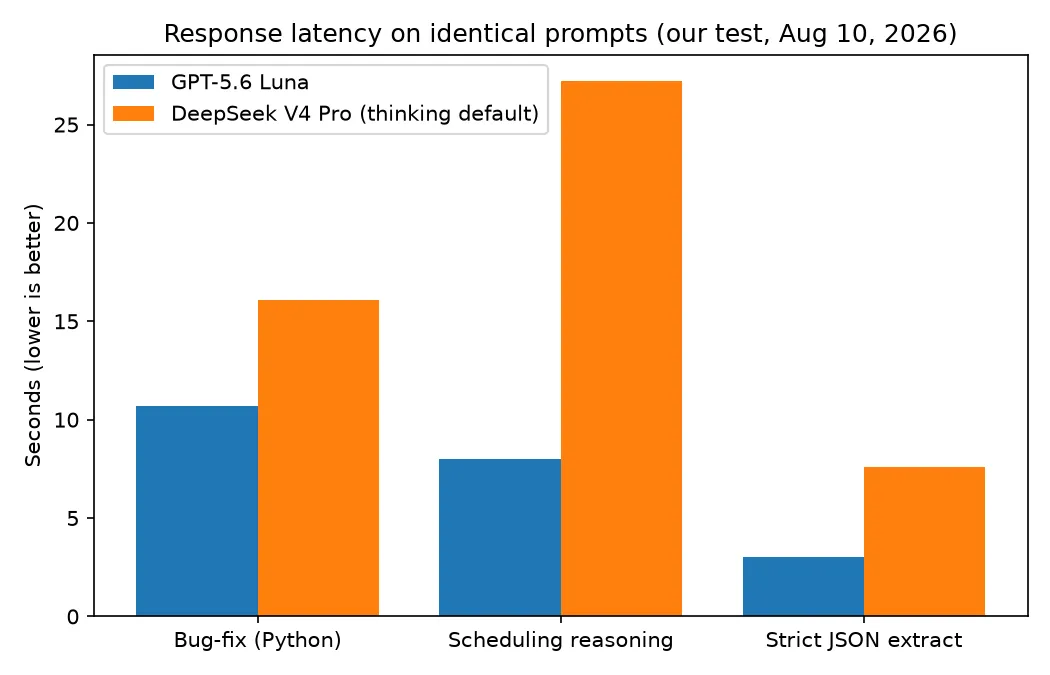
Важно учитывать два ограничения и две детали. Это точечная проверка на трёх задачах, а не полноценный бенчмарк. V4 Pro по умолчанию работает в thinking mode — этим в основном и объясняется отставание в задержке в 2–3 раза. Режим можно отключать для каждого запроса, но сложные задачи на рассуждение модель будет решать хуже. По соблюдению инструкции Luna вернула только функцию, как и просили, а V4 Pro добавила markdown-блок кода. В чате это безвредно, но в пайплайне потребует ещё одного шага парсинга. Для проверки стабильности мы повторили задачу с расписанием: обе модели вновь ответили 10:10.
Официальные тарифы и предупреждение DeepSeek о росте цен
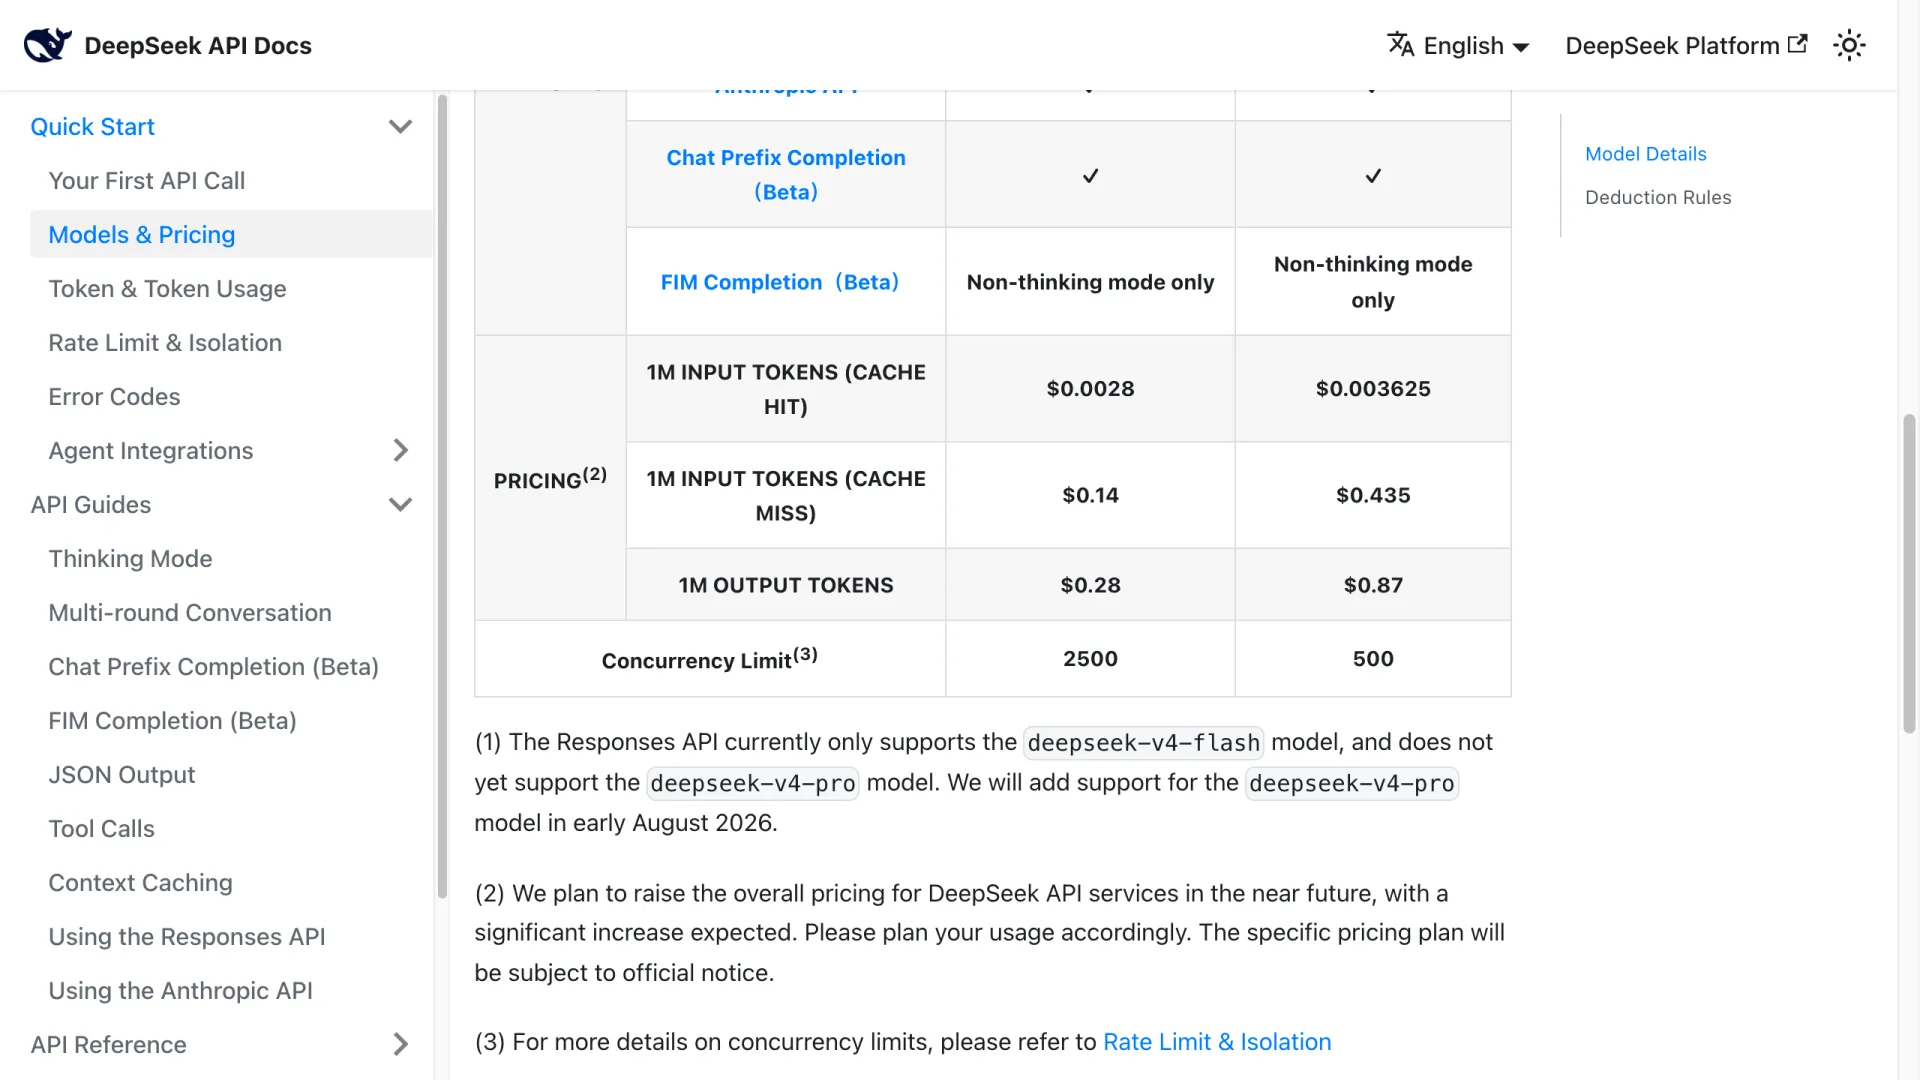
Цены сверены с официальными страницами обоих поставщиков 10 августа 2026 года. GPT-5.6 Luna стоит $0.20 за миллион входных токенов, $0.02 за кэшированные и $1.20 за выходные (страница модели OpenAI). Для DeepSeek V4 Pro тариф составляет $0.435 за миллион входных токенов при cache miss, $0.003625 при cache hit и $0.87 за выходные токены (страница тарифов DeepSeek).
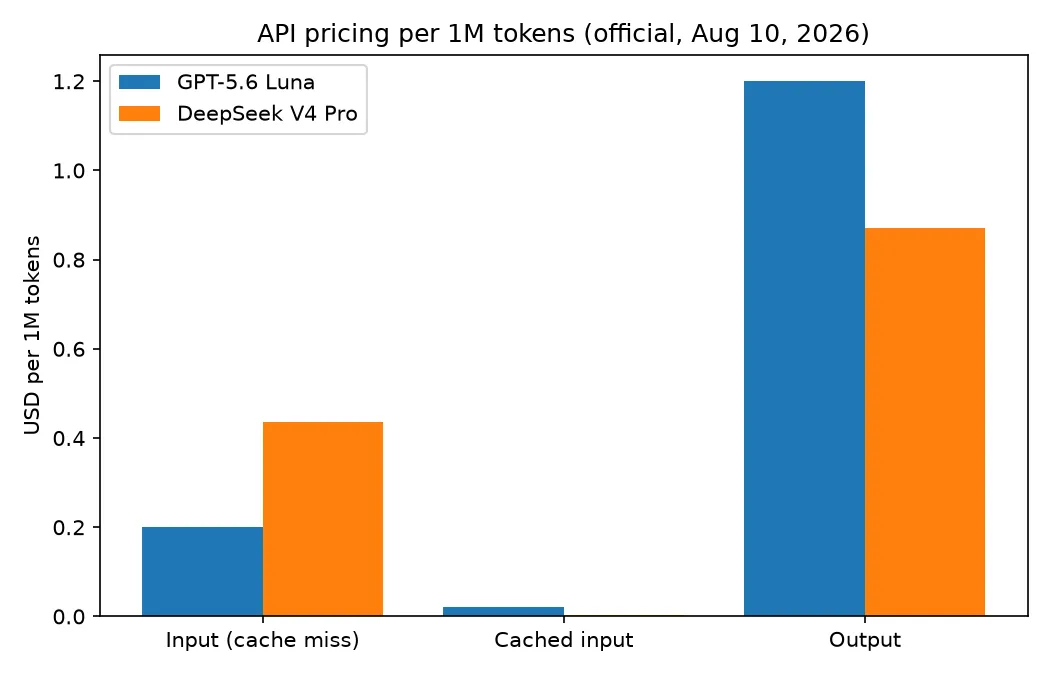
Универсально более дешёвой модели здесь нет. Некэшированный вход у Luna на 54% дешевле, выход у V4 Pro на 27% дешевле, а cache hit у V4 Pro обходится в 5.5 раза дешевле, чем у Luna. Всё зависит от соотношения токенов в вашей нагрузке:
- Интерактивный чат (1K входных + 500 выходных токенов на вызов): Luna — $0.0008, V4 Pro — $0.00087; практически ничья.
- Ревью репозитория (50K нового входного контекста + 3K выходных токенов): Luna — $0.0136, V4 Pro — $0.0244; Luna на 44% дешевле.
- Цикл агента (200K кэшированных + 20K новых входных токенов и 10K выходных на итерацию): Luna — $0.020, V4 Pro — $0.018. Здесь V4 Pro выходит вперёд, и с каждой дополнительной кэшированной итерацией разрыв растёт.
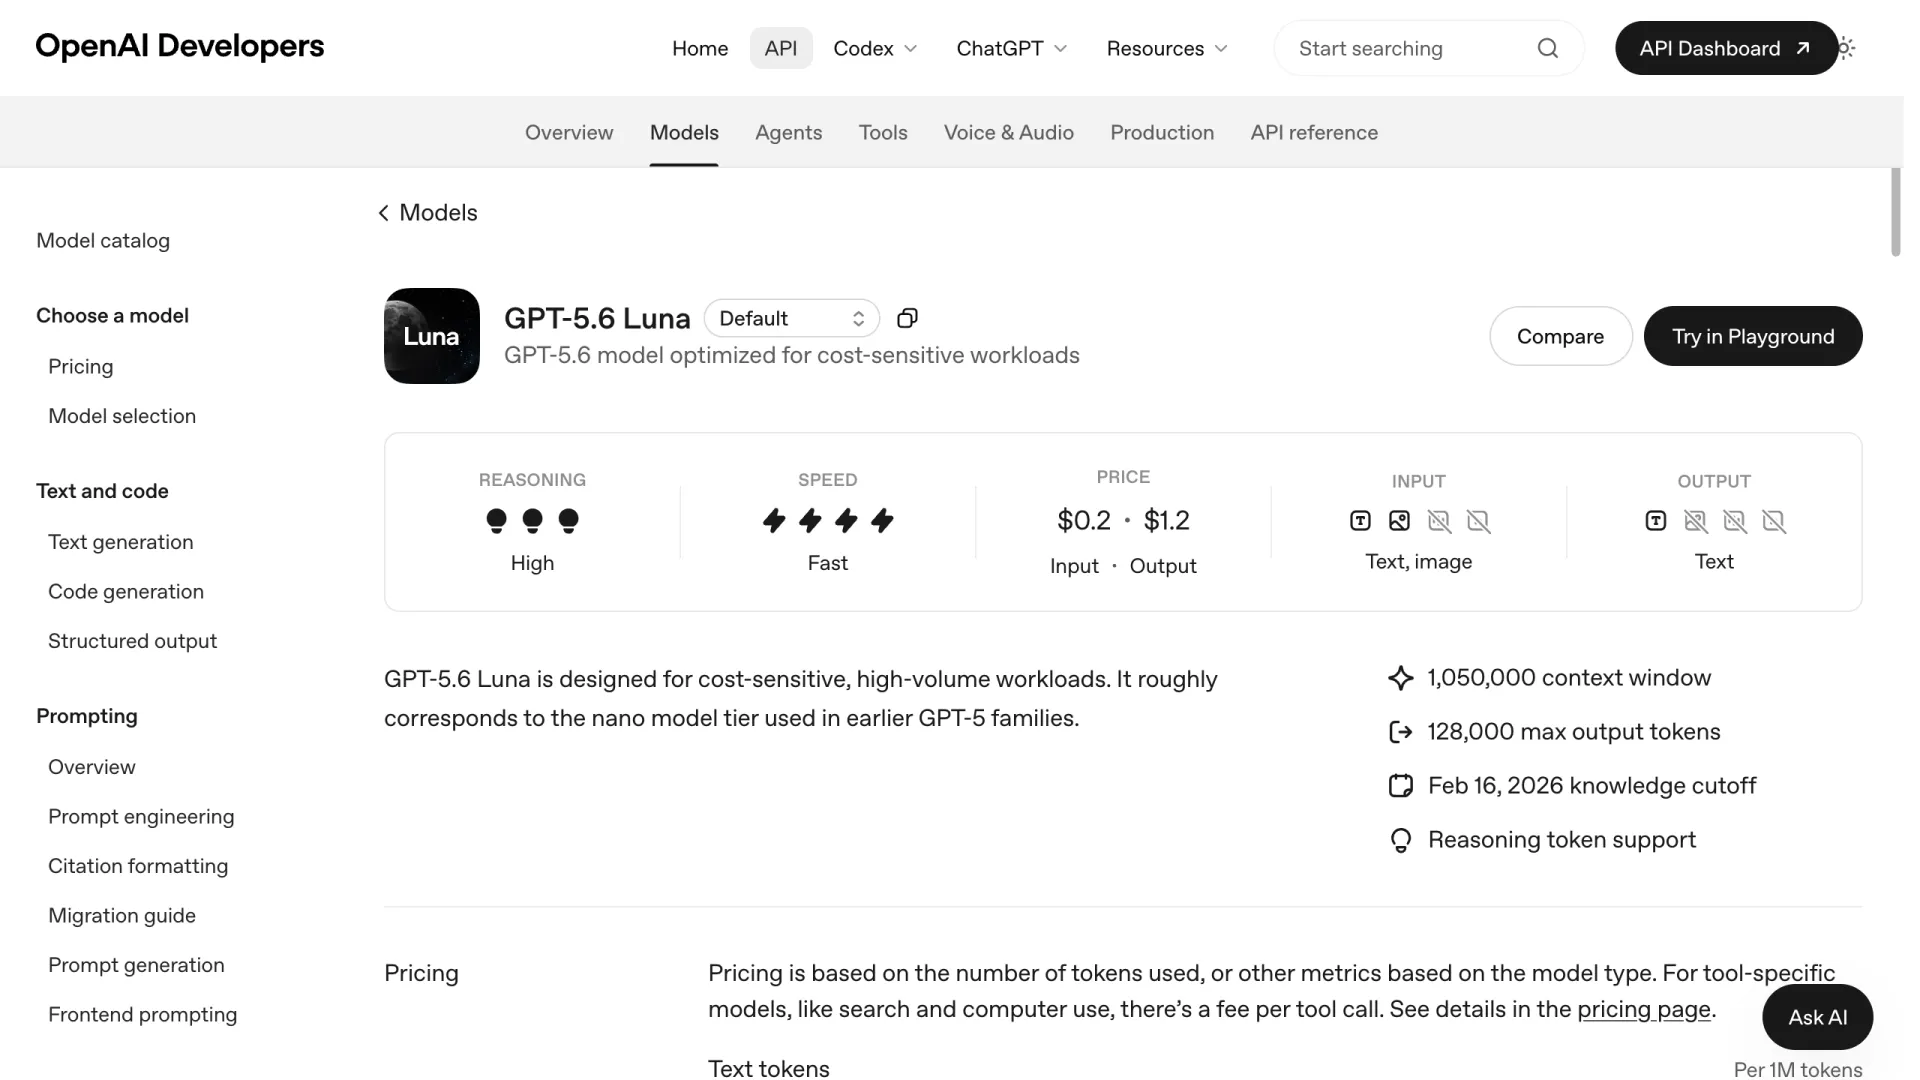
Есть ещё один фактор, ограничивающий срок актуальности этих расчётов. В сноске 2 на странице тарифов DeepSeek сказано: "We plan to raise the overall pricing for DeepSeek API services in the near future, with a significant increase expected." Даты и конкретных цифр нет. Но если выбор V4 Pro держится на цене, у этого аргумента есть официальное предупреждение об истечении срока действия. У Luna цены, напротив, снизились: модель вышла одновременно с августовским снижением цен OpenAI на GPT-5.6.
Кэш: главное ценовое преимущество V4 Pro
За миллион кэшированных входных токенов DeepSeek V4 Pro берёт $0.003625, тогда как Luna — $0.02. Разница в 5.5 раза особенно заметна в агентных сценариях, где на каждой итерации заново читается длинный неизменный префикс. Разработчики, использующие агентов, уже обратили на это внимание:
DeepSeek v4 Pro & MiMo v2.5 Pro ... are insanely cheap for agent-driven work due to their super low cached-input prices ($0.0036/mtok). For Luna, the cached-input price ... the pricing page puts it at $0.02/mtok, & that's 5x more expensive. — комментатор Hacker News, в обсуждении запуска GPT-5.6
Не забывайте и о доплате Luna за запись в кэш: cache write тарифицируется с коэффициентом 1.25x от цены некэшированного входа (страница модели OpenAI). Кроме того, для промптов свыше 272K входных токенов весь запрос оплачивается по ставке 2x за вход и 1.5x за выход. Если контекст вашего агента регулярно превышает 272K токенов, эффективная стоимость Luna примерно удваивается именно там, где кэширование V4 Pro наиболее выгодно.
Перед расчётом бюджета сверяйтесь с официальной документацией
Во время подготовки сравнения мы встретили сторонние публикации, где для V4 Pro указывали от $0.435 до $1.74 за миллион входных токенов, а контекстное окно Luna оценивали в диапазоне от 400K до 1.05M. Три проверки занимают меньше минуты: смотрите тарифы только на двух официальных страницах выше, сверяйте строку версии модели (текущий API отдаёт DeepSeek-V4-Pro; Flash закреплён на -0731) и уточняйте, означает ли указанная «цена входа» cache hit или cache miss. Для V4 Pro эти ставки различаются в 120 раз.
Характеристики, которые определяют выбор модели
Помимо цены, на выбор влияют четыре различия: лимит выходных токенов, модальности, открытость весов и API-возможности. Обе модели заявляют контекстное окно около 1M токенов — 1,050,000 у Luna и 1M у V4 Pro, — поэтому по одному лишь контексту выбрать не получится.
| Характеристика (проверено 10 августа 2026 года) | GPT-5.6 Luna | DeepSeek V4 Pro |
|---|---|---|
| Контекстное окно | 1,050,000 | 1M |
| Максимум выходных токенов | 128K | 384K |
| Входные модальности | Текст + изображение | Только текст |
| Управление рассуждением | Уровни effort (low→max) | Thinking включён (по умолчанию) / выключен |
| Открытые веса | Нет | Да (можно развернуть самостоятельно) |
| Responses API | Да | Пока нет (официально: начало августа 2026 года) |
| Лимит параллельных запросов | Зависит от usage tier | 500 |
| Дата среза знаний | 16 февраля 2026 года | Не указана на странице тарифов |
Лимит V4 Pro в 384K выходных токенов втрое выше, чем 128K у Luna. Это имеет значение для генерации кодовой базы за один запрос, длинных переводов и массового структурированного извлечения данных, где разбиение на части добавляет новые точки отказа. Изображения у Luna важны по другой причине — и пользователи DeepSeek говорят об этом сами:
My only real complaint is that they can't do images, which limits their ability to autonomously debug some kinds of issues. — комментатор Hacker News, о работе с DeepSeek в личных проектах
Открытые веса меняют картину в пользу V4 Pro: модель можно скачать и развернуть у себя. Поэтому из этих двух вариантов только она подходит для требований к локальности данных. Но для обслуживания модели такого размера потребуется серьёзная multi-GPU-инфраструктура, а не проект на выходные.
На бенчмарки сильнее влияет режим effort, чем выбор модели
В опубликованных сравнительных результатах GPT-5.6 Luna и DeepSeek V4 Pro победитель может меняться в зависимости от режима effort, с которым тестировали каждую модель. Например, на одном трекере счёт 33.3 против 44.3 в пользу V4 Pro: Luna там работает на low effort, а V4 Pro — на max. На Artificial Analysis, где обе модели тестируются на max, результат 52 против 45 уже в пользу Luna. Ошибки нет ни в одном случае: измеряются разные конфигурации.
Та же ловушка есть и в цифрах задержки. Artificial Analysis указывает для Luna time-to-first-answer-token в режиме max effort на уровне 132 секунд: на максимальном усилии модель рассуждает примерно две минуты, прежде чем начать отвечать. В нашем тесте с настройками по умолчанию Luna отвечала за 3–10.7 секунды. Обе цифры корректны, но только одна из них похожа на вашу production-конфигурацию. После начала генерации Luna заметно опережает соперника по скорости: 202 токена/с против 78 по данным Artificial Analysis.
Режимы effort также радикально влияют на результат одной и той же модели. На GPQA Diamond V4 Pro набирает 90.1% при max thinking и 72.9% при выключенном thinking. В общих бенчмарках на max effort Luna ведёт на SWE-Bench Pro — 62.7% против 55.4%, а на BrowseComp модели фактически равны: 83.3 против 83.4. Прежде чем доверять таблице результатов, задайте три вопроса: какой режим effort использовали, входит ли время thinking в показатель задержки и совпадают ли версии бенчмарка. Разрыв 84.7 против 67.9 на Terminal-Bench у одного из трекеров сравнивает v2.1 с v2.0.
Какую модель выбрать?
Для пользовательских продуктов выбирайте GPT-5.6 Luna: в нашем тесте на настройках по умолчанию она была в 2–3 раза быстрее на всех трёх задачах, её некэшированный вход стоит вдвое дешевле V4 Pro, а ещё она принимает изображения. DeepSeek V4 Pro лучше подойдёт для агентных циклов с интенсивным использованием кэша, ответов длиннее 128K токенов и задач, которые должны выполняться на собственной инфраструктуре. Только заложите официальное предупреждение о повышении цен в любые долгосрочные расчёты. На GPT-5.6 Luna и DeepSeek V4 Pro модели отличаются всего одной заменой endpoint, поэтому перед выбором можно повторить наши три промпта на своей нагрузке.
| Ваша задача | Выбор | Решающий фактор |
|---|---|---|
| Чат-боты и пользовательские приложения | Luna | Задержка 3.0–10.7s против 7.6–27.2s в нашем тесте; 202 против 78 токенов/с |
| Высокий объём обработки нового входного контекста | Luna | $0.20 против $0.435 за 1M некэшированных входных токенов |
| Циклы агентов со стабильным контекстом | V4 Pro | $0.003625 против $0.02 за 1M кэшированных входных токенов |
| Длинные ответы за один запрос | V4 Pro | Максимум 384K против 128K выходных токенов |
| Vision: скриншоты, PDF как изображения | Luna | V4 Pro работает только с текстом |
| Self-hosting / локальность данных | V4 Pro | Открытые веса; Luna доступна только через API |
| Предсказуемость бюджета до 2027 года | Luna | Официальное уведомление DeepSeek о повышении цен |
FAQ
Что дешевле: GPT-5.6 Luna или DeepSeek V4 Pro?
Однозначного ответа нет. Некэшированный вход Luna на 54% дешевле — $0.20 против $0.435 за 1M токенов. Зато кэшированный вход V4 Pro дешевле в 5.5 раза ($0.003625 против $0.02), а выход — на 27% ($0.87 против $1.20). Агентные нагрузки с активным кэшированием дешевле на V4 Pro, а задачи с большим объёмом нового входа — на Luna.
Обе модели поддерживают контекстное окно в 1M токенов?
Да. Luna предлагает 1,050,000 токенов, V4 Pro — 1M. Учтите, что для запросов Luna с более чем 272K входных токенов весь запрос тарифицируется по ставке 2x за вход и 1.5x за выход.
DeepSeek V4 Pro — это open source и её можно развернуть самостоятельно?
Да. V4 Pro поставляется с открытыми весами и допускает self-hosting, в отличие от Luna, доступной только по API. Но рассчитывайте на multi-GPU-оборудование для обслуживания модели, а не на одну рабочую станцию.
GPT-5.6 Luna поддерживает входные изображения?
Да, Luna принимает текст и изображения. DeepSeek V4 Pro работает только с текстом. Сами пользователи называют отсутствие vision-поддержки главным ограничением для автономных сценариев отладки.
Какое максимальное число выходных токенов у моделей?
DeepSeek V4 Pro может выдать до 384K токенов за ответ, а GPT-5.6 Luna ограничена 128K. Для генерации длинных документов или крупных файлов кода за один запрос лимит V4 Pro в 3 раза выше.
Читайте также
- DeepSeek V4 Pro vs GPT-5.6 Sol: тот же флагман DeepSeek против средней линейки OpenAI
- Обзор GPT-5.6 Luna: Luna отдельно от этого сравнения
- DeepSeek V4 Flash vs V4 Pro: если ценовой риск V4 Pro заставляет перейти на модель классом ниже