 AIREITER
Цена $0.15 за миллион входных токенов — лишь отправная точка для GLM-5.3-Flash. На итоговый счёт влияют попадания в кэш, объём генерации, обязательный reasoning и чекпойнт примерно на 320B параметров. Именно эти факторы определяют, что практичнее для конкретного внедрения: API или самостоятельный запуск весов.
Актуальные тарифы GLM-5.3-Flash
На официальной странице тарифов Z.AI для GLM-5.3-Flash указаны $0.15 за 1 миллион входных токенов, $0.03 за 1 миллион кэшированных входных токенов и $0.50 за 1 миллион выходных токенов. Там же действует временная скидка 50%, которая заканчивается 9 сентября 2026 года в 24:00 по UTC+8, сингапурскому времени.
| Статья расходов GLM-5.3-Flash | Базовая цена / 1M токенов | Цена по акции / 1M токенов |
|---|---|---|
| Новый входной текст | $0.15 | $0.075 |
| Кэшированный входной текст | $0.03 | $0.015 |
| Выходные токены | $0.50 | $0.25 |
| Хранение кэшированного ввода | Бесплатно в течение ограниченного периода | Бесплатно в течение ограниченного периода |
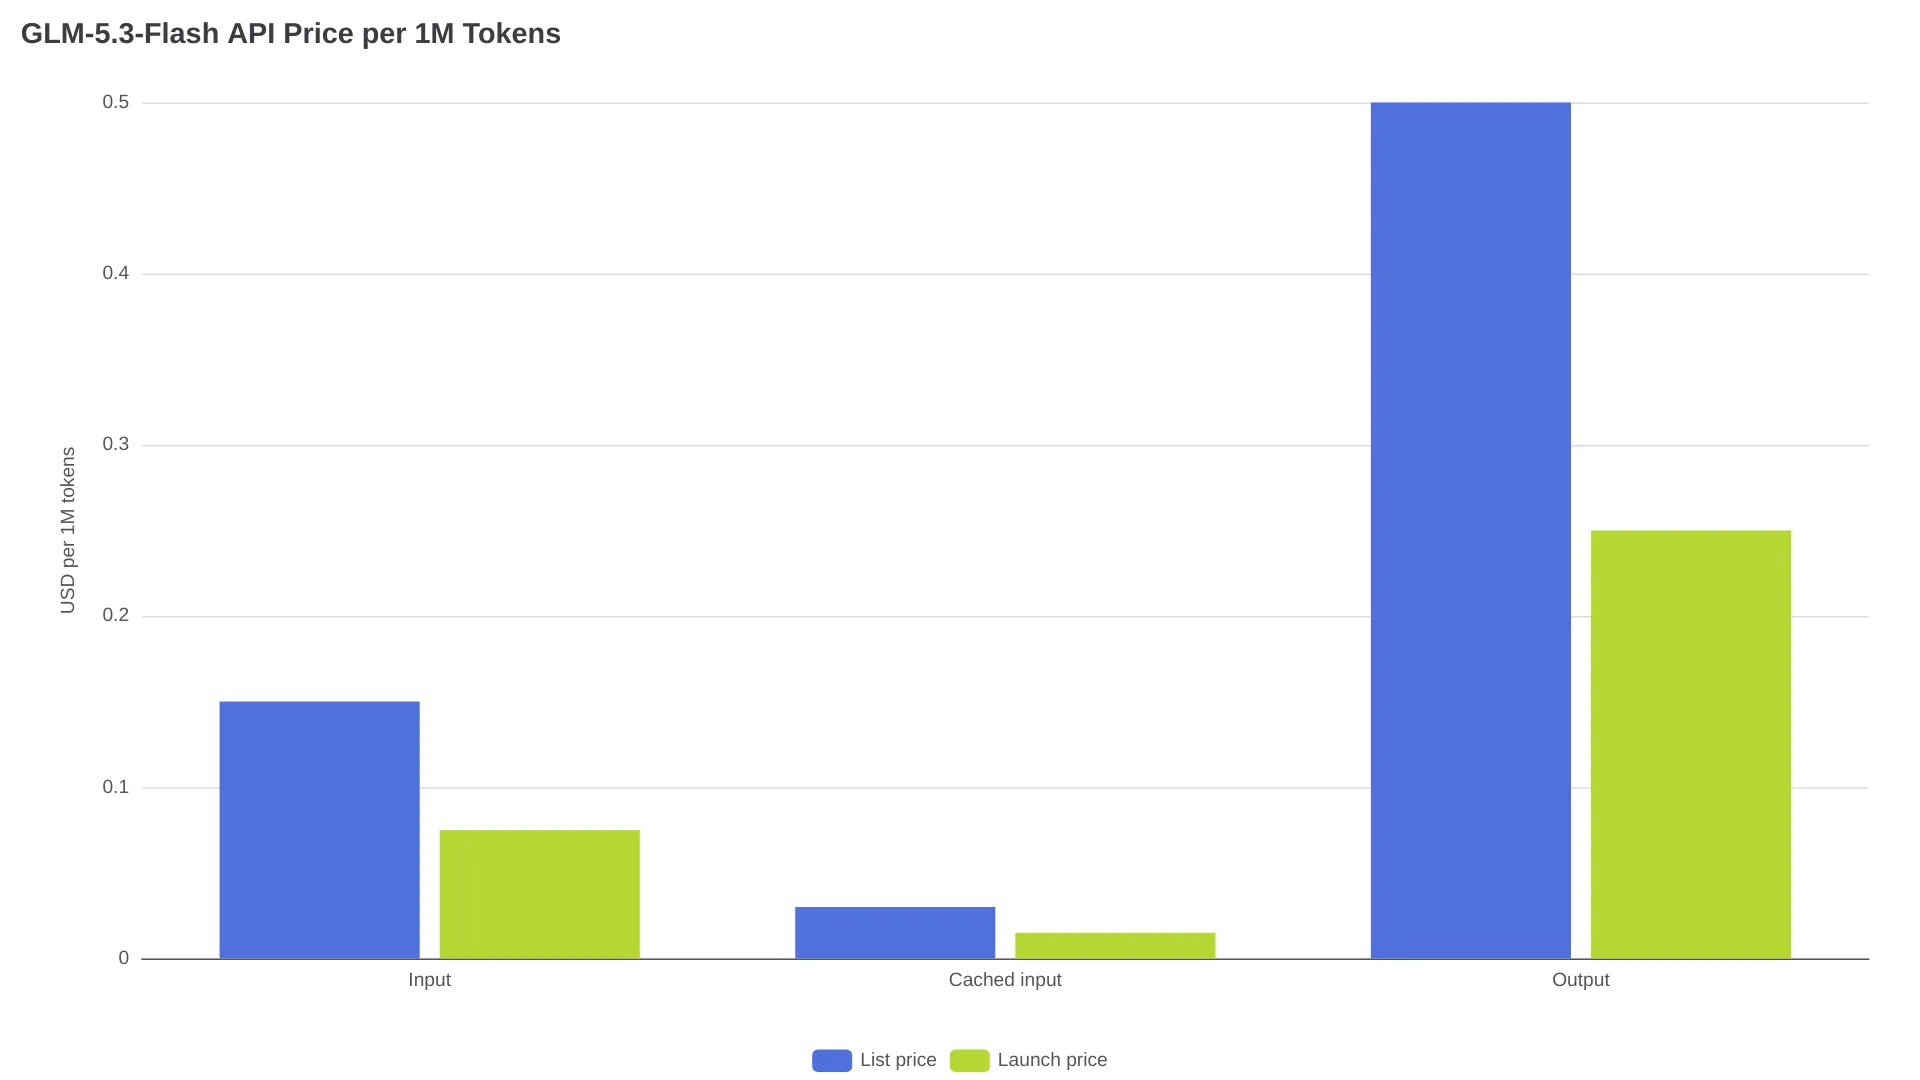
Скидку 50% стоит считать временной промоакцией, а не основой для долгосрочного production-бюджета. В анонсе запуска Z.AI также указывает, что ox-alpha был прежним preview-идентификатором модели.
В той же официальной таблице обычная GLM-5.3 стоит $1.40 за входные токены, $0.26 за кэшированный ввод и $4.40 за выход — всё за 1 миллион токенов. По базовым тарифам Flash примерно на 89% дешевле и на входе, и на выходе. Но это сравнение цен, а не утверждение о равном качестве, задержках или эксплуатационных свойствах двух моделей.
Что именно вы получаете: API, а не компактную локальную модель
GLM-5.3-Flash — мультимодальная open-weight модель под лицензией MIT: всего 320B параметров, из которых на каждый токен активно 18B. В официальной карточке модели на Hugging Face описаны публичный чекпойнт zai-org/GLM-5.3-Flash и варианты локального сервинга. В материалах к релизу Z.AI заявлены контекстное окно в 1 миллион токенов и приём текста, изображений и видео.
Показатель «18B active» означает объём вычислений выбранных экспертов, а не требуемую память для всей модели. При локальном запуске решающими остаются полный весовой файл, KV-кэш, накладные расходы рантайма, мультимодальная обработка и длина контекста.
| Способ доступа | Что даёт | Главное ограничение |
|---|---|---|
| Z.AI API | Хостинговый инференс с оплатой за входные, кэшированные входные и выходные токены | Лимиты аккаунта и задержка reasoning |
| Официальный чекпойнт | Веса под лицензией MIT для самостоятельного хостинга или адаптации | Инфраструктура с большим объёмом памяти, зависящим от точности и квантования |
| Квантованная сборка сообщества | Файлы меньшего размера для некоторых локальных рантаймов | Качество сборки, поддержка модальностей, скорость и совместимость могут различаться |
Низкая цена токенов и низкая стоимость хостинга — не одно и то же. При API расходы появляются по мере всплесков трафика, а self-hosting требует держать вычислительные мощности зарезервированными даже в периоды простоя.
Как считается счёт API в реальных сценариях
Стоимость GLM-5.3-Flash складывается из нового ввода, распознанного кэшированного ввода и сгенерированного вывода:
cost = (new_input_tokens / 1,000,000 × input_rate)
     + (cached_input_tokens / 1,000,000 × cached_rate)
     + (output_tokens / 1,000,000 × output_rate)
По базовому тарифу 10 миллионов новых входных токенов и 2 миллиона выходных обойдутся в $2.50: $1.50 за ввод и $1.00 за вывод. Во время акции тот же объём стоит $1.25.
| Нагрузка | Расчёт по базовому тарифу | Итого по базовому тарифу | Итого по акции |
|---|---|---|---|
| 10M нового ввода + 2M вывода | $1.50 + $1.00 | $2.50 | $1.25 |
| 2M нового ввода + 8M кэшированного ввода + 2M вывода | $0.30 + $0.24 + $1.00 | $1.54 | $0.77 |
| 100K нового ввода + 10K вывода | $0.015 + $0.005 | $0.020 | $0.010 |
Указанная Artificial Analysis смешанная цена $0.10 за миллион основана на конкретном соотношении: 7:2:1 для кэш-попаданий, входных и выходных токенов. Это полезный ориентир для сопоставимой нагрузки, но не универсальный тариф GLM-5.3-Flash.
Экономия на кэше появляется только при фактическом cache hit. В схеме ответа Chat Completion от Z.AI есть поле usage.prompt_tokens_details.cached_tokens. Поэтому в production-учёте стоит записывать именно его, а не считать, что похожие повторяющиеся промпты автоматически получат скидку. Один из участников r/opencodeCLI так описал экономику на старте:
«There's a 50% discount offer until September 9th, and its context consumption is much better than in dsv4f...» — u/CriteriumA, обсуждение на Reddit
Дату окончания скидки подтверждает тарифная сетка Z.AI; сравнение с другой моделью и пользовательский опыт остаются мнением автора комментария. Стабильный повторяющийся контекст способен повысить использование кэша, но не отменяет расходы на вывод, повторы запросов, инструменты и лимиты аккаунта.
Короткая таблица для планирования бюджета
В прогнозе лучше выделить четыре отдельные строки: новый ввод, кэшированный ввод, вывод и платные инструменты. Z.AI указывает цену Web Search в $0.01 за использование, поэтому частые поисковые вызовы агента могут превысить оценку, рассчитанную только по токенам.
| Предположение по месячному использованию | Формула по базовому тарифу | Расход за месяц |
|---|---|---|
| 100M нового ввода + 20M вывода | 100 × $0.15 + 20 × $0.50 | $25.00 |
| 20M нового ввода + 80M кэшированного ввода + 20M вывода | 20 × $0.15 + 80 × $0.03 + 20 × $0.50 | $23.40 |
| 100 вызовов Web Search | 100 × $0.01 | $1.00 |
Это арифметические примеры, а не квота. Повторные запросы и незавершённые запуски агентов нужно учитывать отдельно. При большом объёме генерации реалистичное значение max_tokens и более низкий reasoning_effort, где он уместен, могут повлиять на расходы сильнее, чем оптимизация небольшой части промпта.
Ограничения Z.AI API перед миграцией
Основной base URL официального Z.AI API — https://api.z.ai/api/paas/v4/, а endpoint для чат-комплишенов — https://api.z.ai/api/paas/v4/chat/completions. Для авторизации нужен Bearer API key. В введении в API Z.AI описывает OpenAI-совместимые схемы для Python, Node.js и Java с указанием кастомного base URL.
В текущем справочнике Chat Completion GLM-5.3-FLASH упоминается в описаниях thinking и reasoning, однако в отображаемом enum моделей нет glm-5.3-flash. При этом Flash SKU есть и на официальной странице цен, и в материалах запуска. Перед переводом production-трафика проверьте точный ID хостинговой модели небольшим запросом.
| Деталь интеграции | Подтверждённое ограничение |
|---|---|
| ID хостинговой модели для проверки | glm-5.3-flash; подтвердите, что он принимается текущей схемой вашего аккаунта |
| Хостинговый endpoint | https://api.z.ai/api/paas/v4/chat/completions |
| Аутентификация | Authorization: Bearer YOUR_API_KEY |
| Thinking | В GLM-5.3-FLASH thinking включён; глубина управляется параметром reasoning_effort |
| Reasoning effort | low, high или max |
Максимальное значение max_tokens | 131,072 в текущем справочнике параметров |
| Coding Plan | Отдельные ключ, endpoint’ы и система кредитов; это не общий баланс API. См. быстрый старт Coding Plan от Z.AI |
Z.AI устанавливает max как уровень reasoning effort по умолчанию. Тариф за токен от выбранного уровня не меняется, однако reasoning может увеличить объём вывода и время ожидания. По лимитам аккаунта Z.AI направляет пользователей в персональную панель rate limits; в публичной документации нет единого числового ограничения для всех API-аккаунтов.
Open weights или хостинговый API
В официальной карточке модели приведены рецепты локального запуска через Transformers, vLLM, SGLang, TokenSpeed и KTransformers. Однако из этих инструкций не следует, что модель практически можно развернуть на потребительском GPU.
Хостинговый API разумнее использовать при нерегулярном трафике или отсутствии оборудования для инференса с большим объёмом памяти. Распределённый либо локальный сервинг стоит рассматривать при стабильной высокой загрузке или когда контроль обработки данных оправдывает операционные расходы. Текстовая сборка с пониженной точностью может не воспроизводить возможности официальной мультимодальной конфигурации.
Когда самостоятельный хостинг начинает окупаться
По оценке GetDeploying, для 4-битного развёртывания нужно около 192 GB GPU-памяти, для 8-битного — примерно 384 GB, для BF16 — 768 GB. Конфигурация на MI300X за $2.90 в час при непрерывной работе оценивается примерно в $2,088 в месяц, а равенство затрат API и self-hosting достигается около 14 миллионов токенов в час при соотношении входа к выходу 5:1.
Это сторонние расчёты, а не гарантии Z.AI по оборудованию. Конфигурация на 192 GB для 4 бит обозначена как работающая на пределе: KV-кэш, накладные расходы рантайма, мультимодальная обработка, батчинг и простой могут сдвинуть точку окупаемости. Перед выбором локального инференса сопоставьте стоимость инфраструктуры в час, загрузку, фактические токены в час, долю cache hit и цену завершённой задачи.
GLM-5.3-Flash и GLM-5.3: где проходит граница выбора
У Flash и стандартной GLM-5.3 разные тарифы и разные сценарии развёртывания.
| Вопрос | GLM-5.3-Flash | GLM-5.3 |
|---|---|---|
| Базовая цена входа | $0.15 / 1M | $1.40 / 1M |
| Базовая цена кэшированного ввода | $0.03 / 1M | $0.26 / 1M |
| Базовая цена выхода | $0.50 / 1M | $4.40 / 1M |
| Временная акция | Скидка 50% до 9 сентября 2026 года по UTC+8 | Сопоставимая акция для Flash не показана |
| Open-weight чекпойнт | Указан официальный чекпойнт под лицензией MIT | Отдельная карточка модели; не следует считать веса идентичными |
| Мультимодальное позиционирование | Нативная мультимодальность; Z.AI заявляет ввод изображений и видео | Возможности стандартной GLM-5.3 нужно рассматривать отдельно |
| Локальное развёртывание | Требуются крупный чекпойнт и сервинг с большим объёмом памяти | Используйте её собственную документацию по модели и развёртыванию |
Сначала выбирайте Flash, если важны цена токенов, мультимодальный ввод или путь с open weights, а приложение допускает принудительный reasoning и ограничения провайдера. К стандартной GLM-5.3 стоит переходить только после замеров: нужно убедиться, что более высокий тариф даёт значимое для приложения преимущество в возможностях или надёжности.
FAQ
Какова текущая цена GLM-5.3-Flash API?
Официальные базовые тарифы составляют $0.15 за вход, $0.03 за кэшированный вход и $0.50 за выход на 1M токенов; временные цены со скидкой 50% приведены в таблице выше.
Кэшированный ввод оплачивается по ставке $0.03?
Да, если Z.AI распознаёт эти токены как кэшированные. Хранение кэшированного ввода отдельно указано как временно бесплатное, поэтому статус хранения и оплату cache hit не стоит смешивать.
GLM-5.3-Flash — это open source?
Точнее называть её open-weight чекпойнтом под лицензией MIT. Лицензия допускает широкое применение, но модели с 320B параметров всё равно требуются существенный объём памяти, совместимое ПО и мощности для сервинга.
Можно ли запустить GLM-5.3-Flash на обычном ноутбуке?
Не как практичное развёртывание в полной точности. Даже сторонние оценки для 4-битной версии говорят примерно о 192 GB GPU-памяти, а 18B активных параметров не убирают затраты на хранение и работу с полным чекпойнтом.
GLM-5.3-Flash быстрее GLM-5.3?
Название «Flash» подтверждает позиционирование по цене и активным вычислениям, но не служит универсальной гарантией задержки. Artificial Analysis сообщает о 48.7 выходных токенах в секунду через Z.AI и 42.57 секунды до первого токена ответа в своей тестовой конфигурации; время reasoning и характер нагрузки могут сильнее влиять на воспринимаемую скорость.
Coding Plan даёт тот же баланс, что и API?
Нет. В быстром старте Coding Plan от Z.AI описаны отдельный ключ Coding Plan, отдельные endpoint’ы и доступ только к официально поддерживаемым инструментам и продуктам. Подписку Coding Plan нельзя напрямую пересчитать в публичный API-бюджет в долларах за токен.
При нерегулярном трафике и уже не оплаченной инфраструктуре API — менее рискованный вариант. Локальный сервинг — это отдельная экономическая модель, зависящая от постоянной загрузки, объёма памяти и требований к контролю данных.