 AIREITER
Между релизами Gemini 3.6 Flash и Gemini 3.7 Flash прошло всего три недели, однако прирост оказался существенным. В DeepSWE v1.1 новая модель набрала 65,3% против 48,6% у предшественницы. При этом до декабря 2026 года обе модели стоят одинаково: $0.75 за миллион входных и $3.75 за миллион выходных токенов. Переход не увеличивает цену токена, но его практическая ценность зависит от типа задач.
Gemini 3.7 Flash и 3.6 Flash: результаты всех бенчмарков
На официальной странице моделей Google DeepMind приводит улучшения Gemini 3.7 Flash по всем ключевым метрикам. Самые заметные разрывы видны в бенчмарках для кодовых агентов и корпоративной автоматизации. Ниже — все 18 метрик, опубликованных Google для обеих моделей; Claude Sonnet 5 и GPT-5.6 Terra приведены в статье для контекста.
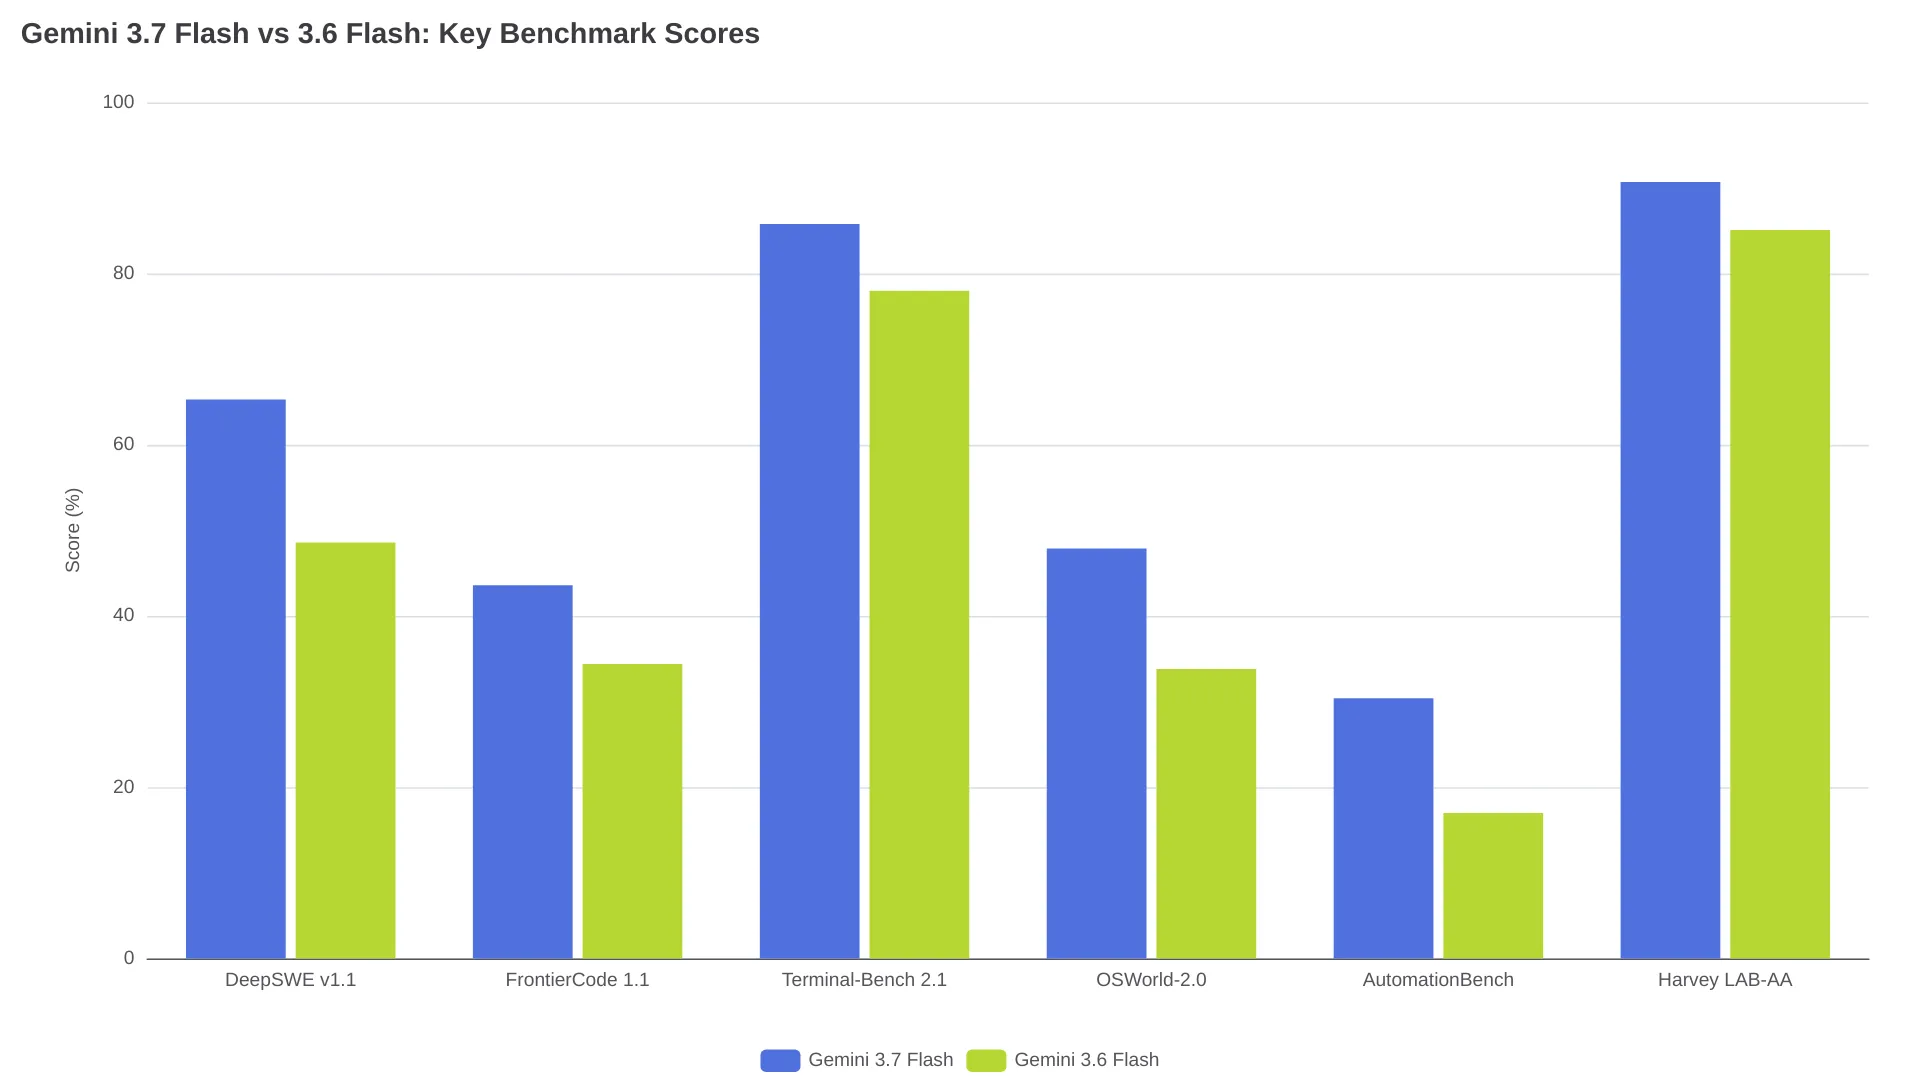
| Бенчмарк | Gemini 3.7 Flash | Gemini 3.6 Flash | Разница |
|---|---|---|---|
| Artificial Analysis Intelligence Index (сводный показатель) | 56 | 52 | +4 |
| FrontierCode 1.1 (качество production-кода) | 43.6% | 34.4% | +9.2 |
| DeepSWE v1.1 (долгосрочные задачи software engineering) | 65.3% | 48.6% | +16.7 |
| Code Arena (Elo в веб-разработке) | 1588 | 1538 | +50 |
| Terminal-Bench 2.1 (агентное программирование в терминале) | 85.8% | 78.0% | +7.8 |
| Terminal-Bench 3.0 (общие возможности агентов) | 14.9% | 5.4% | +9.5 |
| AutomationBench (автоматизация корпоративных процессов) | 30.4% | 17.0% | +13.4 |
| GDPVal-AA v2 (Elo в интеллектуальной работе) | 1525 | 1422 | +103 |
| Harvey LAB-AA (сложные юридические процессы) | 90.7% | 85.1% | +5.6 |
| GDP.pdf (понимание экспертных PDF-документов) | 34.0% | 22.0% | +12.0 |
| CharXiv, без инструментов (анализ графиков) | 84.5% | 85.2% | −0.7 |
| CharXiv, с инструментами | 88.7% | 89.4% | −0.7 |
| LVBench (понимание длинных видео) | 85.4% | 84.2% | +1.2 |
| GDM-MRCR v2, 128k (поиск информации в длинном контексте) | 97.0% | 91.8% | +5.2 |
| OSWorld-2.0 (работа агента за компьютером) | 47.9% | 33.8% | +14.1 |
| Agent's Last Exam (задачи desktop-агентов) | 26.3% | 24.2% | +2.1 |
| HLE-Verified (междисциплинарное экспертное рассуждение) | 53.6% | 51.2% | +2.4 |
| LABBench2 (задачи биологических исследований) | 82.1% | 76.1% | +6.0 |
Все значения заявлены Google DeepMind на странице модели 3.7 Flash. Для большинства этих бенчмарков независимых воспроизведений результатов пока нет, поэтому разницу стоит считать ориентиром, а не гарантией для конкретной нагрузки.
Код и агенты: главное преимущество 3.7 Flash
Максимальный отрыв между моделями наблюдается именно в программировании и агентных сценариях. DeepSWE v1.1 оценивает выполнение длительных инженерных задач в реальных репозиториях: результат вырос с 48,6% до 65,3%, то есть на 16,7 процентного пункта. По этой метрике Gemini 3.7 Flash обходит Claude Sonnet 5 с 53,8% и располагается между ним и GPT-5.6 Terra с 69,6% — все сравнительные результаты взяты из таблицы бенчмарков DeepMind.
Другие агентные тесты показывают ту же картину:
- Terminal-Bench 3.0 — задачи для агентов с несколькими инструментами: рост с 5.4% до 14.9%, почти втрое
- AutomationBench — автоматизация корпоративных процессов: 17.0% → 30.4%
- FrontierCode 1.1 — качество production-кода: +9.2 пункта
- OSWorld-2.0 — работа агента за компьютером: 33.8% → 47.9%
Первые отзывы пользователей на Reddit хорошо отражают разрыв между победами в бенчмарках и повседневным опытом разработчика:
Хорошо справляется с реализацией, но может быть слабее в планировании, ревью кода и декомпозиции сложных задач.
— Обсуждение пользователя в r/google_antigravity
Похожие выводы следуют и из кейсов клиентов Google, опубликованных на странице модели DeepMind. Browser Use сообщил, что «агент Gemini 3.7 Flash оказался на 35% дешевле 3.6 Flash, с наблюдаемым ростом cache hit rate на 8% и меньшим числом ошибок инструментов». Harvey зафиксировала прирост на 2,6 пункта по метрике all-pass в Legal Agent Bench. Nunu.ai получила производительность на уровне GPT-5.6-Terra «примерно за половину стоимости». Все три компании связывают экономию не со скидкой на токены, а с меньшим числом шагов в агентном цикле.
Работа с документами и мультимодальность: прирост есть, но скромнее
За пределами кодинга улучшения менее радикальны. Artificial Analysis Intelligence Index вырос с 52 до 56: по сравнительной таблице DeepMind, Gemini 3.7 Flash находится между Claude Sonnet 5 с 55 и GPT-5.6 Terra с 57. Самый сильный некодовый результат — понимание документов: в GDP.pdf показатель поднялся с 22,0% до 34,0%. Это прирост на 12 пунктов для пайплайнов, обрабатывающих сложные документы, финансовые отчёты или юридические материалы. GDM-MRCR v2 для поиска в контексте объёмом 128K токенов вырос с 91,8% до 97,0%.
В Harvey LAB-AA, оценивающем сложные юридические процессы, результат увеличился с 85,1% до 90,7%. Понимание длинных видео в LVBench и задачи биологических исследований в LABBench2 также прибавили примерно по 6 пунктов. Для узкоспециализированных сценариев это важно, но само по себе вряд ли станет решающим аргументом для миграции.
Цена не изменилась: одинаковая промоставka для обеих моделей
| Модель | Вход ($/1M токенов) | Выход ($/1M токенов) | Стандартная цена (с 1 января 2027 года) |
|---|---|---|---|
| Gemini 3.7 Flash | $0.75\* | $3.75\* | $1.50 / $7.50 |
| Gemini 3.6 Flash | $0.75\* | $3.75\* | $1.50 / $7.50 |
| Claude Sonnet 5 | $2.00 | $10.00 | — |
| GPT-5.6 Terra | $2.00 | $12.00 | — |
\*Промо-цена действует до 31 декабря 2026 года. Все цены приведены по странице модели DeepMind.
Когда 13 августа 2026 года вышла 3.7 Flash, Google установила для обеих Flash-моделей промотариф $0.75/$3.75. До этого 3.6 Flash стоила $1.50/$7.50 по стандартному тарифу. С 1 января 2027 года обе модели вернутся к цене $1.50/$7.50, если Google не продлит акцию. При одинаковой стоимости токенов разница в расходах определяется эффективностью на задаче: заявленное Browser Use снижение стоимости агентных операций на 35% измерялось на тех же рабочих нагрузках и объяснялось меньшим количеством вызовов инструментов и более высоким cache hit rate, а не другой тарификацией.
Подробный разбор расходов на API Gemini 3.7 Flash, включая кеширование, Batch API и оплату grounding, читайте в нашем гайде по ценам Gemini 3.7 Flash API.
В чём Gemini 3.6 Flash всё ещё сильнее
У 3.6 Flash остаётся небольшое преимущество в анализе графиков. В CharXiv без инструментов она набирает 85,2% против 84,5% у 3.7. При включённых инструментах разрыв такой же: 89,4% против 88,7%. Разница меньше одного пункта, поэтому в отдельных задачах с графиками модели могут показывать сопоставимый результат. Прежде чем выбирать модель по умолчанию, проверьте её на собственном наборе таких задач.
В остальных бенчмарках из таблицы Google модель 3.6 не опережает 3.7. Ближайшая спорная зона за пределами анализа графиков — индекс интеллекта: 52 против 56, но и здесь лидирует 3.7.
Миграция на 3.7 Flash: не только замена model ID
На техническом уровне миграция сводится к замене model ID: вместо gemini-3.6-flash нужно указать gemini-3.7-flash. Согласно странице модели DeepMind, у обеих моделей одинаковое контекстное окно — 1M токенов на вход и 64K на выход, одинаковые входные модальности — текст, изображения, видео, аудио и PDF — а также одинаковые возможности работы с инструментами: function calling, search grounding и computer use. Для 3.7 Flash на странице указан статус general availability.
Но есть важный нюанс. Переход с 3.5 на 3.6 принёс неочевидные изменения поведения API, к которым разработчики оказались не готовы. Как показало независимое тестирование, параметры temperature, top_p и top_k молча игнорировались, thinking_budget превратился в строковый enum thinking_level, а prefilling ответов был удалён. Google пока не сообщала, появились ли аналогичные изменения в 3.7 Flash. Пока такой документации нет, перед переключением production-трафика прогоните свой набор оценок с обоими model ID. И сохраните 3.6 как резервный вариант.
Стоит ли переходить на 3.7 Flash?
Решение зависит от типа нагрузки:
- Переходите сразу, если используете кодовых агентов. DeepSWE v1.1 прибавил 16.7 пункта, а результат в Terminal-Bench 3.0 вырос почти втрое. При одинаковой цене за токен нет финансовых причин оставаться на 3.6 в нагрузках с кодовыми агентами.
- Переходите сразу, если обрабатываете сложные документы. Понимание GDP.pdf выросло на 12 пунктов: 22.0% → 34.0%. Поиск в контексте объёмом 128K токенов почти идеален — 97.0%.
- Сначала тестируйте, если ваша ключевая задача — анализ графиков. В CharXiv 3.6 опережает 3.7 менее чем на 1 пункт. Прежде чем принимать решение, сравните модели на своих данных.
- Оставайтесь на 3.6, если пайплайн проверен и стабилен. На странице модели DeepMind не указана дата прекращения поддержки 3.6 Flash. Если ваш процесс проходит регрессионные тесты и прирост в кодинге вам сейчас не нужен, отладка изменений поведения может обойтись дороже, чем выгода. Переносите по одному workflow за раз.
- Учитывайте темп релизов. Google выпустила 3.7 через три недели после 3.6. Перенесите сейчас те workflow, где преимущества 3.7 максимальны, оставьте 3.6 закреплённой как резервную модель и оценивайте каждый новый релиз Flash как поэтапное обновление, а не смену платформы.
Сравнить модели вживую можно в чат-интерфейсах Gemini 3.7 Flash и Gemini 3.6 Flash.
Gemini 3.7 Flash — это новая архитектура или обновление post-training?
Google публично не характеризовала 3.7 Flash ни как новую архитектуру, ни как post-training-обновление. Artificial Analysis Intelligence Index вырос с 52 до 56, тогда как независимое тестирование подтвердило, что 3.5 и 3.6 Flash получили по 50 баллов в том же индексе. Неизвестно, обусловлен ли прогресс 3.7 изменениями архитектуры или улучшенными обучающими данными: документация этого не раскрывает.
Gemini 3.7 Flash дороже Gemini 3.6 Flash?
Нет. До 31 декабря 2026 года обе модели стоят $0.75 за миллион входных токенов и $3.75 за миллион выходных. Затем обе перейдут на тариф $1.50/$7.50. Экономия при обновлении достигается за счёт меньшего числа вызовов инструментов и шагов рассуждения на задачу, а не более низкой цены токена.
Где доступна Gemini 3.7 Flash?
Согласно странице модели DeepMind, 3.7 Flash доступна через Gemini API, Google AI Studio, Google Antigravity, Vertex AI, Gemini Enterprise и Gemini App; статус модели — general availability.
Стоит ли ждать следующую версию Flash вместо миграции сейчас?
3.7 Flash — GA-модель с опубликованными бенчмарками и уже подтверждённым внедрением у клиентов. Если ваша нагрузка выигрывает от улучшений в кодинге и агентных сценариях, переносите эти workflow сейчас и повторно оценивайте модель после выхода следующей версии. Ожидание означает упущенную выгоду от улучшений, которыми уже можно пользоваться.