 AIREITER
29 июля 2026 года мы отправили Claude Opus 5, GPT-5.6 Sol, Terra и Luna один и тот же набор из четырёх задач. В итоге получили 16 ответов — и все 16 были правильными. На этих небольших проверках точность не даёт повода предпочесть одну модель другой.
Разница проявилась в двух параметрах, за которые приходится платить: Opus 5 списал 1 642 выходных токена против 480 у Sol, а после 272 000 входных токенов запросы к GPT-5.6 переходят на более дорогую тарифную сетку. У Claude Opus 5 весь контекст до 1M токенов тарифицируется по одной ставке. Для запроса с 200K входных и 20K выходных токенов флагманские модели различаются по прайс-листу менее чем на 7%; но с ростом объёма ответа и после отметки 272K разрыв увеличивается. Поэтому выбирать стоит по форме запроса и характеру работы модели.
Четыре одинаковых задания для всех моделей
Каждая модель получила идентичный пользовательский промпт с четырьмя задачами, ответы на которые можно проверить механически: исправить ошибочную Python-функцию median, посчитать вхождения букв в заданной строке, вычислить угол в 7,5 градуса между стрелками часов в 3:15 и отрефакторить намеренно небрежную JavaScript-функцию без изменения её поведения. Код мы проверяли запуском на граничных случаях, а не визуальной оценкой.
Все модели прошли все проверки. Исправления на Python корректно обрабатывали списки чётной длины, каждая из четырёх моделей назвала 9 и 7,5 там, где правильными ответами были 9 и 7,5, а все варианты рефакторинга прошли поведенческое сравнение, включая ложные значения полей и фильтры категорий со значением null.
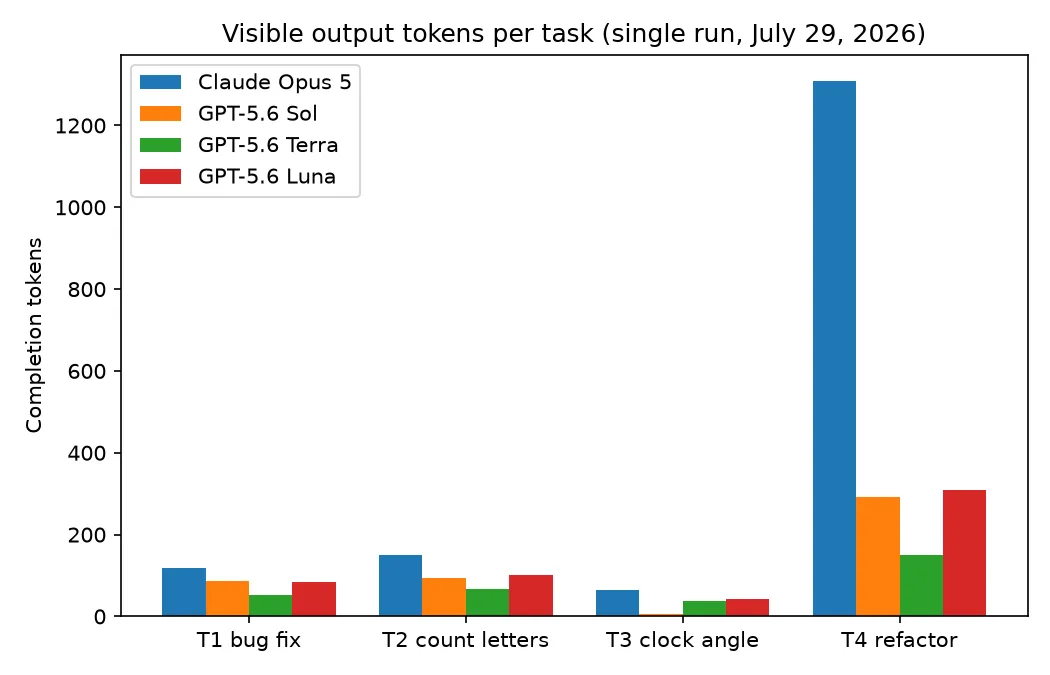
Прежде чем ссылаться на эти цифры, важно учесть три ограничения. Это один запуск каждой модели на каждую задачу: скорее smoke-тест, чем бенчмарк. Вызовы шли через шлюз, добавляющий собственный системный промпт, поэтому число входных токенов прыгало от 35 до 4 415 между запросами — мы полностью исключили его из сравнения. Кроме того, оба вендора тарифицируют скрытые токены рассуждений как выходные. Под «выходными токенами» здесь подразумевается то, за что выставляют счёт, а не только текст, который вы видите.
При равенстве по правильности всё же выделился один качественный момент: Opus 5 сделал лучший из четырёх рефакторингов. Он заменил два исходных цикла одним проходом, вынес множитель 1.2 в именованную константу и оставил комментарий, что намеренно сохранил нестрогое сравнение ради прежнего поведения. Sol, Terra и Luna тоже решили задачу верно, но предложили более буквальные версии с двумя циклами.
Решает не точность, а токены и скорость
Во всех 16 запусках правильность была одинаковой, так что практическое сравнение сводится к стоимости каждого ответа. Opus 5 выполнил четыре задачи за 32,4 секунды и списал 1 642 токена завершения. Sol потребовалось 19,7 секунды и 480 токенов, Terra — 11,7 секунды и 308, Luna — 15,3 секунды и 537.
| Один запуск, 29 июля 2026 года | Правильно | Выходные токены | Общее время | Стоимость только выхода |
|---|---|---|---|---|
| Claude Opus 5 | 4/4 | 1,642 | 32.4s | $0.0411 |
| GPT-5.6 Sol | 4/4 | 480 | 19.7s | $0.0144 |
| GPT-5.6 Terra | 4/4 | 308 | 11.7s | $0.0046 |
| GPT-5.6 Luna | 4/4 | 537 | 15.3s | $0.0032 |
Разрыв объясняется объёмом рассуждений, а не длиной финального текста. За рефакторинг Opus 5 списал 1 308 токенов при размере готового ответа в 492 байта; на ответ «7.5» он потратил 64 токена, тогда как Sol — 7. В документации Anthropic сказано, что в API Opus 5 по умолчанию использует высокий уровень усилий. Значит, часть этой разницы связана с настройкой по умолчанию, а не с неизменным свойством модели: мы измеряли стандартное поведение, а не минимально возможный расход.
Данные сообщества показывают ту же картину. Пост с графиком в r/Anthropic, который при нашей проверке 29 июля был первым результатом Google по этому запросу, показывает почти равные результаты в программировании, но более долгую работу Opus и заметно больший расход токенов. Один пользователь r/ClaudeCode сформулировал это менее дипломатично:
GPT 5.6 Sol просто приступает к тому, что вы попросили сделать. Opus 5 сначала пишет «Войну и мир» в 12 томах, а затем приступает к тому, что вы попросили сделать.
Однако настройки усилий способны изменить экономику. Как отметил комментатор Hacker News, изучивший данные Artificial Analysis, Opus 5 на high effort стоил примерно $1.06 за один запуск intelligence index, а Sol на max — $1.04. Когда обе модели рассуждают на пределе, цены почти сравниваются.
GPT-5.6 — это Sol, Terra и Luna, а не одна модель
GPT-5.6 — не единственная модель. OpenAI предлагает три SKU, а строка gpt-5.6 без уточнения документирована как алиас gpt-5.6-sol — самой дорогой из трёх. Конфигурация с именем gpt-5.6 тарифицируется по максимальной ставке семейства, и это стоит проверить до любого сравнения затрат.
В справочнике моделей OpenAI Sol названа «frontier model for complex professional work», Terra — уровнем, который «balances intelligence and cost», а Luna — моделью, «optimized for cost-sensitive workloads». Все три имеют контекстное окно 1.05M токенов, максимум 128K выходных токенов, отсечку знаний 16 февраля 2026 года и шесть выбираемых уровней рассуждений: от none до max.
| Характеристика, проверено 29 июля 2026 года | Claude Opus 5 | GPT-5.6 (все три) |
|---|---|---|
| Контекстное окно | 1M tokens | 1.05M tokens |
| Максимальный вывод | 128K (300K via Batch API beta) | 128K |
| Надёжная отсечка знаний | May 2026 | February 16, 2026 |
| Управление рассуждениями | Adaptive thinking, effort по умолчанию — high | none / low / medium / high / xhigh / max |
| API ID | claude-opus-5 | gpt-5.6-sol / -terra / -luna |
Для выбора модели особенно важны две строки этой таблицы. Отсечка знаний Opus 5 в мае 2026 года на три месяца свежее, чем у всего семейства GPT-5.6, что имеет значение для задач со ссылками на релизы весны 2026 года. И управление рассуждениями различается не только количеством уровней: у GPT-5.6 можно полностью отключить рассуждения через none, тогда как Opus 5 адаптивно распоряжается собственным бюджетом мышления и дополнительно предлагает уровни effort.
Цены: единая ставка до 1M против порога 272K
Оба вендора публикуют понятные ставки за токены, и до 272K входных токенов они близки: у обоих флагманов $5 за миллион входных токенов, у Opus 5 $25 за миллион выходных против $30 у Sol, кэшированный ввод стоит одинаковые $0.50, а Batch даёт скидку 50% у обоих. По этим ставкам запрос с 200K входных и 20K выходных токенов стоит $1.50 на Opus 5 и $1.60 на Sol.
| За 1M токенов, прайс-лист на 29 июля 2026 года | Ввод | Кэшированный ввод | Вывод | Batch |
|---|---|---|---|---|
| Claude Opus 5 | $5.00 | $0.50 | $25.00 | $2.50 / $12.50 |
| GPT-5.6 Sol | $5.00 | $0.50 | $30.00 | $2.50 / $15.00 |
| GPT-5.6 Terra | $2.50 | $0.25 | $15.00 | $1.25 / $7.50 |
| GPT-5.6 Luna | $1.00 | $0.10 | $6.00 | $0.50 / $3.00 |
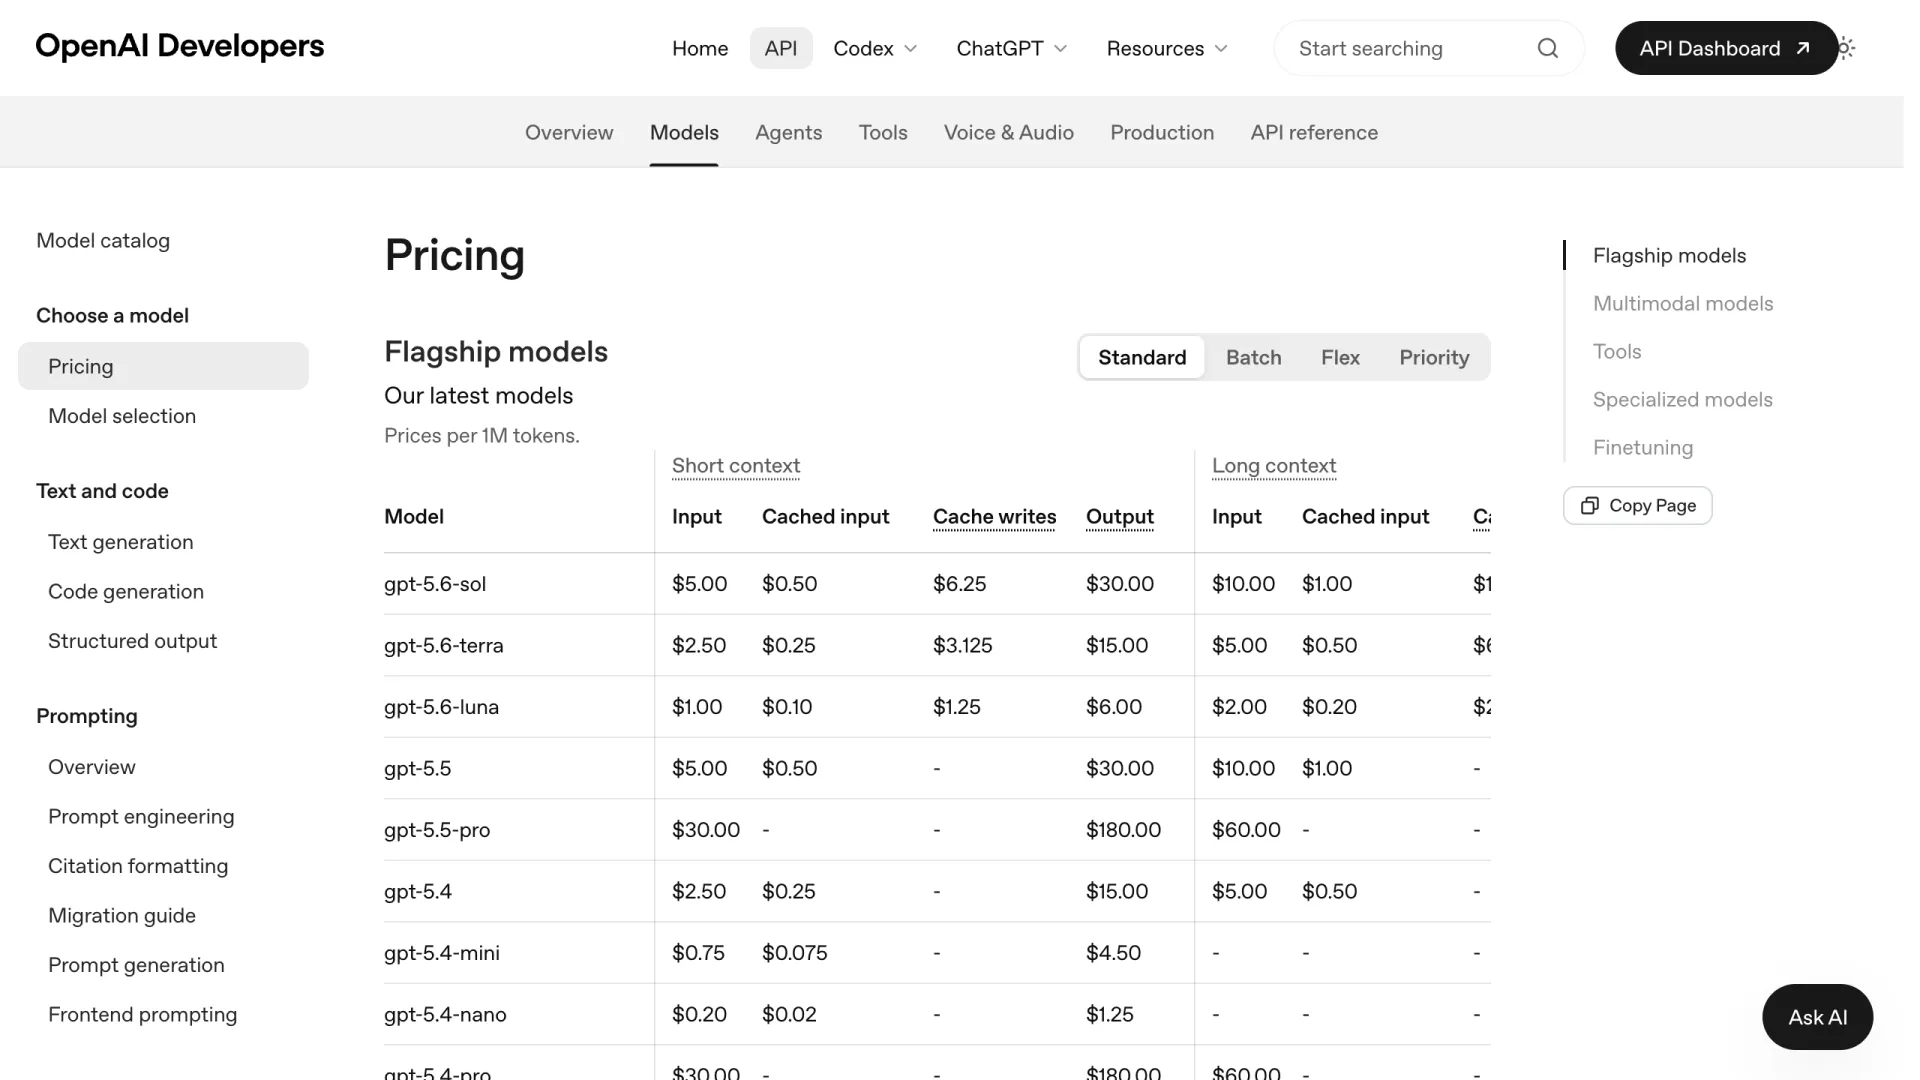
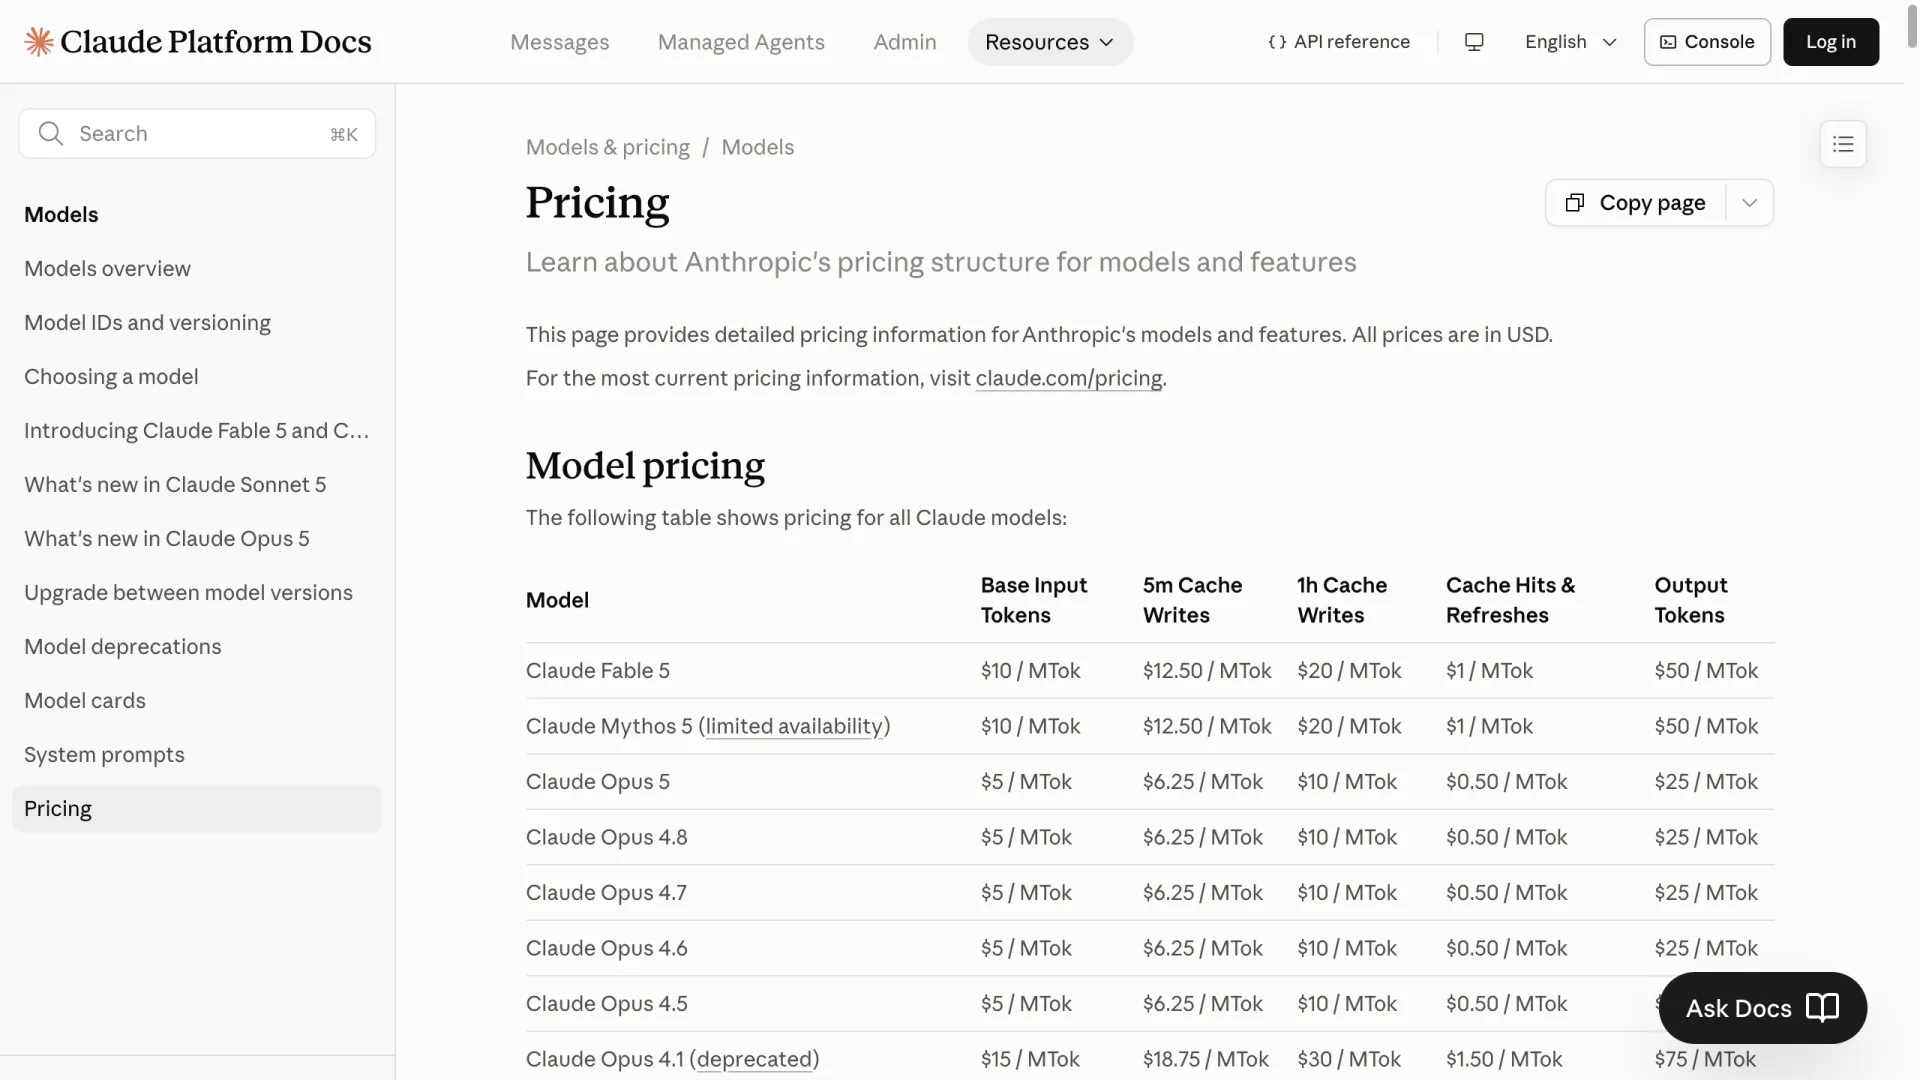
Ключевая разница начинается на 272K входных токенов. Страница цен OpenAI разбивает тарифы GPT-5.6 на короткий и длинный контекст: после 272K вход тарифицируется в 2 раза дороже, а вывод — в 1,5 раза. Для Sol это означает $10 и $45. В документации Anthropic по ценам описан противоположный подход одной фразой: «A 900k-token request is billed at the same per-token rate as a 9k-token request.»
В деньгах, при 20K выходных токенов на каждом уровне, запрос с 300K входных стоит $2.00 на Opus 5 и $3.90 на Sol. При 500K это $3.00 против $5.90, а при 900K — $5.00 против $9.90. После порога Opus 5 обходится примерно вдвое дешевле Sol для запроса той же формы.
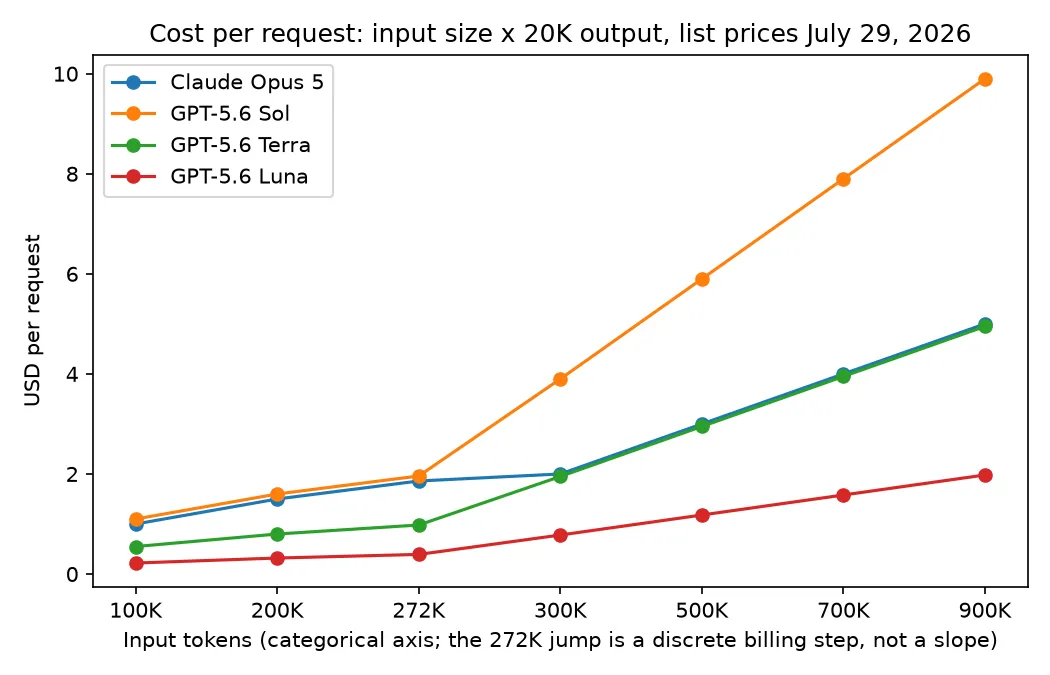
На графике есть и неожиданность, которая не позволяет объявить Anthropic безусловным победителем. После 272K удвоенная ставка Terra за вход составляет $5 — столько же, сколько у Opus 5, — а цена длинного контекста на выходе, $22.50, ниже $25 у Opus 5. При 20K выходных токенов Terra оказывается на постоянные пять центов дешевле в запросах с 300K, 500K, 700K и 900K входных токенов. Эти пять центов зависят от объёма вывода, а не от размера входа: разница равна $2.50 на миллион выходных токенов.
Три примечания для планирования бюджета. Anthropic предлагает для Opus 5 быстрый режим в research preview: $10 за вход и $50 за вывод. У OpenAI есть приоритетный уровень по двойным стандартным ставкам, но только для короткого контекста. Резидентность данных в регионе США добавляет около 10% у обоих вендоров. Наконец, согласно собственной заметке Anthropic, текущий токенизатор Claude для одного и того же текста создаёт примерно на 30% больше токенов, чем модели до 4.7. Поэтому перед расчётом ставок честнее всего прогнать один репрезентативный промпт через оба токенизатора.
Какую модель выбирать под разные задачи
При равенстве по правильности маршрутизация зависит от формы запроса и рабочего стиля. Разработчики в r/ClaudeCode используют Sol с высоким уровнем усилий как ревьюера и QA-агента: модель считают тщательной и сильной в работе с браузером. Другие пользователи r/codex отправляют большую часть задач на более дешёвые уровни GPT со средним reasoning и сообщают, что получают лучшее соотношение цены и результата.
| Форма запроса | Выбор | Причина |
|---|---|---|
| До 272K входных токенов, агентные циклы с большим выводом | Claude Opus 5 | $25 против $30 за вывод; лучший рефакторинг в нашем запуске |
| До 272K, высокая нагрузка или чувствительность к задержке | GPT-5.6 Terra | Самая быстрая и дешёвая из успешно пройденных нами моделей |
| Свыше 272K входных токенов | Claude Opus 5 или Terra | Тарифы Sol для длинного контекста удваиваются; Terra на пять центов дешевле Opus 5 |
| Ревью, QA и проверки через браузер | GPT-5.6 Sol | Шесть уровней усилий для настройки глубины ревью; проверьте на собственном QA-наборе |
| Одноразовая классификация и извлечение данных | GPT-5.6 Luna | $1/$6 и успешное прохождение всех четырёх проверок |
Впрочем, не все считают Sol лучшим кандидатом на QA: в одной ветке r/codex Sol называют регрессией относительно GPT-5.5, а Opus 5 хвалят за большее число завершённых задач на один план. Проверить настройки по умолчанию недорого: все четыре модели есть в каталоге AIReiter — Opus 5 и Sol — поэтому свои задачи можно воспроизвести рядом друг с другом.
Главная цифра из этого сравнения — 272 000 входных токенов. Ниже порога выбор определяется поведением, задержкой и разницей в $5 за миллион выходных токенов. Выше него ценовой аргумент в споре с Sol оказывается на стороне Anthropic, хотя Terra остаётся на пять центов дешевле Opus 5, а Luna — значительно дешевле обеих.
FAQ
gpt-5.6 — это та же модель, что GPT-5.6 Sol?
Да. В справочнике моделей OpenAI строка gpt-5.6 указана как алиас, который разрешается в gpt-5.6-sol. Поэтому она тарифицируется по ставкам Sol: $5 за вход и $30 за выход на миллион токенов до 272K входных, а после — $10 и $45.
Берёт ли Claude Opus 5 больше за запросы с длинным контекстом?
Нет. Anthropic применяет стандартные ставки ко всему окну в 1M токенов в обычном API и указывает, что запрос на 900K токенов стоит за токен столько же, сколько запрос на 9K. Доплата действует только для опционального быстрого режима: $10 за вход и $50 за вывод.
Что дешевле: Claude Opus 5 или GPT-5.6?
Зависит от уровня модели. До 272K входных токенов Opus 5 дешевле Sol на $5 за миллион выходных токенов, а остальные ставки одинаковы; Terra и Luna значительно дешевле обеих. После 272K Opus 5 стоит примерно вдвое меньше Sol для одного и того же запроса, а Terra остаётся немного дешевле Opus 5.
Claude Opus 5 лучше GPT-5.6 для программирования?
В нашем запуске 29 июля обе модели верно исправляли код, считали и рефакторили, а пост с графиком из r/Anthropic, который в этот день возглавлял выдачу Google по запросу, показывает почти равные оценки в программировании. Opus 5 продемонстрировал лучшее понимание рефакторинга, но при настройках по умолчанию списал в 3,4 раза больше выходных токенов, чем Sol. Выбор для кода — это вопрос экономики и желаемой многословности.
Какие отсечки знаний у Opus 5 и GPT-5.6?
Anthropic указывает для Claude Opus 5 надёжную отсечку знаний в мае 2026 года. У всех трёх моделей GPT-5.6 она приходится на 16 февраля 2026 года — примерно на три месяца раньше.