 AIREITER
Запустить модель на 27 млрд параметров прямо на смартфоне — уже не просто эффектная демонстрация. Bonsai 27B от PrismML действительно помещается в 3,9 ГБ и выдаёт на iPhone 17 Pro около 11 токенов в секунду. Это квантизированная версия Qwen3.6 27B с открытыми весами по лицензии Apache 2.0. Тернарная сборка сохраняет свыше 95% результата полновесной FP16-модели в бенчмарках, но качество распределено неравномерно: математика и код почти не проседают, а вызов инструментов и работа с изображениями заметно слабее. Для локальных рассуждений и программирования Bonsai 27B выглядит интересным вариантом; для агентных сценариев с активным использованием инструментов — пока не самым надёжным. Ниже — как достигнуто такое сжатие, что означают цифры тестов, как запустить модель и кому это имеет смысл.
Как PrismML уместила модель 27B в памяти смартфона
Обычной модели на 27 млрд параметров в FP16 требуется примерно 54 ГБ памяти — для любого телефона это недостижимо. Bonsai 27B занимает менее 6 ГБ, поскольку вместо весов полной точности использует компактные дискретные значения.
В тернарной версии каждый вес ограничен тремя вариантами: -1, 0 или +1. Теоретически это около 1,58 бита информации на один вес. PrismML дополняет такую схему групповым масштабированием FP16: для каждой группы весов хранится коэффициент полной точности, чтобы сжатые значения сохраняли подходящий масштаб. В итоге фактическая стоимость составляет примерно 1,71 эффективного бита на вес. Ещё более агрессивный 1-битный бинарный вариант исключает ноль, оставляя только -1 и +1, и опускается примерно до 1,125 эффективного бита.
Здесь важны два момента. Во-первых, квантизация охватывает модель целиком: embeddings, attention, MLP-блоки и голову языковой модели. Полноточных компонентов, которые могли бы поддерживать качество, не остаётся. Во-вторых, основой служит Qwen3.6 27B — гибридная causal-модель с 27,8 млрд параметров. От неё Bonsai наследует контекстное окно в 262K токенов и мультимодальный ввод.
Тернарная или 1-битная: какую сборку выбрать
PrismML предлагает две сборки, и выбор здесь сводится к понятному компромиссу: меньший размер означает более низкую точность. Неподходящий вариант либо зря займёт память, либо даст ненужную потерю качества.
| Сборка | Эффективных бит на вес | Размер | Сохранённое качество | Лучший сценарий |
|---|---|---|---|---|
| Тернарная (-1, 0, +1) | ~1,71 | 5,9 ГБ | >95% от FP16 | Десктопы и задачи, чувствительные к качеству |
| 1-битная бинарная (-1, +1) | ~1,125 | 3,9 ГБ | >90% от FP16 | Смартфоны и устройства с ограниченной памятью |
Для смартфона стоит брать 1-битную сборку: именно она укладывается в доступный запас памяти iPhone 17 Pro. Если же у вас ноутбук или настольный компьютер с запасом памяти, тернарная версия за дополнительные 2 ГБ возвращает несколько пунктов точности. В случаях, когда важнее качество ответа, а не размер модели, это оправданный обмен.
Что показывают бенчмарки — и где начинаются потери
Официальные результаты относятся к тернарной сборке: её средний балл составляет 80,49 по 15 бенчмаркам в thinking-режиме. Отдельные показатели выглядят особенно сильно:
| Бенчмарк | Результат | Что измеряет |
|---|---|---|
| MATH-500 | 99,20 | Математика от школьного до олимпиадного уровня |
| AIME 2025 | 90,84 | Сложные олимпиадные математические задачи |
| HumanEval+ | 93,90 | Генерация кода |
| BFCL v3 | 74,41 | Вызов функций и инструментов |
Если посмотреть на эти цифры вместе, профиль Bonsai 27B становится очевиден. Математика и программирование держатся на уровне 90+, а вызов инструментов — в диапазоне 70. Это ключевое ограничение, которое стоит учитывать до внедрения модели: квантизация гораздо лучше сохраняет способность рассуждать и писать код, чем структурированное многошаговое поведение, необходимое агентным системам.
Все приведённые результаты опубликованы самой PrismML, поэтому пока их разумнее считать отправной точкой, а не окончательным вердиктом — независимых тестов ещё должно накопиться. Среднее значение 80,49 скрывает важные детали: смотрите на результаты по конкретным задачам и на реальные сценарии сбоев. Первые тестировщики сообщали, что тернарная сборка иногда зацикливается в рассуждениях. Кроме того, экстремальная квантизация обычно сильнее ухудшает стабильность на длинном контексте, чем это видно по оценке одиночной задачи. Перед использованием в важном процессе стоит проверить модель на собственных промптах.
Скорость генерации на разных устройствах
Столь агрессивное сжатие имеет смысл лишь при достаточной скорости инференса. На производительном железе она есть. Ниже — данные PrismML:
| Устройство | 1-битная | Тернарная |
|---|---|---|
| iPhone 17 Pro | 11 ток/с | — |
| Apple M5 Max | 87 ток/с | 58 ток/с |
| NVIDIA RTX 5090 | 163 ток/с | 134 ток/с |
11 токенов в секунду на телефоне достаточно для чата и коротких рассуждений, хотя молниеносной такую скорость не назовёшь. На M5 Max 87 токенов в секунду — это уже уровень, при котором локальный запуск на коротких запросах может обогнать облачный API с учётом сетевых задержек. PrismML также предлагает смотреть на плотность интеллекта — балл бенчмарков на гигабайт. У Bonsai этот показатель около 0,53, то есть примерно в десять раз выше, чем у полновесной базовой модели.
Четыре способа запустить Bonsai 27B уже сейчас
Весы открыты, поэтому единственной команды для установки здесь нет. Вот четыре рабочих способа — от варианта без настройки до полного контроля над запуском.
На iPhone
Приложение Locally AI для iOS запускает 1-битную сборку размером 3,9 ГБ прямо на устройстве — без аккаунта и сервера. Именно этот путь реализует обещание «27B на телефоне»: после загрузки весов модель работает полностью офлайн.
В браузере
PrismML публикует WebGPU-ядра, позволяющие запустить 1-битную модель прямо во вкладке браузера без установки. Это самый быстрый способ попробовать Bonsai 27B, прежде чем выделять ей место на диске. Но потребуется компьютер с GPU, поддерживающим WebGPU.
Локально на компьютере
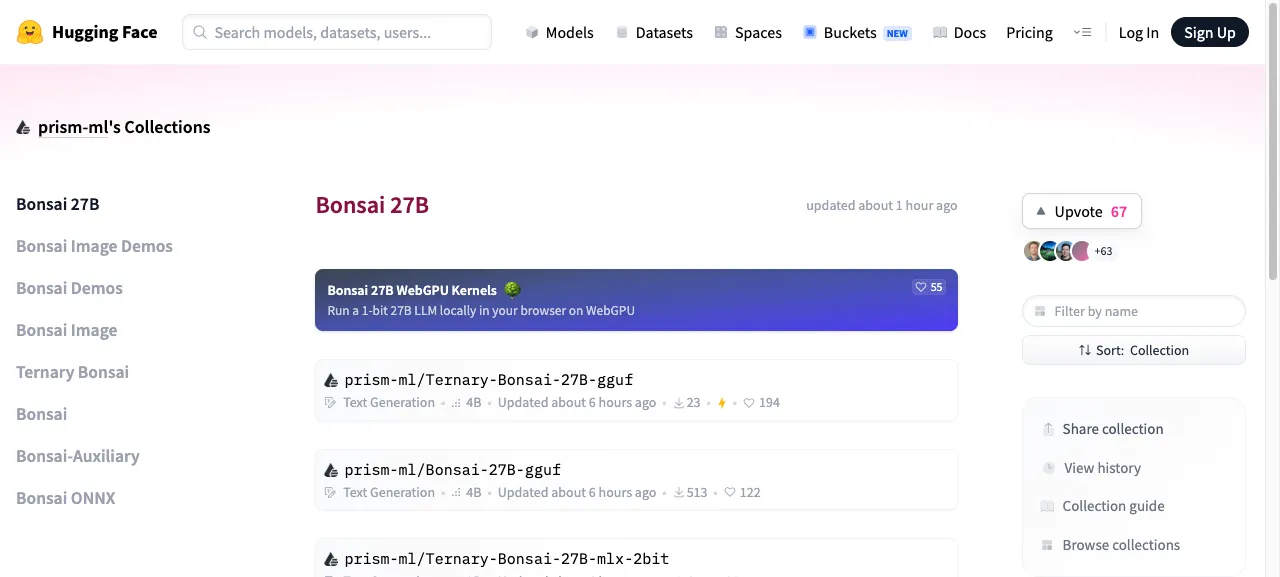
Веса в форматах GGUF, MLX и ONNX доступны на Hugging Face и GitHub по лицензии Apache 2.0. Основные репозитории — prism-ml/Bonsai-27B-gguf для 1-битной версии и prism-ml/Ternary-Bonsai-27B-gguf для тернарной; рядом доступны сборки MLX 2-bit и ONNX. Для 1-битного варианта стоит заложить около 4 ГБ свободного места и RAM, для тернарного — 6 ГБ. Есть нюанс: инструменты ещё не успели полноценно догнать релиз. Веса загружаются в нескольких рантаймах, но на момент запуска популярные локальные приложения, включая LM Studio, ещё не получили полной поддержки. Вероятно, понадобится ручная настройка.
Через облачный API
Если не хочется самостоятельно управлять весами, тернарная сборка доступна через стандартный API на Together.ai. Поддерживаются полное контекстное окно 262K, ввод изображений и JSON mode. Во время стартовой акции цена входных токенов была указана как $0.00 за миллион токенов. Перед расчётом бюджета обязательно проверьте актуальный тариф: промоцену могут изменить.
Bonsai 27B или Gemma 4 12B QAT
Чаще всего Bonsai сравнивают с Gemma 4 12B QAT — моделью Google, обученной с учётом квантизации. Она занимает около 7 ГБ, то есть лишь немного больше тернарной версии Bonsai.
У моделей разные сильные стороны. Благодаря базе на 27B Bonsai 27B заметно превосходит Gemma в математических и кодовых бенчмарках. Gemma обычно лучше сохраняет качество в задачах зрения и вызова инструментов, а её чуть более крупные и менее агрессивно сжатые веса делают её более стабильным универсальным выбором для смартфона. Для локальных рассуждений и работы с кодом сильнее Bonsai; если в нагрузке много изображений или function calling, безопаснее выбрать Gemma 4 12B QAT.
Кому действительно стоит использовать Bonsai 27B
Bonsai 27B подойдёт тем, кому нужны приватные локальные рассуждения или помощь с программированием без подключения к сети, а в распоряжении есть устройство уровня iPhone 17 Pro или производительный ноутбук. Модель также интересна как объект для изучения экстремальной квантизации: запуск 27B-модели во вкладке браузера сам по себе стал важной вехой, а открытая лицензия Apache 2.0 упрощает эксперименты. Она органично дополняет другие открытые и бесплатные модели для программирования, когда нужен локальный вариант.
Пока не стоит применять её в промышленных агентных системах, где критичен надёжный вызов инструментов, в задачах с высокими требованиями к зрению или там, где дорого обойдётся зацикливание рассуждений. В таких случаях более слабо квантизированная модель либо полновесная версия через API остаётся более безопасным выбором.
Частые вопросы
Bonsai 27B можно использовать бесплатно?
Да, веса распространяются бесплатно по лицензии Apache 2.0: их можно скачать и запускать без оплаты. У хостингового доступа через Together.ai собственные тарифы API; на старте цена входных токенов была заявлена как $0.00 за миллион. Уточняйте текущую стоимость.
Bonsai 27B действительно работает на телефоне?
Да. 1-битная сборка занимает 3,9 ГБ и через приложение Locally AI работает на iPhone 17 Pro со скоростью около 11 токенов в секунду. После загрузки она полностью автономна.
Bonsai 27B так же хороша, как полная Qwen3.6 27B?
Почти, но не полностью. Тернарная сборка сохраняет более 95% результатов FP16-версии в бенчмарках, 1-битная — более 90%. Лучше всего сохраняются математика и код, хуже всего — вызов инструментов.
Какой файл Bonsai 27B скачивать?
Для телефона или машины с ограниченной памятью выбирайте 1-битную сборку — prism-ml/Bonsai-27B-gguf, около 3,9 ГБ. Для десктопа или GPU с запасом памяти лучше взять тернарную — prism-ml/Ternary-Bonsai-27B-gguf, около 5,9 ГБ: она даёт несколько дополнительных пунктов точности. Для Apple Silicon и кроссплатформенных рантаймов также есть варианты MLX 2-bit и ONNX.
Что такое тернарная квантизация?
При ней каждый вес модели хранится не как число полной точности, а как одно из трёх значений: -1, 0 или +1. За счёт этого размер модели резко сокращается. Коэффициенты масштабирования FP16 помогают сжатым весам сохранять примерно правильную величину.
Bonsai 27B поддерживает изображения?
Да. Модель принимает изображения вместе с текстом и возвращает текстовый ответ, наследуя мультимодальные возможности базовой Qwen3.6 27B. Однако после сжатия качество работы со зрением сохраняется хуже, чем в математике и программировании.