 AIREITER
Em resumo: vale testar o Seed Audio 1.0 agora se você produz áudios curtos em inglês ou chinês — mas por meio de um gateway de terceiros, não da API oficial. O modelo da ByteDance cria uma cena sonora completa a partir de um único prompt, com diálogo, música de fundo e efeitos sonoros. Seu diferencial diante de ferramentas focadas apenas em TTS ou música está justamente nos diálogos com múltiplos falantes e na mixagem musical integrada. Há, porém, três limites importantes: cada geração tem no máximo dois minutos, o suporte fica restrito a inglês e chinês, e a API oficial continua disponível apenas por convite, sem preço publicado. Veja o panorama completo.
O que é o Seed Audio 1.0
A maioria das ferramentas de áudio resolve uma tarefa específica: texto para fala, música ou efeitos sonoros. O Seed Audio 1.0, cujo nome completo é Doubao-Seed-Audio 1.0, reúne as três em uma única linha do tempo e em uma só geração. Basta descrever algo como "um drama radiofônico de suspense em uma loja de conveniência tarde da noite" para receber um áudio finalizado, com falas, som ambiente e trilha musical já mixados.
O modelo opera em três modos. O Text-to-Audio (T2A) monta uma cena a partir de uma descrição escrita. Já o Text-and-Audio-to-Audio (TA2A) combina clipes de referência com texto para orientar voz e estilo. Há ainda o TTS convencional, voltado para narrações simples quando você só precisa de fala limpa. A escolha depende do tipo de entrada que você fornece.
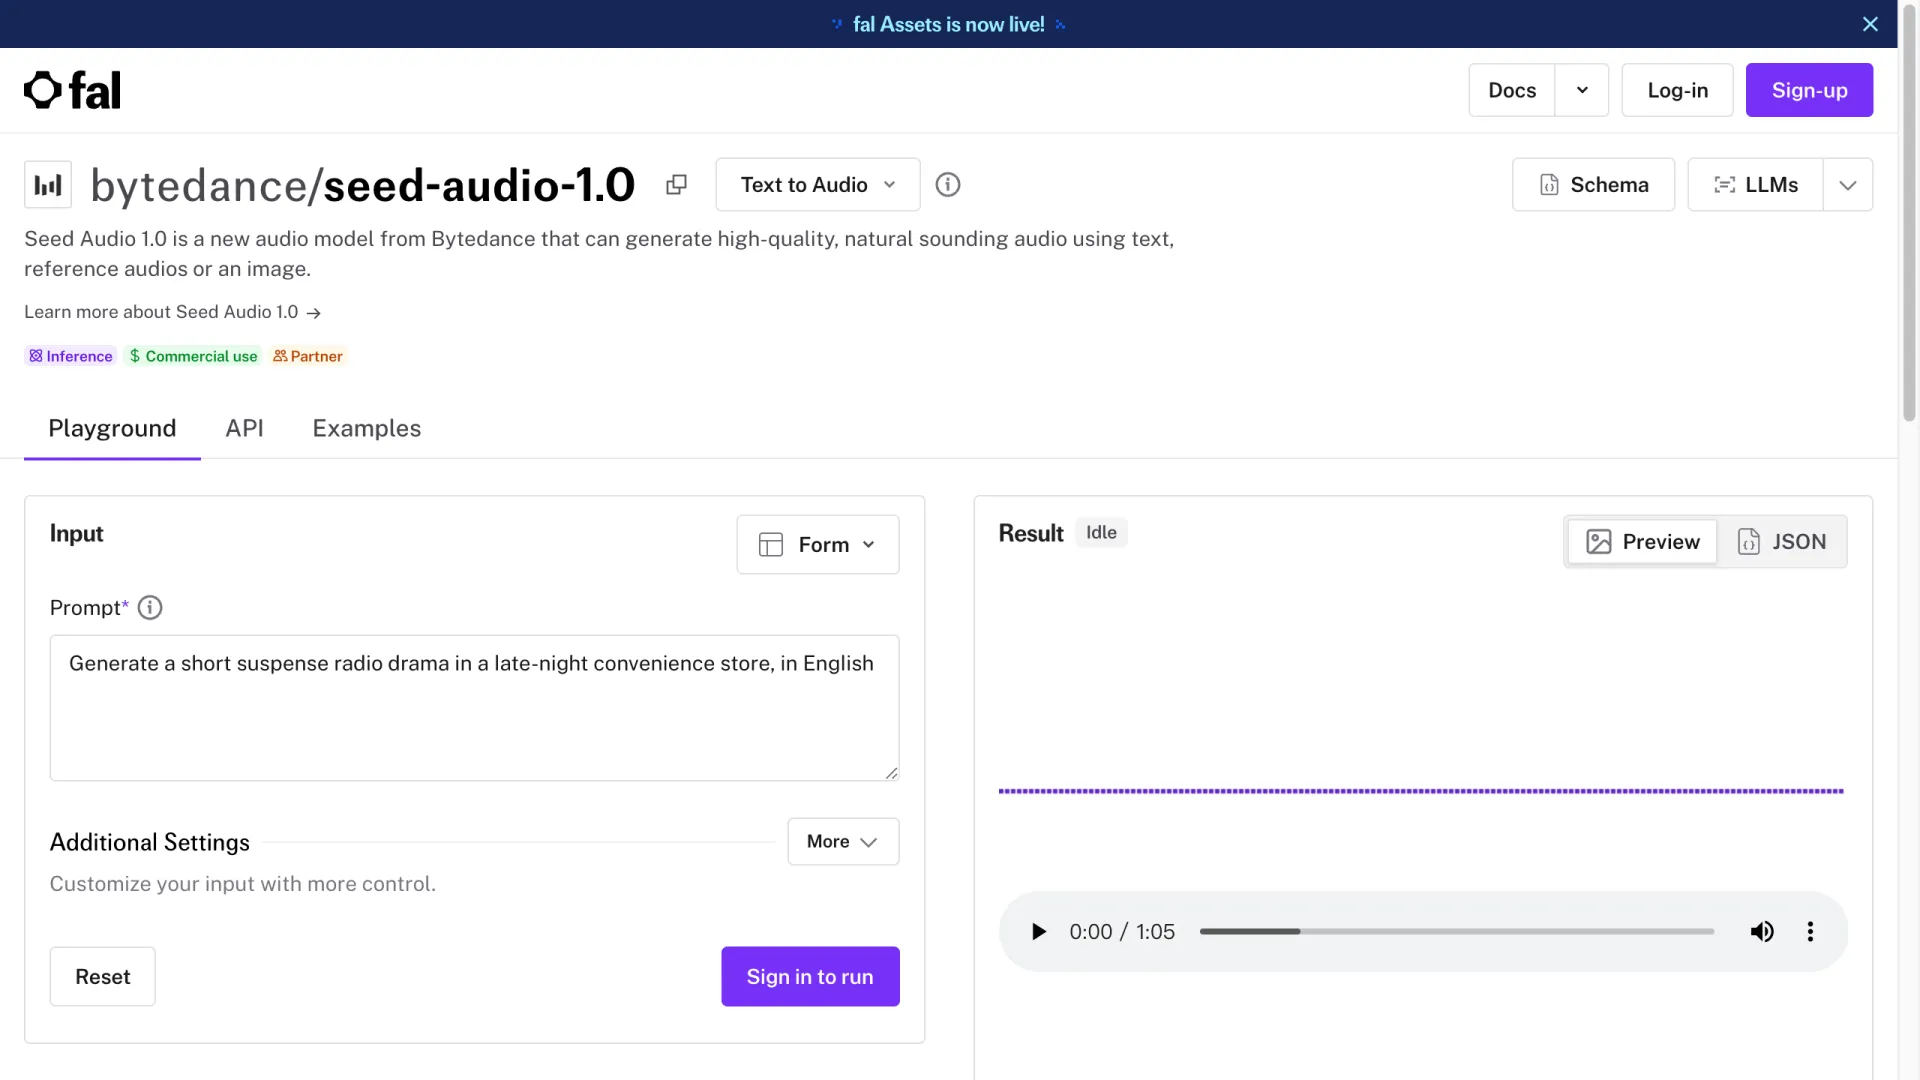
Vale esclarecer um ponto: isso é uma ferramenta de clonagem de voz? O Seed Audio 1.0 consegue fazer uma mesma voz interpretar vários papéis e reproduzir o tom de um clipe de referência, mas o resultado é sintetizado e não fica vinculado à identidade de um locutor real específico. Encare-o como uma ferramenta de estilização de voz zero-shot, não como um clonador sem consentimento de uma pessoa identificada. Ele se baseia nas pesquisas anteriores da ByteDance, Seed-TTS e Seed-Music, o que explica por que expressividade na fala e geração de música convivem no mesmo modelo.
Especificações que definem se ele serve para você
Antes de tudo, veja se seu caso de uso cabe nos limites rígidos do modelo. Estes são os números mais importantes, conferidos nas listagens do modelo no fal e no EvoLink:
| Especificação | Valor |
|---|---|
| Duração máxima por geração | 120 segundos (2 minutos) |
| Limite de prompt de texto | ~1.500–2.000 caracteres (as fontes divergem; confirme no console) |
| Áudio de referência | Até 3 clipes, com ≤30 segundos cada |
| Idiomas | Apenas inglês e chinês |
| Formatos de saída | WAV, MP3, PCM, OGG Opus |
| Taxas de amostragem | 48K / 24K / 16K / 8K |
| Controles | Velocidade, pitch, volume (sem SSML) |
| Modelo de cobrança | Baseado na duração do áudio gerado |
O teto de dois minutos é a limitação que mais pesa. Para um episódio completo de podcast ou uma narração longa, será necessário dividir o roteiro e unir os trechos depois — com o risco de a tonalidade variar entre segmentos. As notas do modelo no fal apontam para uma atualização planejada que elevaria a duração de uma geração para perto de dez minutos, com controle explícito de duração e suporte mais amplo a idiomas. Se seu trabalho é focado em conteúdos longos, pode valer a pena esperar.
Preços
Ainda não há um preço oficial. Até julho de 2026, a Volcengine não publicou uma tarifa por segundo para o Seed Audio 1.0. O modelo segue disponível apenas por convite no Volcano Ark, e os valores oficiais costumam aparecer quando há disponibilidade geral. Gateways como fal e EvoLink também não fixam uma tarifa: a cobrança é feita pela duração do áudio gerado (custo = segundos gerados × tarifa), portanto tentativas repetidas também entram na conta. Ignore valores por token que estejam circulando — esse tipo de cobrança não faz sentido para um modelo de áudio baseado em duração.
Como acessar o Seed Audio 1.0 hoje
Na prática, existem dois caminhos — e eles funcionam de formas bem diferentes.
O caminho oficial é o Volcano Ark, onde o Seed Audio 1.0 está disponível apenas por convite. Você solicita acesso, aguarda a liberação e usa o console da própria ByteDance — que será a fonte definitiva quando chegarem a disponibilidade geral e os preços.
O caminho mais viável é recorrer a um gateway de terceiros. O fal hospeda o modelo como bytedance/seed-audio-1.0, sem lista de autorização: basta usar o endpoint via API com uma chave padrão. O EvoLink oferece acesso semelhante. Hoje, é assim que a maioria das pessoas consegue gerar áudio com o modelo sem esperar por um convite.
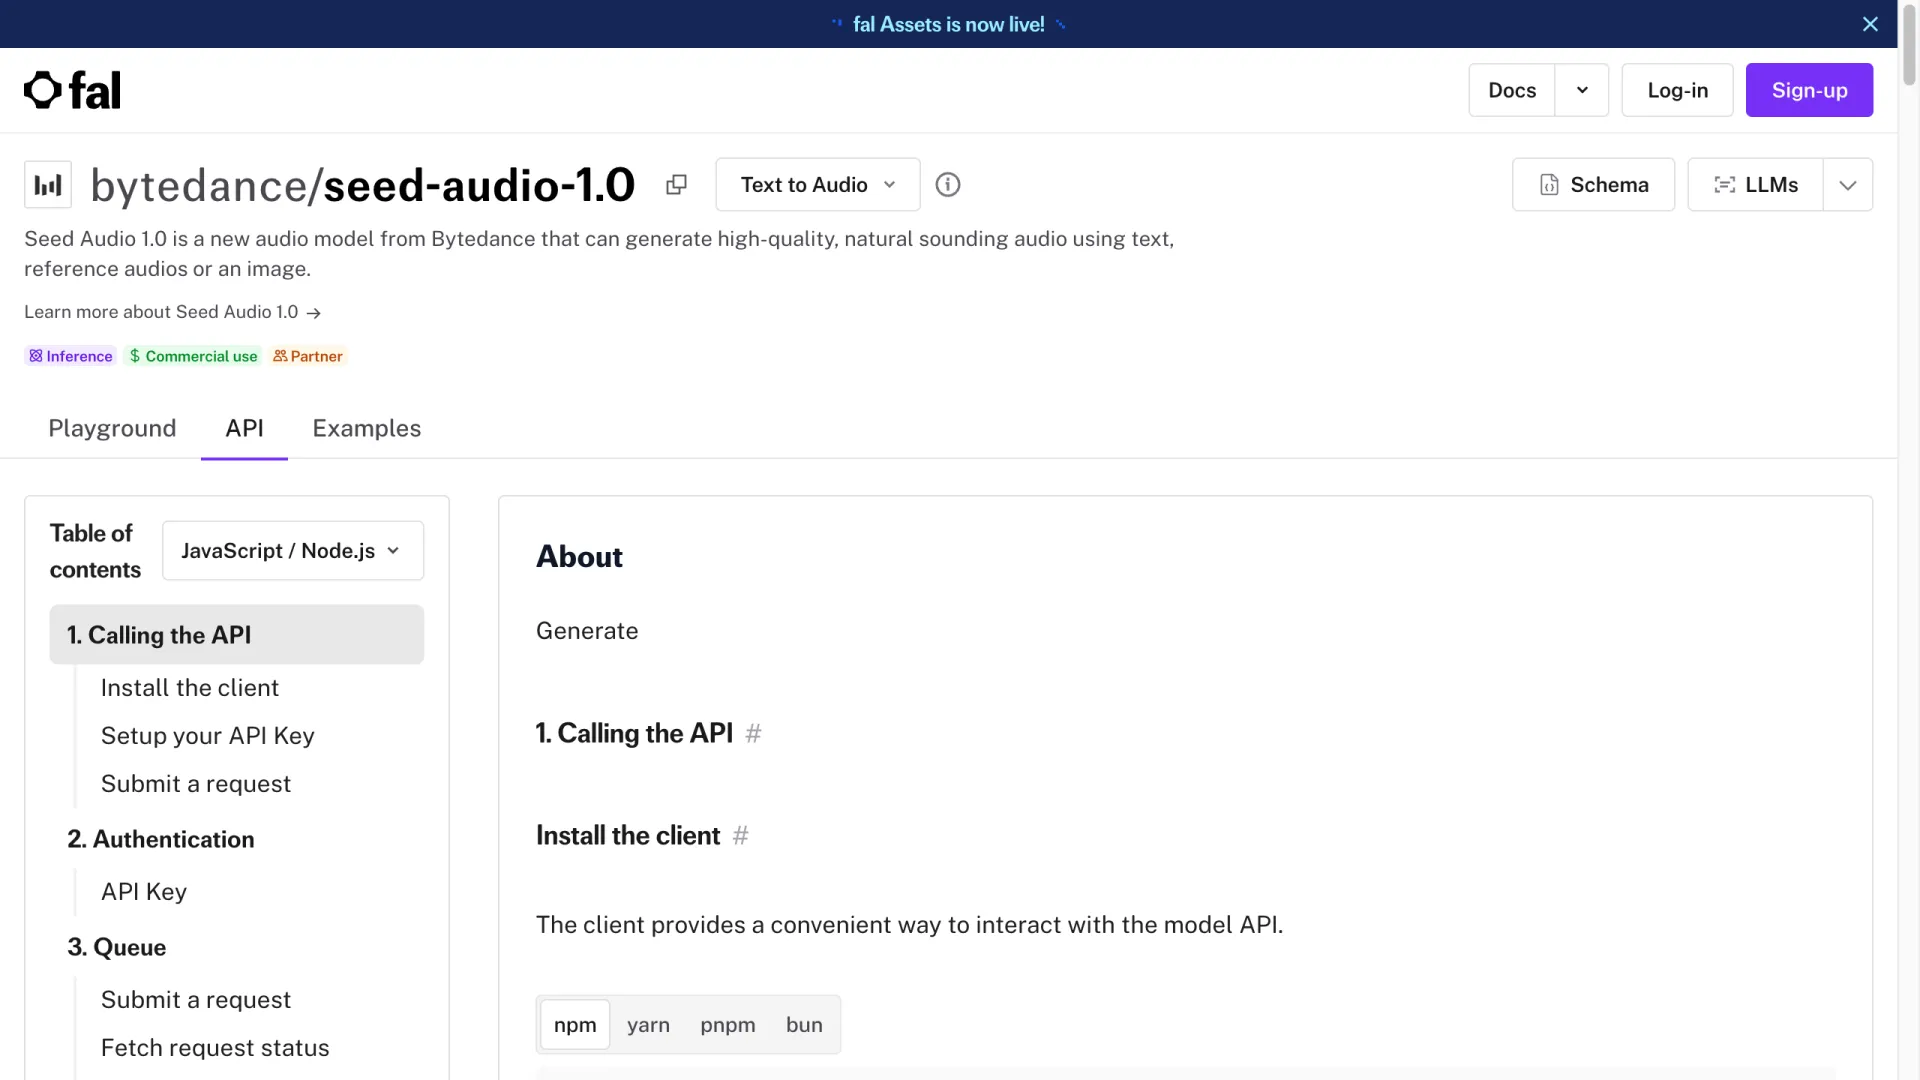
O padrão de chamada segue uma API convencional baseada em fila: instale o cliente, configure sua chave, envie um prompt e consulte o resultado. Se você já integrou algum modelo generativo hospedado dessa forma, não há novidade aqui; nossa análise do fal.ai detalha melhor a experiência para desenvolvedores.
Um bom primeiro teste é uma cena curta com vários falantes, que coloque diálogo, ambiência e ritmo à prova ao mesmo tempo — por exemplo, "um drama radiofônico de suspense de 30 segundos em uma loja de conveniência tarde da noite, em inglês". Mantenha o primeiro clipe abaixo de 30 segundos para que uma geração malsucedida custe pouco enquanto você entende como o modelo interpreta seu prompt.
Seed Audio 1.0 vs ElevenLabs, Stable Audio e AudioCraft
A comparação relevante não é a qualidade de cada clipe isoladamente, mas a função para a qual cada ferramenta foi criada.
| Ferramenta | Ponto forte | Mixagem de cena | Idiomas | Controle de voz |
|---|---|---|---|---|
| Seed Audio 1.0 | Cenas sonoras completas (fala + música + SFX) | Sim, em uma passagem | EN, CN | Estilização zero-shot |
| ElevenLabs | Fala e clonagem de voz | Apenas fala | 30+ | Clonagem mais forte |
| Stable Audio | Geração de música e som | Faixa única | N/A (música) | Baseado em prompt |
| AudioCraft | Música/SFX de código aberto | Faixa única | N/A (música) | Baseado em prompt |
Se você precisa da melhor fala pura ou de clonagem de voz precisa em muitos idiomas, o ElevenLabs ainda leva vantagem. Para música independente, Stable Audio e o AudioCraft da Meta são mais adequados. O diferencial do Seed Audio 1.0 é unir diálogo, música e efeitos em uma cena coerente e editável — nenhuma outra ferramenta desta lista faz isso em uma única chamada.
Onde ele se destaca — e onde deixa a desejar
Pontos fortes: Diálogos com múltiplos falantes e mixagem de música e efeitos em uma única passagem são os grandes atrativos. Além disso, os fluxos de edição documentados — estender um clipe, preencher uma seção e unir tomadas, segundo o guia de uso do fal — fazem dele uma ferramenta de produção, não apenas um gerador de resultados isolados.
Limitações: O teto de dois minutos obriga a unir trechos em qualquer projeto mais longo. O suporte apenas a inglês e chinês exclui grande parte dos trabalhos de voz globais. Como é um modelo de geração offline, não serve para agentes de voz em tempo real. E o acesso oficial continua restrito a convite.
Já vale a pena usar?
Se seu conteúdo é em inglês ou chinês e se encaixa em formatos curtos — dublagem, trechos de audiolivro, trilhas para vídeos curtos ou protótipos de dramas em áudio — vale testar o Seed Audio 1.0 hoje por meio de um gateway. Gerar a cena inteira de uma vez elimina a etapa manual de combinar fala, música e efeitos.
Espere se você precisa de interação em tempo real, de um idioma não suportado ou de áudio longo sem interrupções. A disponibilidade geral e a atualização planejada de duração devem mudar esse cenário. Enquanto isso, um modelo em tempo real como o Qwen Audio 3 é mais adequado para casos de uso ao vivo. Para todos os demais, este é um momento de "testar em um gateway e manter a stack atual funcionando", não de migrar tudo de uma vez.
Perguntas frequentes
O Seed Audio 1.0 é gratuito?
Não. Não existe um nível oficial gratuito: a API do Volcano Ark é exclusiva por convite e passa a ser cobrada pela duração do áudio gerado quando você tem acesso. Gateways de terceiros cobram suas próprias tarifas medidas por uso.
O Seed Audio 1.0 consegue clonar minha voz?
Ele consegue imitar o estilo de um clipe de referência e dar voz a vários papéis, mas produz fala sintetizada, não um clone fixo de uma pessoa real específica. Não o trate como uma ferramenta de clonagem de identidade pronta para uso.
Quais idiomas o Seed Audio 1.0 suporta?
No lançamento, apenas inglês e chinês. Segundo as notas do modelo no fal, há suporte multilíngue mais amplo no roteiro de uma atualização planejada.
Qual é a duração máxima do áudio gerado?
Hoje, até 120 segundos por geração. A atualização planejada eleva a duração de uma única geração para perto de dez minutos, com controle explícito de duração.
Existe uma API oficial para o Seed Audio 1.0?
Sim, no Volcano Ark da Volcengine, mas por enquanto ela é exclusiva por convite. Para acesso aberto sem lista de autorização, use um gateway como o fal, que hospeda bytedance/seed-audio-1.0.
Qual é a diferença entre Seed Audio e Seed Music?
O Seed-Music foi a pesquisa anterior da ByteDance focada em música. O Seed Audio 1.0 combina essa capacidade musical com fala e efeitos sonoros em um único modelo de geração de cenas.