 AIREITER
Qwen Audio 3.0 Realtime é a oferta de áudio em tempo real da linha atual da Qwen: você fala com o modelo, ele responde em voz, e a latência é baixa o bastante para a interação lembrar uma chamada telefônica. Na plataforma da Alibaba, isso chega pela API Qwen3-Omni / Qwen3.5-Omni Realtime — com IDs como qwen3-omni-flash-realtime —, pelo Qwen-TTS-Realtime para conversão direta de texto em fala e pelo qwen3-asr-flash para transcrição. Os modelos omni Realtime hospedados reconhecem mais de 100 idiomas, operam em full duplex com interrupções e custam uma fração de centavo por minuto de conversa.
Para começar sem complicação, use qwen3-omni-flash-realtime via WebSocket. A seguir, veja o papel de cada modelo, preços, comparação com OpenAI Realtime e Gemini Live e os primeiros passos para integrar a API. Todas as especificações, preços e IDs de modelo apontam para suas fontes primárias, principalmente a documentação Realtime do Model Studio da Alibaba e o model card do Qwen3-Omni. Esse mercado muda rápido; se algum número tiver sido atualizado, considere a fonte linkada como referência.
Entenda os nomes da linha de áudio da Qwen
A família de áudio da Qwen passou por algumas gerações. Entender essa evolução ajuda a escolher o modelo certo:
Qwen-Audio(2023) eQwen2-Audioeram modelos de compreensão de áudio: recebiam áudio e retornavam texto. Eles não geravam fala.- Na geração atual, o áudio foi incorporado aos modelos omni.
Qwen3-OmnieQwen3.5-Omniaceitam texto, imagens, áudio e vídeo, produzindo texto e fala natural. - O funcionamento em tempo real é uma camada de entrega: os mesmos modelos omni chamados pela Realtime API, com IDs que terminam em
-realtime.
Na prática, “Qwen Audio 3.0 Realtime”, independentemente da forma como o nome é escrito, se refere à família Qwen3-Omni usada em tempo real. É essa pilha que o restante deste guia aborda.
A pilha de áudio em tempo real da Qwen tem três partes
Em vez de pensar em um modelo isolado, faz mais sentido enxergar um pipeline. Um aplicativo de voz em produção costuma envolver três modelos da Qwen, que podem trabalhar juntos ou de forma independente.
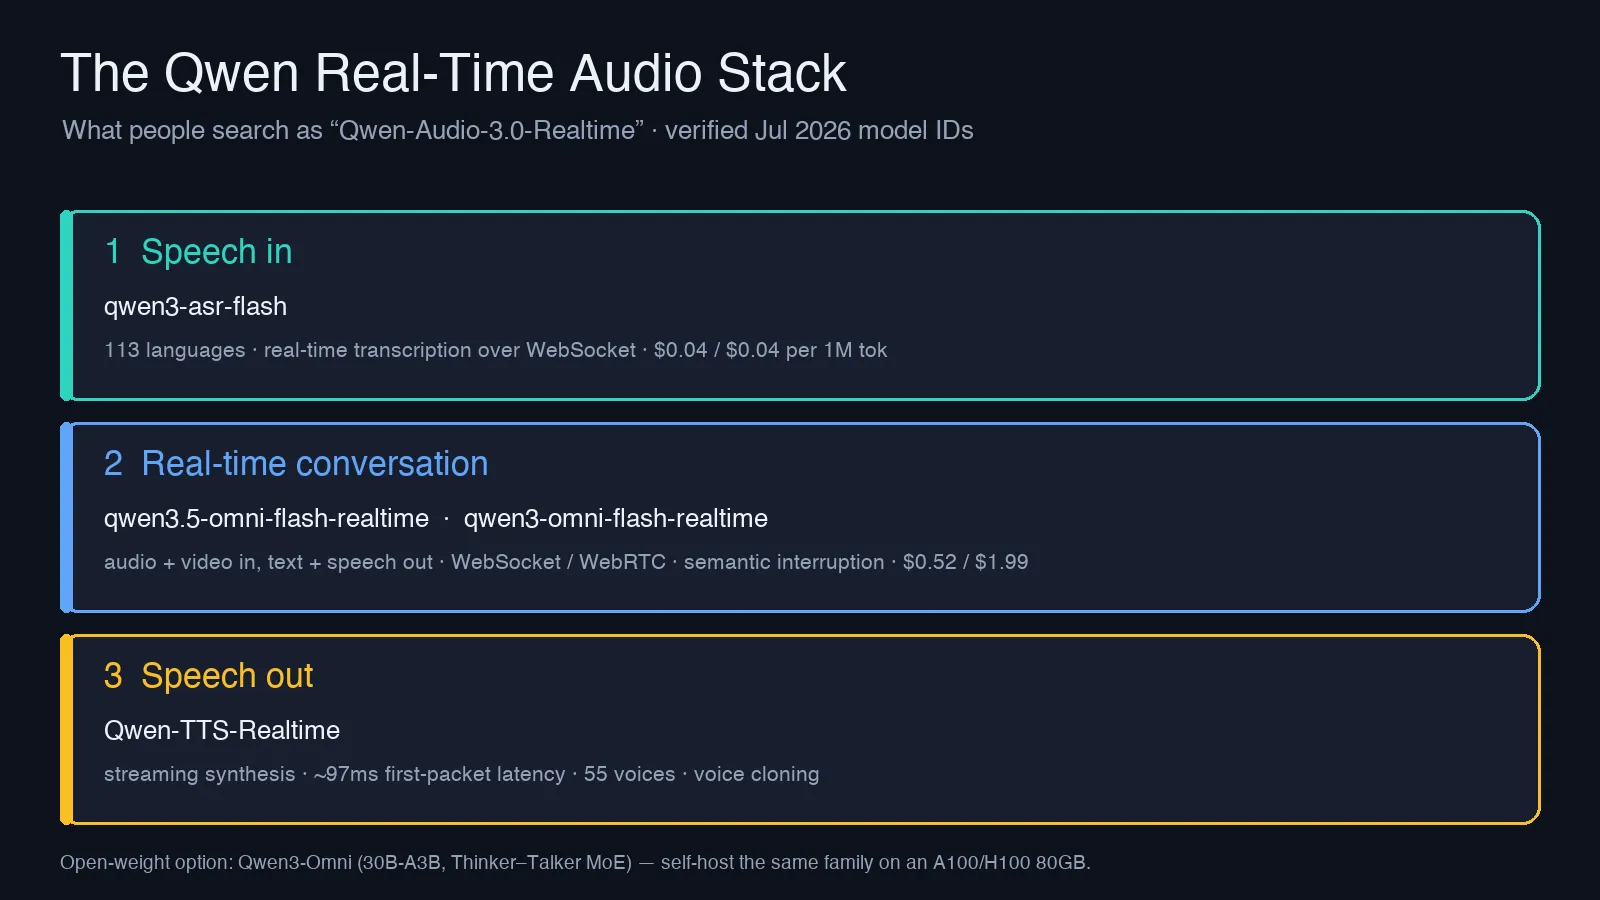
- Entrada de voz —
qwen3-asr-flash. Reconhecimento de fala em streaming via WebSocket, voltado a legendas ao vivo e interfaces de agentes de voz. Transcreve uma ampla variedade de idiomas e funciona como uma opção econômica para transcrição. - Conversa em tempo real —
qwen3.5-omni-flash-realtime,qwen3-omni-flash-realtime,qwen3.5-omni-plus-realtime. Este é o núcleo da solução: áudio — e frames de vídeo — entram; texto e fala sintetizada saem por uma conexão persistente, mantida entre turnos em vez de ser reaberta a cada solicitação. - Saída de voz —
Qwen-TTS-Realtime. Um modelo dedicado de conversão de texto em fala por streaming, útil quando você só precisa transformar texto em voz, como ao ler a resposta gerada por um LLM textual.
Ao usar um modelo omni Realtime na camada central, em muitos casos não é preciso fazer chamadas separadas de ASR e TTS: ele cuida da fala de entrada e de saída de ponta a ponta. Os modelos separados existem para cenários em que você quer combinar componentes, como usar seu próprio STT com o TTS da Qwen.
Especificações que fazem diferença na prática
Estes são os números da documentação Realtime do Model Studio, e não de páginas de marketing.
| Atributo | Qwen Realtime API (família omni) |
|---|---|
| Entrada de áudio | PCM, 16 kHz |
| Saída de áudio | PCM, 24 kHz |
| Outras entradas | Frames de imagem / vídeo (JPG, até 1080p, 256 KB após a codificação) |
| Reconhecimento de fala | 113 idiomas e dialetos (API hospedada) |
| Geração de fala | 36 idiomas e dialetos |
| Vozes | 55 no total (47 multilíngues, 8 dialetais), além de clonagem de voz nos modelos 3.5 |
| Conexões | WebSocket (autenticação Bearer, VAD manual ou no servidor) e WebRTC (negociação SDP) |
| Duração máxima da sessão | 120 minutos via WebSocket |
| Recursos extras | Interrupção semântica, function calling, busca autônoma na web, controles de voz para volume / velocidade / emoção |
Alguns desses pontos merecem destaque. A interrupção semântica permite que o modelo diferencie uma interrupção real de uma simples sinalização de escuta, como um “aham”. Essa distinção separa um agente de voz natural de um agente irritante. O suporte a WebRTC é especialmente relevante em aplicações de navegador, pois ele cuida de cancelamento de eco e jitter. E o número de 113 idiomas de reconhecimento vale para a API hospedada; a versão de pesos abertos oferece um conjunto menor, como detalhado adiante.
Sobre latência: o fluxo de streaming dedicado do Qwen-TTS-Realtime mira cerca de 97 ms de latência até o primeiro pacote, segundo a documentação de streaming do Qwen3-TTS. É esse tipo de métrica que define se a fala parece imediata. O valor representa o tempo até o primeiro trecho de áudio, não a resposta completa. No ciclo conversacional completo, a arquitetura Thinker–Talker foi projetada para streaming; o relatório técnico do Qwen3-Omni descreve um design multi-codebook focado em reduzir latência, enquanto testes da comunidade situam a resposta de áudio para áudio na faixa de menos de 250 ms, com full duplex e turnos interrompíveis. Os resultados reais variam conforme região, rede e carga. Meça no seu próprio tráfego em vez de depender de um único número de destaque.
Preços do áudio em tempo real da Qwen, sem rodeios
Os preços hospedados de tempo real da Qwen são consideravelmente menores que os das APIs fechadas de tempo real. As tarifas abaixo são por milhão de tokens, para entrada / saída, conforme listadas no diretório de modelos DashScope da Portkey, um agregador de terceiros que espelha as tarifas da Alibaba. Antes de assumir qualquer compromisso, confirme o valor vigente no console do Model Studio:
| Modelo | Entrada / 1M tok | Saída / 1M tok |
|---|---|---|
qwen-omni-turbo-realtime | $0.27 | $1.07 |
qwen3-omni-flash-realtime | $0.52 | $1.99 |
qwen3-asr-flash (transcrição) | $0.04 | $0.04 |
Quanto isso representa por chamada. Áudio consome muitos tokens: cerca de 427 tokens por minuto de áudio. Imagine uma conversa de voz de 10 minutos, com 5 minutos de fala do usuário e 5 minutos de resposta do modelo. No qwen3-omni-flash-realtime, isso equivale a aproximadamente 2.135 tokens de entrada e 2.135 de saída: cerca de $0.001 de entrada + $0.004 de saída ≈ meio centavo por chamada de 10 minutos. Mesmo em escala, áudio em tempo real é barato. O custo que costuma surpreender é o tempo de fala na saída, pois respostas faladas custam cerca de 4x mais que a entrada.
Antes de fechar o orçamento, considere mais dois pontos:
- Há uma cota gratuita, mas ela depende da região. O endpoint de Singapura, internacional, já ofereceu 1 milhão de tokens de entrada e 1 milhão de tokens de saída gratuitos por 90 dias; o endpoint dos EUA não. As cotas podem mudar, então confira a oferta atual no console do Model Studio da sua região antes de incluí-la no planejamento.
- A camada
qwen3.5-omniusa faixas de preço por tamanho de solicitação, e não uma tarifa fixa. Por isso, uma solicitação grande com muito contexto pode cair em uma faixa diferente de várias solicitações pequenas. Teste isso com o padrão real do seu tráfego antes de se comprometer.
Qwen versus OpenAI Realtime e Gemini Live
Entre os fornecedores de LLMs de fronteira para uso geral, as três opções evidentes de fala para fala em tempo real em meados de 2026 são a Realtime API da OpenAI, o Gemini Live do Google e a família omni Realtime da Qwen. Provedores especializados em voz, como ElevenLabs, Deepgram, Cartesia e Hume, também competem fortemente em TTS e STT; esta comparação, porém, trata da rota de modelos multimodais completos. Em vez de citar preços de concorrentes que mudam mensalmente, veja como analisar a decisão:
- Custo. Pelas tarifas por chamada mostradas acima, o preço de tempo real da Qwen fica na ponta mais baixa entre as opções hospedadas de modelos de fronteira. Como contraste, o áudio Realtime da OpenAI já ficou em torno de $0.06 por minuto de entrada e $0.24 por minuto de saída (veja aqui o detalhamento de preços); nessa base, a mesma chamada de 10 minutos que custa cerca de meio centavo no
qwen3-omni-flash-realtimechega perto de $1.50 na OpenAI. Confirme os valores atuais dos dois lados antes de contar com essa diferença, pois todos podem mudar, mas a distância é grande. A Qwen também é a única das três com uma versão de pesos abertos, que pode ser auto-hospedada para levar o custo marginal próximo de zero. - Abertura. OpenAI Realtime e Gemini Live são APIs fechadas. O Qwen3-Omni oferece pesos abertos, permitindo migrar do serviço hospedado para a infraestrutura própria sem reescrever a aplicação em torno do comportamento de outro modelo.
- Qualidade. Cobertura de terceiros informa que a camada superior
qwen3.5-omni-plusiguala ou supera o Gemini 3.1 Pro em alguns benchmarks de compreensão de áudio. Trate qualquer benchmark isolado como hipótese inicial e valide com seus próprios áudios. - Ecossistema. OpenAI e Google têm ferramentas, SDKs e exemplos da comunidade mais maduros hoje. A documentação da Qwen é sólida, mas você dependerá mais diretamente da especificação bruta de WebSocket/WebRTC.
Na prática: se custo ou a possibilidade de auto-hospedagem são importantes, a Qwen é a escolha mais forte. Se você busca a experiência de SDK mais madura e aceita pagar por ela, as opções da OpenAI e do Google ainda lideram em refinamento. Para uma análise completa de custos das alternativas fechadas, consulte as leituras relacionadas abaixo.
Qual variante escolher?
| Sua necessidade | Use |
|---|---|
| Loop completo de voz hospedado mais barato | qwen3-omni-flash-realtime |
| Melhor qualidade hospedada, sessões mais longas e clonagem de voz | qwen3.5-omni-plus-realtime |
| Você precisa apenas de transcrição | qwen3-asr-flash |
| Você precisa apenas de texto para fala | Qwen-TTS-Realtime |
| Os dados precisam permanecer no seu próprio hardware | Auto-hospede o Qwen3-Omni de pesos abertos (30B-A3B) |
As camadas 3.5 adicionam clonagem de voz e limites maiores de contexto e diálogo — até 100 turnos e 600 segundos de áudio retido — em comparação com o mais enxuto qwen3-omni-flash, que suporta 8 turnos. Em um protótipo, comece pelo Flash; migre para o Plus apenas quando encontrar um limite concreto.
Como acessar
Hospedado, pelo caminho direto. Crie uma chave de API no Alibaba Cloud Model Studio e abra uma conexão WebSocket com autenticação Bearer. Para aplicações de navegador, você também pode negociar WebRTC com um POST SDP. O fluxo envia áudio PCM e recebe áudio PCM e texto. Se preferir não gerenciar o socket manualmente, o SDK Python do DashScope encapsula a interface Realtime. A conexão básica é curta, apenas como esboço e sem tratamento de erros:
import os, json, base64, websocket

MODEL = "qwen3-omni-flash-realtime"
url = f"wss://dashscope-intl.aliyuncs.com/api-ws/v1/realtime?model={MODEL}"
ws = websocket.create_connection(
    url, header=[f"Authorization: Bearer {os.environ['DASHSCOPE_API_KEY']}"]
)

# 1. configure the session: voice, output format, server-side turn detection
ws.send(json.dumps({
    "type": "session.update",
    "session": {
        "voice": "Cherry",
        "output_audio_format": "pcm24",
        "turn_detection": {"type": "server_vad"},
    },
}))

# 2. stream microphone audio up as base64 PCM 16 kHz frames
ws.send(json.dumps({
    "type": "input_audio_buffer.append",
    "audio": base64.b64encode(pcm_frame).decode(),
}))

# 3. read events back; response.audio.delta carries PCM 24 kHz to play
while True:
    event = json.loads(ws.recv())
    if event["type"] == "response.audio.delta":
        play(base64.b64decode(event["audio"]))
Com VAD no servidor, o modelo decide quando o usuário terminou de falar; use o modo manual se quiser controlar as fronteiras entre turnos. O fluxo de eventos segue de perto o formato do OpenAI Realtime, então clientes Realtime existentes podem ser adaptados com poucas alterações. Antes de colocar em produção, confira os nomes exatos dos campos, a lista de vozes e o host do endpoint regional na documentação Realtime, pois eles variam entre as implantações de Singapura e dos EUA e evoluem junto com a API.
Auto-hospedado. O Qwen3-Omni de pesos abertos adota uma arquitetura Thinker–Talker Mixture-of-Experts, com 30B de parâmetros totais e cerca de 3B ativos. A Alibaba recomenda usar vLLM em vez de Transformers puro. Para inferência BF16 do modelo completo de 30B, guias de implantação de terceiros indicam como mínimo uma única placa de 80GB, A100 ou H100. Uma placa de 24 GB, como a RTX 4090, não comporta os pesos completos, embora versões quantizadas reduzam essa exigência.
O ponto de atenção é que servir em tempo real é mais difícil do que rodar inferência em lote. Pessoas que hospedam o modelo relatam a necessidade de limitar o cache KV para evitar travamentos sob carga concorrente, além de throughput de tokens em uma única placa inferior ao da API hospedada. Pilhas de serving otimizadas para streaming reduzem boa parte dessa diferença: engenheiros que trabalham com Red Hat AI e vLLM relataram que sobrepor as etapas do pipeline reduz a geração de fala para um clipe de 3 segundos de aproximadamente 8 segundos para cerca de 0.5. É um ganho real, mas exige engenharia adicional. A auto-hospedagem remove o custo por token, mas acrescenta custos de GPU e operação; por isso, faz mais sentido para volume alto e estável do que para protótipos.
Hoje, para voz omni em tempo real, o endpoint DashScope é o caminho canônico. Se sua pilha já encaminha diversos provedores por um único gateway, um agregador pode ficar à frente dele. Antes, porém, confirme que os IDs específicos dos modelos Realtime da Qwen estão no catálogo: muitos intermediários oferecem modelos de texto e imagem, mas não a camada de áudio em tempo real.
Limites para considerar antes de desenvolver
- As sessões têm limite de 120 minutos. Para algo mais longo, como uma linha de suporte ou uma sessão extensa de tutoria, será preciso implementar reconexão que transporte o contexto entre sockets.
- A região afeta tanto a cota gratuita quanto a disponibilidade. Teste no endpoint em que você realmente pretende implantar, e não apenas naquele usado no primeiro cadastro.
- A versão hospedada e a de pesos abertos não são idênticas. A API hospedada anuncia reconhecimento em 113 idiomas e geração em 36; a versão de Qwen3-Omni com pesos abertos cobre um conjunto menor, com 19 idiomas de entrada de fala e 10 de saída. Se um idioma específico for requisito, valide na variante exata que será usada em produção.
- O custo em tempo real acompanha o tempo de fala, não a quantidade de solicitações. Como áudio consome muitos tokens, um usuário falante custa mais do que um usuário conciso. Projete sua fatura com base em minutos de conversa, não no número de chamadas.
Perguntas frequentes
O Qwen 3 aceita áudio?
Sim. Os modelos Qwen3-Omni são multimodais nativos: recebem áudio, texto, imagens e vídeo como entrada e podem responder com texto ou fala em tempo real.
O Qwen consegue gerar áudio, e não apenas compreendê-lo?
Sim. Diferentemente do Qwen-Audio original, que gerava somente texto, os modelos omni Realtime e o Qwen-TTS-Realtime produzem áudio falado, incluindo vozes clonadas na camada 3.5.
O áudio em tempo real da Qwen é gratuito?
Existe uma cota de teste gratuita, historicamente de 1 milhão de tokens de entrada e 1 milhão de tokens de saída por 90 dias no endpoint internacional de Singapura. Depois disso, a cobrança é por token. O Qwen3-Omni totalmente aberto pode ser executado gratuitamente se você fornecer sua própria GPU.
Como executar o áudio da Qwen localmente?
Baixe o Qwen3-Omni de pesos abertos, na versão 30B-A3B, e sirva o modelo com vLLM. Para o modelo completo em BF16, você precisará de aproximadamente uma placa de 80GB, A100 ou H100; GPUs de consumo menores lidam apenas com versões quantizadas, não com os pesos completos.
Leituras relacionadas
Fontes primárias:
- Documentação da API Realtime do Alibaba Model Studio
- Model card e pesos abertos do Qwen3-Omni (GitHub)
Como as alternativas se comparam em preço: