 AIREITER
Muse Spark 1.2 em resumo
A Meta lançou o Muse Spark 1.2 em 5 de agosto de 2026, com resultados melhores em benchmarks de programação do que o 1.1 e um novo agente de terminal feito para rodá-lo. Mesmo assim, perdeu para o Claude Opus 5 nos três rankings de código. Essa é, essencialmente, a história do lançamento. A evolução existe: a Meta ampliou o processamento de treinamento voltado a código, co-treinou o modelo com seu agente Muse Code e os números subiram. Mas parte do salto entre versões vem do novo harness, não apenas do modelo. E, em Terminal-Bench, DeepSWE e na própria avaliação interna de código da Meta, o modelo da Anthropic continua na frente por 4 a 9 pontos.
O preço ainda torna o modelo atraente. A tabela standard manteve os US$ 1,25/US$ 4,25 por milhão de tokens, enquanto o plano contributor reduz esse valor em cerca de 12x. Só que há uma contrapartida: no caminho padrão, seu código alimenta o treinamento da Meta. Além disso, no maior nível de esforço de raciocínio, o tempo até o primeiro token piorou em aproximadamente nove vezes. Para quem avalia o Muse Spark 1.2 em um fluxo de desenvolvimento em produção, esses dois pontos pesam mais que a posição no leaderboard.
O que mudou de fato em relação ao 1.1
O Muse Spark 1.2 é uma atualização focada em programação do modelo de raciocínio de ponta da Meta, lançada em 5 de agosto junto do Muse Code, um agente de código baseado em terminal que está em beta. A própria Meta descreve a versão como uma "melhoria moderada" sobre o Muse Spark 1.1. É uma formulação deliberadamente contida para uma atualização concentrada justamente nas tarefas mais exigentes para agentes de código: refatorações em vários arquivos, sessões longas de depuração e trabalhos que vão muito além de um único prompt.
Dois aspectos do treinamento explicam o avanço. Primeiro, o Muse Code participou do ciclo desde o início. A Meta co-treinou o modelo com trajetórias de harness selecionadas por rejection sampling, ajustando-o para render melhor dentro do próprio agente. Segundo a empresa, o treinamento envolveu vários harnesses, então o modelo continua generalizando para outras ferramentas de programação. Além disso, a Meta aplicou um ciclo de autoaperfeiçoamento: o Muse Spark 1.1 criou ambientes desafiadores de código e modelos de instruções, depois avaliou soluções candidatas contra eles, formando o conjunto de treinamento do 1.2. A Meta atribui a esse ciclo a melhora mensurável do 1.2 no seguimento de instruções complexas.
A atualização mira o ponto mais fraco da família Muse. Quando o Muse Spark estreou, em abril de 2026, ficou atrás em programação agentiva, com 77,4 no SWE-Bench Verified, ante 80,8 do Claude Opus 4.6. Um checkpoint especializado em código, combinado a um harness criado para esse fim, é a resposta direta a essa lacuna, preservando ao mesmo tempo a capacidade agentiva mais geral.
Como interpretar os benchmarks sem maquiagem
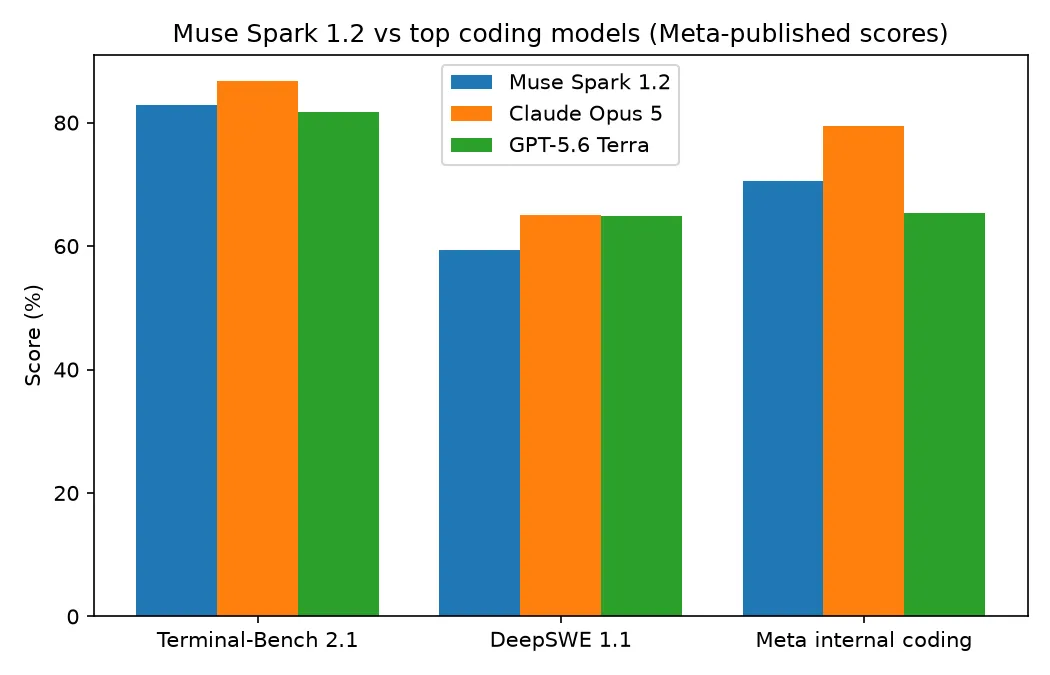
No Terminal-Bench 2.1, o Muse Spark 1.2 rodando no Muse Code atingiu 82,9%, superando o GPT-5.6 Terra no Codex, com 81,8%, e o Grok 4.5 no Grok Build, com 81,6%. Porém, ficou atrás do Claude Opus 5 no esforço máximo dentro do Claude Code, que lidera com 86,7%. No DeepSWE 1.1, marcou 59,3% e ficou em terceiro, atrás do Opus 5, com 65,0%, e do GPT-5.6 Terra, com 64,8%. A avaliação interna de código da Meta é a mais transparente das três: os 70,6% do Muse Spark 1.2 superam o GPT-5.6 Terra, com 65,4%, e o Gemini 3.6 Flash, com 63,9%, mas ainda ficam quase nove pontos abaixo dos 79,4% do Opus 5. Claude lidera os três gráficos.
Os ganhos geracionais são concretos: o Muse Spark 1.2 melhora 6,7 pontos sobre o 1.1 no Terminal-Bench e 6,3 no DeepSWE. Mas há um detalhe nos rótulos dos gráficos que importa para quem compara as versões. As pontuações do 1.1 foram registradas em um harness genérico mini-swe-agent, enquanto o 1.2 rodou no Muse Code. Parte desse avanço, portanto, pertence ao novo harness, e não somente ao modelo. No Intelligence Index combinado da Artificial Analysis, o 1.2 marca 54, ficando em 14º entre 186 modelos, contra uma mediana de classe de 32. É uma alta em relação aos 51 do 1.1, bem mais discreta do que os gráficos de programação sugerem.
A comparação direta com Claude e GPT é justamente o que potenciais compradores seguem perguntando. No Reddit, um desenvolvedor resumiu a dúvida antes de existir qualquer dado do 1.2:
"Alguém já usou o MUSE Spark 1.1 da Meta? Tenho curiosidade de saber como ele se compara a Claude e GPT em raciocínio, programação, velocidade, precisão e contexto."
Os benchmarks do 1.2 são a primeira resposta rigorosa a essa pergunta: ele é competitivo, claramente o segundo colocado em programação e supera as opções GPT-5.6 e Gemini na maioria dos gráficos.
Dois pontos que pesam no uso em produção
Dois fatores práticos definem se o Muse Spark 1.2 se encaixa em um fluxo de trabalho real — e nenhum deles aparece na posição de um leaderboard.
O retrocesso de latência no xhigh
O Muse Spark é um modelo de raciocínio. Ele pensa antes de responder, e não há como desligar isso. O controle /effort oferece cinco níveis, de minimal a xhigh, e os tokens de raciocínio são cobrados como saída. No topo, o custo é alto em dois sentidos. Medições independentes publicadas pela OrcaRouter mostram que o tempo até o primeiro token saltou de 2,90 segundos no 1.1 para 26,12 segundos no xhigh — cerca de nove vezes mais —, enquanto a velocidade de saída caiu de 213,5 para 165,0 tokens por segundo. Rodar a avaliação Intelligence Index da Artificial Analysis no 1.2 custou US$ 637,85, alta de 16% sobre os US$ 548,07 do 1.1, apenas porque o modelo delibera mais. Em programação interativa, com um desenvolvedor aguardando a resposta, o esforço máximo troca latência por precisão de um jeito que muitas vezes não compensa.
O plano contributor dá desconto em troca do seu código
A Meta oferece o Muse Spark 1.2 em dois planos, e o que ela apresenta primeiro para novos usuários vem com uma condição. O plano contributor custa US$ 0,10/US$ 0,20 por milhão de tokens de entrada/saída, contra US$ 1,25/US$ 4,25 no standard. Isso o torna cerca de 12x mais barato na entrada e 21x na saída, com entrada em cache praticamente gratuita, a US$ 0,002. Em troca, você concede explicitamente à Meta o direito de usar seus prompts e conclusões para treinar modelos futuros. É a menor tarifa da comparação acima; o pagamento vem na forma dos seus dados.
O fluxo padrão de entrada no Muse Code coloca desenvolvedores nesse plano. Em testes relatados pela VentureBeat, o instalador de uma linha funcionou em um Mac mini — download de 97 MB e login —, mas o agente não chegou a executar nada: informou que não havia modelos visíveis e exigiu uma forma de pagamento mesmo no plano com desconto. Baixo custo, sim; gratuito, não. Os limites de taxa também são mais restritos: 60 solicitações por minuto, contra 3.000 no standard. É um sinal claro de que a oferta mira indivíduos e prototipagem, não produção. Equipes com bases de código proprietárias precisam migrar conscientemente para a tabela standard ou solicitar retenção zero de dados à área comercial da Meta.
Preços em contexto: onde o Muse Spark se posiciona
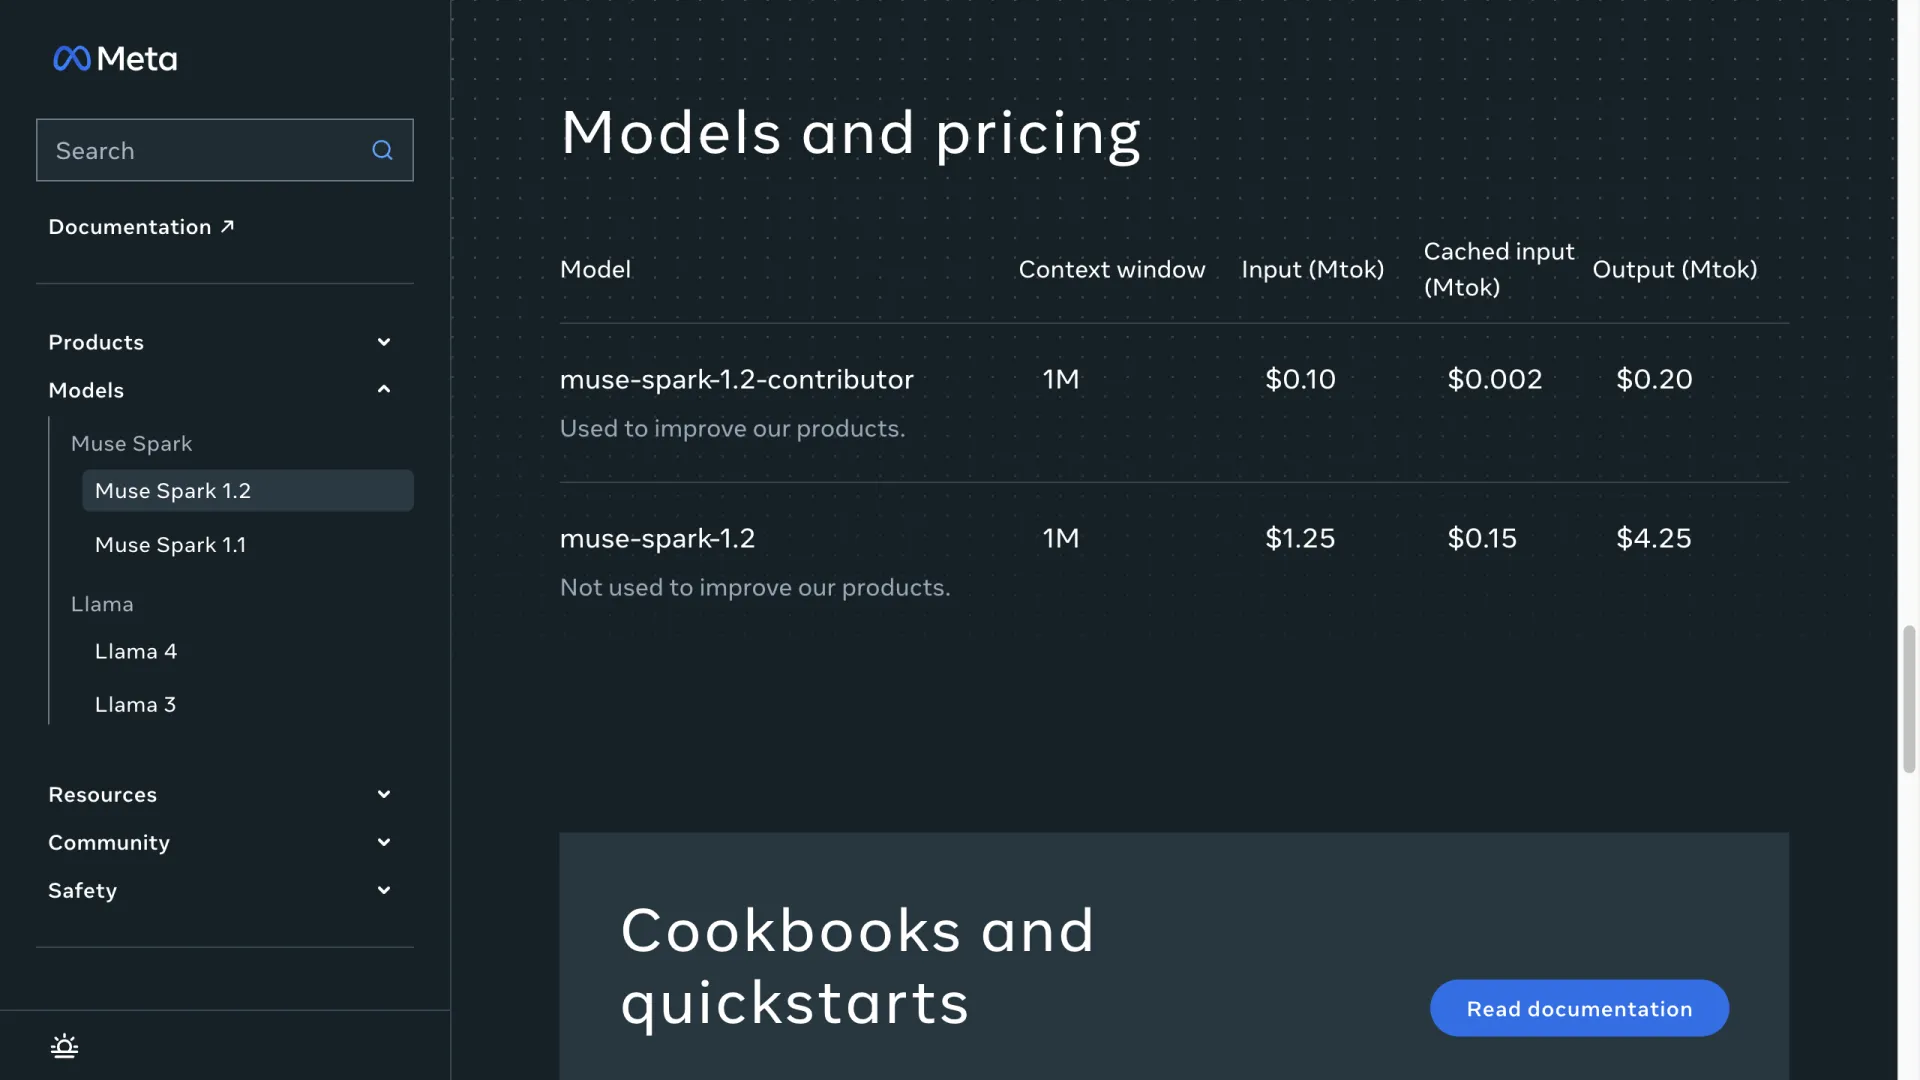
O plano standard do Muse Spark 1.2 — US$ 1,25 por milhão de tokens de entrada, US$ 0,15 para cache, US$ 4,25 de saída, janela de contexto de 1M de tokens e sem tarifa adicional para contexto longo — fica na faixa intermediária inferior do mercado de modelos para código. É consideravelmente mais barato que os líderes de programação de ponta: Claude Opus 5, a US$ 5/US$ 25, e GPT-5.5, a US$ 5/US$ 30, custam cerca de 4 a 7x mais na saída. Ele praticamente empata em preço com o GLM-5.2 da Z.ai, a US$ 1,40/US$ 4,40, e fica abaixo do Grok 4.5, a US$ 2/US$ 6. Na ponta mais barata, o DeepSeek V4 Pro, a US$ 0,435/US$ 0,87, custa várias vezes menos, assim como o próprio plano contributor do Muse Spark.
| Modelo | Entrada US$/M | Saída US$/M | Cache US$/M | Contexto |
|---|---|---|---|---|
| Muse Spark 1.2 (standard) | 1.25 | 4.25 | 0.15 | 1M |
| Muse Spark 1.2 (contributor)* | 0.10 | 0.20 | 0.002 | 1M |
| Claude Opus 5 | 5.00 | 25.00 | — | — |
| GPT-5.5 | 5.00 | 30.00 | — | — |
| GLM-5.2 | 1.40 | 4.40 | — | — |
| Grok 4.5 | 2.00 | 6.00 | — | — |
| DeepSeek V4 Pro | 0.435 | 0.87 | — | — |
\*o plano contributor concede à Meta direitos para treinar com seus dados; limite de 60 req/min.
Onde acessar — e o que usar agora
O Muse Spark 1.2 está disponível em três lugares: na Meta Model API, no agente de terminal Muse Code e na OpenRouter. Ele ainda não chegou a todos os agregadores — o catálogo da AIReiter, consultado em 6 de agosto de 2026, não o lista. Se sua stack depende de uma API unificada e você precisa de um modelo de código hoje, a escolha fica entre as opções já roteadas.
A alternativa disponível hoje com faixa de preço mais próxima é o GLM-5.2, a US$ 1,40/US$ 4,40. Em 6 de agosto de 2026, rodei uma tarefa única de raciocínio para programação no glm-5.2, encaminhado pela API da plataforma, para verificar o que a opção "disponível hoje" entrega: uma função Python de saque que não tinha a verificação de cheque especial. O GLM-5.2 respondeu em 3,2 segundos, com 85 tokens de prompt e 128 de conclusão, identificou corretamente a falta da validação de saldo, gerou a correção (if amount > 0 and account_balance >= amount:) e escreveu um teste que falha antes da correção e passa depois. É uma única tarefa, não um benchmark, mas é um modelo funcional para programação na mesma faixa de preço e que pode ser chamado agora. DeepSeek V4 Pro, Kimi K3, Claude Sonnet 5 e a família GPT-5.6 completam as opções capazes de programar que já constam no catálogo da AIReiter.
Vale usar o Muse Spark 1.2?
A resposta depende de qual aspecto você quer otimizar. Na prática, a decisão se divide em três cenários.
Escolha o Muse Spark 1.2 se você precisa programar em escala com sensibilidade a preço — grandes refatorações entre arquivos, depurações longas e tarefas agentivas de horizonte extenso — e aceita usar diretamente Meta, Muse Code ou OpenRouter. Por US$ 1,25/US$ 4,25, ele entrega capacidade de programação de classe frontier a preço intermediário, e a janela de 1M de tokens com compactação de contexto é adequada para trabalhos que ultrapassam um único prompt. Mantenha o esforço de raciocínio abaixo de xhigh, salvo se sua tarefa puder absorver um primeiro token em 26 segundos.
Escolha o Claude Opus 5 se você precisa do melhor desempenho nos rankings de programação. Ele lidera os três benchmarks em que o Muse Spark 1.2 aparece. Você paga de 4 a 6x mais por token para ter essa vantagem de precisão.
Escolha um modelo já presente no seu agregador se você precisa colocar algo em produção hoje e o Muse Spark ainda não está na sua plataforma. O GLM-5.2 oferece a mesma faixa de preço sem espera; o DeepSeek V4 Pro é ainda mais barato quando o custo bruto é o fator dominante.
Perguntas frequentes
O Muse Spark 1.2 é melhor que o Claude Opus 5 para programação?
Não. O Claude Opus 5 lidera os três benchmarks de código publicados pela Meta — Terminal-Bench 2.1, DeepSWE 1.1 e a avaliação interna de código da Meta — com margens de 3,8 a 9 pontos. O Muse Spark 1.2 é um segundo colocado claro e supera o GPT-5.6 Terra e o Gemini 3.6 Flash na maioria dos gráficos.
O Muse Spark 1.2 é open source?
Não. Diferentemente da família Llama da Meta, o Muse Spark é proprietário: disponível apenas na nuvem, sem pesos para download e sem possibilidade de auto-hospedagem. Mark Zuckerberg disse que terá "mais a compartilhar" sobre possíveis lançamentos open source, mas o 1.2 chega sem pesos e sem licença.