 AIREITER
O MuseTalk roda em uma GPU de notebook com 4 GB: o README oficial registra cerca de cinco minutos para processar um clipe de oito segundos em uma RTX 3050 Ti Laptop usando FP16. A diferença entre “funciona” e “funciona rápido o suficiente” é o ponto central ao avaliar o MuseTalk lipsync — e ela volta a aparecer na resolução, na instalação e na tabela de custos abaixo.
O que o MuseTalk altera no vídeo — e o que permanece intacto
O MuseTalk repinta a boca e a parte inferior do rosto em um vídeo existente para sincronizar os lábios com uma faixa de áudio fornecida. A posição da cabeça, o movimento dos olhos, a expressão facial, o fundo e os movimentos da câmera não são regenerados; tudo isso vem do vídeo original. É uma edição localizada, não um gerador de talking heads: você já precisa ter uma gravação em que o rosto apareça claramente.
A velocidade vem da arquitetura. O repositório, publicado pelo Lyra Lab da Tencent Music, codifica o rosto mascarado com um VAE sd-vae-ft-mse congelado, extrai as características do áudio com um modelo Whisper-tiny congelado e combina as duas informações por meio de cross-attention em uma UNet baseada no Stable Diffusion v1.4. Em vez de executar um processo iterativo de remoção de ruído, o modelo faz inpainting no espaço latente em uma única etapa. É assim que os autores chegam a uma taxa declarada de 30 fps ou mais em uma NVIDIA Tesla V100.
O que a região facial de 256x256 representa em um vídeo-fonte em 1080p
O valor 256x256 indica o tamanho da região editável do rosto, não a resolução final do vídeo. Um clipe em 1080p continua saindo em 1080p e na taxa de quadros original, mas com um patch de 256x256 regenerado e mesclado sobre a área da boca. Por isso, quanto menor o rosto aparecer no enquadramento, mais o resultado tende a se sustentar. Em um close fechado, a suavidade fica evidente contra o restante do rosto, que permanece nítido.
Há duas formas de amenizar o problema, ambas com algum custo. Remover --use_float16 melhora a qualidade, mas exige mais VRAM e aumenta o tempo de processamento. Outra opção é passar o clipe final pelo GFPGAN ou pelo CodeFormer para restauração facial. Isso deixa a região da boca mais nítida, mas acrescenta uma etapa de processamento e pode alterar sutilmente a aparência da pessoa.
Qualidade em números: onde o MuseTalk leva vantagem e onde o Wav2Lip ainda ganha
A principal vantagem declarada do MuseTalk está na qualidade da imagem, não na precisão bruta da sincronização. No conjunto de dados HDTF, o relatório técnico do MuseTalk registra FID 6.43, contra 7.27 do DI-Net, 10.93 do VideoRetalking e 11.21 do Wav2Lip.
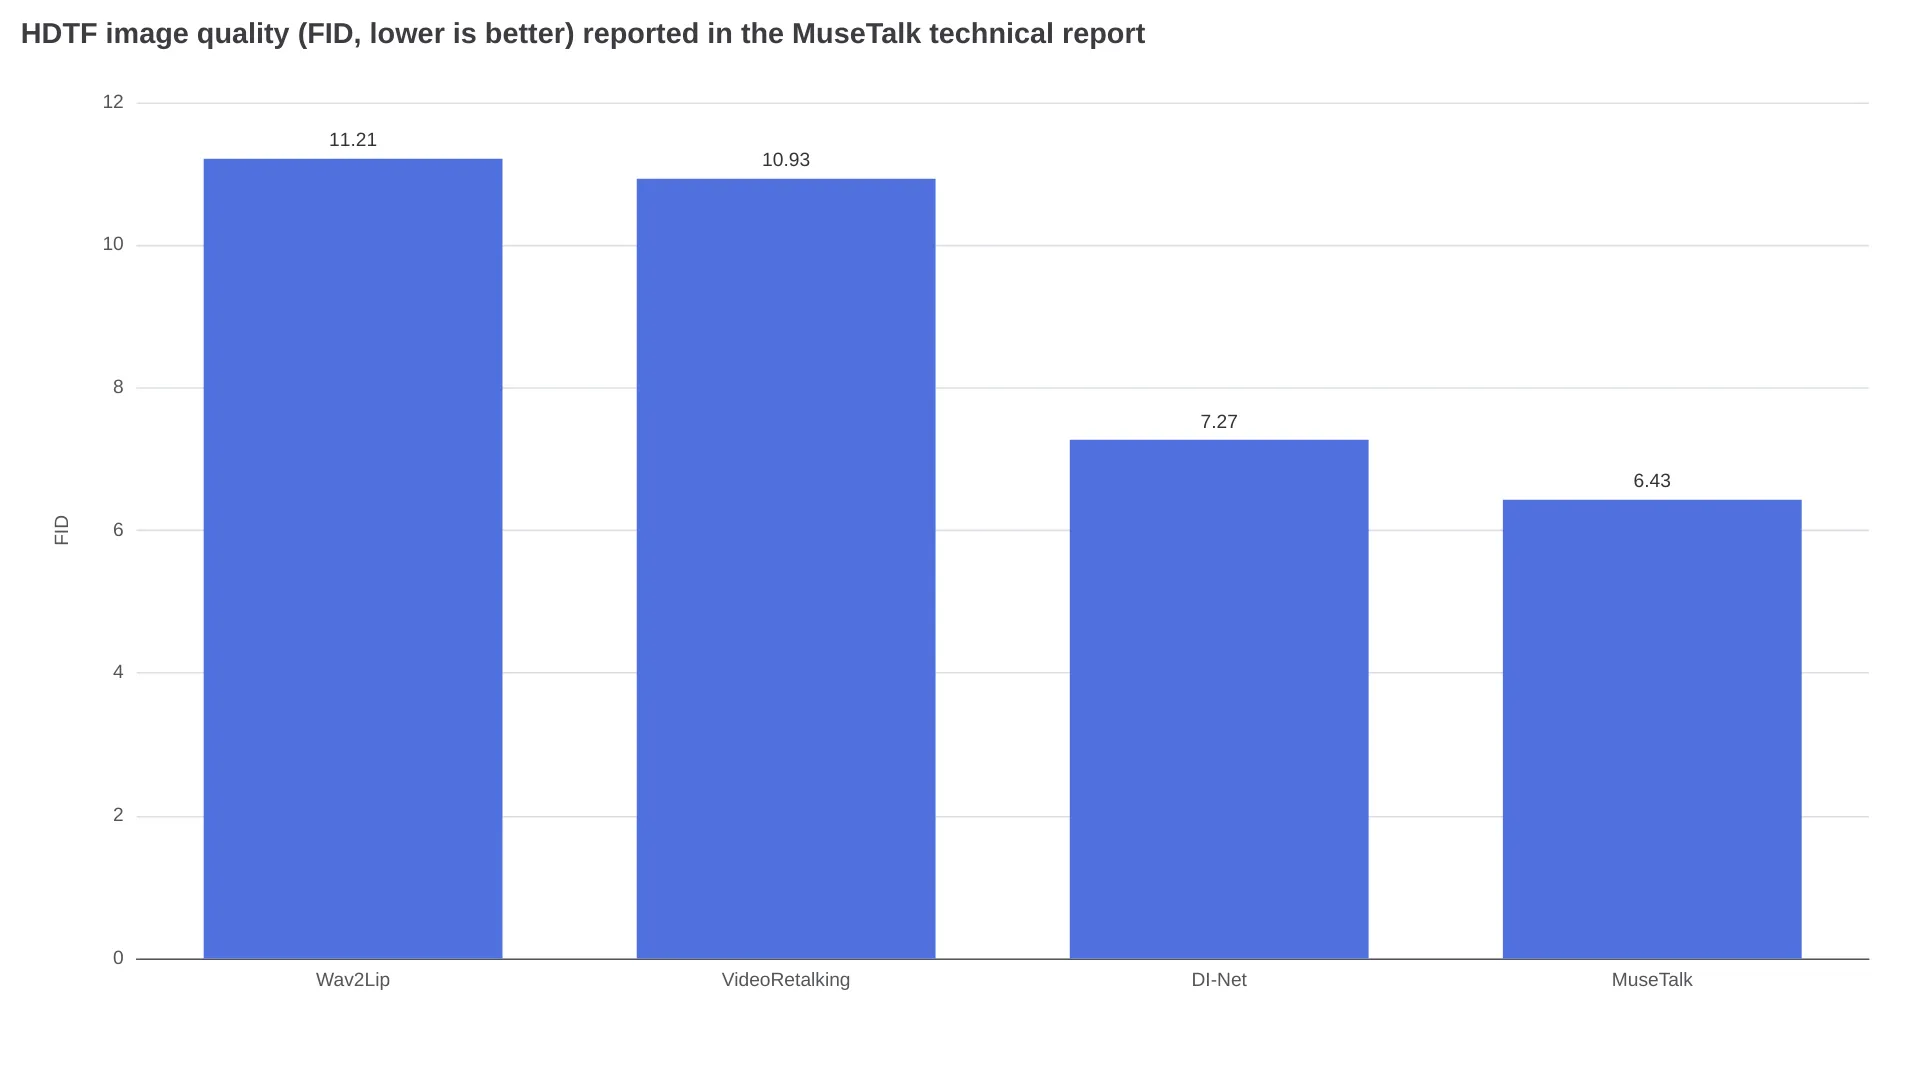
Quando a métrica é sincronização, a ordem muda. O mesmo relatório dá ao Wav2Lip um LSE-C de 7.46, contra 6.53 do MuseTalk. Por outro lado, o MuseTalk fica ligeiramente à frente em similaridade de identidade, com CSIM de 0.8225 versus 0.8184. Em resumo: o modelo GAN mais antigo acompanha melhor os lábios, enquanto o MuseTalk preserva melhor a fidelidade visual. O estudo com usuários apresentado no relatório também aponta para resultados apenas moderados: 3.62 de 5 em qualidade visual, 3.55 em identidade e 3.41 em sincronização labial.
Considerando o limite de 256x256, esses números descrevem um modelo convincente para planos médios, mas não algo que aguente sem perdas um close em 4K.
Quanto custa um minuto de lip sync
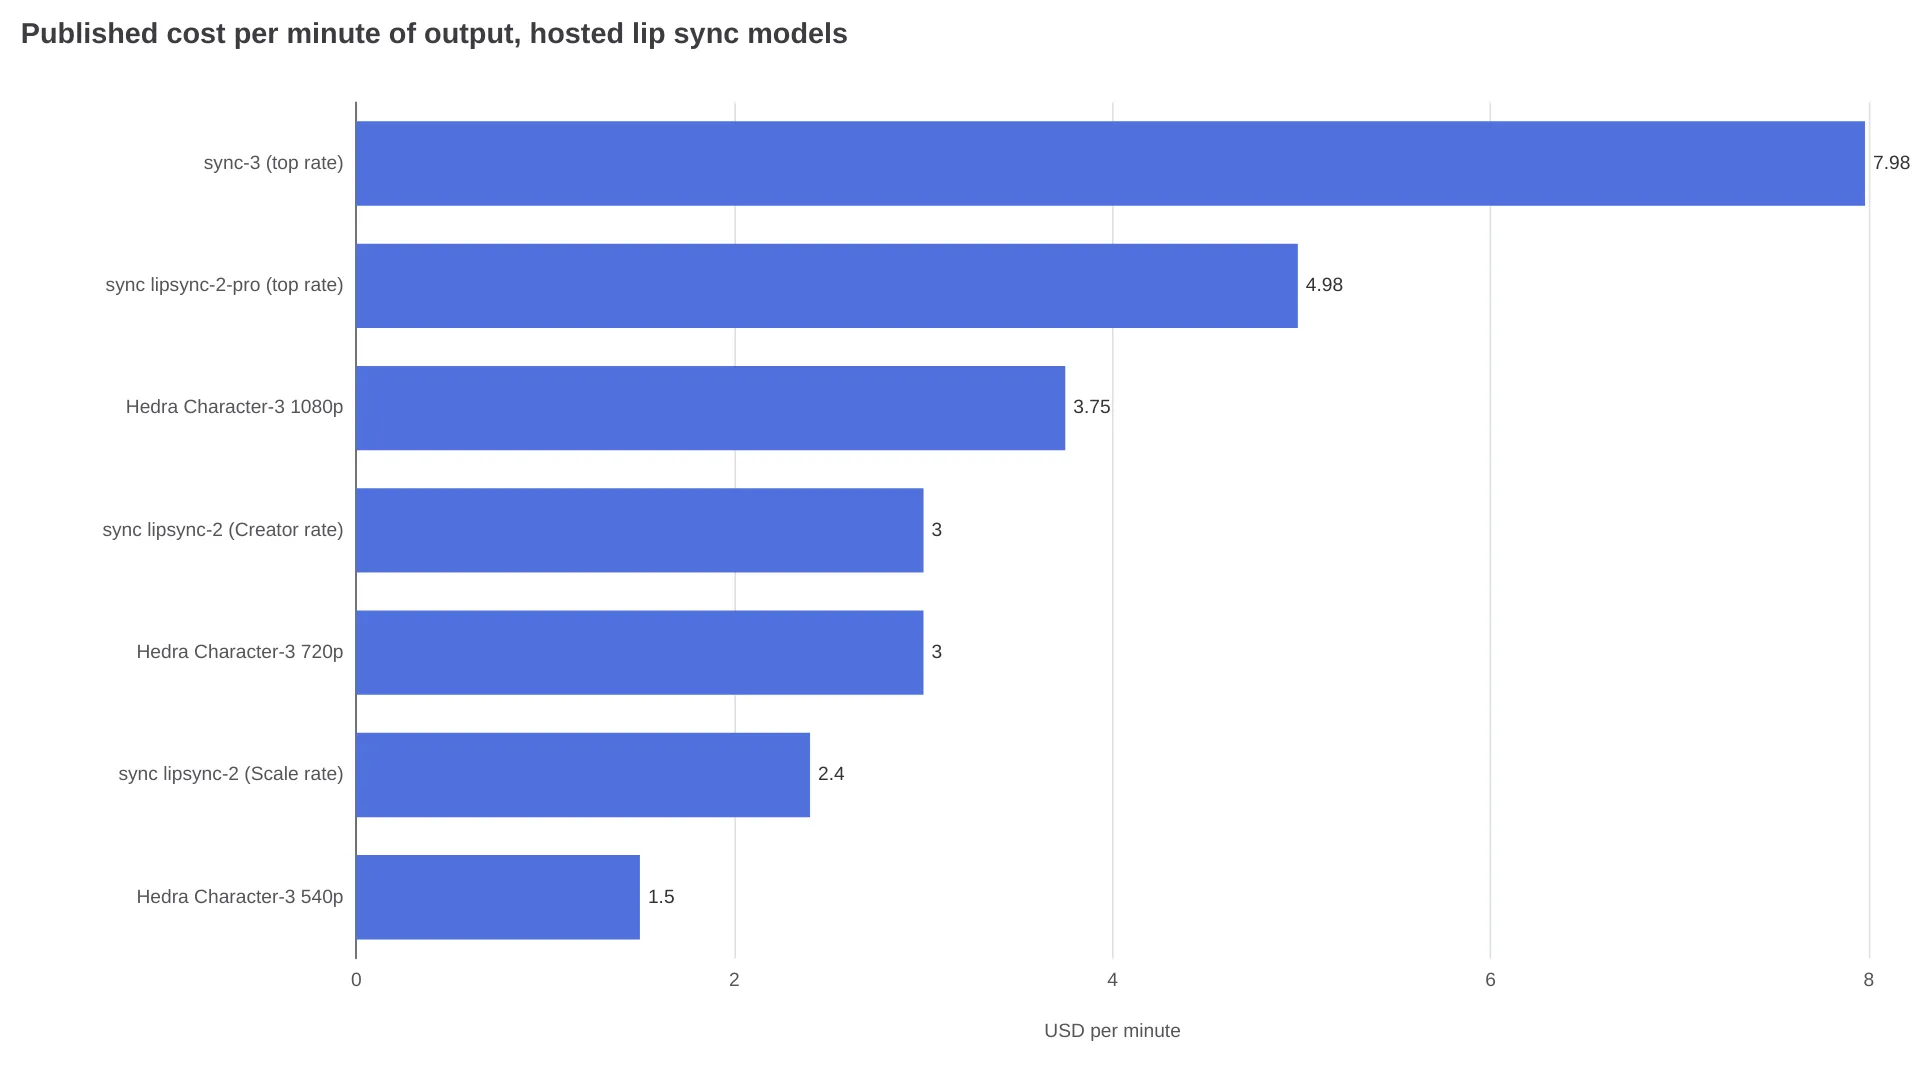
É aqui que a opção open source começa a fazer sentido. As tarifas publicadas para modelos hospedados de lip sync ficam entre US$ 1,50 e quase US$ 8,00 por minuto de saída.
| Opção | Tarifa publicada (as unidades de cobrança variam) | Por minuto de saída | Resolução facial |
|---|---|---|---|
| MuseTalk hospedado por conta própria, aluguel de Tesla V100 | US$ 0.188 / hora de GPU | ~US$ 0.006 a 2 minutos de GPU por minuto de clipe | 256x256 |
| MuseTalk no Replicate | ~US$ 0.052 / execução, com duração típica de 54 s segundo a página do modelo | Cobrado por execução, não por minuto | 256x256 |
| MuseTalk no fal.ai | Cobrado por segundo de computação | Não publicado na página do modelo | 256x256 |
| Hedra Character-3 540p / 720p / 1080p — image-to-video, não é um substituto direto para um vídeo existente | 2,5¢ / 5¢ / 6,25¢ por segundo | US$ 1.50 / US$ 3.00 / US$ 3.75 | n/a |
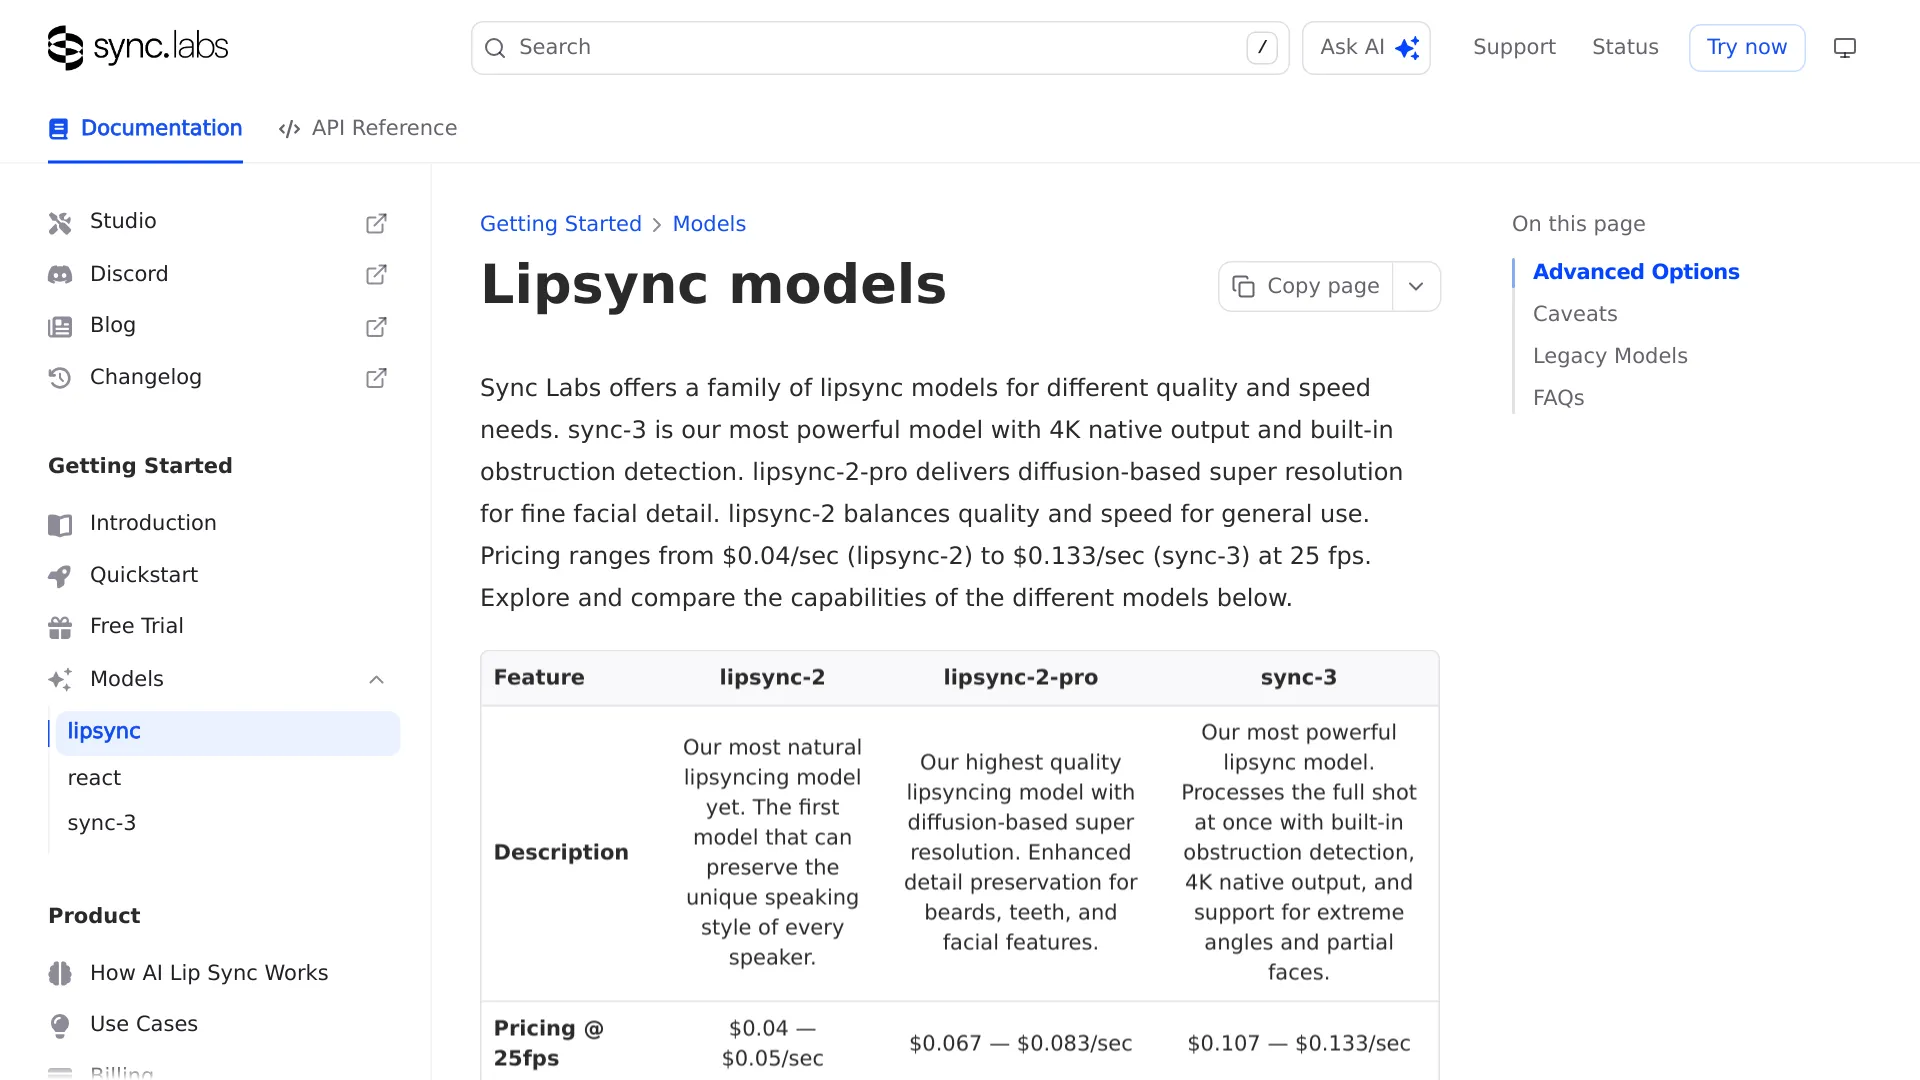
| sync lipsync-2 | US$ 0.04–0.05 / s a 25 fps | US$ 2.40–US$ 3.00 | 512x512 |
| sync lipsync-2-pro | US$ 0.067–0.083 / s | US$ 4.02–US$ 4.98 | 512x512 + etapa de detalhamento |
| sync-3 | US$ 0.107–0.133 / s | US$ 6.42–US$ 7.98 | 4K nativo |
O valor de hospedagem própria vem do guia de custos da NexGPU, que considera dois minutos de uso de GPU para cada minuto de clipe: inferência, detecção com DWPose, codificação e decodificação pelo VAE e muxing com FFmpeg. Cem clipes de um minuto custam cerca de US$ 0.63 em computação usando uma V100 a US$ 0.188 por hora, além de aproximadamente US$ 0.09 pelo tempo de configuração. São apenas valores de aluguel da GPU: engenharia, armazenamento e custos operacionais ficam de fora.
Quando você leva isso para uma fila de localização, a diferença aparece rapidamente. Quinhentos minutos de vídeo dublado custam cerca de US$ 3 em aluguel de GPU com o MuseTalk hospedado por conta própria, contra US$ 1.200 usando o sync lipsync-2 na tarifa Creator.
Onde a opção gratuita deixa de ser gratuita
O adicional cobrado por minuto compra vantagens bem específicas:
- Resolução da geração facial. Segundo a documentação dos modelos da sync, lipsync-2 e lipsync-2-pro geram rostos em 512x512, o dobro da região usada pelo MuseTalk. Já o sync-3 produz saída nativa em 4K, com super-resolução integrada.
- Cenas difíceis. A mesma documentação afirma que o sync-3 lida nativamente com rostos de perfil, enquadramentos por sobre o ombro e rostos parcialmente visíveis, além de detectar obstruções automaticamente. O MuseTalk faz a detecção facial quadro a quadro; por isso, um rosto virado ou uma mão cobrindo a boca são pontos de falha documentados.
- Vídeos com várias pessoas. A detecção do falante ativo aparece como opção nos três modelos atuais da sync; o MuseTalk não oferece uma configuração equivalente.
- Tempo de configuração. Em uma implantação própria, esse custo é pago uma vez — mas não é pequeno.
A página do MuseTalk no fal.ai deixa claro o que você compra ao eliminar essa etapa: uma URL para o vídeo, outra para o áudio e nada além disso. Sem ambiente conda, versões específicas de CUDA ou árvore de pesos para organizar.
Como colocar o MuseTalk para funcionar sem brigar com as dependências
Uma reclamação recorrente de quem já executou o modelo não tem relação com a qualidade da saída. O problema é a pilha OpenMMLab. No r/StableDiffusion, um usuário que comparou modelos de lip sync resumiu a experiência depois de testar o MuseTalk e o LatentSync:
“LatentSync e Musetalk funcionam e têm desempenho parecido... O Musetalk é trabalhoso de configurar porque depende das bibliotecas do OpenMMLab.” — u/Traditional_Tap1708, r/StableDiffusion
Instale as versões fixadas no README usando mim, não o pip puro:
- Use Python 3.10 em um ambiente conda novo, com PyTorch 2.0.1, torchvision 0.15.2 e torchaudio 2.0.2.
mim install mmengine "mmcv==2.0.1" "mmdet==3.1.0" "mmpose==1.1.0". Uma versão mais recente do mmcv é a causa mais comum de falhas de importação do mmdet.- Tenha o FFmpeg no
PATH, verificando comffmpeg -version, ou informe o caminho explicitamente com--ffmpeg_pathno Windows. - Execute
sh download_weights.shpara baixar a árvore completa. A UNet sozinha não basta: o script também baixa o sd-vae-ft-mse, o Whisper, odw-ll_ucoco_384.pthdo DWPose e os pesos de face parsing do BiSeNet. Quando algum arquivo falta, o erro costuma aparecer como falha na detecção ou na composição do rosto, e não como uma mensagem clara. - Converta a fonte para 25 fps com
ffmpeg -i input.mp4 -r 25 output.mp4. O repositório recomenda entrada a 25 fps porque essa foi a taxa usada no treinamento do modelo; uma taxa diferente é a causa mais comum de descompasso entre áudio e vídeo. - Aponte o
configs/inference/test.yamlpara seu vídeo e áudio e executepython -m scripts.inference --inference_config configs/inference/test.yaml --result_dir results/test --unet_model_path models/musetalkV15/unet.pth --unet_config models/musetalkV15/musetalk.json --version v15.
Se você vai gerar vários clipes com o mesmo rosto, defina preparation: true uma vez em configs/inference/realtime.yaml. Deixe o sistema armazenar em cache coords.pkl, latents.pt e o conjunto de máscaras em results/v15/avatars/ e depois volte a configuração para false. Adicionar --skip_save_images também faz mais diferença do que parece: gravar PNGs no disco pode virar o gargalo, em vez do próprio modelo.
MuseTalk 1.5 ou 1.0: quais pesos baixar
Use a versão 1.5. O repositório a apresenta como a versão mais recente, datada de 28 de março de 2025, e atribui a ela ganhos de nitidez, consistência de identidade e alinhamento entre fala e movimento dos lábios graças às perdas perceptual, GAN e de sincronização, além do treinamento em duas etapas.
O único motivo para manter a versão 1.0 por perto é o bbox_shift, que só funciona nela. Esse parâmetro move verticalmente o limite da máscara: valores positivos abrem mais a boca, enquanto valores negativos a fecham.
Execute o padrão uma vez e o script exibirá o intervalo ajustável para o seu clipe. No exemplo do README, o intervalo é [-9, 9] e o valor escolhido é -7. Faça novas renderizações dentro do intervalo obtido: use valores mais negativos se a boca parecer exagerada e mais positivos se ela quase não abrir.
Falhas que você provavelmente encontrará — e quais podem ser corrigidas
| Sintoma | Causa | Dá para corrigir? |
|---|---|---|
| A execução é interrompida, sem rosto detectado | Um quadro contém um rosto virado, bloqueado ou ausente | Sim. Recorte ou remova o trecho problemático |
| A boca quase não se move | O áudio está encoberto pela música ou o limite da máscara está alto demais | Sim. Isole os vocais; use bbox_shift positivo na v1.0 |
| Os lábios perdem a sincronização no meio | A fonte não está em 25 fps | Sim. Converta antes do processamento |
| A boca fica suave contra um rosto nítido | O rosto é pequeno demais no enquadramento para a região de 256x256 | Parcialmente. Faça um recorte mais fechado, desative o fp16 e adicione restauração facial |
| Emenda visível, bigode não preservado | A síntese da parte inferior do rosto substitui detalhes da identidade | Não. É uma limitação do modelo |
| Jitter entre os quadros | Os quadros são gerados individualmente | Parcialmente. O repositório atribui ao treinamento em duas etapas da v1.5 uma melhora na consistência |
| Rosto de desenho ou estilizado falha | A distribuição de treinamento usa rostos reais | Não |
| Áudio energético sobre um falante imóvel | O MuseTalk não altera o movimento da cabeça nem a expressão | Não. Será preciso refazer ou substituir o clipe de origem |
Um usuário que testou o MuseTalk em uma configuração com pouca VRAM relatou “171s para 7 segundos de áudio” e acrescentou que ele “só funciona com imagens realistas” (u/Bartholomheow, r/StableDiffusion). Já a promessa de “tempo real” descreve a taxa sustentada depois da preparação do avatar, não a latência de ponta a ponta. Um desenvolvedor que criava talking heads no r/LocalLLaMA afirmou que, com o MuseTalk, “o tempo de preparação é longo demais” (u/lonyPorgrammer) para o seu caso de uso interativo.
Qual caminho de lip sync combina com o seu projeto
| Opção | Escolha quando | Principal desvantagem |
|---|---|---|
| MuseTalk hospedado por conta própria | Há grande volume e a gravação é favorável: rascunhos de localização, avatares interativos que reutilizam o mesmo rosto em milhares de clipes de áudio ou vídeos internos de treinamento | A configuração leva horas, não minutos; a taxa de processamento depende da GPU alugada |
| MuseTalk hospedado (Replicate, fal.ai) | Você tem poucos clipes ou quer testar a qualidade no próprio material antes de assumir uma implantação | O mesmo limite de 256x256, nenhuma das APIs oferece uma flag de cache de avatar no schema do endpoint e há cobrança por execução |
| Modelo pago de lip sync (sync-3, lipsync-2-pro) | Saída voltada ao cliente, closes grandes, ângulos de perfil, obstruções, vários falantes ou entrega em 4K | US$ 4–8 por minuto, além de o material sair da sua infraestrutura |
Alugue uma V100 para reproduzir a taxa oficial de processamento ou uma 4090 se a ideia for transmitir ao vivo. Para o caminho baseado em endpoints hospedados, os dois serviços são analisados com mais profundidade em nossa análise do Replicate e na análise do fal.ai.
FAQ sobre o MuseTalk lipsync
O MuseTalk roda em uma GPU de 6 GB ou 8 GB?
Sim. O README documenta testes em uma RTX 3050 Ti Laptop de 4 GB usando FP16, portanto a inferência básica cabe em uma GPU com pouca VRAM. Na prática, o maior limitador é a velocidade de processamento.
256x256 é a resolução de saída?
Não. É a região facial editável, que é mesclada de volta a um vídeo que mantém a resolução e a taxa de quadros originais.
O MuseTalk funciona em rostos de desenho ou anime?
Não de forma confiável. O modelo foi treinado com vídeos reais de pessoas falando, e usuários que testaram entradas estilizadas relatam resultados inconsistentes.
A taxa de “30 fps em tempo real” inclui o pré-processamento?
Não. Ela descreve a taxa de geração em uma Tesla V100 depois da preparação do avatar. A detecção facial, a codificação dos latentes e o primeiro processo de cache acontecem antes disso.
MuseTalk ou LatentSync?
Escolha o MuseTalk quando latência e volume forem os fatores decisivos, já que a inferência em uma única etapa e os avatares em cache eliminam boa parte do custo por clipe. O usuário do r/StableDiffusion citado acima, que executou os dois modelos, descreveu o desempenho como semelhante. Nesse cenário, a taxa de processamento pesa mais na decisão do que a fidelidade.
O MuseTalk pode ser usado comercialmente?
O repositório licencia o código sob MIT, mas a cadeia de dependências não segue um único padrão. Whisper, VAE, DWPose, face parsing do BiSeNet e SyncNet têm seus próprios termos, e o repositório também sinaliza restrições separadas para os dados de exemplo. Verifique cada licença antes de colocar o sistema em produção.
O equilíbrio que continua sem solução nessa faixa de preço
O MuseTalk entrega a maior parte do caminho por praticamente nada. O que ele não resolve é a preservação da identidade sob pressão: bigodes, o formato exato dos lábios, um rosto que ocupa todo o enquadramento ou um falante que vira a cabeça no meio da frase.
Para a maioria das equipes, a resposta não está em uma única ferramenta. O caminho mais sensato é usar o MuseTalk para ganhar escala e recorrer a um modelo pago nas cenas que serão exibidas em tela cheia.
Leia também
- Análises e preços do Higgsfield AI em comparação com acesso via API
- Guia de instalação local do Kokoro 82M TTS, para gerar a faixa de áudio consumida pelo MuseTalk
- Guia do Wan 2.2 Animate