 AIREITER
O MiniMax Music 3.0 chegou em 13 de agosto de 2026 com pesos abertos no HuggingFace, API a US$ 0,15 por música e suporte a faixas de até cinco minutos. O endpoint da API ainda aparece na documentação como Music 2.6, enquanto a execução local pode exigir até 24 GB de VRAM.
O que mudou no Music 3.0 — e por que músicas de 5 minutos importam
O Music 3.0 substitui o Music 2.6 como modelo musical recomendado pela MiniMax. A principal novidade é gerar, de uma só vez, músicas de até cinco minutos, incluindo composição, arranjo, performance e produção. A empresa diz que a mudança resolve um problema comum nas versões anteriores: a perda de consistência de gênero, instrumentação e vocais conforme a faixa avançava além da primeira seção (blog oficial).
| Componente | Parâmetros | Função |
|---|---|---|
| LLM global (baseado no Qwen3.5-8B) | 8B | Prevê a estrutura musical e a semântica da música inteira |
| LLM local | 0.6B | Preenche os detalhes acústicos de cada frame |
| Flow-matching + Flow-VAE | 2.4B + 123M | Converte estados ocultos em áudio contínuo, sem depender de tokens discretos |
Por baixo do capô, uma pilha de quantização vetorial residual (RVQ) em 8 camadas separa a estrutura musical mais ampla — a Camada 1 usa um codebook com 16.384 entradas — dos detalhes acústicos, distribuídos nas Camadas 2 a 8, com 1.024 entradas cada. O LLM global acompanha o contexto da música como um todo, enquanto o LLM local prevê o áudio frame a frame. Depois, a pilha de flow-matching renderiza o resultado a partir dos estados ocultos combinados, em vez de decodificar apenas tokens discretos. Segundo o blog, isso reduz artefatos de alta frequência e frases rígidas comuns em modelos musicais anteriores, mas a MiniMax ainda não publicou benchmarks controlados comparando o sistema ao Music 2.6, ao Suno ou ao Udio.
Preços da API, IDs dos modelos e limites de requisição
A plataforma oficial da MiniMax lista dois IDs de modelo para o Music 3.0, com cobrança simples conforme o uso:
| ID do modelo | Preço por música | Limite de requisições | Observações |
|---|---|---|---|
Music-3.0 | US$ 0,15 | 120 RPM | É preciso falar com a equipe de vendas para obter limites maiores |
Music-3.0-free | US$ 0 | 3 RPM | Camada de teste gratuita |
Geração/edição de letras do Music-3.0 | US$ 0,01 | — | Gera ou otimiza letras automaticamente |
Os dois modelos geram uma música completa — com vocais e duração de até cinco minutos — em cada chamada da API. O endpoint é POST /v1/music_generation, o mesmo usado pelo Music 2.6. No dia do lançamento, a documentação de referência da API ainda mostrava music-2.6 nos exemplos indexados. Na prática, os desenvolvedores talvez precisem testar manualmente o ID Music-3.0 até a documentação ser atualizada.
Como rodar o Music 3.0 localmente: ComfyUI e requisitos de hardware
O lançamento com pesos abertos foi o que mais chamou a atenção da comunidade. Os arquivos estão disponíveis no HuggingFace em MiniMaxAI/MiniMax-Music3, e há uma distribuição otimizada para o ComfyUI em Comfy-Org/MiniMax-Music-3.
O model card documenta três níveis de hardware, confirmados também pelos primeiros relatos da comunidade:
| Modo | VRAM | Velocidade aproximada | Qualidade |
|---|---|---|---|
| Precisão total | <24 GB (por exemplo, RTX 4090) | Mais rápida | Melhor |
| Offloading para a CPU | ~22 GB de GPU + 32 GB ou mais de RAM | Moderada | Próxima da total |
| Streaming de camadas | 8 GB de GPU + 32 GB ou mais de RAM | Lenta | Limitada |
Para começar localmente, instale o ComfyUI 0.33.0 ou posterior (confirmado pelo tópico da comunidade do ComfyUI), baixe os arquivos do modelo em um dos repositórios do HuggingFace acima, carregue o workflow do ComfyUI para o MiniMax-Music3, escolha o modo de precisão compatível com a VRAM disponível e gere a faixa. Atualmente, CUDA é o único backend de computação compatível; ainda não existe suporte a ROCm ou MPS (segundo relatos da comunidade). Uma PR de integração com Diffusers está em andamento e pode permitir inferência nativa em Python fora do ComfyUI.
Um usuário do Reddit no r/comfyui relatou ter gerado 140 segundos de música country em uma AMD RX 7900 GRE (16 GB de VRAM, 32 GB de RAM) em aproximadamente 125 segundos. Outro tópico no r/StableDiffusion resumiu a reação da comunidade de forma direta:
"Hoje cancelei minha assinatura do Suno graças ao Minimax Music." — r/StableDiffusion
Vale ler com atenção os termos da licença antes de usar o modelo comercialmente. O blog fala em "pesos abertos" e "pronto para produção", mas não publica o texto da licença, as regras para uso comercial ou as condições de redistribuição. O arquivo LICENSE do repositório no HuggingFace é a fonte oficial; verifique seu conteúdo antes de lançar um trabalho que gere receita.
Como criar prompts para o Music 3.0: Structured Captions e tags de seção
O principal recurso de controle do Music 3.0 são as Structured Captions: descrições detalhadas e organizadas no tempo, que indicam ao modelo o que deve acontecer em cada trecho da música. De acordo com o blog oficial, uma caption bem estruturada especifica:
- Gênero e subgênero (por exemplo, "progressive house / EDM")
- Andamento e tonalidade (por exemplo, "126 BPM, si bemol maior")
- Instrumentação (por exemplo, "tenor masculino soproso, sintetizadores com sidechain, baixo de pista, reverberação de salão")
- Interpretação vocal (por exemplo, "tenor rouco com passagens em falsete")
- Arco emocional (por exemplo, "verso leve crescendo até um refrão de alta energia")
- Características da produção (por exemplo, "mixagem com som de sala vintage", "teclas brilhantes")
As letras usam tags de seção comuns, reconhecidas pela maioria dos modelos de IA musical:
[intro]
[verse]
[pre-chorus]
[chorus]
[bridge]
[instrumental]
[solo]
[outro]
O Prompt Enhancement System pode transformar pedidos simples — como "música pop animada com vocais femininos" — no formato completo de Structured Caption, usando terminologia da indústria musical. Assim, pessoas sem formação musical conseguem controlar melhor o resultado sem precisar dominar vocabulário especializado. Faixas instrumentais podem ser geradas sem letras; músicas com vocais exigem letras fornecidas pelo usuário ou o otimizador de letras de US$ 0,01 por música.
MiniMax Music 3.0 contra Suno e Udio
A comparação que realmente importa é esta: vale mais pagar US$ 0,15 por música ao MiniMax ou assinar um serviço já estabelecido?
| Recurso | MiniMax Music 3.0 | Suno | Udio |
|---|---|---|---|
| Duração máxima da música | 5 min | ~4 min | ~2–4 min |
| Modelo de cobrança | US$ 0,15/música, conforme o uso | US$ 10/mês no Pro, 500 músicas | US$ 10/mês no Standard, ~600 músicas |
| Opção gratuita | API a 3 RPM + pesos abertos | 10 músicas/dia | Créditos limitados |
| Pesos abertos | Sim (HuggingFace) | Não | Não |
| Execução local | Sim (ComfyUI) | Não | Não |
| Uso comercial | Verifique a licença no HuggingFace | Incluído nos planos pagos | Incluído nos planos pagos |
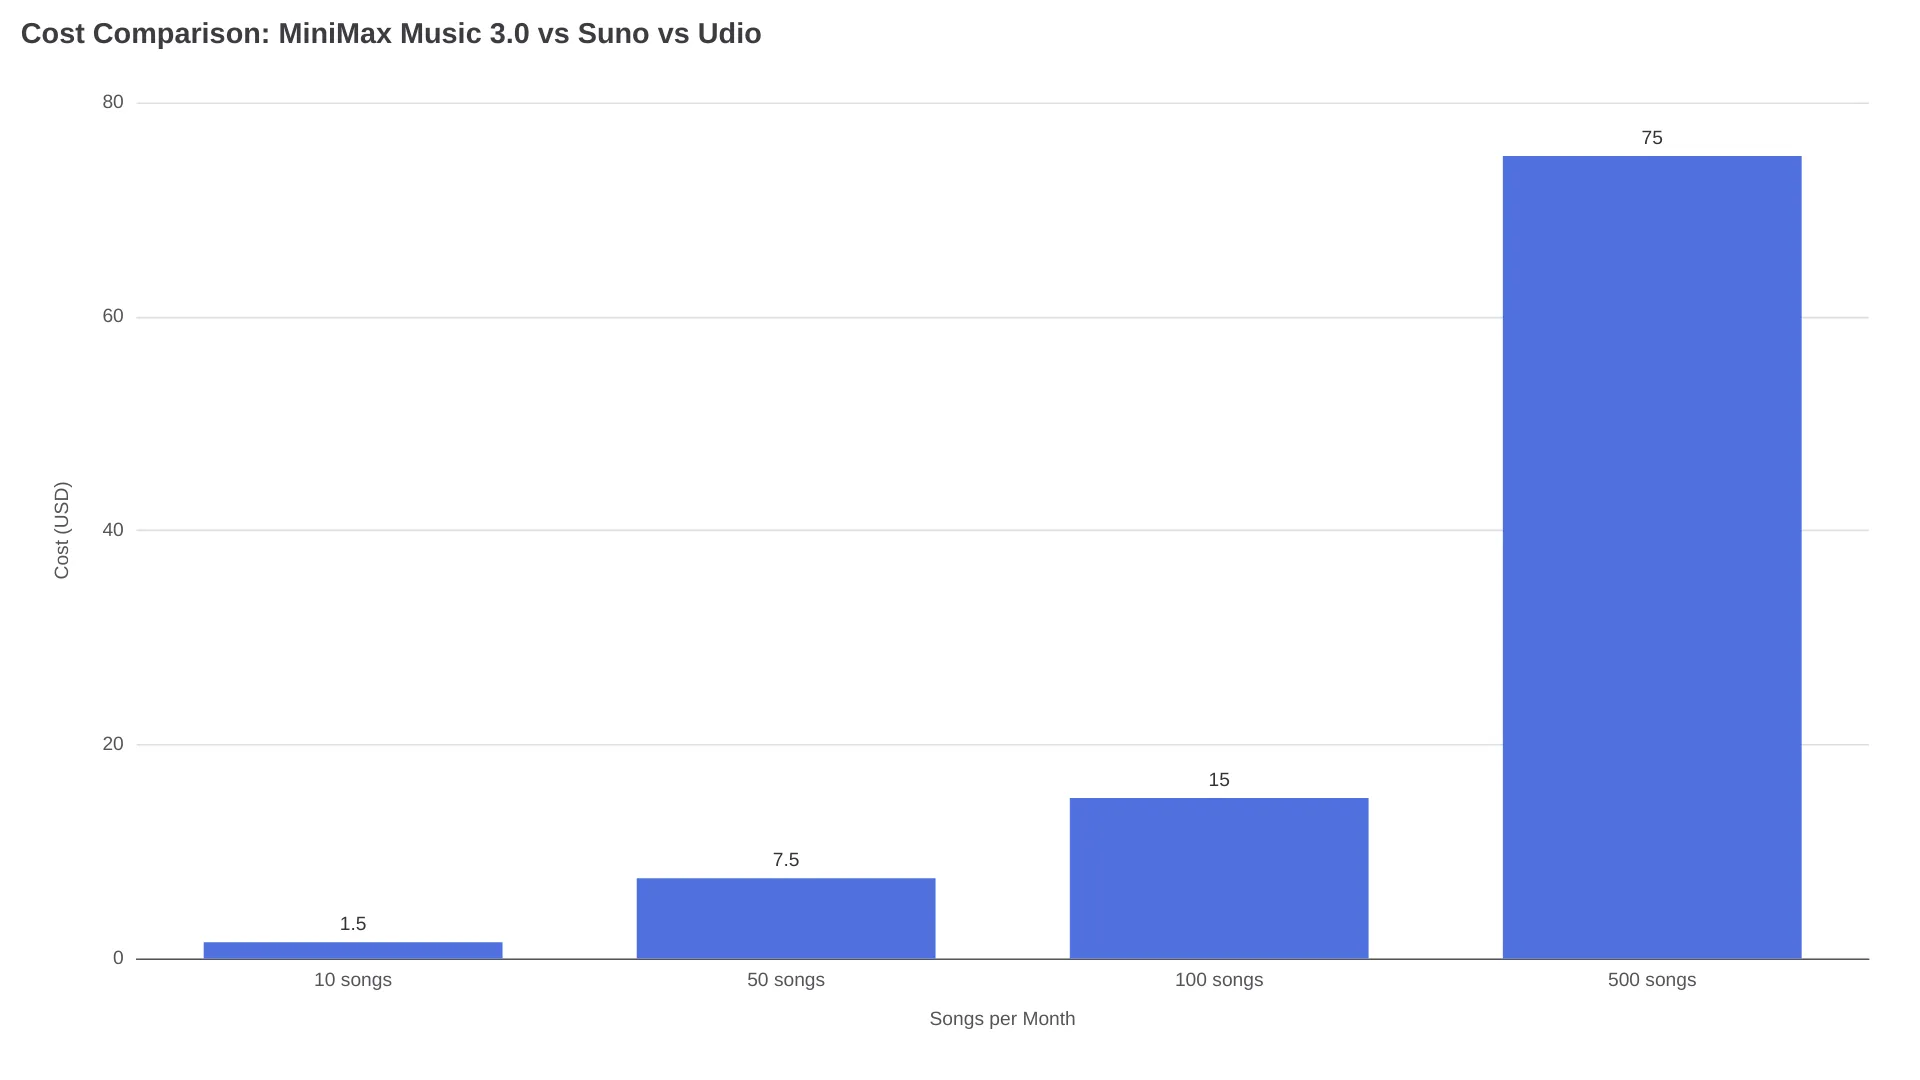
O ponto de equilíbrio fica em torno de 67 músicas por mês. Abaixo disso, o pagamento conforme o uso do MiniMax, a US$ 0,15 por música, sai mais barato do que qualquer assinatura. Acima desse volume, o Suno Pro ou o Udio Standard, por US$ 10 mensais e mais de 500 músicas, vencem no custo bruto. O diferencial do MiniMax é a opção local com pesos abertos: geração gratuita ilimitada para quem já tem a GPU.
Tópicos em r/SunoAI e r/comfyui descrevem o Music 3.0 como competitivo com o Suno v4 em naturalidade vocal e fidelidade aos prompts, especialmente nos gêneros eletrônico e pop. Rock, metal e estilos acústicos mais antigos receberam avaliações mais variadas, com alguns usuários apontando excesso de “embolado” em mixagens densas. O suporte multilíngue — mandarim e inglês nas demonstrações oficiais, além de rap de Bollywood testado pela comunidade — também parece forte.
Perguntas frequentes
O MiniMax Music 3.0 é gratuito?
O modelo de API Music-3.0-free gera músicas sem custo, com limite de 3 RPM. Também é possível executar gratuitamente o modelo de pesos abertos localmente pelo ComfyUI.
O Music 3.0 gera faixas instrumentais?
Sim. A geração instrumental não exige letras; a geração com vocais requer letras fornecidas pelo usuário ou o otimizador de letras de US$ 0,01 por música.
Qual é o ID do modelo de API do Music 3.0?
Music-3.0 (120 RPM, US$ 0,15 por música) e Music-3.0-free (3 RPM), ambos acessados por POST /v1/music_generation. A documentação da API, porém, ainda cita music-2.6 em algumas páginas.
O Music 3.0 é compatível com idiomas além do inglês?
As demonstrações oficiais incluem mandarim e inglês. Testes da comunidade mostram geração bem-sucedida em hindi (teste de rap de Bollywood). Ainda não foi publicada uma lista oficial de idiomas.
Posso usar comercialmente as faixas criadas pelo MiniMax Music 3.0?
Confira o arquivo LICENSE no HuggingFace e os termos de serviço da API. O blog não especifica os direitos de uso comercial.
De quanta VRAM preciso para rodar o Music 3.0 localmente?
Menos de 24 GB em precisão total, ~22 GB com offloading para a CPU ou 8 GB no modo de streaming de camadas. Consulte a tabela de hardware acima.
Qual caminho escolher?
| Situação | Caminho recomendado | Custo |
|---|---|---|
| Testar ou prototipar algumas músicas | API Music-3.0-free | US$ 0 |
| Uso ocasional em produção (<67 músicas/mês) | API Music-3.0 | US$ 0,15/música |
| Geração em alto volume (>67 músicas/mês) | Suno Pro ou Udio Standard | US$ 10/mês |
| Você tem uma GPU de 24 GB e quer geração gratuita ilimitada | ComfyUI local com pesos do HuggingFace | US$ 0, apenas computação |
| Desenvolver um app com geração musical programática | API Music-3.0 pela plataforma MiniMax | US$ 0,15/música |
Restam duas lacunas: o atraso na documentação da API, que ainda está focada no Music 2.6, e os termos de licença não especificados para os pesos abertos. As duas questões devem ser esclarecidas conforme o lançamento amadurecer, mas nenhuma delas impede o funcionamento da API hoje.