 AIREITER
O próprio model card do MiniMax classifica a camada de pré-processamento do H3 como "crítica para a qualidade do resultado final". Já uma discussão no Reddit sobre prompts para H3, com 220 upvotes, parece mais um relatório de bugs sobre diálogos sem sentido. Nesta análise dos prompts do MiniMax H3, colocamos o formato oficial lado a lado com testes de criadores e relatos de falhas: câmera e referências se mostram mais confiáveis do que diálogo e áudio, e, em alguns casos, fugir deliberadamente da sintaxe entrega o melhor resultado.
Como funciona de fato o formato de prompt do MiniMax H3
O prompt oficial do MiniMax H3 é um documento estruturado em três campos — integrated_multimodal_description, overall_soundscape e non_diegetic_music. Ele inclui planos com marcação de tempo, IDs persistentes para falantes e tags de diálogo <d>. Essa estrutura existe porque o H3 espera uma representação intermediária estruturada, normalmente gerada por um pré-processador hospedado, o H3-Context-IR, que o MiniMax não incluiu no lançamento dos pesos abertos. Na API hospedada, pedidos soltos são reescritos automaticamente. Já os pesos abertos de 33B, executados localmente em SGLang, vLLM, Diffusers ou ComfyUI, deixam essa estrutura por sua conta.
O MiniMax também disponibiliza uma skill portátil chamada h3-prompt-writing no repositório oficial no GitHub. São dois arquivos de guia, base-en.txt e ref-en.txt, que qualquer agente de programação pode ler sem fazer chamadas externas de API. Criadores a usam no Claude ou no Cursor para transformar briefings em linguagem natural no formato completo; @AI__TSUBAKI documenta exatamente esse fluxo para clipes cinematográficos.
Limites técnicos que moldam o prompt
| Restrição | Valor | Impacto no prompt |
|---|---|---|
| Duração do clipe | 4–15 segundos, 24 FPS | Os timestamps precisam ser estritamente crescentes e ficar dentro da duração |
| Áudio | Estéreo a 32 kHz, gerado em conjunto | Os campos de ambientação sonora e trilha são obrigatórios; N/A é permitido |
| Resolução | 768p por padrão; 2K via H3-Regenerate-2K, apenas por API | Teste em 768p e pague pelo 2K só depois de fechar o prompt |
| Tipos de tarefa | T2VA (texto), I2VA (primeiro frame em 0.00 s), FL2VA (primeiro + último frame), L2VA (último frame), Ref2VA (omni-reference) | Cada tipo exige sua própria frase de alinhamento |
| Limites de referências | 9 imagens + 3 clipes de vídeo + 3 clipes de áudio, 12 arquivos no total, ≤15 s por tipo de mídia | Mais referências significam mais roteamento, não necessariamente um resultado melhor |
| Tamanho do prompt | Os exemplos oficiais têm 300–700 palavras; text-to-video puro aceita cerca de 7.000 caracteres | Prompts curtos sem referências são um modo de falha apontado no manual oficial |
Um prompt completo, mas mínimo, cabe em dez linhas: três campos, uma instrução de câmera, uma pessoa visível falando uma frase entre aspas e sem trilha sonora.
integrated_multimodal_description: Cinematic, live-action. [Shot 1] A woman in her
late twenties sits on a sunlit sofa, a matte-green skincare bottle in hand. The
camera pushes in, small amplitude, slow speed. She is visible on screen and says:
"This is the one product I repurchase every year." At 00:05.500 she sets the
bottle down.
overall_soundscape: Quiet room tone, faint traffic outside, soft fabric movement,
gentle contact of the bottle on the table.
non_diegetic_music: N/A
A sintaxe completa de cada campo — incluindo tags, frases de alinhamento e templates — está no nosso guia de prompts do MiniMax H3. Aqui, a questão é outra: essa sintaxe realmente compensa?
O que o formato promete — e o que os testes confirmam
As orientações oficiais fazem três promessas implícitas. Os relatos citados são mais favoráveis às duas primeiras do que à aderência do áudio.
Promessa 1: estrutura entrega o resultado esperado
É aqui que as evidências são mais fortes. O criador no X @AIWarper publicou uma comparação de antes e depois ao migrar para a estrutura oficial:
"I STRONGLY encourage you to adhere to the prompting guide released by Minimax. It really helps a lot with getting exactly what you expected.... My last post did not follow the suggested prompt structure." — @AIWarper, 306 likes
O log de testes de terceiros mostra o mesmo padrão nos detalhes: pediu um corte exatamente em 00:05.000 e o recebeu, transcreveu literalmente um depoimento roteirizado e manteve a composição do primeiro frame estável ao longo de um clipe I2VA de 6 segundos. Os relatos com storyboard seguem na mesma linha: os quadros de @aimikoda são obedecidos como sequência de planos, e o storyboard de @nanyuan0412 foi seguido sem improvisos. A exceção foram os campos de som, que esqueceram de preencher e acabaram gerando quase silêncio.
O limite recorrente não é uma recusa do modelo, mas o ritmo. "Biggest problem has been pacing", escreve u/Relevant_One_2261. Diálogos que não cabem na duração e timestamps próximos demais são as falhas estruturais que mais se repetem.
Promessa 2: comandos de câmera funcionam melhor que descrições de resultado
Um problema de enquadramento resolvido na prática confirma isso. Um usuário de r/StableDiffusion pediu que o H3 mantivesse o corpo inteiro de uma pessoa caminhando dentro do quadro, usando a instrução simples "entire subject remains visible throughout". Falhou repetidamente. A solução foi traduzir o resultado desejado para a gramática nativa de câmera do H3:
"The camera pulls out with large amplitude at the same speed as the subject walks forward, maintaining a full-body composition." — u/Powerful-Goal52, confirmado como funcional pelo autor original
Isso corresponde diretamente às três dimensões de câmera do H3 — tipo de movimento, amplitude e velocidade — e à regra de usar uma única instrução de câmera por plano. Veja a tradução prática:
| Resultado desejado | Comando que o H3 segue |
|---|---|
| Pessoa permanece inteira no quadro enquanto caminha | Pull Out com grande amplitude na velocidade da caminhada da pessoa |
| Dar ênfase sutil sem quebrar o enquadramento | Push In, pequena amplitude, velocidade lenta |
| Revelar o ambiente ao redor de uma pessoa parada | Truck Left ou Truck Right, amplitude média |
| Mudar a altura sem inclinar a câmera | Pedestal Up / Pedestal Down em velocidade lenta |
As orientações oficiais de prompting listam 13 famílias de movimento: Zoom, Push, Pull, Pan, Tilt, Truck, Pedestal, Arc, Tracking, Static, Shake, Roll e POV. Cada uma pode ser modulada por amplitude e velocidade. Na prática, a diferença entre zoom, uma mudança de distância focal, e push, um movimento físico de câmera, importa; os termos não são intercambiáveis.
Promessa 3: separar os campos de áudio mantém tudo sob controle
Este é o ponto fraco. Separar a ambientação diegética da trilha não diegética é uma boa decisão de design, mas a aderência é inconsistente:
"I use this, but about 20% of the time it adds music anyway lol" — u/TheElectriking sobre
non_diegetic_music: N/A
A discussão com 220 upvotes de onde veio essa citação reúne o restante do padrão: artefatos de áudio nas transições entre clipes, personagens falando frases aleatórias sem sentido e a pessoa errada dizendo uma fala. u/krigeta1 relata ter enviado três referências de áudio próprias e recebido "a random voice or not the audio I assign to the characters". Em uma discussão separada, diálogos de personagens em cena que insistiam em ser lidos como voz off foram corrigidos ao vincular explicitamente o ID do falante ao personagem visível.
Texto na imagem sofre de fragilidade semelhante. A wiki da comunidade diz que "exact text is fragile"; para letras cruciais de marca, o ideal é fornecer uma imagem de referência ou fazer a composição em pós-produção. Há ainda um relato divergente: @web4miko afirma que, em seus testes, o H3 "can't even beat Seedance 2.0" em compreensão de texto e contexto. Nos relatos citados, roteamento de áudio, texto exato e contexto denso aparecem como as fraquezas recorrentes.
Quando vale fugir da sintaxe oficial
As comparações lado a lado e relatos em primeira mão citados apontam três desvios do formato oficial. Vale conhecê-los antes de se comprometer com toda a estrutura.
Às vezes, aspas funcionam melhor que tags <d>. Em uma comparação publicada no r/StableDiffusion, com cerca de 105 upvotes e 81 comentários, o autor descobriu que remover a marcação <d>[Language]...台词...</d> recomendada pelo guia e usar o diálogo simplesmente entre aspas produziu fala limpa. Já a versão com tags adicionou áudio não solicitado. Um comentarista que realizou testes parecidos concordou:
"the official dialogue prompting is buggy as hell... quotes approach is still not nearly as buggy as the
<d></d>tagging." — u/networking_noob
Na prática: tente primeiro <d>, pois esse é o caminho treinado pelo modelo. Mas, se a fala sair embolada ou excessiva, refaça a mesma linha entre aspas em vez de reescrever o prompt inteiro.
non_diegetic_music: N/A funciona como controle isolado. Segundo u/Nextil, esse campo evita música "even if you ignore most of the other structure". Se você não for estruturar mais nada, faça ao menos isso: trilha indesejada é uma reclamação recorrente nos relatos citados.
Trabalhos com muitas referências pedem menos texto, não mais. Quando imagens levam a identidade e um vídeo carrega o movimento, o papel do prompt se reduz ao roteamento e à nova ação. Os templates mais compartilhados de @aimikoda, um deles com mais de 1.300 favoritos, são minimalistas exatamente por isso. Já @CharaspowerAI mostrou o agente Design do próprio MiniMax expandindo uma única linha — "act as an expert FPV director and turn this into something viral" — para um prompt estruturado completo automaticamente. Um bloco de roteamento de referências fica assim:
@Image 1 is the character reference: preserve the face, short black hair, red silk jacket.
@Video 1 supplies the sword-draw rhythm.
@Audio 1 sets the mood with quiet traditional strings.
Depois disso, o prompt só precisa descrever o novo plano. O fluxo prático desses relatos é simples: primeiro, fixe as imagens estáticas; deixe as referências fazerem o trabalho pesado; use palavras apenas para o que muda.
Triagem de falhas que o manual não explica
O guia oficial de prompting para na sintaxe. Ele não explica o que fazer quando a geração volta quebrada. A tabela abaixo foi montada a partir dos relatos de falha mencionados:
| Sintoma | Causa provável | Correção |
|---|---|---|
Música adicionada mesmo com N/A | Um usuário observou vazamento em cerca de 20% das execuções | Gere novamente; evite pedir qualquer "clima" musical em outra parte do prompt |
| O personagem errado fala uma linha | Conflito no roteamento entre falante e áudio | Vincule explicitamente o ID do falante ao personagem visível em cena |
| Fala em cena sai como voz off | Falta de associação com lip-sync | Informe que o falante está visível; para uma voz off real, adicione "lips remain closed" |
| Referência de áudio é ignorada | Acima dos limites de 3 clipes / 15 segundos, ou sem atribuição | Dê uma função a cada clipe e reduza o áudio total de referência |
| Modelo local ignora diálogo em chinês | ComfyUI reutilizou o tokenizer do Qwen; a codificação do shell corrompeu o texto | Tokenizer do repositório, exigência oficial, + envio compatível com Unicode + <d>[Chinese] 台词</d> (correção relatada pela comunidade) |
| Plano-sequência longo (>15 s) desmorona | Fora da faixa de projeto de 4–15 s; objetos se achatam e a continuidade deriva | Divida em segmentos de 15 segundos e planeje a continuidade entre eles |
Vale olhar com atenção para a linha sobre execução local. No relato de @eternityspring, o problema de "H3 won't speak Chinese" era reutilização de tokenizer e codificação, não o prompt em si.
O custo da estrutura: tokens, iterações e portabilidade
Estrutura não sai de graça. O repositório oficial publica o consumo de tokens do Context-IR em três casos reproduzíveis, e os números crescem bastante conforme aumenta a quantidade de referências:
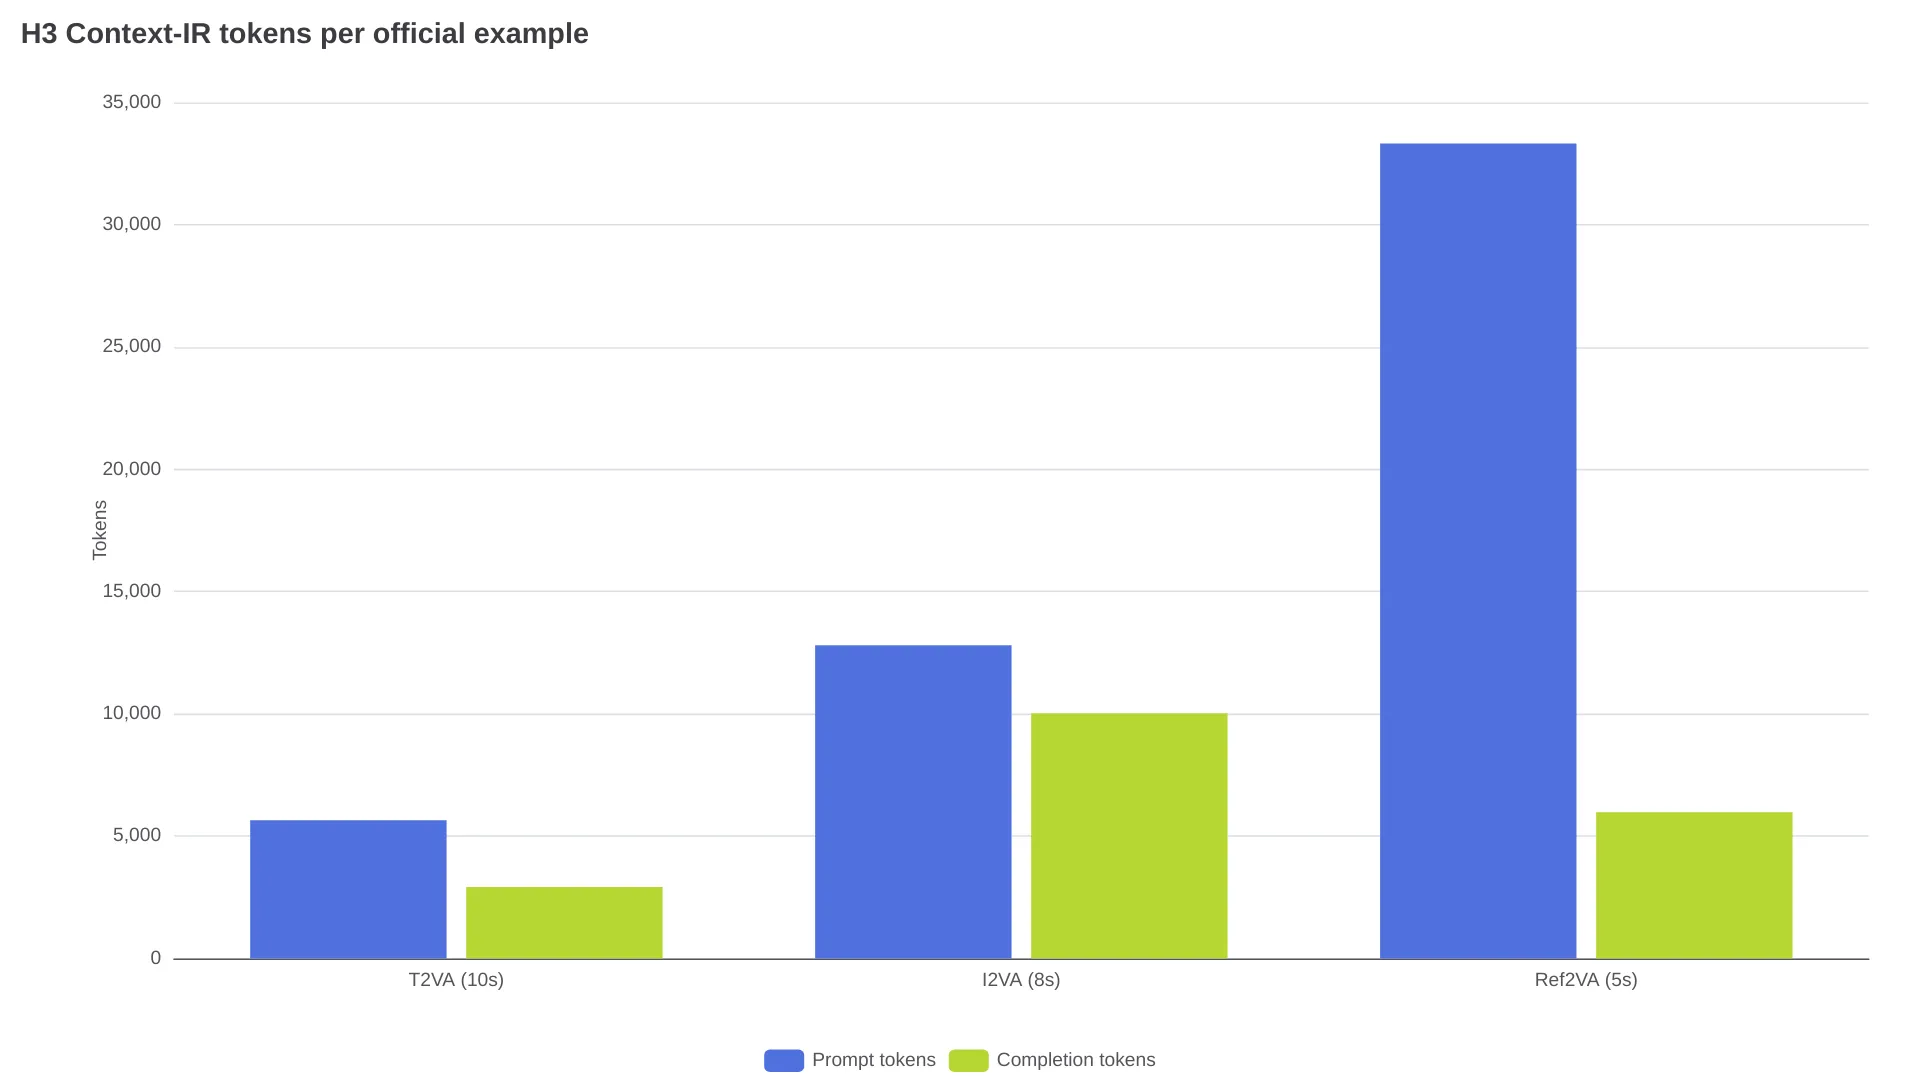
Uma geração apenas com texto consome 8.565 tokens de pré-processamento. Um trabalho multimodal com referências chega a 39.299, sendo 33.323 do lado do prompt. Em execuções locais, esses tokens aumentam a latência do pré-processamento. Em fluxos hospedados, elevam o overhead de processamento, mesmo quando o preço é cobrado por segundo gerado. O custo de tempo também existe: uma criadora no X documentou 48 horas refinando um único prompt com três pessoas e câmera orbital até acertar o resultado (@LoveUolanda). A forma econômica de iterar é criar em 768p, onde um teste de 6 segundos custa cerca de US$ 0,68, e só enviar o prompt fechado para 2K. As tarifas de US$ 0,1125/s em 768p e US$ 0,1825/s em 2K para o MiniMax H3 estão listadas na página do modelo do relay.
O último custo oculto é a portabilidade. Os campos, IDs de falante e tags do H3 formam um dialeto, não um padrão. Um guia comparativo entre modelos mostra que o Veo 3.1 quer parágrafos simples com rótulos SFX: embutidos, enquanto o Seedance 2.0 usa uma descrição de seis campos. Nenhum aceita os campos, IDs de falante ou tags do H3. Uma biblioteca de prompts criada para H3 exige reescrita, e não simples copiar e colar, em qualquer outro lugar.
Perguntas frequentes sobre prompts do MiniMax H3
O formato de prompt estruturado é obrigatório no MiniMax H3?
Não. Na API hospedada, o Context-IR converte pedidos soltos em linguagem natural para a representação interna. A estrutura importa mais em execuções locais com pesos abertos e em trabalhos que exigem cortes exatos, timestamps e roteamento de falantes.
Como impedir o MiniMax H3 de adicionar música de fundo?
Termine com non_diegetic_music: N/A e não peça um clima musical em nenhuma outra parte do prompt. Vazamentos ainda acontecem, portanto regenerar é normal.
Qual deve ser o tamanho de um prompt para MiniMax H3?
Os exemplos do MiniMax têm entre 300 e 700 palavras, e o text-to-video puro aceita cerca de 7.000 caracteres. Quando referências já carregam identidade e movimento, o prompt deve encolher, não crescer.
Posso reutilizar prompts do H3 no Seedance ou no Veo?
Não. Os campos nomeados, IDs de falante e tags do H3 são específicos do modelo. O Seedance usa um formato de seis campos, e o Veo aceita parágrafos simples, portanto cada modelo de destino precisa de sua própria reescrita.
Por que minha instalação local do H3 ignora diálogos em outros idiomas?
Em geral, o problema está na cadeia de ferramentas, não no modelo. Configurações que reutilizam o tokenizer do Qwen ou shells que corrompem Unicode quebram o diálogo antes da geração. Use o tokenizer oficial do repositório e o formato de diálogo <d>[Language].
Veredito: quem deve aprender o formato
| Seu tipo de trabalho | Veredito |
|---|---|
| Filme com múltiplos planos e diálogo | Aprenda o formato completo; reserve tentativas extras para áudio e tenha aspas como alternativa |
| Animação de produto / imagem estática (I2VA) | Aprenda a versão leve: frase de alinhamento + movimento + campos de som |
| Storyboard ou série com consistência de personagem | Sim — as referências fazem o trabalho pesado; mantenha prompts mínimos e fáceis de rotear |
| Clipes únicos e uso casual | Pule a maior parte: descrição simples + non_diegetic_music: N/A resolvem o básico |
| Construir uma biblioteca única de prompts para vários modelos | Não — o dialeto de cada modelo precisa de sua própria versão; escreva para cada modelo |
Aprenda o formato para trabalhos com múltiplos planos, timestamps ou referências. É nesse cenário que sua aderência está documentada e pode ser reproduzida. Para clipes pontuais, pule a estrutura e espere novas tentativas, não obediência absoluta, em áudio carregado de diálogo.
A própria comunidade está dividida nesse equilíbrio. No mesmo mês, houve uma maratona de 48 horas ajustando um prompt de câmera e um post com 880 upvotes em que um comentarista escreveu que "reading the manual was actually exciting." Até que a aderência aos campos de áudio alcance a mesma consistência dos comandos de câmera, a estratégia mais prática é: deixe um agente montar a estrutura, confira você mesmo os campos de áudio e teste barato em 768p antes de se comprometer com 2K.