 AIREITER
O Liquid AI LFM3 reúne texto, visão, áudio e interação multimodal em seis modelos com cerca de 2 bilhões de parâmetros. O problema é que a própria página de preços da Liquid ainda não informa uma tarifa para o LFM3 em 27 de outubro de 2026. Por enquanto, isso define se ele é um especialista barato para dispositivos de borda ou apenas um lançamento para baixar e hospedar por conta própria.
LFM3 em uma frase: seis especialistas 2B, mas sem preço de API por enquanto
O LFM3 é a terceira geração de modelos fundamentais da Liquid AI voltada à inteligência especializada no dispositivo — não um único checkpoint. Toda a família compartilha o backbone LFM3-1.7B-Base, pré-treinado com 22 trilhões de tokens, e chega em seis versões: LFM3-1.7B, LFM3-VL-2B, LFM3-Audio-2B, LFM3-Omni-2B, d1-2B e d1-Omni-2B (anúncio).
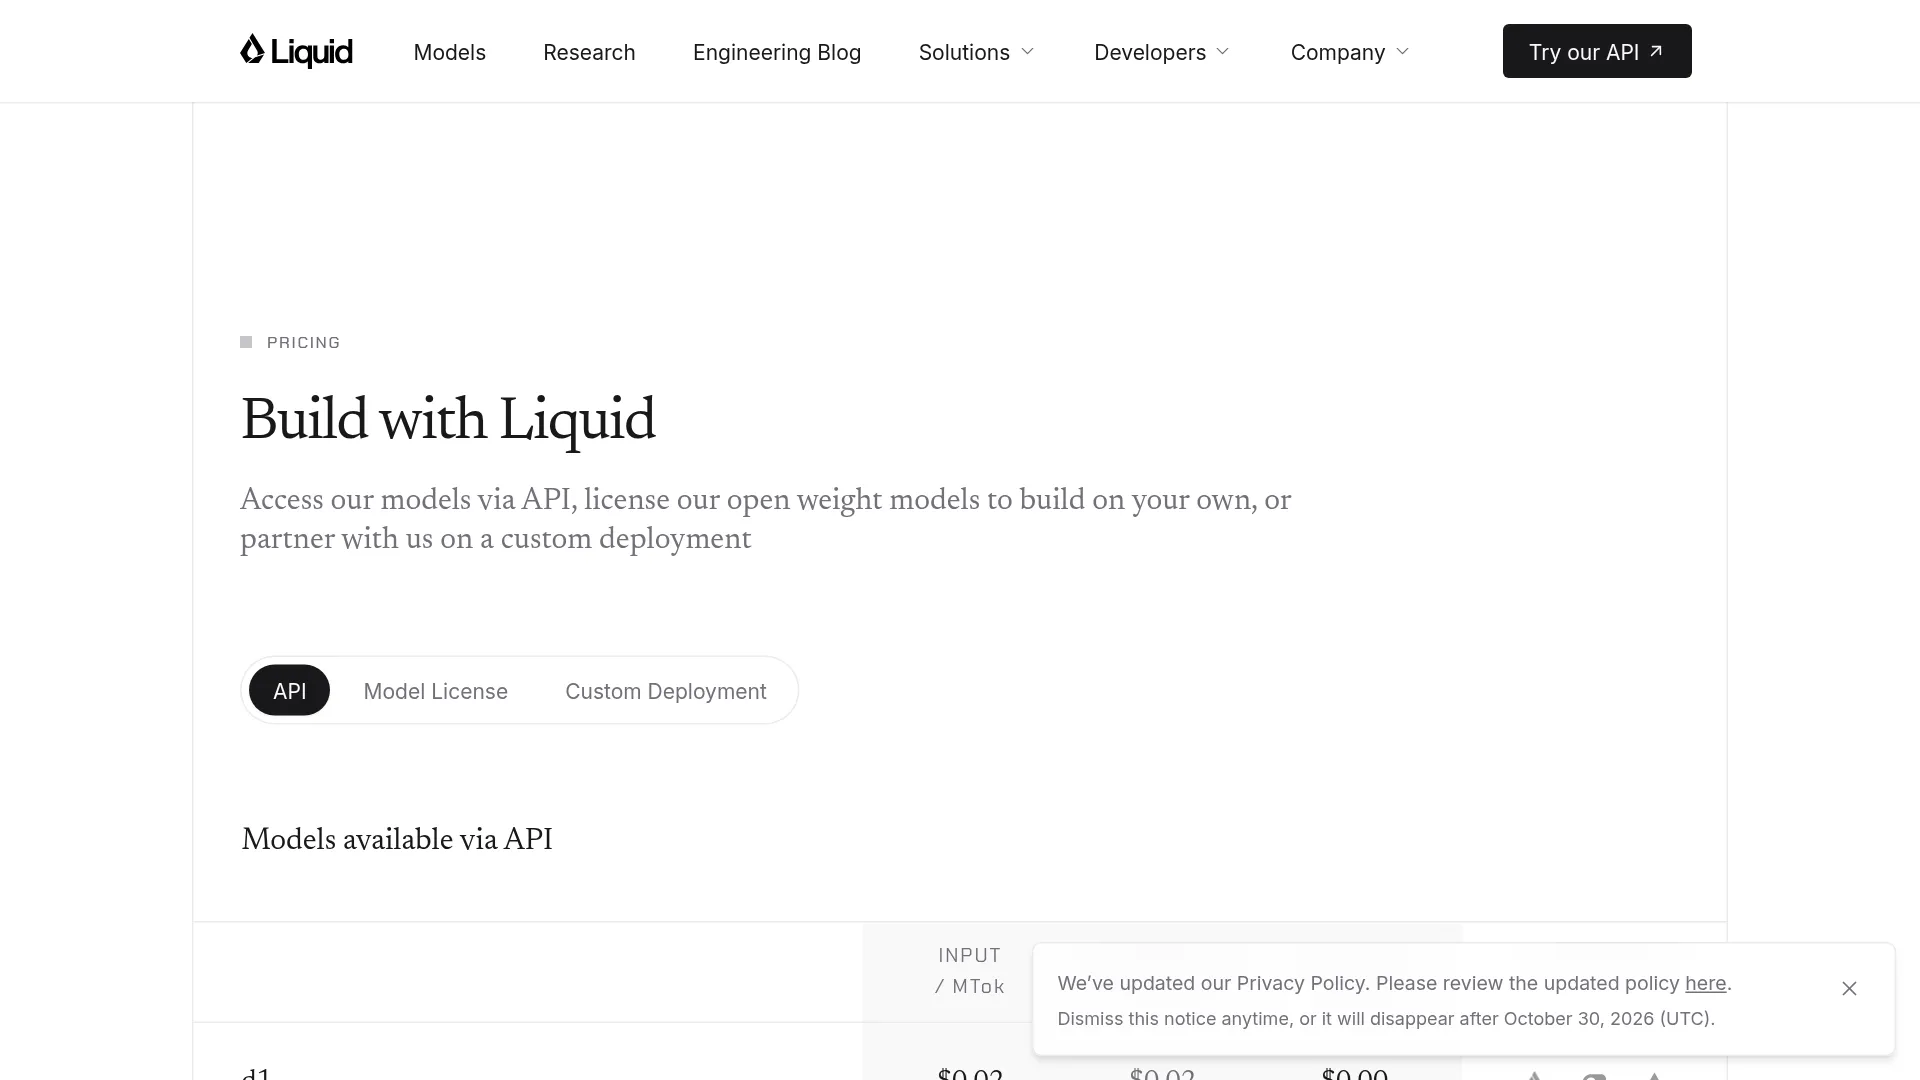
Consultei a página de preços da Liquid AI em 27 de outubro: não há uma entrada para o LFM3, apenas as tarifas do d1, d1-ultra e LFM2.5 apresentadas abaixo. O anúncio do LFM3 informa que os pesos estão disponíveis pelo Hugging Face, pelo Liquid Playground e pela Liquid API, mas hoje só os dois primeiros podem ser verificados diretamente. Organizações novas ainda recebem US$ 2 em créditos gratuitos no Liquid Console (preços).
Os seis modelos e a escolha certa para cada tarefa
Os seis checkpoints do LFM3 compartilham o mesmo backbone, mas aceitam entradas e entregam saídas diferentes.
| Modelo | Tamanho aprox. | Entradas | Saídas | Use para |
|---|---|---|---|---|
| LFM3-1.7B | 1.7B | Texto | Texto | Agentes locais, chamadas de ferramentas, saída estruturada |
| LFM3-VL-2B | 1.9B | Texto, imagens, vídeo | Texto | Entendimento de imagens e vídeos, agentes visuais |
| LFM3-Audio-2B | 2B | Texto, áudio | Texto, fala | Conversas por voz, reconhecimento, síntese e tradução em 18 idiomas |
| LFM3-Omni-2B | 2B | Texto, imagens, vídeo, áudio | Texto, fala | Assistente multimodal unificado |
| d1-2B | 2B | Texto, imagens, vídeo | Respostas calibradas | Classificação, extração e decisões em uma única passagem |
| d1-Omni-2B | 2B | Texto, imagens, vídeo, áudio | Respostas calibradas | Percepção multimodal com pontuações de confiança |
O LFM3-1.7B tem uma janela de contexto de 256 mil tokens e uma arquitetura tri-híbrida com 24 camadas: 13 camadas de convolução curta com gating, 5 camadas de atenção em janela deslizante com janela de 256 tokens e 6 camadas de atenção global (anúncio). A etapa final de treinamento intermediário, com 3,5 trilhões de tokens, adicionou trajetórias de agentes e chamadas de ferramentas. Isso ajuda a explicar por que a Liquid posiciona o modelo de texto para estruturas como Hermes Agent, Pi e OpenClaw (anúncio). O LFM3-VL-2B é o primeiro modelo de visão da Liquid com entrada de vídeo, enquanto o LFM3-Omni-2B é o primeiro modelo omnidimensional da empresa a processar simultaneamente trilha sonora e quadros (anúncio).
Os modelos de decisão funcionam de outra forma. O d1-2B e o d1-Omni-2B não fazem geração autorregressiva: eles retornam respostas calibradas com probabilidades em uma única passagem direta (anúncio). Segundo a Liquid, a latência de decisão do d1-2B é de 5,7 ms em uma NVIDIA H100 e 3,8 ms em uma AMD MI325X. No d1-Omni-2B, os números sobem para 12,4 ms e 8,2 ms, respectivamente, ao usar um clipe de áudio de 10 segundos (anúncio).
O que a Liquid afirma — e o que já dá para verificar
Os números de benchmark da Liquid AI foram divulgados pela própria empresa; trate-os como alegações do fornecedor até que surjam testes independentes. Todos os dados abaixo vêm do anúncio da Liquid.
| Modelo | Métrica informada pelo fornecedor | Resultado do LFM3 | Resultado anterior / concorrente |
|---|---|---|---|
| LFM3-1.7B | WebArena-Verified | 38.42 | 3.02 (LFM2.5-2.6B) |
| LFM3-1.7B | Tamanho / velocidade | 35% menos parâmetros, ~25% mais rápido por parâmetro em 8K que o LFM2-1.2B | — |
| LFM3-VL-2B | Média de visão 62 / encoder | 71.4 de média; encoder de 164M com 2,2x menos FLOPs | 57.6 de média; paridade de encoder com o Qwen3.5-2B alegada |
| LFM3-Audio-2B | UTMOSv2 / latência | 3.83; 50 ms até o primeiro token; 87x em tempo real na CPU do M4 Max | 3.22 (LFM2.5-Audio-1.5B) |
| d1-2B | ImajevBench | 75.5 | 64.0 (d1-3B) |
O que consegui verificar diretamente: a coleção LiquidAI LFM3 no Hugging Face lista as seis versões, incluindo variantes quantizadas, MLX e ONNX, e o catálogo do LM Studio já oferece variantes do LFM3 para desktops. Ainda assim, use as pontuações como indicação, não como garantia. Médias agregadas escondem diferenças em OCR, grounding e vídeo, e a cifra de 1 GB em 4 bits não inclui o cache KV nem a sobrecarga do aplicativo.
"é impressionante como hoje dá para fazer as coisas tão rápido." — @Nklockiewicz, rodando o LFM3 em um iPhone no modo avião via MLX/ExecuTorch a 40 tok/s (fonte)
"Normalmente eles entregam mais velocidade e inteligência do que o tamanho sugere, mas, na minha experiência, ainda não são inteligentes o bastante para 'trabalho de verdade'." — u/spaceman_, r/LocalLLaMA (fonte)
O limite de US$ 10 milhões na licença merece atenção antes do lançamento
A licença de pesos abertos da Liquid AI é gratuita até a receita anual da empresa ultrapassar US$ 10 milhões (preços). Desenvolvedores, pesquisadores, organizações sem fins lucrativos e empresas com receita anual inferior a US$ 10 milhões podem baixar, executar, ajustar e colocar qualquer LFM aberto em produção, manter os ajustes privados e fazer implantações em dispositivos móveis, na borda ou localmente, sem obrigação de copyleft (preços).
Empresas acima de US$ 10 milhões precisam de uma licença empresarial paga, com preço definido pela escala da implantação em contato com a equipe comercial. O uso em pesquisa, educação e organizações sem fins lucrativos continua gratuito e sem limite de receita (preços). A LFM Open License encerra a concessão comercial gratuita ao atingir esse limite; antes de incorporar os pesos a um aplicativo comercial, confirme com o jurídico as regras de atribuição, redistribuição e exportação.
Execução local: o que 1 GB exige na prática
O LFM3-1.7B ocupa cerca de 1 GB na versão de 4 bits, mas esse número considera apenas os pesos (anúncio). O processo em execução também carrega o runtime, o cache KV para contextos longos e quaisquer encoders de visão ou áudio. Reserve, portanto, memória RAM extra — especialmente nas versões VL e Omni, que processam quadros de vídeo ou clipes de áudio.
Comece pelo LFM3-1.7B e só passe para VL, Audio ou Omni quando houver necessidade. Antes de medir desempenho, confira as dependências adicionais no model card de cada versão. Os caminhos para Ollama, LM Studio, llama.cpp, MLX e ONNX estão listados na coleção do Hugging Face e no catálogo do LM Studio.
Quando um exemplo do model card exigir trust_remote_code=True, fixe um hash de commit, revise o código do repositório ou faça o primeiro teste em um ambiente isolado, pois essa flag executa o código enviado junto com o repositório. A Liquid fala em 18 idiomas para áudio no anúncio, mas não apresenta ali uma tabela de qualidade por idioma. Valide, portanto, os resultados em outros idiomas com seus próprios dados.
Acesso à API agora: onde chamar e como a cobrança funciona
O acesso ao LFM3 por API foi anunciado, mas ainda não tem preço separado na página pública da Liquid, que direciona as chamadas pelo Liquid Console, OpenRouter e Vercel AI Gateway (preços).
| Modelo de API listado em 27 de outubro | Entrada / MTok | Entrada em cache / MTok | Saída / MTok |
|---|---|---|---|
| d1 | US$ 0,02 | US$ 0,02 | US$ 0,00 |
| d1-ultra | US$ 0,042 | US$ 0,042 | US$ 0,00 |
| LFM2.5-24B-A2B | US$ 0,05 | US$ 0,025 | US$ 0,70 |
| Tarifas de texto do LFM3-1.7B / VL / Audio / Omni | Não listado | Não listado | Não listado |
Essa ausência é a resposta sobre o preço por enquanto: faça o orçamento do LFM3 como computação hospedada por você, somada ao tempo de engenharia, e não como uma linha de cobrança por token. Se algum provedor já oferecer tokens do LFM3, compare o valor com as referências publicadas para d1 e LFM2.5 e confirme se ele apenas encaminha as chamadas ao Liquid Console ou se serve seus próprios pesos. O preço listado de US$ 0,00 por milhão de tokens de saída no d1 pode torná-lo interessante para pipelines de inspeção em alto volume.
FAQ do LFM3
Quanto custa a API do LFM3?
A Liquid AI não informa um preço separado por token para o LFM3 em 27 de outubro de 2026; a página pública mostra apenas as tarifas do d1, d1-ultra e LFM2.5-24B-A2B.
O LFM3 é gratuito para uso comercial?
A produção comercial é gratuita para empresas com receita anual inferior a US$ 10 milhões, conforme a LFM Open License; empresas maiores precisam de uma licença empresarial paga.
O LFM3 roda em celular ou notebook?
Sim, no caso da versão de texto, com cerca de 1 GB em 4 bits mais a sobrecarga do runtime. Há caminhos por Ollama, LM Studio, llama.cpp, MLX e ONNX; as versões VL, Audio e Omni precisam de mais memória por causa dos encoders e das mídias.
O LFM3 é melhor que Qwen ou Gemma para agentes de borda?
Não encontrei uma comparação independente nos resultados do lançamento que consultei. As supostas vantagens da Liquid sobre o Qwen3.5-2B e o Qwen2.5-Omni-7B foram divulgadas pelo fornecedor (anúncio), então teste o LFM3 com Gemma e Qwen no seu próprio harness antes de migrar.
Posso ajustar o LFM3 em uma única GPU?
A Liquid oferece notebooks para SFT, DPO, GRPO e pré-treinamento contínuo e afirma que todos os modelos podem ser ajustados em uma única GPU (anúncio), mas não publicou os requisitos de VRAM ou de tamanho do conjunto de dados.
Especialista privado e barato ou generalista pequeno que depende do seu harness?
O LFM3 faz sentido quando os dados precisam permanecer no dispositivo, quando a mídia não pode sair do ambiente local ou quando o volume de decisões torna a cobrança por tokens na nuvem pesada. Ele perde força em conhecimento amplo, raciocínio criativo longo ou qualidade pronta para uso sem ajustes no harness. Baixe uma variante, meça o desempenho com seus prompts e hardware e deixe esse resultado — não o gráfico de lançamento — decidir.