 AIREITER
Para um agente de código que trabalha com até cerca de 150K tokens de contexto, o Hy3 é a escolha mais inteligente e tem um custo por token de entrada praticamente igual. Mas, quando as sessões se estendem, o repositório cresce ou a aplicação precisa atender muita concorrência em produção, o DeepSeek V4 Flash leva vantagem em três pontos que o Hy3 não acompanha: janela de contexto de 1M de tokens, preço documentado de US$ 0,0028 para cache hit e teto de 2.500 requisições simultâneas. Esse é o resumo da decisão entre hy3 vs deepseek v4 flash. A análise se baseia em preços verificados em 14 de julho de 2026 nas documentações oficiais da DeepSeek e nas listagens ativas da OpenRouter, além de benchmarks independentes e relatos de quem usa os dois modelos diariamente no Hacker News e no Reddit.
Dois modelos, prioridades bem diferentes
A Tencent lançou a versão final do Hy3 em 6 de julho de 2026, atualizando o preview disponível desde 23 de abril. Segundo o anúncio, trata-se de um modelo Mixture-of-Experts com 295B de parâmetros totais e 21B ativos, estruturado em torno do que a empresa chama de raciocínio híbrido rápido e lento: o próprio modelo decide, a cada solicitação, quanto esforço de raciocínio deve aplicar. A janela de contexto chega a 256K tokens. Os pesos são abertos sob licença Apache 2.0, e a API roda no Tencent Cloud TokenHub.
O DeepSeek V4 Flash chegou em abril de 2026 como a camada rápida da família V4. Também é um MoE de pesos abertos — 284B de parâmetros totais e 13B ativos, segundo a Artificial Analysis —, mas usa licença MIT e foi otimizado para outro objetivo: servir 1M de tokens de contexto a baixo custo. Ele oferece modos com e sem thinking, sendo o primeiro o padrão, e suporta até 384K tokens de saída.
As contagens de parâmetros são próximas, mas a proposta de cada arquitetura não é. O Hy3 prioriza qualidade de raciocínio por token; o Flash concentra seus recursos em contexto longo, eficiência de cache e throughput. Na prática, quase todas as diferenças relevantes entre os dois vêm dessa divisão.
| Especificação (verificada em 2026-07-14) | Hy3 | DeepSeek V4 Flash |
|---|---|---|
| Parâmetros | 295B totais / 21B ativos | 284B totais / 13B ativos |
| Janela de contexto | 256K | 1M (384K máx. de saída) |
| Raciocínio | Thinking híbrido rápido/lento | Modos com thinking + sem thinking |
| Licença | Apache 2.0 | MIT |
| Lançamento | 6 de julho de 2026 (preview em 23 de abril) | Abril de 2026 |
| API oficial | Tencent Cloud TokenHub | api.deepseek.com (formatos OpenAI + Anthropic) |
O que os benchmarks mostram de fato
No Intelligence Index v4.1 da Artificial Analysis, o Hy3 marca 41 pontos, contra 37 do DeepSeek V4 Flash em modo de raciocínio com alto esforço. Quatro pontos nesse índice representam uma diferença concreta, aproximadamente a distância entre o Flash e os modelos de uma faixa abaixo. Ainda assim, não é uma separação de categoria: ambos ficam na faixa de modelos muito capazes, mas não de fronteira.
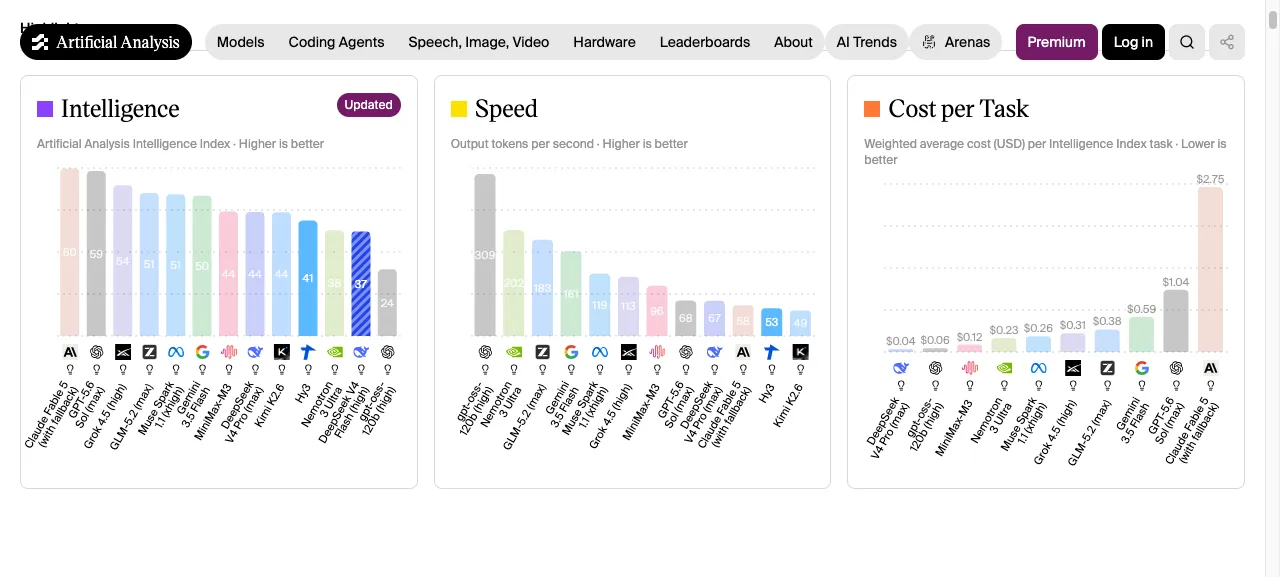
Antes de dar peso demais a essa pontuação, vale considerar duas ressalvas.
Primeiro, os benchmarks de programação com agentes pintam um cenário mais duro para os dois modelos. Um participante da thread de lançamento no Hacker News encontrou o resultado do Hy3 no DeepSWE: 28%, contra 52% do GPT-5.4 em esforço máximo. Nenhum dos modelos chineses está perto da fronteira em programação agentiva; eles disputam entre si, não o topo do ranking.
Segundo, tabelas de benchmark publicadas pelos próprios fornecedores merecem a cautela habitual. Os números de lançamento do Hy3 geraram acusações imediatas de "benchmaxxed" na thread do HN, enquanto as tabelas da DeepSeek cobrem apenas as avaliações que a empresa decidiu executar. Eu me apoiaria nos dados independentes acima: o Hy3 é um pouco mais inteligente, mas a diferença é pequena o bastante para que preço e contexto invertam a decisão.
Preços: não olhe só para o valor de tabela
Há duas tabelas de preços, verificadas em 14 de julho de 2026, que convém não misturar. A DeepSeek divulga preços exatos por token em sua API própria. Já a Tencent não publica uma tabela equivalente em inglês para o Hy3 final — o comunicado informa que a entrada do preview do Hy3 custava aproximadamente US$ 0,18 por milhão de tokens no TokenHub. Por isso, a coluna do Hy3 abaixo usa as tarifas listadas pela OpenRouter: preço de marketplace, não preço direto do fornecedor.
| Por 1M de tokens | Hy3 (marketplace OpenRouter) | DeepSeek V4 Flash (API própria) |
|---|---|---|
| Entrada | US$ 0,14 | US$ 0,14 (cache miss) |
| Entrada em cache | US$ 0,035 | US$ 0,0028 (cache hit) |
| Saída | US$ 0,58 | US$ 0,28 |
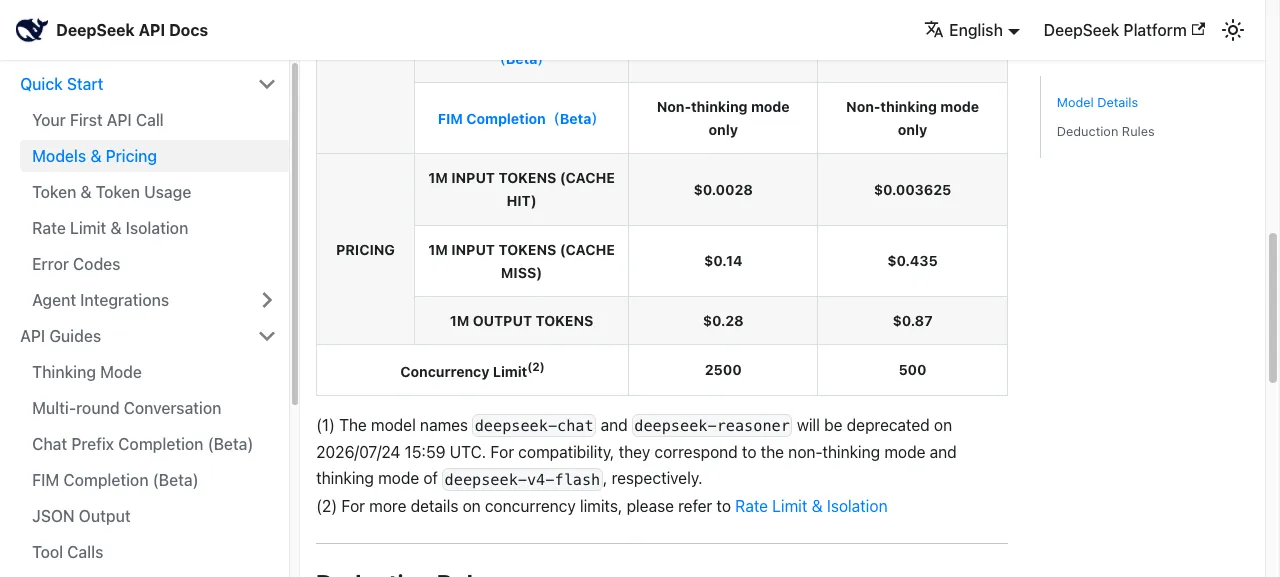
O preço de entrada é igual. A escolha se decide nas outras duas linhas.
O peso do cache hit
O preço de cache hit da DeepSeek é 50x menor que o de cache miss e 12,5x menor que a tarifa de entrada em cache do Hy3 na OpenRouter. As duas tarifas de cache não são estritamente equivalentes: a da DeepSeek é da API própria, enquanto a do Hy3 depende do que os provedores subjacentes da OpenRouter cobram pela leitura de cache. Ainda assim, são os valores que você pagaria hoje. Para agentes, esse é o número mais importante desta página. A cada turno, um agente reenvia o mesmo contexto crescente — prompt de sistema, definições de ferramentas, conteúdo de arquivos e histórico da conversa. Em uma sessão de 40 turnos, a maior parte dos tokens de entrada se repete. Com taxa de cache hit de 90%, o preço efetivo de entrada do Flash cai de US$ 0,14 para cerca de US$ 0,017 por milhão de tokens. No Hy3, cai para cerca de US$ 0,045: continua barato, mas é quase 3x mais caro, e a diferença aumenta conforme as sessões se prolongam.
O Hy3 pesa mais na saída
Os dois são modelos de raciocínio, portanto ambos cobram os tokens de thinking como saída. A tarifa de US$ 0,58 do Hy3 é mais que o dobro dos US$ 0,28 do Flash, então cada cadeia extensa de raciocínio custa aproximadamente o dobro para quem usa o Hy3. O Flash ainda tem uma saída que o Hy3 não oferece: mudar para o modo sem thinking em tarefas mecânicas, como formatação, extração e edições simples, evitando pagar por raciocínio desnecessário. A análise deepseek-v4-flash-vs-deepseek-v4-pro explica como essa alternância de modo funciona na prática.
O plano gratuito
Há uma vantagem real do Hy3: a OpenRouter lista a variante tencent/hy3:free sem custo, embora com limite de taxa. Para testar o modelo antes de assumir um compromisso, isso é melhor que o Flash, que não tem camada gratuita de API. O preview do Hy3 também continua listado a US$ 0,063/US$ 0,21 — abaixo do preço da versão final — para quem puder trabalhar com o checkpoint de abril.
O custo oculto de uma janela de contexto menor
Os 256K de contexto do Hy3 parecem mais que suficientes até você colocar um agente para trabalhar em uma base de código real. Um usuário do Reddit em r/hermesagent, usando os dois modelos no mesmo harness, descreveu o Hy3 como "quase idêntico, exceto pelo tamanho do contexto, então há compactação frequente". E compactar não é apenas inconveniente: cada ciclo consome tokens de saída para resumir, elimina detalhes e invalida o cache do prompt. Depois, é preciso pagar a tarifa de cache miss para reconstruí-lo.
A diferença se torna estrutural no self-hosting. O design de atenção esparsa da arquitetura V4 — a DeepSeek chama o mecanismo de lightning indexer — deixa o KV cache muito mais leve do que o da atenção convencional do Hy3. São relatos individuais, não benchmarks, mas os números da thread no HN chamam atenção: um participante que rodou ambos em um par de DGX Sparks relatou acomodar 3M de tokens de KV cache ao lado do DeepSeek V4 Flash, contra aproximadamente 130K tokens com o Hy3 quantizado em FP4. Outro estimou que, quando o llama.cpp oferecer suporte completo ao indexer, o contexto completo de 1M do Flash deve exigir apenas cerca de 6GB de RAM. O Flash também já mostrou resistência a quantização agressiva: diversos usuários na mesma thread relatam que ele segue coerente até em 2 bits, algo que ainda não foi demonstrado para o Hy3.
Se o seu caso de uso fica bem abaixo de 200K tokens, esta seção não traz custo algum, e os quatro pontos extras de inteligência do Hy3 vêm de graça. Caso contrário, o imposto de contexto se acumula: mais compactação, mais invalidação de cache e mais memória por sessão.
O que desenvolvedores relatam desde o lançamento
O sinal mais útil que encontrei não está em nenhuma tabela de benchmark. Ele aparece na diferença de comportamento que desenvolvedores descrevem ao rodar os dois modelos dentro de agentes de programação.
Um usuário da mesma thread do Hacker News, que passou a usar DeepSeek V4 Flash e Pro diariamente depois de cancelar a assinatura da Anthropic e então testou o Hy3, resumiu o Flash assim: ele é rápido, mas "frequentemente constrói um modelo mental completamente errado e sai seguindo pelo caminho errado", exigindo correções recorrentes e compactação do histórico. Na experiência dele, o Hy3 "não é tão rápido, mas até agora parece se manter no rumo com muito mais confiabilidade" e degrada menos conforme o contexto cresce. Outros participantes da mesma thread elogiaram o conhecimento geral e a qualidade de texto do Hy3, considerando-os melhores que os do Flash para um modelo desse porte.
No Reddit, o cenário favorece mais o Flash quando o critério é a saída bruta de código. Uma comparação da mesma tarefa em r/LLMDevs classificou "DeepSeek V4 Flash > Hy3 > GLM", embora ainda chamasse o Hy3 de "promissor para fluxos práticos de programação". Em r/opencode, a percepção recorrente é que o Flash é "mais que suficiente" para o trabalho cotidiano com agentes.
Também há o histórico operacional. A demanda pelo lançamento do Hy3 superou a capacidade de atendimento da Tencent: usuários na thread do HN relataram rate limiting intenso, e uma pessoa que acompanha o ranking público de uso da OpenRouter observou que o modelo caiu do topo para as posições 8ª–9ª em um mês, atribuindo a queda diretamente a esses limites. A DeepSeek, em contraste, documenta um teto de 2.500 requisições simultâneas para o Flash em sua API oficial — cinco vezes o permitido para o V4 Pro. Para tráfego de produção, um fornecedor publicou garantias de capacidade; o outro tem histórico de congestionamento.
Qual modelo faz mais sentido para você
- Agentes de código com sessões abaixo de ~150K tokens: Hy3. Tem maior qualidade de raciocínio, tende a se manter melhor na tarefa e iguala o preço de tabela de entrada do Flash. O limite de 150K, em vez dos 256K completos, existe porque o contexto de agentes cresce rápido e você precisa de folga antes de a compactação entrar em cena.
- Sessões longas, repositórios grandes e RAG sobre documentos extensos: Flash costuma ser a melhor escolha. A janela de 1M, junto do desconto de 50x no cache, coloca o modelo em outra classe de custo, e a sobrecarga de compactação do Hy3 consome sua vantagem de inteligência.
- APIs de produção em alto volume: Flash. São 2.500 requisições simultâneas documentadas, histórico de serviço mais estável e modo sem thinking para chamadas em massa mais baratas.
- Redação, pesquisa e tarefas de conhecimento geral: Hy3. Relatos da comunidade e as avaliações de conhecimento da AA favorecem o modelo nessa escala.
- Implantação local: Flash para a maioria dos hardwares. Há muito mais evidências práticas de eficiência do KV cache e resiliência à quantização; a própria orientação de serviço da Tencent para o Hy3, citada na thread de lançamento, é usar oito GPUs da classe H20.
- Teste antes de decidir: a camada gratuita do Hy3 na OpenRouter não custa nada. Rode suas próprias tarefas antes de acreditar em qualquer tabela de benchmark, inclusive nesta.
Onde usar cada modelo
DeepSeek V4 Flash: a API oficial atende endpoints no formato OpenAI (api.deepseek.com) e Anthropic (api.deepseek.com/anthropic), então ele entra em ferramentas compatíveis com Claude com uma simples troca de base URL. Atenção ao prazo de migração indicado na mesma página de preços: os nomes antigos deepseek-chat e deepseek-reasoner serão descontinuados em 24 de julho de 2026, mapeando respectivamente para os modos sem thinking e com thinking do Flash. A OpenRouter oferece o modelo por US$ 0,09/US$ 0,18, um pouco abaixo da tarifa oficial, mas sem o preço de cache hit da API própria.
Hy3: o Tencent Cloud TokenHub é o caminho direto. A OpenRouter disponibiliza a versão final, o checkpoint de preview mais barato e a camada gratuita. A SiliconFlow ofereceu promoções de lançamento. Também é possível hospedar o modelo localmente sob Apache 2.0, desde que você tenha as GPUs necessárias. O guia de configuração da API Hy3 mostra como obter uma chave e fazer a primeira chamada.
Perguntas frequentes
O Hy3 é gratuito?
Em parte. A OpenRouter lista uma camada tencent/hy3:free gratuita e limitada por taxa, enquanto produtos de consumo da Tencent, como Yuanbao e ima, usam o Hy3 sem cobrança. O acesso de API para produção via TokenHub ou pela camada paga da OpenRouter é tarifado por token.
Hy3 é o mesmo que Tencent Hunyuan?
Sim. O Hy3 é a terceira geração da linha de modelos Hunyuan da Tencent, que agora é comercializada pela empresa como "Tencent Hy". O preview foi lançado em 23 de abril de 2026, e a versão final em 6 de julho de 2026.
Qual é melhor para programação: Hy3 ou DeepSeek V4 Flash?
Os resultados da comunidade variam conforme o formato da tarefa. Comparações no Reddit com a mesma tarefa colocaram a saída bruta do Flash acima da do Hy3, enquanto usuários de agentes em sessões longas relatam que o Hy3 se mantém no rumo com mais confiabilidade. Tarefas curtas e bem delimitadas favorecem a velocidade do Flash; em sessões de agentes que duram horas, onde se desviar custa caro, o Hy3 tende a ser melhor — desde que o contexto fique confortavelmente dentro de sua janela de 256K.
Posso rodar o DeepSeek V4 Flash localmente?
Sim, e de forma mais prática que o Hy3. Os pesos usam licença MIT, o KV cache da arquitetura é incomumente leve e usuários relatam qualidade utilizável até com quantização de 2 bits em máquinas com ~96GB de RAM.
Por que a comparação de preços entre hy3 vs deepseek v4 flash é tão confusa?
Porque há pelo menos quatro tabelas de preço: Tencent TokenHub, as listagens da OpenRouter para o Hy3 final e o preview, e a API oficial da DeepSeek com sua tarifa separada para cache hit. Compare o preço efetivo para o padrão de tráfego da sua aplicação: entrada em cache domina cargas de agentes, e é nessa parte que a tarifa de US$ 0,0028 da DeepSeek é difícil de superar.
Veredito
Com base nas evidências independentes disponíveis, o Hy3 é o modelo mais forte; o DeepSeek V4 Flash é o serviço mais forte. Para cargas de API em produção, o Flash é minha escolha padrão: sua economia de cache, janela de contexto e concorrência publicada se combinam de um jeito que uma vantagem de quatro pontos em benchmark não compensa. Escolha o Hy3 quando a qualidade de raciocínio por prompt importar mais que escala — e comece pela camada gratuita, já que não custa nada comparar com suas próprias tarefas.