 AIREITER
Escolha o GLM-5.3-Flash para tarefas visuais nativas; prefira o DeepSeek V4 Flash para texto e código com alto aproveitamento de cache. No fim, o tipo de carga e o caminho de cobrança pesam mais do que um único benchmark.
A comparação começa pelos IDs dos modelos
Esta é uma comparação entre o GLM-5.3-Flash (glm-5.3-flash) e o modelo de produção da API da DeepSeek, o deepseek-v4-flash, identificado na página oficial de preços como DeepSeek-V4-Flash-0731. O DeepSeek V4 Pro e o endpoint separado deepseek-v4-flash-vision-exp não substituem o modelo Flash principal nesta análise. Para entender a identidade Ox Alpha, os limites de hardware e as ressalvas da prévia, consulte a análise do GLM-5.3-Flash da AIReiter.
A resposta curta para cada tipo de carga
| Se sua prioridade é… | Escolha | Por quê |
|---|---|---|
| Screenshot para código, inspeção de interfaces, vídeo ou entrada de arquivos | GLM-5.3-Flash | Entrada nativa de imagens, vídeos e arquivos em um único modelo |
| Processamento em massa apenas de texto, com altas taxas de acerto de cache | DeepSeek V4 Flash | Preço oficial mais baixo para entradas em cache, especialmente fora do horário de pico |
| Tráfego com muitas entradas novas e saídas durante a promoção da GLM | GLM-5.3-Flash | As tarifas promocionais de entrada e saída ficam abaixo das tarifas oficiais da DeepSeek para cache miss e saída |
| Programação intensa no terminal, com uma escolha conservadora para produção | DeepSeek V4 Flash | Rota pública versionada em beta e resultados oficiais de avaliação do Flash |
| Agentes visuais de navegador ou de uso do computador | GLM-5.3-Flash | O feedback visual permanece dentro do fluxo de programação ou uso de ferramentas |
| Um contexto de texto com 1 milhão de tokens | Nenhum dos dois por padrão | Ambos anunciam contexto na classe de 1 milhão de tokens; teste a recuperação no tamanho real dos seus prompts |
| Um único modelo para texto, código e imagens | GLM-5.3-Flash | Evita a necessidade de um endpoint de visão separado no fluxo multimodal principal |
O que as especificações oficiais realmente informam
A documentação de modelos da Z.AI e a página de preços da Z.AI descrevem o modelo e a cobrança do GLM. A documentação de Modelos e preços da DeepSeek e o registro de alterações trazem a versão correspondente do Flash e seus detalhes de recursos.
| Especificação | GLM-5.3-Flash | DeepSeek V4 Flash |
|---|---|---|
| ID do modelo na API | glm-5.3-flash | deepseek-v4-flash |
| Versão publicada | GLM-5.3-Flash | DeepSeek-V4-Flash-0731 |
| Janela de contexto | 1 milhão de tokens | 1 milhão de tokens |
| Máximo de saída listado na documentação oficial | 128 mil tokens | 384 mil tokens |
| Principais tipos de entrada | Texto, imagens, vídeo e arquivos | Texto e código; visão é um modelo experimental separado |
| Saída | Texto | Texto |
| Controle de raciocínio | Thinking ativado; reasoning_effort compatível | Modos thinking e non-thinking; níveis de esforço low, high e max |
| Ferramentas e saída estruturada | Chamadas de função, streaming, cache de contexto e saída em JSON | Chamadas de ferramentas, saída em JSON, Responses API e compatibilidade com a Anthropic API |
| Pesos | Pesos abertos publicados pelo provedor | Pesos abertos publicados pelo provedor |
Os 320 bilhões de parâmetros totais e 18 bilhões de parâmetros ativos do GLM descrevem uma arquitetura esparsa de especialistas, e não um checkpoint local de 18 bilhões; a página oficial de preços do Flash da DeepSeek não divulga uma contagem de parâmetros comparável.
O GLM aceita entradas visuais pelo caminho principal do modelo; a DeepSeek oferece o deepseek-v4-flash-vision-exp separadamente, o que muda as premissas de roteamento e teste.
Programação e agentes exigem dois testes diferentes
Agentes de terminal testam o uso de repositórios e ferramentas; agentes visuais também precisam interpretar interfaces renderizadas e estados de uma GUI.
Trabalho em terminal e repositórios
A tabela de lançamento da Z.ai e a atualização oficial de 31 de julho da DeepSeek relatam os seguintes resultados:
| Benchmark | GLM-5.3-Flash | DeepSeek V4 Flash | Status das evidências |
|---|---|---|---|
| Terminal Bench 2.1 | 84.3 | 82.7 | Avaliações reportadas separadamente pelos provedores |
| DeepSWE | 63.4 | 54.4 | Avaliações reportadas separadamente pelos provedores |
| Toolathlon Verified | 78.4 | 70.3 | Avaliações reportadas separadamente pelos provedores |
| AutomationBench | 48.8 | 25.1 | Avaliações reportadas separadamente pelos provedores |
| Agents’ Last Exam | 26.3 | 25.2 | Avaliações reportadas separadamente pelos provedores |
O GLM lidera esses benchmarks reportados pelos provedores, mas como os harnesses são diferentes, os resultados servem para colocar os modelos na lista de finalistas — não para decidir sozinhos.
As evidências independentes tornam a disputa menos desequilibrada. Em um teste realizado pela Composio em 27 de agosto, com 30 tarefas de agentes em múltiplas etapas, o GLM-5.3-Flash concluiu 21/30, contra 20/30 do DeepSeek V4 Flash. O DeepSeek foi o mais rápido em 19 das 30 tarefas, enquanto o custo reportado por tarefa concluída com sucesso ficou em cerca de $0.028 para o DeepSeek contra cerca de $0.06 para o GLM. Esses números vêm do teste da Composio, não de nenhum dos provedores.
Para agentes que trabalham principalmente no terminal, comece pelo DeepSeek V4 Flash quando velocidade, reprodutibilidade e uma rota inicial defensável forem as restrições. Inclua o GLM quando a qualidade do reparo na primeira tentativa ou um comportamento mais amplo com ferramentas justificar a comparação com esse custo menor.
Ferramentas, estados do navegador e feedback visual
O GLM se encaixa melhor quando o agente precisa inspecionar o resultado produzido pelo próprio código. A Z.ai descreve um ciclo em que o modelo lê screenshots ou interfaces renderizadas, altera a implementação e verifica o resultado novamente. Isso vale para screenshot para código, depuração de frontend, uso de navegador, documentos e alguns fluxos em 3D.
O DeepSeek lida com tarefas de agentes baseadas em texto e código por meio do deepseek-v4-flash; a entrada visual exige a rota separada deepseek-v4-flash-vision-exp. Se o pipeline existente já conta com roteamento de visão, essa separação pode ser aceitável. Mas, se o agente alterna entre código-fonte, uma captura do navegador e vídeo sem trocar de endpoint, o GLM é uma escolha mais simples. O guia da API DeepSeek V4 Flash Vision Exp aborda essa alternativa.
O que usuários reais relatam depois dos benchmarks
As evidências da comunidade apontam para uma troca de vantagens, não para um líder absoluto. Um relato de usuário após dois dias descreveu o GLM como competente em contextos menores, mas menos consistente à medida que o prompt crescia, embora tenha destacado o suporte a imagens:
“Quando cresce, ele começa a agir de forma ansiosa e descuidada.” — @XBToshi, relatando dois dias de uso intenso do GLM-5.3-Flash em uma comparação publicada
Isso é uma evidência anedótica, não uma taxa de falhas. Ainda assim, ela aponta para um modo de falha que as tabelas de benchmark não mostram: um limite de contexto amplo não garante um comportamento estável em agentes com várias interações.
Um pequeno experimento no Ollama também favoreceu o DeepSeek em unidades de cota específicas do provedor, mas o autor não equiparou essas unidades ao custo em dólares da API.
As evidências de latência e serving mudam a resposta
Não foi publicada uma comparação de latência p50 ou throughput usando o mesmo harness para esses modelos exatos; não transfira resultados do Pro, do Vision-Exp ou de outras rotas. A Composio considerou o DeepSeek o mais rápido em 19/30 tarefas de agentes, um sinal útil, mas que não mede throughput. Avalie o tempo até a primeira chamada de ferramenta útil em assistentes interativos e o tempo total até um resultado aceito em jobs em lote.
Preço por token não é custo por tarefa concluída
As tabelas oficiais de preços produzem um resultado mais complexo do que “o DeepSeek é mais barato”. A Z.AI lista uma promoção de 50% para o GLM-5.3-Flash até 9 de setembro de 2026 às 24:00 UTC+8. A DeepSeek cobra separadamente por cache hits e cache misses, com tarifas de pico e fora do pico.
Todos os valores abaixo estão em dólares americanos por 1 milhão de tokens.
| Item de cobrança | Promoção do GLM-5.3-Flash | Preço de tabela do GLM-5.3-Flash | DeepSeek V4 Flash fora do pico | DeepSeek V4 Flash no pico |
|---|---|---|---|---|
| Entrada nova/cache miss | $0.075 | $0.15 | $0.22 | $0.44 |
| Entrada em cache | $0.015 | $0.03 | $0.007 | $0.014 |
| Saída | $0.25 | $0.50 | $0.66 | $1.32 |
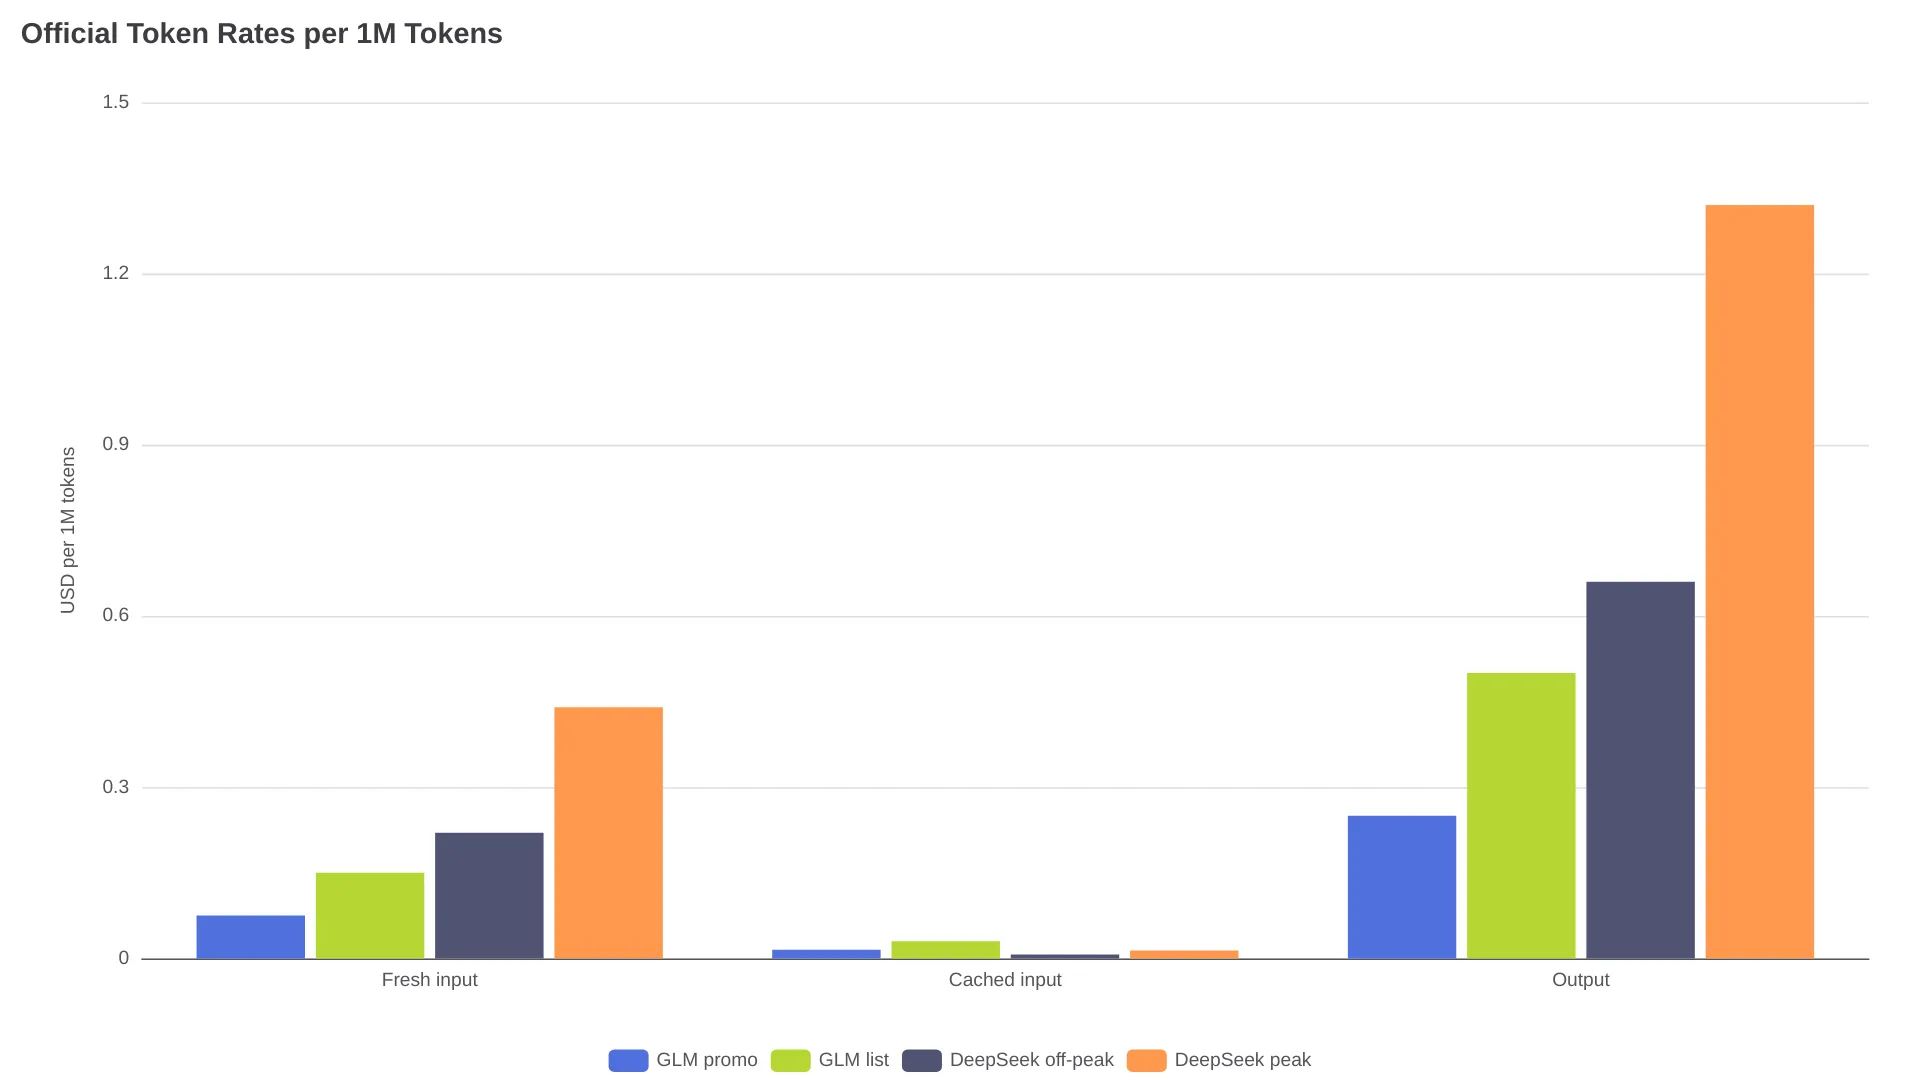
Os horários de pico da DeepSeek são 01:00–04:00 UTC e 06:00–10:00 UTC, de segunda a sexta-feira; todos os demais horários ficam fora do pico. A tabela oficial também lista concorrência de 2.500 para o V4 Flash. A página de preços do GLM informa armazenamento de entradas em cache gratuito por tempo limitado, mas não apresenta ali um número universal de concorrência.
- O DeepSeek vence no preço das entradas em cache em todos os períodos correspondentes.
- A promoção do GLM vence no preço de entradas novas e saídas em relação às tarifas oficiais da DeepSeek para cache miss e saída.
- Depois da promoção, as tarifas de tabela do GLM para entradas novas e saídas continuam abaixo das tarifas fora do pico listadas pela DeepSeek.
- O caso mais forte do DeepSeek em preço aparece em tráfego com muito cache, predominância de entradas e saídas curtas, especialmente quando agendado fora do horário de pico.
Exemplo com 10 milhões de tokens de entrada e 2 milhões de saída
Considere 10 milhões de tokens de entrada nova e 2 milhões de tokens de saída, sem taxas de ferramentas ou novas tentativas:
| Modelo e caminho de cobrança | Cálculo | Total |
|---|---|---|
| Promoção do GLM | 10 × $0.075 + 2 × $0.25 | $1.25 |
| Preço de tabela do GLM | 10 × $0.15 + 2 × $0.50 | $2.50 |
| DeepSeek fora do pico, cache miss | 10 × $0.22 + 2 × $0.66 | $3.52 |
| DeepSeek no pico, cache miss | 10 × $0.44 + 2 × $1.32 | $7.04 |
Se todos os 10 milhões de tokens de entrada forem cache hits, o total do DeepSeek fora do pico cai para $1.39 (10 × $0.007 + 2 × $0.66), enquanto o total promocional do GLM fica em $0.65 (10 × $0.015 + 2 × $0.25). A vantagem do DeepSeek no cache ganha importância quando a proporção entre entrada e saída é muito maior e a saída é curta.
Quando a conta menor do DeepSeek é decisiva
Escolha o DeepSeek V4 Flash quando a maioria das solicitações reutiliza um prefixo longo e estável de sistema ou repositório, gera respostas curtas e pode ser executada fora dos horários de pico. Classificação, extração, sumarização e automações rotineiras baseadas apenas em texto se encaixam melhor nesse perfil do que agentes orientados por screenshots.
Quando a capacidade extra do GLM pode sair mais barata no total
O GLM pode reduzir o custo do pipeline quando uma imagem, um documento ou um vídeo exigiria uma solicitação de visão separada. Sua tarifa promocional de saída também pesa em agentes que geram patches de código longos. Valide essa hipótese usando tokens faturados, ciclos de reparo e taxas de tarefas aceitas, em vez de presumir uma vantagem universal no custo por tarefa.
Contexto longo é uma afirmação de capacidade, não uma garantia de qualidade
As duas documentações oficiais listam uma janela de contexto de 1 milhão de tokens, então o tamanho do contexto, sozinho, termina empatado. A DeepSeek lista uma saída máxima de 384 mil tokens; a documentação de modelos da Z.AI lista saída máxima de 128 mil tokens para o GLM-5.3-Flash. Essa diferença só importa em aplicações que permitem gerações excepcionalmente longas.
A Z.ai informa 3.01× menos computação de atenção e 4.44× menos tamanho de KV-cache que o GLM-5.3, observando que o KV cache do GLM continua ligeiramente acima do do DeepSeek V4 Flash. Essas alegações do fornecedor não comprovam uma vantagem de latência ou de qualidade de recuperação sobre o DeepSeek.
Teste recuperação, conclusão de ferramentas e taxa de tarefas aceitas em 50 mil, 200 mil e no tamanho máximo real dos seus prompts, usando a regra de aceitação definida no gate abaixo.
Escolha um padrão ou roteie os dois
| Carga de trabalho | Primeiro modelo a testar | Fallback ou escalonamento |
|---|---|---|
| Classificação e extração somente de texto | DeepSeek V4 Flash | GLM se a formatação ou a qualidade falhar |
| Chat com repositório e alto aproveitamento de cache | DeepSeek V4 Flash | GLM em turnos de reparo mais difíceis |
| Agente de programação no terminal | DeepSeek V4 Flash | GLM quando a conclusão na primeira tentativa for importante |
| Screenshot para código | GLM-5.3-Flash | DeepSeek para tarefas posteriores apenas de texto |
| Agente de navegador ou uso do computador | GLM-5.3-Flash | DeepSeek em etapas de planejamento sem elementos visuais |
| Análise baseada em vídeo, imagem ou arquivo | GLM-5.3-Flash | DeepSeek Vision Exp se uma rota separada for aceitável |
| Texto longo com saída curta | DeepSeek V4 Flash | GLM se a recuperação perder qualidade |
| Geração longa de código durante a promoção | GLM-5.3-Flash | DeepSeek quando a economia dos cache hits dominar |
Antes de migrar uma carga de produção, execute um gate pequeno usando o mesmo harness:
- Fixe os IDs exatos:
glm-5.3-flashedeepseek-v4-flash; não permita que um roteador substitua silenciosamente o Pro ou o Vision-Exp. - Use de 20 a 50 tarefas reais, cobrindo jobs bem-sucedidos e falhas recentes. Inclua pelo menos cinco tarefas com uso de ferramentas se o produto for baseado em agentes.
- Registre taxa de aprovação, ciclos de reparo, chamadas de ferramentas omitidas, tempo até a primeira ação útil, total de tokens de entrada e saída e proporção de cache hits.
- Compare o custo por tarefa aceita e mantenha o outro modelo como fallback até que as taxas de timeout e falha estejam estáveis.
O guia de início rápido da Z.AI e o guia da primeira chamada de API da DeepSeek documentam o acesso compatível com a OpenAI; os controles de raciocínio, as rotas de visão e a lógica de cobrança não são idênticos.
As perguntas que os compradores ainda fazem
O GLM-5.3-Flash é o mesmo modelo que o Ox Alpha?
A Z.ai identificou oficialmente o GLM-5.3-Flash como o modelo que havia testado anonimamente como Ox Alpha. O roteamento da prévia, as cotas e o comportamento do endpoint não devem ser tratados como especificações permanentes do modelo público.
Use a tabela de roteamento e valide a escolha padrão com IDs fixados, casos reais de falha e o mesmo harness. A análise do GLM-5.3-Flash aborda as evidências de identidade e implantação; o guia da API DeepSeek V4 Flash Vision Exp cobre a rota visual separada.