 AIREITER
Antes de ser apresentado oficialmente, o modelo anônimo conhecido como Ox Alpha circulava entre usuários. Agora, a Z.ai revelou seu nome público: GLM-5.3-Flash. A novidade é importante, mas o termo “Flash” exige uma leitura cuidadosa: o modelo ativa 18B parâmetros por token, enquanto o checkpoint publicado tem cerca de 320B e ainda exige hardware robusto para rodar localmente.
Resposta curta: o Ox Alpha era a prévia do GLM-5.3-Flash
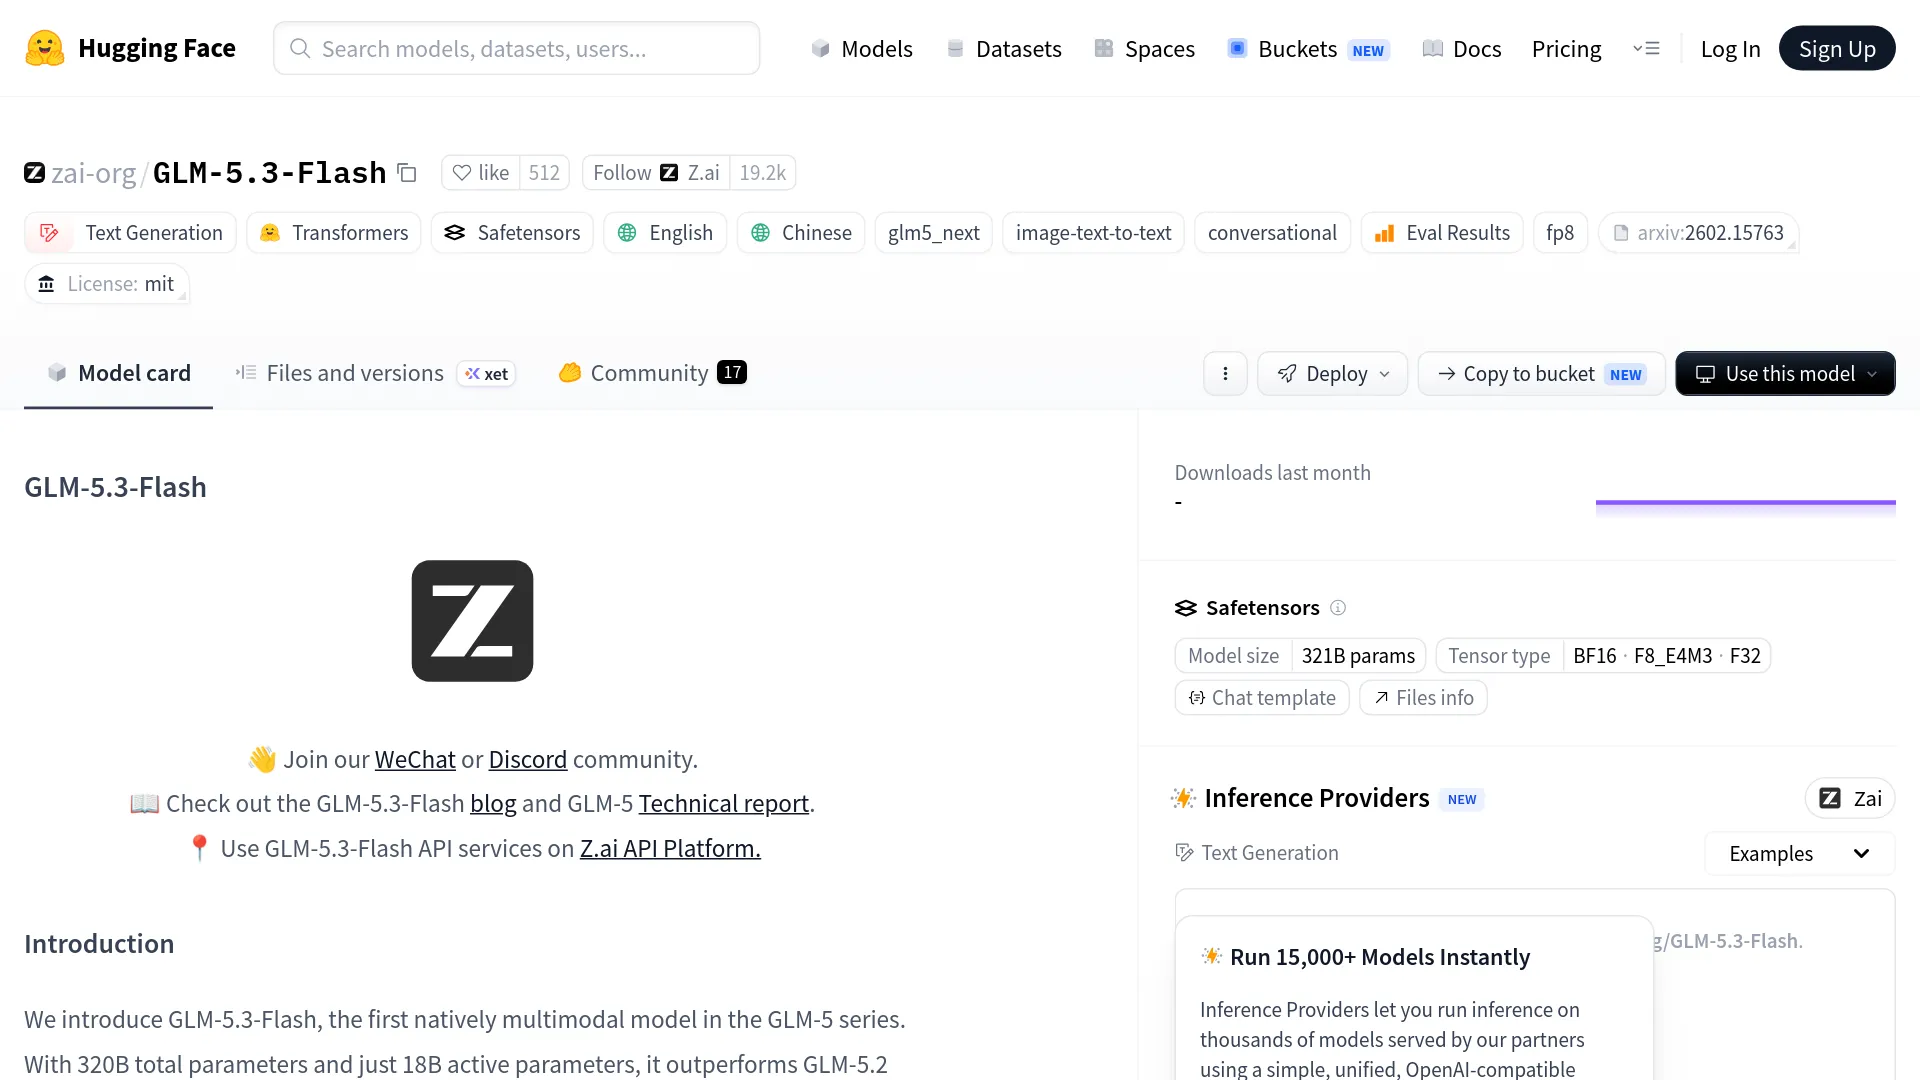
O anúncio da Z.ai em 26 de agosto de 2026 confirma que o GLM-5.3-Flash é o modelo apresentado anteriormente de forma anônima como Ox Alpha no OpenCode e no OpenRouter. A página oficial do modelo no Hugging Face agora lista o checkpoint público, a licença MIT, as entradas multimodais e referências para execução local.
Os relatos sobre o Ox Alpha devem ser vistos como evidências da fase de prévia, não como especificações definitivas do modelo lançado. O Ox Alpha tinha sua própria camada de roteamento, tráfego e condições operacionais. Por isso, os primeiros relatos sobre velocidade, cotas e políticas podem não representar todos os endpoints do GLM-5.3-Flash.
“Para mim, nada mudou. Os dois modelos são grandes demais para o meu sistema com 32 GB de RAM.” — u/dampflokfreund no r/LocalLLaMA
GLM-5.3-Flash em resumo
| Especificação | GLM-5.3-Flash |
|---|---|
| Lançamento oficial | 26 de agosto de 2026 |
| Nome da prévia anterior | Ox Alpha / ox-alpha |
| Arquitetura do modelo | 320B parâmetros no total, 18B ativos por token |
| Janela de contexto | 1.048.576 tokens (1M) |
| Entrada | Texto, imagens e vídeo |
| Saída | Texto |
| Licença | MIT |
| Checkpoint oficial | zai-org/GLM-5.3-Flash |
| Entrada na API | $0.15 por 1M de tokens |
| Entrada em cache | $0.03 por 1M de tokens |
| Saída na API | $0.50 por 1M de tokens |
A página do Hugging Face exibe um tamanho armazenado de aproximadamente 321B parâmetros, enquanto a descrição do modelo usa a forma abreviada 320B-A18B. Os números representam, respectivamente, a capacidade total armazenada e a quantidade de computação ativa por token. Ter 18B parâmetros ativos não transforma o checkpoint em um modelo local de 18B.
O que mudou do Ox Alpha para o modelo público
A Z.ai afirma ter operado o GLM-5.3-Flash anonimamente como Ox Alpha antes do lançamento público, usando o OpenCode e o OpenRouter para coletar feedback em situações reais. A página do OpenRouter apresentava a prévia como um modelo multimodal, com contexto longo e preço temporariamente fixado em $0. O lançamento público agora associa o modelo ao provedor, ao checkpoint e à licença.
A prévia e o modelo lançado continuam sendo ambientes operacionais distintos. Uma correspondência de tokenizador ou um erro de API no estilo GLM pode indicar a linhagem, mas não comprova que todas as solicitações anônimas usavam os pesos finais ou a mesma camada de roteamento. Para implantação e reprodutibilidade, o checkpoint público é a referência correta.
A arquitetura por trás do nome “Flash”
O GLM-5.3-Flash combina uma arquitetura esparsa de mistura de especialistas com mudanças no mecanismo de atenção voltadas à redução do custo em contextos muito longos. A Z.ai descreve 320B parâmetros no total, 18B parâmetros ativos, 45 camadas, atenção híbrida esparsa e linear, recuperação por IndexPool e Manifold-Constrained Hyper-Connections (mHC). O model card também atribui o treinamento a um corpus multimodal de pré-treinamento com 30T tokens.
A Z.ai afirma que o modelo usa 3 vezes menos computação de atenção e tem um cache KV 4,4 vezes menor em contexto de 1M, na comparação com o GLM-5.3. São alegações arquiteturais do fornecedor, não uma garantia de latência independente do hardware. Na prática, a velocidade ainda depende do tamanho do contexto, da concorrência, do pré-processamento visual e da infraestrutura de serving.
A multimodalidade nativa do modelo é mais interessante para agentes do que para o rótulo genérico de “chatbot com visão”. A proposta da Z.ai é permitir que um agente examine interfaces renderizadas, estados do navegador, documentos ou outros artefatos visuais e, em seguida, revise o código ou o resultado produzido. O model card oficial demonstra entrada de imagem, enquanto o modelo público e a documentação de implantação também descrevem entrada de vídeo.
O que a tabela de benchmarks mostra — e o que não mostra
O lançamento oficial e o model card apresentam resultados fortes, especialmente em tarefas de programação e agentes. Entre os números visíveis no model card estão 84,3 no TerminalBench 2.1, 63,4 no DeepSWE e 55,3 no HLE. O material de lançamento da Z.ai também informa pontuação 57 no Artificial Analysis Intelligence Index, 48,8 no AutomationBench e desempenho máximo de 29,0 no Z.ai Code Bench.
| Benchmark | GLM-5.3-Flash | Comparativo ou referência | Fonte e limitação |
|---|---|---|---|
| TerminalBench 2.1 | 84,3 | GLM-5.2: 81,0; Claude Opus 4.8: 85,0 | Resultado da Z.ai/model card; harnesses e limites de uso fazem diferença |
| DeepSWE v1.1 | 63,4 | GLM-5.2: 46,2 | Avaliação reportada; não generalize para todos os repositórios |
| AutomationBench | 48,8 | GLM-5.2: 26,2 | Avaliação reportada com uma versão específica do benchmark |
| Z.ai Code Bench, esforço máximo | 29,0 | Claude Opus 4.8: 29,5 | Alegação de quase empate sob as condições da Z.ai |
| Artificial Analysis Intelligence Index v4.1.1 | 57 | A Z.ai diz ser comparável ao Claude Opus 4.8 | Índice externo; a mistura de tarefas não representa uma pontuação exclusiva de programação |
Os resultados divulgados usam harnesses, limites de contexto, tempos limite e avaliadores diferentes. Portanto, vale compará-los como indicadores de direção, não como posições em um ranking universal. A conclusão mais justa é que o GLM-5.3-Flash apresenta evidências convincentes de uma grande evolução sobre o GLM-5.2 em avaliações de agentes de programação — não que supere todos os modelos de fronteira em qualquer cenário.
A mesma cautela vale para os testes iniciais da comunidade. O @prz_chojecki relatou que o Ox Alpha teve desempenho melhor que o GLM-5.2 em todos os 226 problemas do ErdosBench. É uma observação útil para criar casos de teste, mas não substitui uma avaliação controlada com suas próprias ferramentas e seu repositório.
As limitações práticas encontradas pelos primeiros usuários
“Flash” descreve melhor o volume de computação ativa e o posicionamento de preço do que a latência interativa. Discussões de usuários no r/opencodeCLI relataram tanto bons resultados em programação quanto esperas frustrantes, especialmente durante a prévia anônima. São observações específicas do provedor e da carga de trabalho, não benchmarks oficiais de latência.
“Como ele pode ser chamado de ‘Flash’ se é muito mais lento que o modelo principal?” — u/ahriad no r/opencodeCLI
O sinal operacional mais relevante é a confiabilidade de agentes em tarefas longas, sob carga. O @solomonneas relatou 30 builds concluídos com sucesso em 49 tentativas durante um teste de sete dias, com 14 falhas causadas por timeouts. Isso não comprova uma taxa fixa de falhas na API oficial, mas justifica manter uma rota alternativa para tarefas que podem levar horas.
O modelo também tem uma limitação de implantação local que os destaques dos benchmarks costumam esconder: o checkpoint oficial em FP8 ocupa cerca de 306 GiB antes dos custos adicionais de execução e do cache KV. Portanto, um modelo com 320B parâmetros totais exige uma infraestrutura com muita memória, mesmo ativando apenas 18B parâmetros a cada token.
Opções de API, acesso hospedado e execução local
Para uso hospedado, a página de preços da Z.ai lista o GLM-5.3-Flash a $0.15 por 1M de tokens de entrada, $0.03 por 1M de tokens de entrada em cache e $0.50 por 1M de tokens de saída. Uma promoção temporária de 50% reduz os valores para $0.075 na entrada, $0.015 na entrada em cache e $0.25 na saída, até 24:00 de 9 de setembro de 2026, UTC+8. Consulte a tabela oficial de preços da Z.AI antes de montar o orçamento, pois a promoção tem data para terminar.
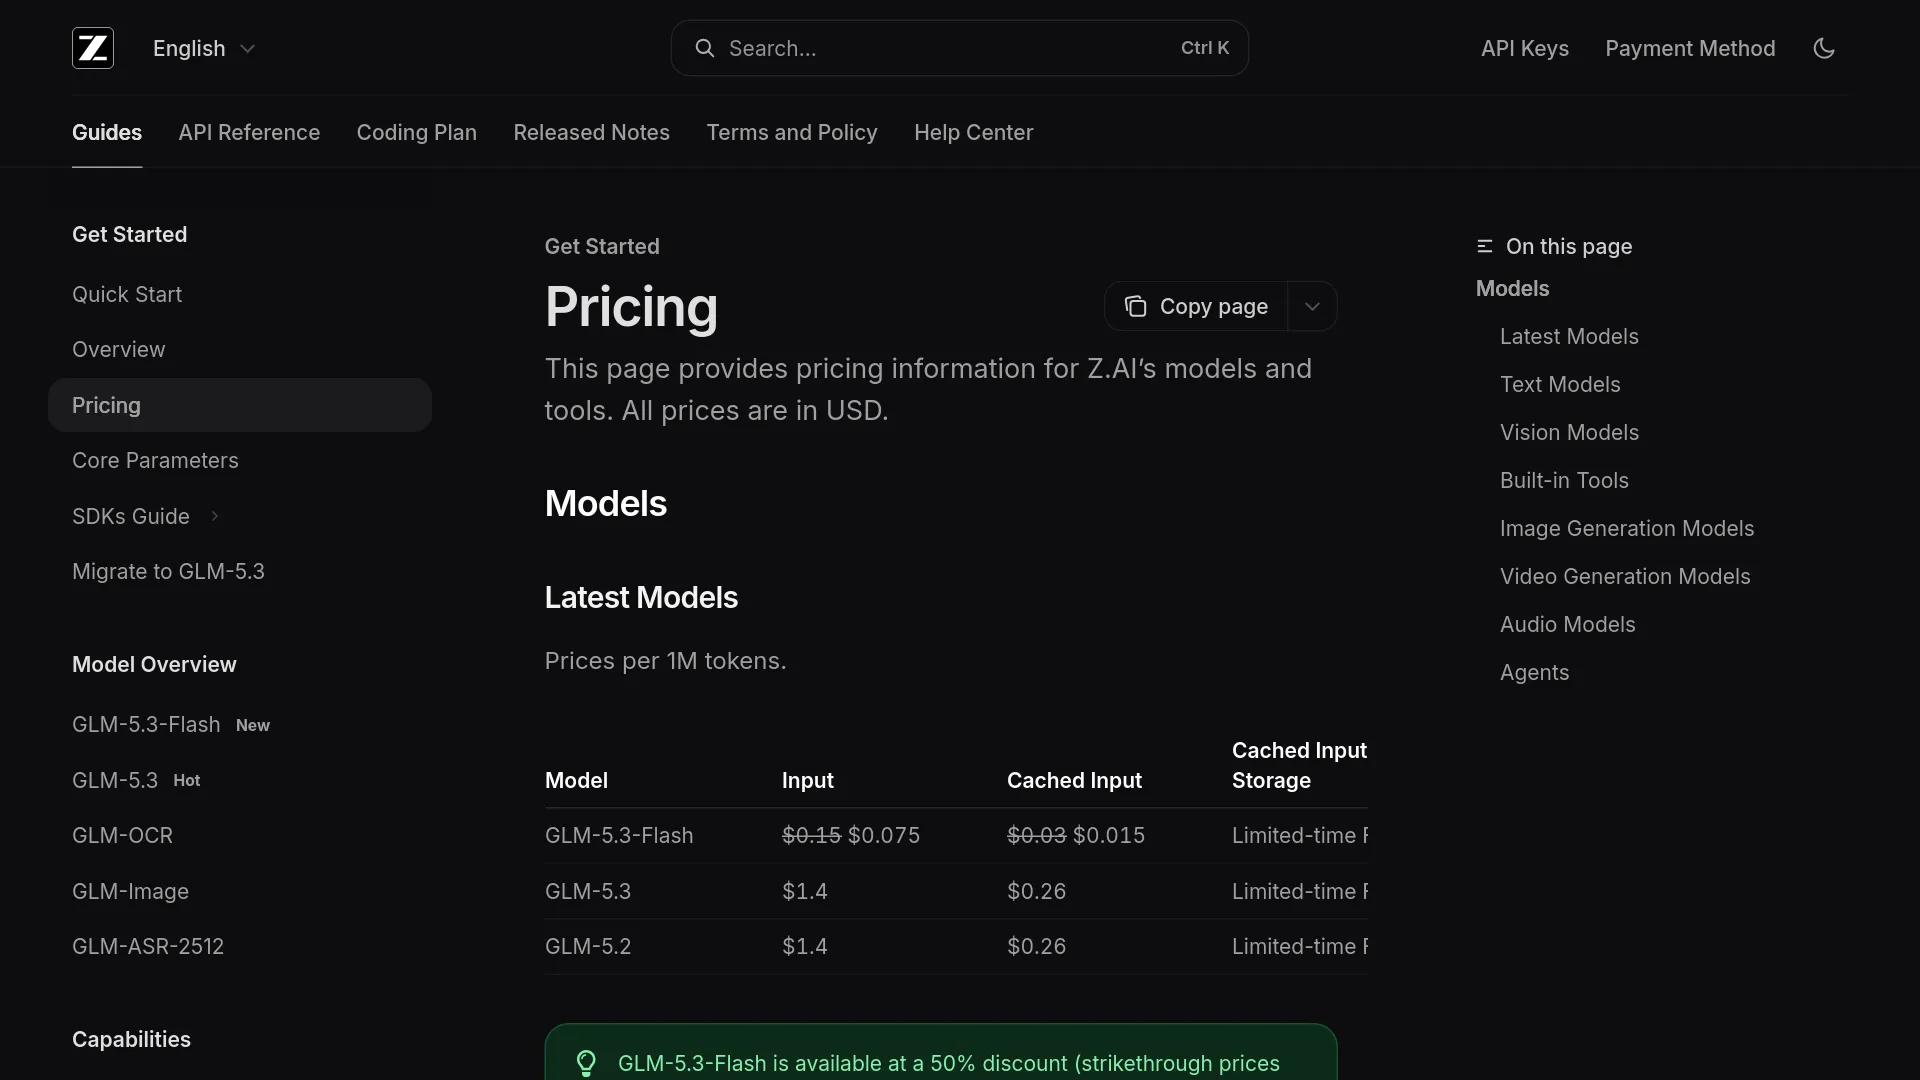
O preço regular publicado é diferente do valor temporário da prévia do Ox Alpha. Em um exemplo simples, 10M tokens de entrada mais 2M tokens de saída custariam $2.50 pelo preço de tabela, antes de outras tarifas do provedor: 10 × $0.15 + 2 × $0.50. A entrada em cache pode reduzir essa parcela quando o provedor cobra esses tokens como conteúdo armazenado em cache.
É possível rodar o modelo localmente, mas isso está mais para um projeto de infraestrutura do que para um download em notebook. A receita oficial do vLLM indica aproximadamente 306 GiB para os pesos em FP8 e 386GB de VRAM na implantação FP8 padrão; o BF16 aparece com requisito de 772GB. No caminho documentado, atualmente são necessárias GPUs NVIDIA Hopper ou mais recentes, uma versão recente do FlashInfer e uma imagem dedicada do vLLM enquanto a integração amadurece.
O tutorial do KTransformers documenta inferência heterogênea entre CPU e GPU, uso direto dos pesos oficiais em FP8 e pelo menos 350GB de memória de sistema livre. O exemplo com uma única GPU usa uma configuração de offload; ele não indica que uma GPU de consumo consiga armazenar o modelo inteiro. O tutorial também usa uma configuração validada de 501.025 tokens e limita cada solicitação multimodal a oito imagens ou um vídeo.
| Rota de implantação | O que a documentação oferece | Principal restrição |
|---|---|---|
| API da Z.ai | Acesso hospedado com cobrança por uso; tarifas regulares e promocionais publicadas | Verifique limites de requisição, termos regionais e a promoção vigente |
| vLLM | Serving em FP8/BF16, endpoint compatível com OpenAI, paralelismo de tensores e caminho multimodal | Infraestrutura NVIDIA com muita memória; a receita atual tem como alvo Hopper+ |
| KTransformers | Inferência heterogênea entre CPU e GPU e carregamento em FP8 | Cerca de 306 GiB apenas para os pesos; recomenda-se pelo menos 350GB de memória de sistema |
| Ecossistema Ollama/LM Studio/llama.cpp | O model card aponta para distribuições quantizadas e ferramentas compatíveis | O suporte a quantização e a velocidade dependem da compilação específica |
Quem deve usar o GLM-5.3-Flash agora?
Use-o em agentes de programação com foco em custo e em pilotos de engenharia com contexto longo. O preço baixo, o contexto de 1M e a evolução relatada sobre o GLM-5.2 fazem dele um candidato forte para análise de repositórios, alterações em vários arquivos, geração de testes e chamadas repetidas de agentes. Mantenha testes de aceitação e um modelo alternativo no fluxo até que sua própria taxa de sucesso se mostre estável.
Use-o em tarefas técnicas multimodais quando os modelos GLM de texto forem o gargalo. A entrada de imagens e vídeos pode ajudar um agente a examinar resultados de navegador, layouts de interface, diagramas, documentos e artefatos renderizados. O modelo não gera vídeos; ele interpreta entradas visuais e devolve texto ou código.
Não o escolha apenas porque “18B ativos” parece sinônimo de modelo para desktop. O checkpoint completo tem cerca de 320B parâmetros, e a execução local exige centenas de gigabytes de armazenamento ou memória antes mesmo de considerar o contexto e os custos da execução. Para a maioria dos casos, o acesso pela API hospedada é a opção econômica mais simples, a menos que você já opere hardware de inferência com muita memória.
Não envie código confidencial para um endpoint de prévia sem verificar sua procedência. O lançamento público do GLM-5.3-Flash está associado à Z.ai, mas os termos do provedor, a retenção de dados e o roteamento continuam sendo relevantes. Em tráfego de produção, registre a política de dados vigente do endpoint e use a API oficial ou um provedor cujos termos operacionais possam ser auditados.
Perguntas frequentes
O Ox Alpha é exatamente igual ao GLM-5.3-Flash?
A Z.ai identifica oficialmente o GLM-5.3-Flash como o modelo que havia sido disponibilizado em prévia como Ox Alpha. O comportamento inicial do Ox Alpha continua sendo um contexto útil, mas o roteamento e os limites da prévia não devem ser tratados como especificações do modelo público.
O GLM-5.3-Flash é open source?
O checkpoint oficial no Hugging Face foi lançado sob a licença MIT, e a Z.ai fornece referências para execução local. A descrição operacional mais precisa é “pesos abertos”: os pesos estão disponíveis, mas executar o modelo completo ainda exige uma infraestrutura considerável.
Quanta memória o GLM-5.3-Flash exige localmente?
Os pesos oficiais em FP8 ocupam cerca de 306 GiB antes dos custos adicionais de execução e do cache KV. A receita do vLLM lista 386GB de VRAM para sua implantação FP8 padrão, enquanto o KTransformers recomenda pelo menos 350GB de memória de sistema para a inferência heterogênea.
A API realmente custa $0.15 por milhão de tokens de entrada?
Sim. A página oficial de preços da Z.AI lista $0.15 para entrada, $0.03 para entrada em cache e $0.50 para saída. A promoção de 50% aparece válida até 9 de setembro de 2026, UTC+8.
O GLM-5.3-Flash é mais rápido que outros modelos Flash?
As evidências disponíveis não estabelecem um ranking universal de latência. Os primeiros usuários relataram sessões lentas ou encerradas por timeout. Por isso, meça o tempo até o primeiro token, o tempo total de conclusão, as tentativas repetidas e a taxa de tarefas aceitas na sua própria rota de provedor.
O GLM-5.3-Flash aceita imagens e vídeos?
Sim. A Z.ai e o model card oficial descrevem entradas de texto, imagem e vídeo, com saída em texto. A documentação de execução local acrescenta limites de requisição, como até oito imagens ou um vídeo na configuração documentada do KTransformers.
Use a API hospedada quando quiser aproveitar o custo e a multimodalidade do GLM-5.3-Flash sem comprar uma máquina de inferência com centenas de gigabytes; experimente a execução local apenas se essa infraestrutura já estiver disponível. Para tarefas longas de agentes, mantenha um modelo alternativo testado, porque as evidências públicas são mais fortes em capacidade e preço do que em confiabilidade interativa sustentada.