 AIREITER
Se você está procurando alternativas ao GLM-5-3-Flash, provavelmente não precisa de mais uma explicação sobre a revelação do Ox Alpha. O que você precisa é substituir uma rota de agente barata, mas às vezes lenta, evitar um checkpoint local de 320B ou manter o processamento multimodal sem reconstruir seu cliente de API. A melhor opção depende do problema que você quer resolver.
A resposta curta: escolha pelo problema que está tentando corrigir
DeepSeek V4 Flash é a rota de texto mais flexível quando preço de cache, modo opcional sem raciocínio e alta concorrência são importantes. O modelo tem contexto de 1M de tokens, limite de concorrência de 2.500 requisições e preço oficial fora do horário de pico de US$ 0,22 por milhão de tokens de entrada sem cache e US$ 0,66 por milhão de tokens de saída.
Qwen3.8-Flash é a alternativa hospedada para testar quando entrada de imagem e vídeo, compatibilidade de API e ferramentas integradas fazem diferença. A tarifa informada é de US$ 0,15 por milhão de tokens de entrada e US$ 0,47 por milhão de tokens de saída.
GLM-5.3 é o caminho de evolução dentro da mesma família para quem quer continuar na Z.ai, mas precisa do modelo de texto topo de linha da empresa. Já o GPT-5.6 Terra e o Claude Opus 4.8 são opções premium para tarefas em que concluir mais uma execução vale pagar várias vezes mais. O Kimi K3 oferece capacidade de contexto de 1M, mas não é um substituto barato.
A decisão não é “qual modelo vence?”. A questão é saber se você está otimizando custo por token, entrada visual, programação de longo prazo, controle local ou taxa de tarefas aceitas.
O endpoint do Ox Alpha acabou; comece pelo estado da sua migração
O anúncio oficial da Z.ai identificou a prévia anônima Ox Alpha como GLM-5.3-Flash em 26 de agosto de 2026. O lançamento público trouxe um checkpoint com nome definido, preços publicados, um modelo do Hugging Face sob licença MIT e acesso documentado à API. O ambiente antigo de prévia não deve ser tratado como um contrato permanente de modelo: roteamento, cotas, latência e comportamento de políticas podem ser diferentes na API lançada.
Se alguma configuração ainda chama stealth/ox-alpha, o identificador público na OpenRouter é z-ai/glm-5.3-flash; nas requisições diretas à Z.ai, use a URL-base geral https://api.z.ai/api/paas/v4. A Z.ai documenta um endpoint separado para o Coding Plan, https://api.z.ai/api/coding/paas/v4. Portanto, não presuma que a rota de assinatura e a API geral tenham cobrança ou limites idênticos.
A avaliação do GLM-5.3-Flash publicada pela AIReiter cobre o ponto de partida, incluindo a diferença entre 18B parâmetros ativos e aproximadamente 320B parâmetros no checkpoint completo. Este artigo responde à pergunta seguinte: o que deve entrar no lugar dele quando custo, velocidade, hardware ou confiabilidade deixarem de fazer sentido?
“Para mim, nada mudou. Os dois modelos são grandes demais para o meu sistema com 32 GB de RAM.” — u/dampflokfreund, r/LocalLLaMA
Alternativas comparadas por preço, contexto e forma de implantação
Os preços abaixo são retratos das tarifas informadas pelos provedores, verificados em 28 de agosto de 2026. Não se trata de uma única promoção uniforme: a DeepSeek altera os valores entre os horários de pico e fora do pico, enquanto o preço do Flash na Z.ai inclui um desconto temporário até 9 de setembro de 2026 às 24:00 UTC+8.
| Modelo | Entrada / 1M de tokens | Saída / 1M de tokens | Contexto | Modalidades de entrada | Principal motivo para substituir |
|---|---|---|---|---|---|
| DeepSeek V4 Flash | US$ 0,22 fora do pico; US$ 0,44 no pico | US$ 0,66 fora do pico; US$ 1,32 no pico | 1M | Texto | Roteamento de texto atento ao cache e modo sem raciocínio |
| Qwen3.8-Flash | US$ 0,15 | US$ 0,47 | 1M | Texto, imagem, vídeo | Multimodalidade hospedada e compatibilidade de API |
| GLM-5.3 | US$ 1,40 | US$ 4,40 | 1M | Texto | Mesmo provedor, com um modelo de maior capacidade dentro da família |
| GPT-5.6 Terra | US$ 2,00 | US$ 12,00 | 1,05M | Texto | Trabalho complexo de agentes com maior confiança |
| Claude Opus 4.8 | US$ 5,00 | US$ 25,00 | 1M | Texto | Programação difícil e revisão de contexto longo |
| Kimi K3 | US$ 3,00 | US$ 15,00 | 1M | Texto | Tarefas de alta capacidade com contexto longo |
Atualmente, a Z.ai lista o GLM-5.3-Flash a US$ 0,075 por milhão de tokens de entrada, US$ 0,015 por milhão de tokens de entrada em cache e US$ 0,25 por milhão de tokens de saída durante a promoção de 50%. Os preços de tabela são US$ 0,15, US$ 0,03 em cache e US$ 0,50. O gráfico comparativo usa o preço de tabela, não o valor promocional temporário. (Preços da Z.ai)
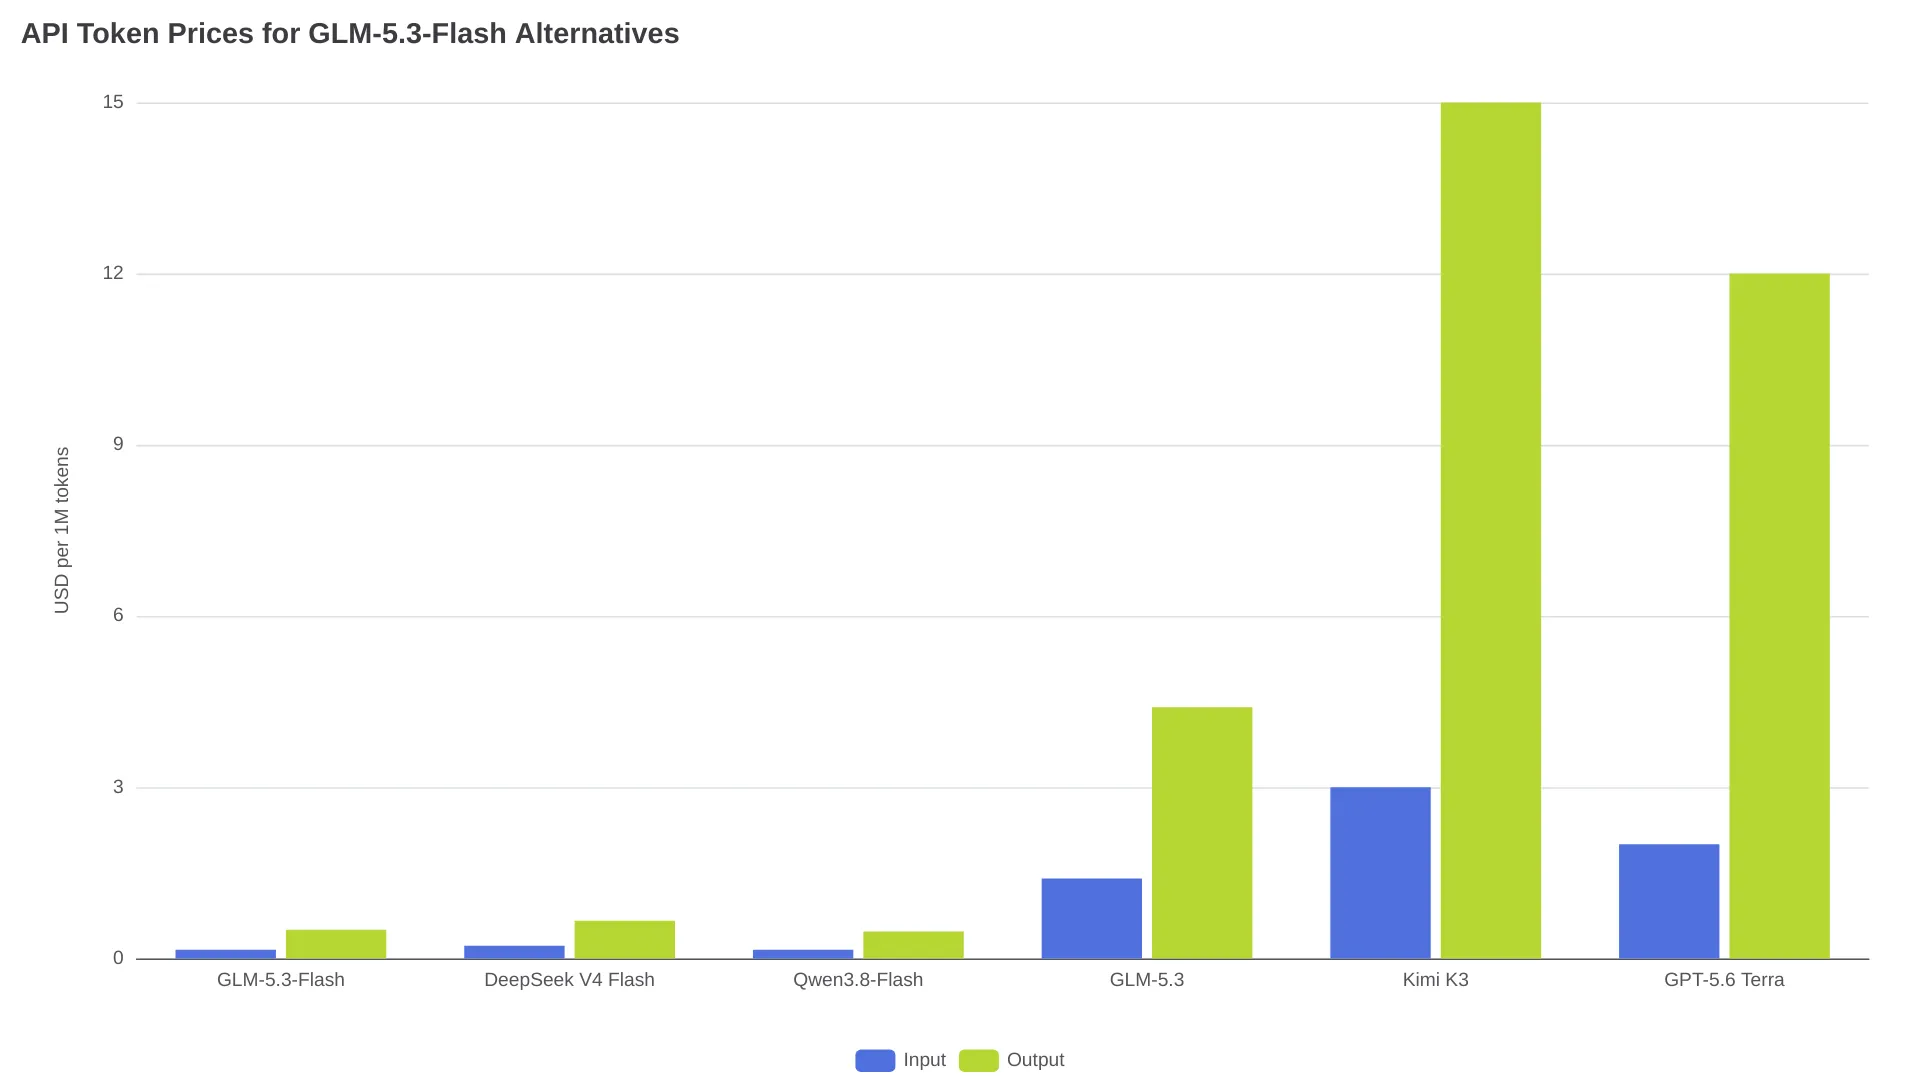
Base de preços: valor de tabela do GLM-5.3-Flash, preço oficial fora do pico do DeepSeek V4 Flash e tarifas atuais informadas pelos provedores nas demais linhas. O preço do DeepSeek no horário de pico é o dobro do valor fora do pico.
Os seis caminhos de substituição que fazem sentido
DeepSeek V4 Flash: texto e programação com foco em cache
DeepSeek V4 Flash é o primeiro modelo a testar quando o GLM-5.3-Flash fica caro demais para o tráfego rotineiro de texto. A DeepSeek lista contexto de 1M de tokens, saída máxima de 384K, saída em JSON, chamadas de ferramentas, Responses API e acesso compatível com Anthropic. O limite oficial de concorrência é de 2.500 requisições.
A diferença na cobrança é importante. A DeepSeek separa acertos e falhas de cache e dobra as tarifas nos períodos de pico dos dias úteis, das 01:00 às 04:00 e das 06:00 às 10:00 UTC. O modelo também oferece modos com e sem raciocínio, enquanto o cartão do modelo GLM-5.3-Flash documenta níveis de esforço de raciocínio baixo, alto e máximo, em vez de uma rota simples sem raciocínio.
Escolha o DeepSeek V4 Flash para cargas com contexto repetido, chats baseados em recuperação de informação e programação somente em texto nas quais acertos de cache ou controle do raciocínio sejam importantes. O Qwen3.8-Flash tem tarifas publicadas menores para tokens novos, então o DeepSeek não é automaticamente a opção mais barata para toda requisição de texto. Ele também não substitui visualmente o modelo de forma direta: a entrada de imagens pertence à rota separada deepseek-v4-flash-vision-exp, e os tokens derivados das imagens são cobrados como entrada.
Qwen3.8-Flash: o substituto multimodal hospedado mais próximo
Qwen3.8-Flash é a alternativa hospedada mais próxima para testar se seu agente envia capturas de tela, gráficos ou vídeos e você quer manter uma integração com formato de API semelhante. A QwenCloud lista entradas de imagem, texto e vídeo; contexto de 1M de tokens; entrada máxima de 991K; e saída máxima de 131K. O modelo oferece APIs compatíveis com OpenAI e Anthropic, ferramentas, saída estruturada, cache, processamento em lote, busca na web e ajuste fino.
O ponto de atenção operacional é a estrutura de cache. A QwenCloud informa leituras de cache implícito a US$ 0,016 por milhão de tokens, criação de cache explícito a US$ 0,20 e saída a US$ 0,47. Os limites publicados são de 2M de tokens por minuto e 15.000 requisições por minuto, mas a página não esclarece se eles se aplicam por conta, chave, organização ou implantação.
Escolha o Qwen3.8-Flash quando a entrada visual for essencial ou o preço de tokens novos pesar mais. A página oficial do modelo não oferece uma tabela de benchmarks identificada, resultados de latência ou estudo de confiabilidade em sessões longas. Portanto, valide o modelo com os rastros dos seus próprios agentes, em vez de presumir que paridade de recursos significa paridade de comportamento.
GLM-5.3: a evolução dentro da família quando o Flash não basta
GLM-5.3 não é a alternativa econômica. Ele é o caminho natural quando o problema é falta de profundidade em tarefas de texto, e não preço ou multimodalidade. A tabela de preços da Z.ai informa US$ 1,40 por milhão de tokens de entrada, US$ 0,26 por milhão de tokens de entrada em cache e US$ 4,40 por milhão de tokens de saída — aproximadamente uma ordem de grandeza acima do preço de tabela do Flash.
A Z.ai apresenta o GLM-5.3 como seu modelo de programação topo de linha, enquanto o GLM-5.3-Flash é o modelo multimodal nativo de menor custo. Use o GLM-5.3 seletivamente em tarefas difíceis que priorizam texto; migrar para ele pode eliminar o fluxo visual que tornava o Flash útil.
GPT-5.6 Terra: para execução de agentes com mais confiança
GPT-5.6 Terra é uma opção premium para equipes que valorizam concluir tarefas difíceis mais do que pagar pouco por token. A OpenAI informa US$ 2 por milhão de tokens de entrada, US$ 0,20 por milhão de tokens de entrada em cache e US$ 12 por milhão de tokens de saída, com uma janela de contexto de aproximadamente 1,05M de tokens. Na tabela de benchmarks publicada pela Z.ai, o GPT-5.6 Terra marca 87,4 no Terminal-Bench 2.1 e 69,6 no DeepSWE v1.1, acima dos 84,3 e 63,4 do GLM-5.3-Flash nas configurações citadas.
Esses números justificam testar o Terra quando uma tarefa de programação malsucedida custa mais do que uma API mais cara; eles não comprovam uma superioridade universal em produção. Use o modelo como uma camada de escalonamento para alterações de alto valor em repositórios ou trabalhos autônomos complexos.
Claude Opus 4.8: para programação difícil e revisão de contexto longo
Claude Opus 4.8 custa US$ 5 por milhão de tokens de entrada e US$ 25 por milhão de tokens de saída na tabela global padrão da Anthropic. A empresa também informa leituras de cache a US$ 0,50 por milhão de tokens e tarifas de processamento em lote equivalentes à metade dos preços padrão de entrada e saída.
Na tabela comparativa da Z.ai, o Opus 4.8 supera o GLM-5.3-Flash no Terminal-Bench 2.1, Agents’ Last Exam, HLE with Tools e NL2Repo, enquanto o Flash lidera em várias categorias que exigem muitas ferramentas e automação. Essa divisão torna o Opus mais útil como modelo de escalonamento avaliado do que como padrão universal.
Kimi K3: para tarefas com contexto de 1M, não para inferência barata
Kimi K3 entra nesta lista por atender a um motivo diferente de migração: talvez você queira uma rota com contexto de 1M para fluxos longos de engenharia de software ou pesquisa. A Kimi informa US$ 0,30 por milhão de tokens de entrada em cache, US$ 3 por milhão de tokens de entrada e US$ 15 por milhão de tokens de saída.
Com essas tarifas, escolha o Kimi K3 somente quando seu contexto e perfil de capacidade justificarem o preço premium. Ele não responde à pergunta “como reduzir minha conta de tokens?”.
Escolha a alternativa pela carga de trabalho, não pela posição no ranking
| Sua carga ou restrição | Primeiro modelo a testar | Por quê |
|---|---|---|
| Classificação ou extração de texto em volume | Qwen3.8-Flash | Tarifas publicadas menores para entrada e saída novas do que as do DeepSeek V4 Flash fora do pico |
| Texto longo com prefixos repetidos | DeepSeek V4 Flash | Preço para acertos de cache e modo opcional sem raciocínio |
| Texto longo com entrada principalmente nova | Qwen3.8-Flash | Tarifas publicadas menores para tokens novos |
| Capturas de tela, gráficos ou vídeo em um fluxo de API | Qwen3.8-Flash | Entrada nativa de imagem e vídeo, além de protocolos de API conhecidos |
| Mesmo ecossistema da Z.ai, mas com raciocínio de texto mais difícil | GLM-5.3 | Mantém o provedor e sobe um nível dentro da família |
| Programação em que falhas custam caro | GPT-5.6 Terra | Escalonamento premium com pontuações de programação citadas mais fortes |
| Revisão cuidadosa de código ou planejamento de repositórios | Claude Opus 4.8 | Raciocínio premium, com opções de cache e processamento em lote |
| Trabalho de longo horizonte em que contexto importa mais do que preço | Kimi K3 | Posicionamento de capacidade com contexto de 1M |
| Notebook comum ou estação de trabalho com 32 GB | API hospedada primeiro | O GLM-5.3-Flash é um checkpoint com aproximadamente 320B de parâmetros no total, não um modelo local de 18B |
A restrição de implantação local é considerável. O checkpoint oficial do GLM-5.3-Flash é descrito como tendo aproximadamente 320B de parâmetros no total; a análise de implantação da AIReiter registra um footprint em FP8 de cerca de 306 GiB e uma implantação padrão com vLLM exigindo aproximadamente 386 GB de VRAM. A quantização reduz a exigência, mas não transforma o modelo em um download normal para notebook.
Um padrão de migração mais seguro para agentes
Mantenha o adaptador do provedor separado do roteamento de tarefas e avalie o substituto com base no trabalho que realmente importa.
- Use uma única interface de requisição. Preserve a camada compatível com OpenAI para mensagens, ferramentas e saída estruturada quando o provedor oferecer suporte a ela. Trate controles de raciocínio, payloads de visão, chamadas de ferramentas, saídas estruturadas e limites de contexto como sinalizadores de capacidade, não como campos universais.
- Teste tarefas aceitas, não apenas o texto gerado. Registre se o código compila, se a chamada de ferramenta é válida, se a verificação visual passa e se a tarefa termina sem nova tentativa. Uma primeira resposta barata que exige mais duas tentativas do tamanho de um repositório pode não sair mais barata.
- Faça o roteamento pelo tipo de falha. Envie textos com contexto repetido para o DeepSeek V4 Flash, requisições multimodais para o Qwen3.8-Flash e tarefas de programação de alto risco para GPT-5.6 Terra, Claude Opus 4.8 ou GLM-5.3, de acordo com seus resultados de aceitação.
- Mantenha um fallback. A avaliação da AIReiter registra um teste comunitário de sete dias com 30 builds concluídos em 49 tentativas e 14 falhas por timeout. Isso não representa uma taxa universal de falha do provedor, mas já é motivo suficiente para não operar um agente de produção com uma única rota.
- Faça o orçamento com preços normais. A promoção do Flash da Z.ai termina em 9 de setembro de 2026. As tarifas da DeepSeek mudam conforme o horário de pico. A criação e a leitura de cache da Qwen usam preços diferentes. Uma migração que só funciona durante uma tarifa temporária não é um modelo de custo estável.
Um primeiro teste prático é executar dez requisições rotineiras ou focadas em texto, além de dez tarefas de programação, uso de ferramentas ou processamento visual. Compare a taxa de tarefas aceitas, o tempo total de conclusão, as novas tentativas e o gasto total com tokens. Para muitas equipes, isso significa testar o DeepSeek V4 Flash para textos com contexto repetido e o Qwen3.8-Flash para trabalhos multimodais, mantendo o GLM-5.3-Flash como fallback até que as novas rotas provem ser confiáveis.
Perguntas frequentes
Qual é a melhor alternativa gratuita ao Ox Alpha?
Nenhum substituto gratuito permanente e independente de provedor foi estabelecido pelas fontes oficiais consultadas aqui. Os provedores podem oferecer cotas ou promoções que mudam com o tempo, mas uma decisão de produção deve usar as tarifas pagas publicadas e tratar o acesso gratuito como um bônus.
Qual alternativa oferece suporte a imagens e vídeos?
O Qwen3.8-Flash lista oficialmente entradas de imagem, texto e vídeo. A rota padrão do DeepSeek V4 Flash é diferente da rota deepseek-v4-flash-vision-exp. Por isso, teste o endpoint exato antes de migrar um agente visual.
Qual alternativa posso executar localmente?
Entre as opções de pesos abertos estão o checkpoint GLM-5.3-Flash e o Qwen3.8-Flash-Next. O GLM-5.3-Flash tem aproximadamente 320B de parâmetros no total, enquanto a documentação do Flash-Next de pesos abertos da Qwen descreve um contexto nativo de 262K que pode ser ampliado para 1M com YaRN. Não presuma que nenhum dos dois caiba em uma máquina com 32 GB.
Como evitar surpresas depois de trocar de provedor?
Execute 20 tarefas representativas em duas rotas e compare a taxa de tarefas aceitas, o tempo total de conclusão, as novas tentativas e o gasto total com tokens. Mantenha a rota atual do GLM-5.3-Flash como fallback até que a substituta prove ser confiável com suas próprias ferramentas e repositórios.