 AIREITER
O GLM-5.2 ocupa o 2º lugar no ranking Code Arena Frontend da Arena (1.595 Elo) e fica a apenas um ponto do Claude Opus 4.8 no FrontierSWE. Ainda assim, muita gente está tentando deixá-lo para trás. O problema quase nunca é capacidade. Desde o lançamento, em junho de 2026, os relatos de desenvolvedores citados abaixo repetem os mesmos obstáculos: cotas dos planos de programação que acabam no meio da tarefa, erros nos horários de pico e um consumo de tokens que torna o preço de US$ 1,40/US$ 4,40 bem menos atraente em loops longos de agentes. A melhor alternativa ao GLM-5.2 depende do obstáculo que você acabou de encontrar.
Escolhas rápidas: a melhor alternativa ao GLM-5.2 para cada caso
Cinco veredictos logo de cara — as evidências aparecem mais adiante:
- Cota acabando / custo por loop de agente: DeepSeek V4 Flash, a US$ 0,14/M de entrada, US$ 0,28/M de saída e contexto de 1M.
- Loops de agentes instáveis: Kimi K2.7 Code, a US$ 0,95/M de entrada e US$ 4,00/M de saída.
- Limite para as tarefas mais difíceis: Claude Opus 4.8, com o dobro da pontuação do GLM-5.2 no SWE-Marathon, pelo preço de um modelo fechado.
- Self-hosting ou controle dos dados: Qwen3-Coder (Apache 2.0) ou os próprios pesos MIT do GLM-5.2, caso você tenha 372–475 GB de RAM para uma versão em 4 bits.
- Nada está errado; você só quer algo mais novo: GLM-5.3 pelo mesmo preço de US$ 1,40/US$ 4,40, confirmado pela Z.ai no dia do lançamento.
O que o GLM-5.2 faz bem — e quanto custa mantê-lo em operação
A documentação oficial da Z.ai apresenta o GLM-5.2 como seu principal modelo de texto, com janela de contexto de 1M de tokens, saída máxima de 128K e preços de API de US$ 1,40/M de entrada, US$ 4,40/M de saída e US$ 0,26/M de entrada em cache. Os pesos usam a licença MIT e foram liberados em 16 de junho de 2026, depois de uma distribuição inicial, em 13 de junho, que deixou o modelo restrito ao GLM Coding Plan. No model card, ele aparece com 81,0 no Terminal-Bench 2.1 (Opus 4.8: 85,0), 62,1 no SWE-bench Pro (Opus 4.8: 69,2) e 74,4 no FrontierSWE, contra 75,1 do Opus 4.8.
Esses números colocam o GLM-5.2 na fronteira dos modelos fechados, mas com preços de modelo aberto. O problema aparece na operação diária. O plano Pro do Coding Plan passou de menos de US$ 35 para US$ 65 por mês por volta do lançamento do 5.2 — aumento registrado por @bridgemindai no mesmo dia. As cotas do plano geram reclamações ainda mais fortes que o preço:
"O GLM 5.2 acaba com seu limite semanal em um dia." — u/intl_spy, r/opencode
"Eu gosto do GLM-5.2, mas meu Deus, ele devora tokens." — @atomtanstudio
Um desenvolvedor que usa agentes autoevolutivos com o GLM-5.2 em trabalho real relatou ter gasto mais de US$ 500 em um único fim de semana. Segundo ele, trocar de modelo durante a execução elimina o cache KV e obriga a pagar novamente pelo mesmo contexto (@Xianbao_QIAN). Outro resumiu de forma direta o limite da proposta de valor:
"O GLM 5.2 é ótimo, mas minha assinatura do Codex de US$ 200/mês ainda me dá mais uso do que US$ 200 em consumo da API do GLM 5.2. É um excelente modelo complementar... mas não substitui o Codex de jeito nenhum." — @mweinbach
Também há problemas de capacidade nos horários de pico. @gengdaJ, assinante do plano desde o GLM-4.5, descreve servidores "explodindo" à noite e o sistema recorrendo a modelos mais antigos. É esse o quadro completo por trás das buscas por "alternativas ao GLM-5.2" feitas até por quem gosta do modelo.
Alternativas com preço e indicação para cada problema
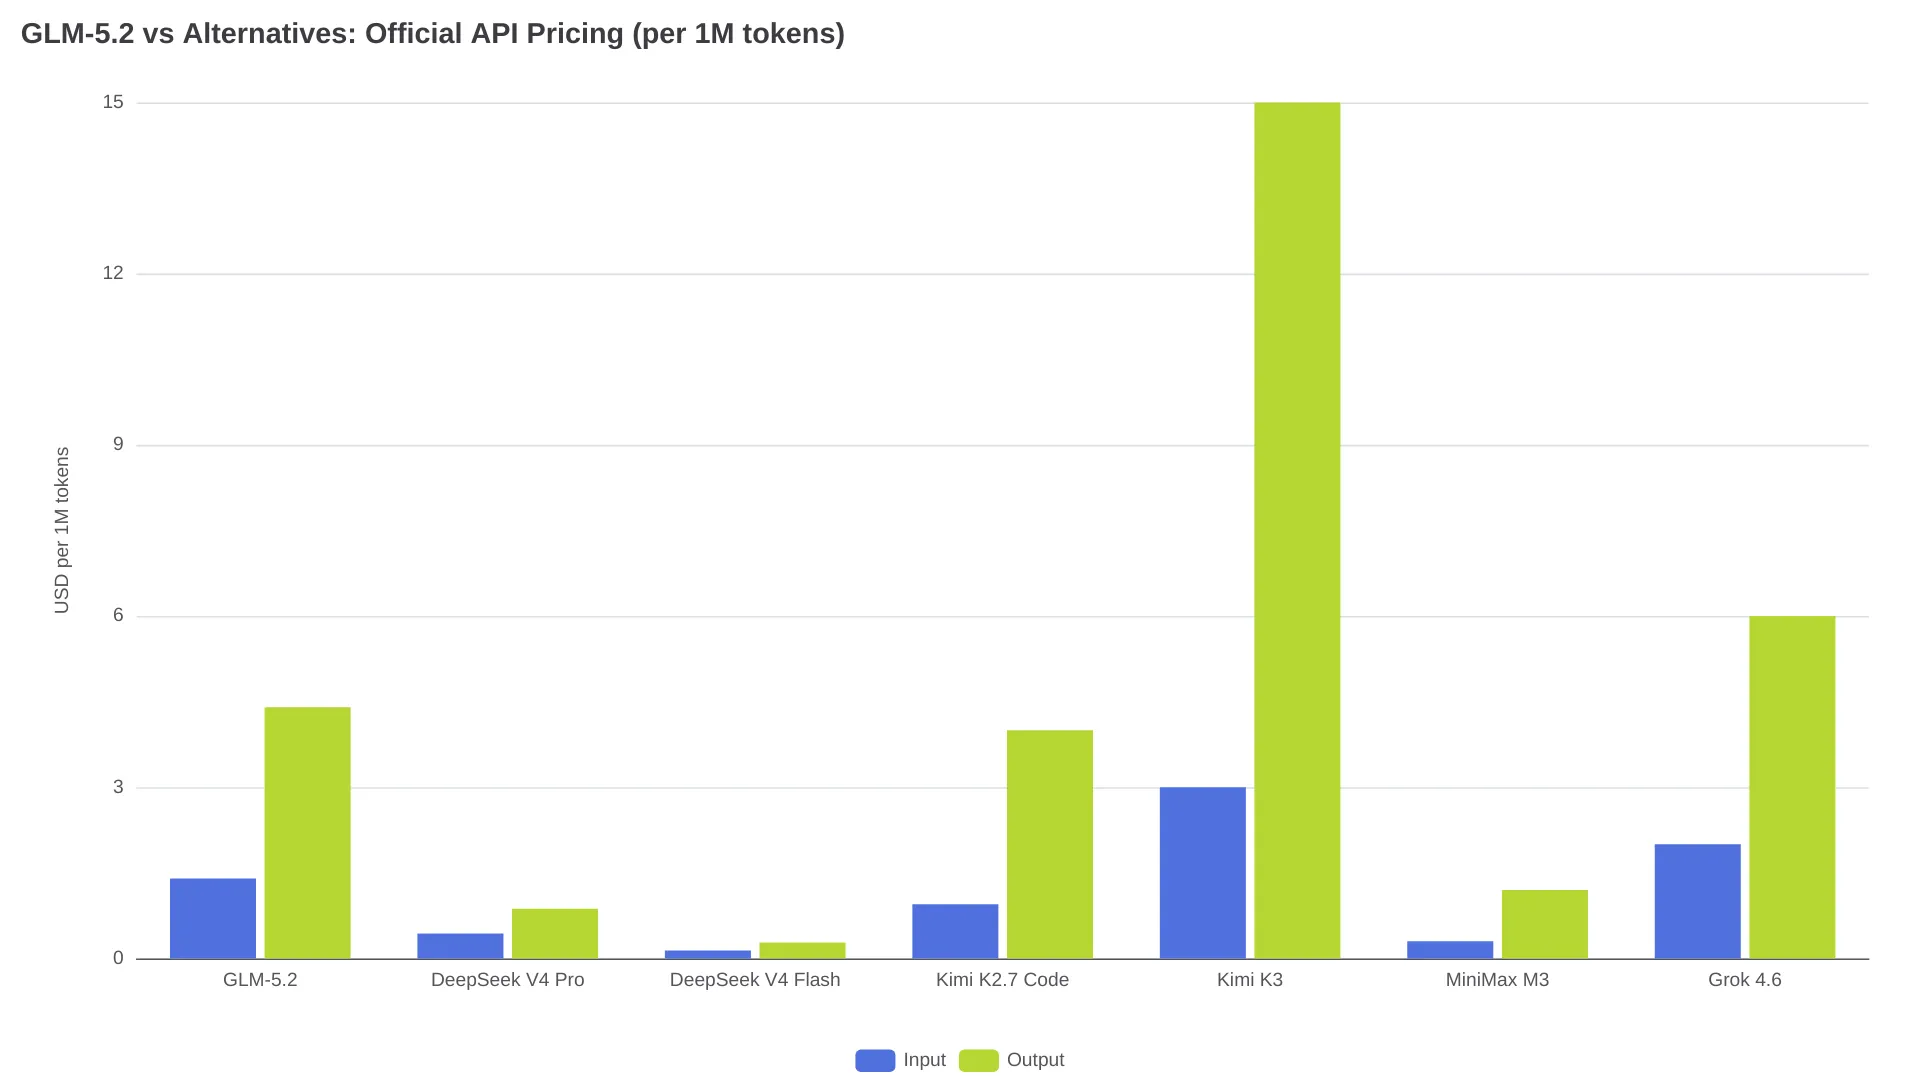
Todos os preços abaixo vêm das páginas oficiais de preços dos fornecedores e foram coletados em agosto de 2026. Os valores do Kimi K3 e do MiniMax M3 correspondem à entrada sem cache; as faixas com cache são bem mais baratas.
| Modelo | Contexto | Pesos / licença | Preço da API (US$/1M, entrada / saída) | Troque se… |
|---|---|---|---|---|
| GLM-5.2 (referência) | 1M | MIT | US$ 1,40 / US$ 4,40 | — |
| DeepSeek V4 Pro | 1M | Aberto (MIT, segundo a Layer3 Labs) | US$ 0,435 / US$ 0,87 | Você quer raciocínio difícil mais barato, mantendo o mesmo tamanho de contexto |
| DeepSeek V4 Flash | 1M | Aberto | US$ 0,14 / US$ 0,28 | O consumo de cota é o problema principal |
| Kimi K2.7 Code | 256K | Aberto (MIT modificada) | US$ 0,95 / US$ 4,00 | A confiabilidade dos loops de agentes importa mais que o tamanho do contexto |
| Kimi K3 | 1M | Fechado | US$ 3,00 / US$ 15,00 | Você precisa da estabilidade do Kimi e de contexto de 1M |
| MiniMax M3 | 1M | Fechado | US$ 0,30 / US$ 1,20* | Trabalho multimodal ou de alto volume, sensível a preço |
| Qwen3.8 Max / Qwen3-Coder | 1M | Apache 2.0 | Pesos gratuitos; hospedagem varia | O objetivo é fazer self-hosting ou fine-tuning |
| Grok 4.6 | 500K | Fechado | US$ 2,00 / US$ 6,00 | Você prioriza velocidade e um contexto grande, mas administrável |
Além desses sete modelos, há dois caminhos de upgrade mais abaixo: Claude Opus 4.8 para equipes que continuam falhando nas tarefas mais difíceis, e GLM-5.3 para quem quer permanecer na mesma família pelo mesmo preço.
\* A faixa do MiniMax M3 vale para entradas ≤512K tokens; acima desse limite, o preço dobra. O GLM-5.3 tem exatamente os mesmos preços do GLM-5.2, segundo o anúncio de lançamento da Z.ai, por isso foi excluído da comparação de custos.
Problema por problema: para qual modelo trocar
Cota acabando: encaminhe o loop pelo DeepSeek V4 Flash
A diferença aparece claramente na conta. Para entradas sem cache, os US$ 1,40/M do GLM-5.2 custam 10 vezes mais que os US$ 0,14/M do DeepSeek V4 Flash. Na saída, são US$ 4,40 contra US$ 0,28 — uma diferença de 15,7 vezes. Na etapa de execução de um loop de agente, que envolve editar arquivos, corrigir testes e gerar código repetitivo, essa distância se acumula a cada rodada. E o DeepSeek oferece o mesmo contexto de 1M de tokens, com saída máxima de 384K. O V4 Pro, a US$ 0,435/US$ 0,87, preserva boa parte da economia para tarefas de raciocínio mais pesado; nosso comparativo entre GLM-5.2 e DeepSeek V4 Pro mostra em que cenário cada um se sai melhor, enquanto o confronto com o V4 Flash cobre a opção econômica.
O padrão adotado por assinantes do OpenCode Go não foi exatamente trocar um modelo pelo outro, mas dividir as funções: GLM-5.2 para planejamento e revisão, e um modelo mais barato para o trabalho pesado. "Uso o GLM 5.2 do OpenCode Go apenas para planejamento", escreve u/narkeeso. u/Endoky, no mesmo ecossistema, resume assim: "uso o GLM 5.2 apenas como modelo de escalonamento ou para planejamento".
Loops de agentes instáveis: Kimi K2.7 Code
Quando o problema é o serviço, não a capacidade do modelo, o Kimi é a alternativa mais citada nas discussões que analisamos. Um usuário resumiu a situação — originalmente em chinês:
"A capacidade do modelo é praticamente a mesma, mas foi a incapacidade de oferecê-lo de forma estável que me fez escolher o Kimi em vez do GLM." — @wonjder
O Kimi K2.7 Code é a escolha especializada em programação: US$ 0,95/M de entrada, US$ 4,00/M de saída (US$ 0,19/M nos acertos de cache), com contexto de 262.144 tokens — um quarto da janela do GLM-5.2. Esse é o principal compromisso. O modelo aceita entradas de texto, imagem e vídeo, cobrindo também a lacuna multimodal deixada pelo GLM-5.2, que trabalha apenas com texto. Se 256K não forem suficientes para o seu repositório, o Kimi K3 oferece janela de 1M por US$ 3,00/US$ 15,00. Vale observar que os US$ 15 de saída equivalem a 3,4 vezes a tarifa do GLM-5.2: o K3 é uma compra por estabilidade, não por economia. O comparativo entre Kimi K2.7 Code e GLM-5.2 entra nos benchmarks.
Mais margem para as tarefas difíceis: Claude Opus 4.8
No SWE-Marathon, que envolve compilações, trabalho de kernel e tarefas autônomas de várias horas, o Opus 4.8 marca 26,0, contra 13,0 do GLM-5.2. No NL2Repo, são 69,7 contra 48,9, segundo o model card da Z.ai. O GLM-5.2 continua sendo o modelo aberto mais bem colocado nos dois rankings, de acordo com o mesmo material, mas a diferença aumenta justamente quando as tarefas ficam mais longas. O Opus é fechado, não pode ser hospedado localmente e tem preço premium; o comparativo entre GLM-5.2 e Opus detalha quando esse adicional se paga.
Self-hosting ou controle dos dados: Qwen3-Coder ou os próprios pesos do GLM
Qwen3-Coder e Qwen3.8 Max são distribuídos sob a licença Apache 2.0, têm contexto de 1M de tokens e contam com versões compactas para execução em uma única GPU. Tanto a Layer3 Labs quanto o glm5.app os apontam como as opções para self-hosting. Para fine-tuning e implantação privada, são as escolhas mais práticas entre estas alternativas; nosso artigo sobre os pesos abertos do Qwen 3.8 Max explica a família.
A opção contraintuitiva é hospedar o próprio GLM-5.2, já que a licença MIT permite isso. O problema é o hardware: os pesos em BF16 ocupam 1,51 TB, e até uma quantização de 4 bits da versão GGUF da Unsloth precisa de 372–475 GB de memória para ser carregada. Na prática, uma versão em 4 bits exige um servidor com várias GPUs, enquanto o BF16 completo é assunto para escala de cluster. As ferramentas locais também ainda são recentes: o llama.cpp só ganhou suporte ao indexador do GLM-5.2 em 24 de julho de 2026 (PR #25407). Hospedar o GLM-5.2 por conta própria é uma decisão de soberania dos dados, não de praticidade; sem um cluster, as variantes compactas do Qwen são a alternativa mais adequada para uma estação de trabalho.
Multimodalidade e alto volume barato: MiniMax M3
O MiniMax M3 combina contexto de 1M com entradas multimodais por US$ 0,30/M de entrada e US$ 1,20/M de saída — faixa para ≤512K; acima desse limite, os dois valores dobram, então faça as contas com cuidado. Para o orçamento de equipes, os planos de tokens do MiniMax custam US$ 20/US$ 50/US$ 120 por mês e cobrem a linha M3, M2.7, imagem e fala da empresa, com a cota medida em janelas móveis de 5 horas e semanais.
Velocidade em primeiro lugar: Grok 4.6
O Grok 4.6 custa US$ 2,00/M de entrada e US$ 6,00/M de saída, com contexto de 500K. A página da API da xAI afirma que o modelo oferece programação e uso de ferramentas líderes do setor, mas não publica a tabela de benchmarks. Portanto, trate esse posicionamento como posicionamento. O sinal vindo dos usuários, porém, existe: @bourneliu66 afirma que o Grok tomou o lugar do GLM em seu "trio principal", sendo mais forte, rápido e barato, nas palavras dele. Antes de aceitar essa ordem, valide-a com o seu próprio workload.
Nada está quebrado; você quer o GLM mais novo: GLM-5.3
O GLM-5.3 chegou à API em 18 de agosto de 2026 pelo mesmo preço do GLM-5.2, segundo o anúncio da Z.ai. Se o motivo da sua pesquisa por alternativas é ansiedade por upgrade, e não um problema concreto, o comparativo entre GLM-5.2 e GLM-5.3 mostra o que realmente mudou.
A estratégia de stack dividido: mantenha o GLM-5.2, mas rebaixe sua função
Um destino recorrente nas discussões acima não é migrar completamente. É deixar o GLM-5.2 como planejador e revisor, enquanto um modelo mais barato executa o trabalho. Isso combina com o perfil do modelo: a Z.ai o posiciona para trabalho de engenharia com agentes de longa duração, mas ele é o mais caro por token entre as opções econômicas.
Dois detalhes definem se essa divisão vai funcionar. O primeiro é a perda do cache KV: qualquer troca de modelo no meio da execução, ou mesmo entre provedores que oferecem o mesmo modelo, faz você pagar novamente pelo contexto. O segundo é a variação entre provedores: usuários do r/opencodeCLI relatam diferenças grandes de velocidade entre Fireworks, NeuralWatt e OpenCode Go servindo o mesmo modelo.
Um único endpoint compatível com OpenAI resolve a parte operacional: você mantém o mesmo formato de requisição da API do GLM-5.2 nas duas etapas, redireciona o tráfego quando um provedor degrada e concentra a cobrança. Isso não torna o contexto gratuito: o cache nunca é reutilizado entre modelos ou provedores, que é justamente o custo por trás do relato dos US$ 500 no fim de semana. Por isso, faça o roteamento nas fronteiras entre tarefas, não no meio da execução. Se a sua divisão acontece dentro do Claude Code, o nosso guia do GLM-5.2 no Claude Code cobre a configuração do ambiente.
A decisão em 30 segundos
| Seu problema | Escolha | O que você perde |
|---|---|---|
| A cota semanal acaba em um dia | DeepSeek V4 Flash | Parte do refinamento na programação com agentes em relação ao GLM |
| Loops de agentes morrem por erros do provedor | Kimi K2.7 Code | Contexto de 1M (fica em 256K) |
| As tarefas mais difíceis, de várias horas, falham | Claude Opus 4.8 | Pesos abertos, preço baixo e self-hosting |
| Você precisa dos pesos no próprio hardware | Qwen3-Coder | A liderança do GLM em Elo na programação de frontend |
| O modelo devora tokens no trabalho geral | MiniMax M3 | Acima de 512K de entrada, os preços dobram |
| Exigências regulatórias ou de compras | Qwen ou pesos do GLM hospedados localmente | A praticidade de um serviço gerenciado |
| Você quer o GLM mais novo | GLM-5.3 | Nada; o preço é o mesmo |
Perguntas frequentes
Qual é a melhor alternativa geral ao GLM-5.2?
O DeepSeek V4 Pro é o substituto mais equilibrado: contexto de 1M, pesos abertos e custo por token de 3 a 5 vezes menor. O Kimi K2.7 Code é a melhor escolha quando a confiabilidade em execuções longas com agentes pesa mais que a diferença nos benchmarks.
O DeepSeek é melhor que o GLM-5.2 para programação?
Em raciocínio algorítmico difícil, a comparação do glm5.app coloca o DeepSeek V4 Pro à frente. Já em tarefas de longa duração, com agentes trabalhando em vários arquivos, o contexto de 1M do GLM-5.2 e seu treinamento para agentes de longo horizonte — especialização declarada pela Z.ai — mantêm o modelo na dianteira. Na prática: o DeepSeek executa, o GLM planeja.
Qual é a alternativa mais barata ao GLM-5.2?
O DeepSeek V4 Flash, a US$ 0,14/M de entrada e US$ 0,28/M de saída, com entrada em cache a US$ 0,0028/M — praticamente grátis para contextos repetidos.
Quais alternativas têm o mesmo contexto de 1M de tokens do GLM-5.2?
DeepSeek V4 Pro e V4 Flash, Kimi K3, MiniMax M3 e Qwen3.8 Max listam janelas de 1M de tokens. O Kimi K2.7 Code (256K) e o Grok 4.6 (500K) não chegam a esse tamanho.
É possível rodar o GLM-5.2 localmente em vez de trocar de modelo?
Em termos técnicos, sim — os pesos MIT estão disponíveis. Mas uma versão em 4 bits precisa de 372–475 GB de RAM, e o suporte no llama.cpp só foi integrado em 24 de julho de 2026. Para a maioria das equipes, o acesso pela API hospedada continua sendo a única opção prática.
Quanto custam por mês as alternativas ao GLM-5.2 em planos de assinatura?
Os planos de tokens do MiniMax custam US$ 20–US$ 120 por mês. A CLI de código do Kimi começa em US$ 19/mês, e o Coding Plan da Z.ai, em US$ 18/mês, segundo o levantamento de preços da Digital Applied. Depois do aumento de junho, o plano Pro da Z.ai custa US$ 65.